Google hat die KI-Suche in Smartphones integriert, die weniger als 600 MB groß ist, sodass Fotos, Videos und Tonaufzeichnungen auch ohne Internetverbindung durchsucht werden können.
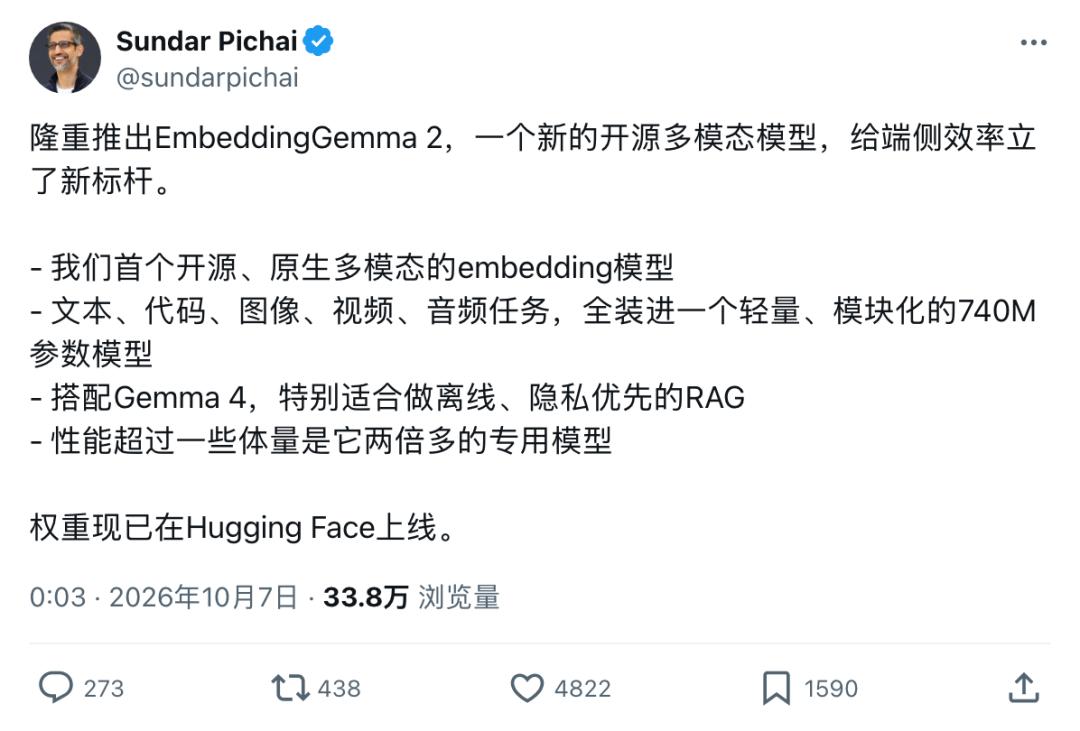
Am 6. Oktober veröffentlichte Google das quelloffene Modell EmbeddingGemma 2: Es handelt sich um eine Suchmaschine, die Bilder erkennen, Videos abspielen und Ton verarbeiten kann – und steckt in einem kleinen Modell mit weniger als 600 MB Arbeitsspeicherbedarf!
Texte, Code, Bilder, Videos und Audiodateien lassen sich nun gemeinsam mit einer einzigen Suchanfrage durchsuchen, was bei Googles quelloffenen Modellen bisher noch nie vorgekommen ist.
Mit 740 Millionen Parametern lässt es sich auf Smartphones, Laptops und Browsern vollständig offline ausführen.
Googles CEO Sundar Pichai hat es persönlich empfohlen: Dies ist das erste native multimodale quelloffene Einbettungsmodell von Google.
Einer seiner größten Durchbrüche besteht darin, dass auch Smartphones lokal nach Bildern, Videos und Tönen suchen können. In der Demonstration findet man nach Eingabe der Phrase „Vögel singen“ sofort sowohl Fotos von Vögeln als auch Aufnahmen von Vogelgezwitscher.
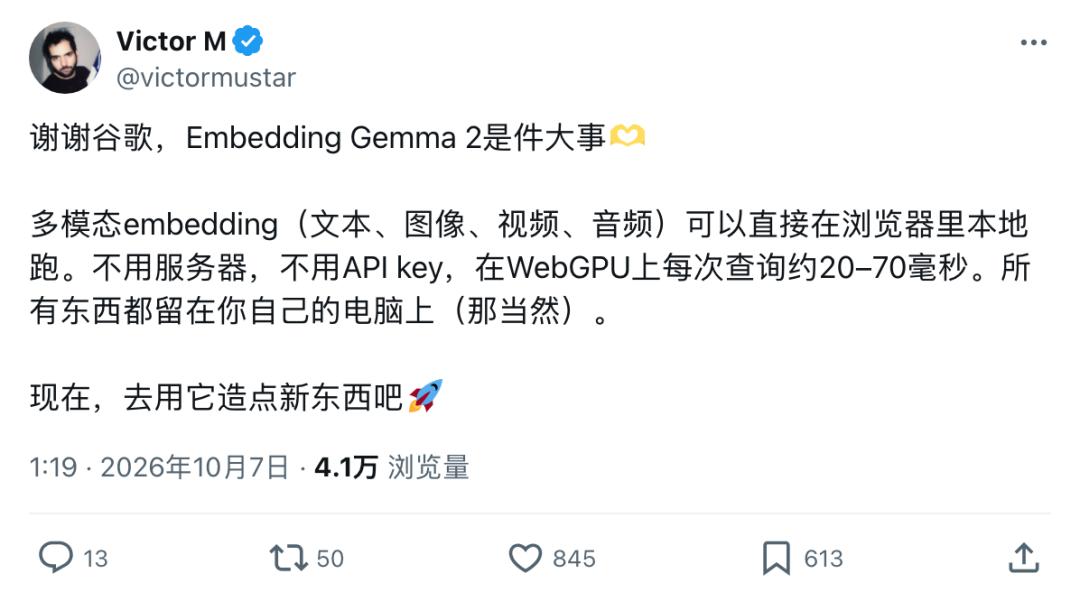
Über eine Stunde nach der Veröffentlichung ließ Victor M von Hugging Face das Modell bereits im Browser ausführen.
Er gab in das Suchfeld „Vögel singen“ ein, und die Kacheln auf dem Bildschirm sortierten sich sofort neu: Ganz oben standen sowohl Fotos von Vögeln als auch Aufnahmen von Vogelgezwitscher mit angezeigter Wellenform.
Die gesamte Abfrage dauerte nur 22 Millisekunden, ohne dass ein Server kontaktiert oder eine API aufgerufen wurde.
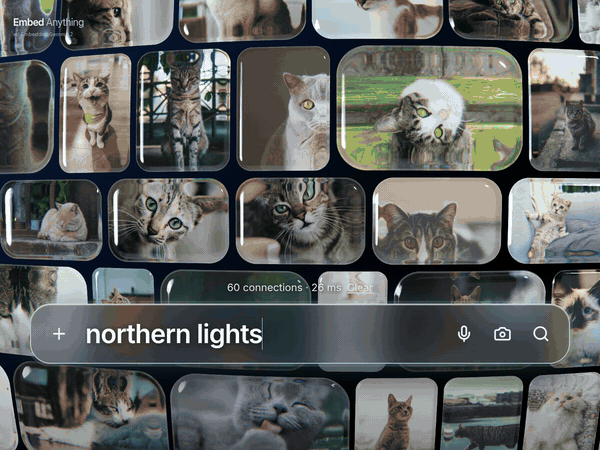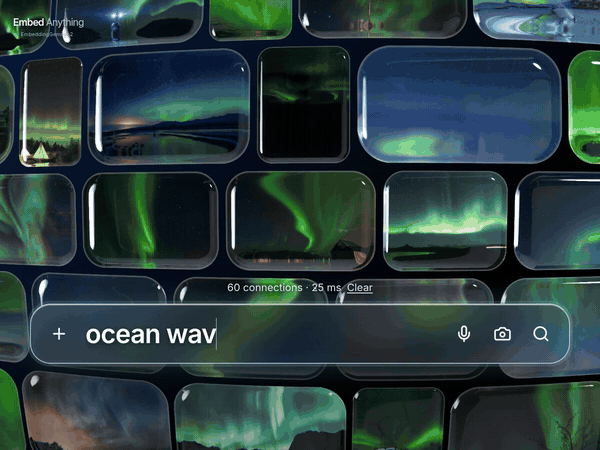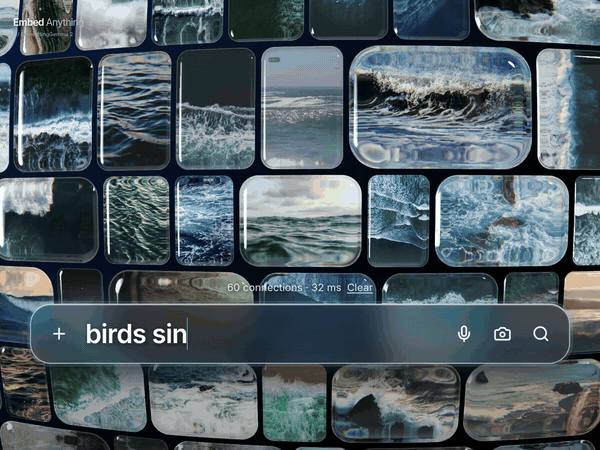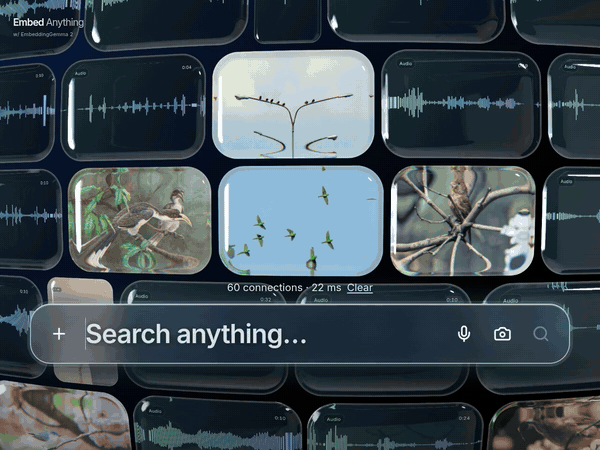
Nach der Integration in Anwendungen können Sie die KI dazu bringen, Fotos, Aufnahmen und Videos auf Ihrem Smartphone zu finden, ohne die Dateien zuerst in die Cloud hochzuladen.
Texte, Bilder, Töne
können sich gegenseitig durchsuchen
Embedding ist für normale Nutzer normalerweise unsichtbar, aber viele KI-Suchfunktionen und RAG-Fragestellungen greifen im Hintergrund darauf zurück, um Informationen abzurufen.
Seine Aufgabe besteht darin, einen Inhalt in eine Zahlenfolge umzuwandeln – das entspricht der Zuweisung einer Koordinate für jeden Inhalt in einem riesigen Raum. Je ähnlicher die Bedeutung ist, desto näher liegen die Koordinaten beieinander.
Bei der Suche sucht das System dann die Inhalte heraus, die der Frage am nächsten kommen.
Die vorherige Generation von EmbeddingGemma verarbeitete nur Texte. Um Bilder und Töne zu durchsuchen, musste man oft andere Modelle anschließen oder sie zuerst in Text umwandeln.
EmbeddingGemma 2 legt alle diese Inhalte in denselben 768-dimensionalen Raum.
Beispielsweise können Fotos von Katzen, das Wort „Katze“ und das Miauen von Katzen in diesem Raum semantisch miteinander verknüpft werden.
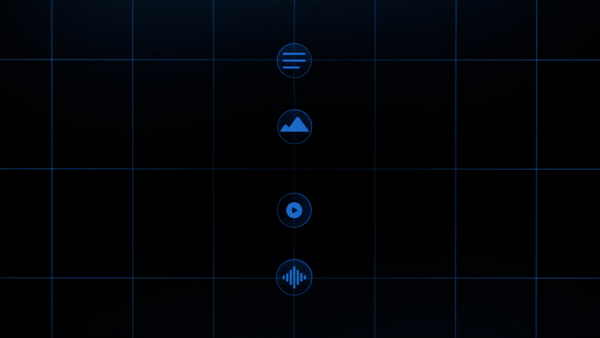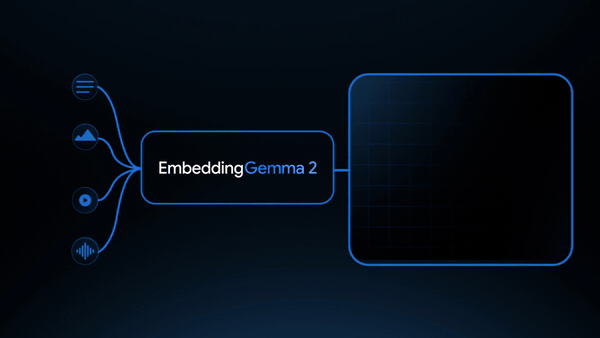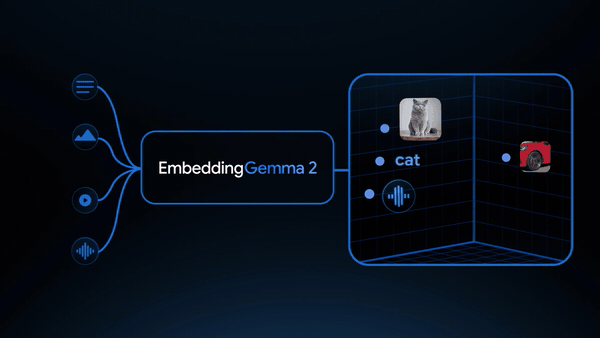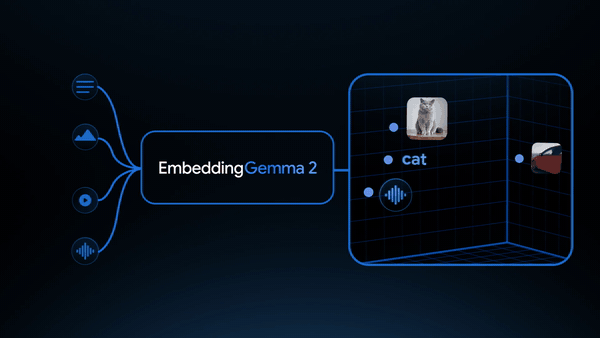
So können Sie mit einem einzigen Satz nach Bildern und Videos suchen, oder mit einer Sprachaufnahme die entsprechenden Ausschnitte in einem Video finden.
Es kann auch Texte, Bilder und Videos zusammenführen, sodass Sie in einer einzigen Suche alle vollständigen Informationen finden, die diese Inhalte enthalten.
Google hat im Modellkartenblatt ein Beispiel angeführt.
Eine Produktseite für Laufschuhe enthält eine Textbeschreibung, zwei Detailbilder und ein Video zum Testen der Rutschfestigkeit des Schuhs auf nassen Felsen.
Das Modell kann diese Gruppe von Inhalten in einen Vektor umwandeln, um Suchanfragen wie „wasserdichte Schuhe für Trailrunning“ zuzuordnen.
Die Menge der verarbeitbaren Inhalte pro Durchgang ist ebenfalls gestiegen. Das Kontextfenster von 8K ist viermal so groß wie das der vorherigen Generation.
Wenn Sie nur Inhalte eines einzelnen Typs eingeben, können Sie maximal etwa 5,5 Minuten Audiodatei, 29 Bilder oder 58 Videobilder verarbeiten. Es unterstützt zudem über 100 Sprachen.
Google hat es mit mehreren Modellen derselben Größenordnung verglichen – die größten Unterschiede zeigen sich bei der Bild- und Videoverarbeitung.
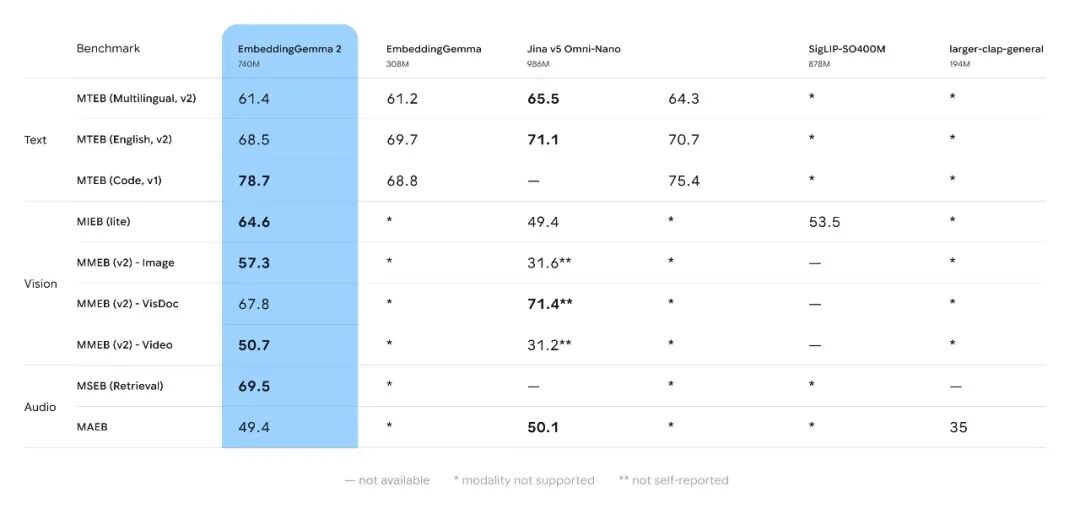
EmbeddingGemma 2 liegt bei der Bild- und Videosuche deutlich vor Jina v5 Omni-Nano.
In den von Google veröffentlichten Tests erzielte EmbeddingGemma 2 eine Bildsuchpunktzahl von 57,3, während Jina v5 Omni-Nano mit 30 % mehr Parametern nur 31,6 Punkte erreichte.
Auch bei der Videosuche klafft eine große Lücke: 50,7 Punkte gegenüber 31,6 Punkten, also ein Vorsprung von fast 20 Punkten.
Bei den mehrsprachigen Texttests liegt es auf etwa dem Niveau der vorherigen Generation.
567 MB
Das Smartphone fungiert selbst als Suchmaschine
All diese Fähigkeiten sind in 740 Millionen Parametern untergebracht.
Der Textteil macht 270 Millionen Parameter aus, der visuelle Kodierer 170 Millionen und der Audiokodierer 300 Millionen – sie können nach Bedarf geladen werden. Wenn Sie nur Texte durchsuchen, laden Sie nur 270 MB; wenn Sie auch Bilder durchsuchen möchten, fügen Sie den visuellen Teil hinzu, was insgesamt 440 MB ergibt.
Bei Tests auf Googles Pixel 11 Pro belegt das quantisierte reine Textmodell minimal etwa 191 MB Arbeitsspeicher, das vollständige multimodale Modell etwa 567 MB.
Es unterstützt zudem das „Verschlanken“ von Suchindizes: Indem die Bedeutung jedes Inhalts mit weniger Zahlen aufgezeichnet wird, kann der belegte Speicherplatz um zwei Drittel reduziert werden.
Bei Googles mehrsprachigem Textsuchtest sank die Punktzahl um weniger als 1 Punkt.
Google selbst hat mehrere Beispielanwendungen entwickelt:
Instant Media Search in der AI Edge Gallery ermöglicht es Ihnen, Fotos in Ihrer Galerie nach Bedeutung zu durchsuchen.
Video Moments Finder ist noch intuitiver: Mit einem einzigen Satz können Sie die entsprechenden Ausschnitte im Video lokalisieren.
Eine weitere Anwendung namens Foresight kombiniert es mit Gemma 4, um Dateien und Besprechungsprotokolle auf einem Mac offline zu durchsuchen.
Auf Entwicklerseite bietet llama.cpp bereits Unterstützung, und Unsloth hat eine quantisierte Version veröffentlicht, die die lokale Bereitstellung des Modells erleichtert.
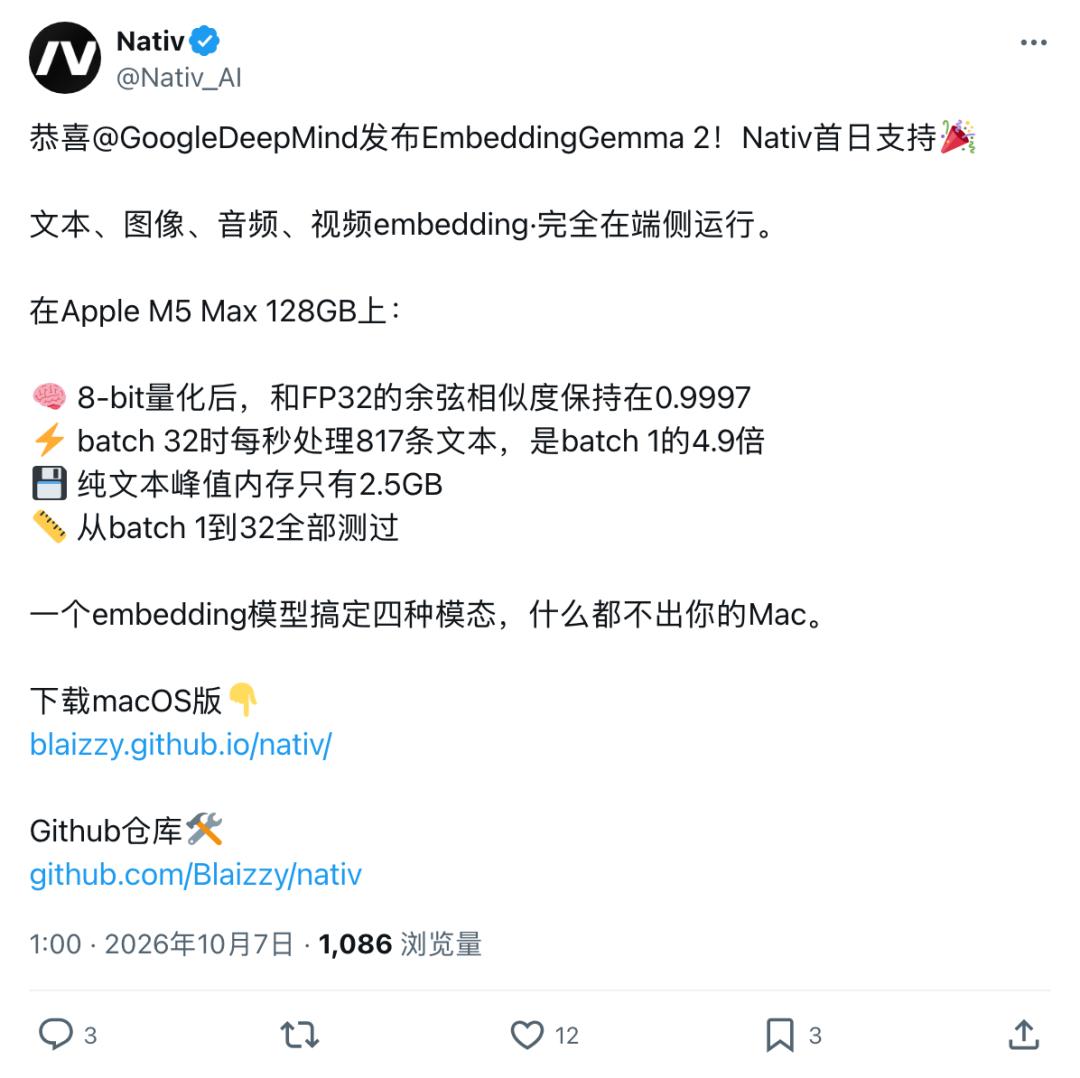
Laut praktischen Messungen der Mac-Anwendung Nativ erreicht der durch die 8-Bit-quantisierte Version generierte Vektor auf dem M5 Max eine Kosinus-Ähnlichkeit von 0,9997 mit dem Originalmodell, und die Einbettungsgeschwindigkeit für Texte beträgt 817 Einträge pro Sekunde.
Der Test des türkischen Entwicklers Avenox ist noch näher am Alltag.
Er schreibt seine Notizen größtenteils auf Englisch, stellt seine Fragen aber gewohnheitsmäßig auf Türkisch. Früher funktionierte die Suche über Schlüsselwörter nicht, wenn die Begriffe nicht übereinstimmten – dann konnten relevante Notizen nicht gefunden werden.
Er ließ Claude eine Stunde lang einen Testaufbau erstellen, wählte 40 Notizen aus, formulierte jede auf Türkisch neu und prüfte, ob die richtige Notiz unter die ersten 18 Suchergebnisse gelangt.
Laut seinen veröffentlichten Ergebnissen lag die Trefferquote bei der Schlüsselwortsuche nur bei 15 %; mit EmbeddingGemma 2 stieg sie auf 97 %.
Anschließend testete er es mit 30 echten Nachrichten, die er im Alltag eingegeben hatte und die Tippfehler enthielten. Die Anzahl der relevanten Notizen, die das Modell fand, war doppelt so hoch wie bei der Schlüsselwortsuche. Jede Abfrage dauerte etwa 50 Millisekunden und lief vollständig lokal.
Einige Entwickler gehen noch weiter.
Der Entwickler Nick Lo hat es auf einem Nano-Entwicklungsboard installiert.
Nach Eingabe eines Satzes wandelt das Modell diesen in nur etwa 15 Millisekunden in eine Zahlenfolge für die Suche um. Nachdem das entsprechende Bild gefunden wurde, wird es an einen ESP32-S3-Mikrocontroller übergeben, der das Bild Zeile für Zeile zeichnet.

Coding Agent findet Code
kann nun ebenfalls lokal durchsuchen
Neben der multimodalen Funktion hat sich auch die Codesuche deutlich verbessert.
Beim Codesuche-Benchmark MTEB Code stieg die Punktzahl von 68,76 bei der vorherigen Generation auf 78,68 – ein Anstieg von fast 10 Punkten. Laut Google ist dieses Ergebnis führend unter Modellen dieser Größe.
Das ist sehr praktisch für Agenten, die Code schreiben.
Tools wie Claude Code und Codex müssen vor der Arbeit zuerst die relevanten Codeabschnitte im gesamten Code-Repository finden.
Mit der 270 MB großen reinen Textversion können Entwickler lokal einen Index für das Code-Repository erstellen und dann mit einfachen Wörtern nach relevantem Code suchen. Sowohl das Erstellen des Index als auch die Suche können vollständig lokal ausgeführt werden.
KI-Suche
zieht auf Ihr Smartphone um
Im März dieses Jahres veröffentlichte Google bereits das multimodale Gemini Embedding 2 in der Cloud, das per API-Aufruf mit nutzungsabhängiger Bezahlung genutzt werden kann.
Mehr als ein halbes Jahr später hat Google die multimodale Suche in ein kleines quelloffenes Modell gebracht, das auf Smartphones ausgeführt werden kann. Für Fotos, Aufnahmen und Videos gibt es nun die Option der lokalen Suche.
Eine von Google vorgeschlagene Nutzung ist die Kombination mit Gemma 4, um eine datenschutzpriorisierte RAG-Lösung für den Offline-Betrieb zu erstellen.
Eine Komponente sucht die Informationen, die andere beantwortet die Fragen anhand der gefundenen Daten – sowohl die Suche als auch die Fragestellung werden vollständig auf dem Gerät ausgeführt.
Bisher mussten Sie zum Durchsuchen von Fotos, Videos und Aufnahmen mit KI die Inhalte oft in die Cloud zur Verarbeitung übermitteln.
Jetzt lässt sich diese Suchfunktion mit nur wenigen hundert MB Speicherbedarf in die Tasche jedes Nutzers bringen.
Quellenangaben:
https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2
https://huggingface.co/google/embeddinggemma-2
https://ai.google.dev/gemma/docs/embeddinggemma