Wer erstellt Prüfungsaufgaben für große KI-Modelle, verkauft diese Aufgaben und führt die Bewertung durch? Über das ungezügelte Wachstum der KI-Datenbranche
Mit der Verbesserung der Fähigkeiten von KI-Modellen und der zunehmenden Komplexität der Trainingsanforderungen wächst eine Reihe neuer Unternehmen rasant, die Modellentwicklern Trainingsdaten anbieten: Als AfterQuery im April dieses Jahres die A-Runden-Finanzierung bekannt gab, betrug seine Bewertung 300 Millionen US-Dollar. Bis September wurde seine Bewertung nach Medienberichten durch die neue Finanzierungsrunde auf 3,2 Milliarden US-Dollar angehoben. Ein weiteres Unternehmen, Bespoke Labs, das Trainingsdaten und Umgebungen für intelligente Agenturen anbietet, gab ebenfalls im Juli dieses Jahres bekannt, dass die Summe aus Seed-Runde und A-Runde-Finanzierung 40 Millionen US-Dollar erreicht hat.
Obwohl die Bewertungen stetig steigen, ist die KI-Datenbranche für die Außenwelt äußerst undurchsichtig. Verkaufen diese Unternehmen eigentlich genau?
Wenn wir früher über Datenannotationen sprachen, dachten wir leicht daran, Bilder zu markieren und die Antworten von Modellen zu bewerten. Aber da KI von der Beantwortung von Fragen zur Ausführung von Aufgaben übergeht, ändern sich auch die Lieferungen von Datenunternehmen: Von Bewertungsstandards, die von Experten verfasst wurden, bis hin zu Umgebungen für verstärkendes Lernen, die Aufgaben, Werkzeuge und Validierungsmechanismen enthalten. Sie müssen sachkundige Personen finden, echte Brancheninformationen erhalten und dann Fachwissen und Berufserfahrung in Trainingssignale umwandeln, die das Modell lernen kann.
Gleichzeitig tauchen ständig neue KI-Bewertungen auf. Die Punktzahlen in den Ranglisten steigen – welche Fähigkeiten sind dadurch eigentlich stärker geworden? Wenn Daten speziell für Bewertungen erzeugt werden, wann verbessert das das Erlebnis echter Nutzer und wann wird es nur zu einem reinen Punktesammeln? Was sind die Daten, die Forscher, die täglich Modelle trainieren, am dringendsten benötigen?
In dieser Folge des Podcasts „Silicon Valley 101“ haben wir He Yunzhong eingeladen, der bei Scale AI für die Forschung zum Nach-Training und zur Bewertung verantwortlich ist, sowie Sun Yiyou, Postdoktorand an der University of California, Berkeley und Forscher am Projekt „Agents’ Last Exam“. Aus den Perspektiven von Industrie und Forschung zerlegen wir dieses Geschäft, das wenig transparent ist und sich extrem schnell verändert.
Wir sprechen über die unterschiedlichen Hintergründe von Datenunternehmen wie Scale, Mercor und Surge und erörtern auch die Chancen kleiner Teams in synthetischen Umgebungen und vertikalen Branchen. Von der Beschaffung eines Spiel-Quellcodes über die Überprüfung von Aufgaben, die von Experten eingereicht wurden, bis hin zur Gestaltung von Anreizmechanismen, die Menschen dazu bringen, ihre Erfahrungen weiterzugeben – die Schwierigkeiten guter Daten verbergen sich oft außerhalb der Ranglisten.
Im Folgenden finden Sie eine Auswahl des Gesprächs:
01
Wer betreibt das KI-Datengeschäft?
Yiwen: Auf dem Markt gibt es eine Vielzahl von Datenunternehmen. Wie lassen sie sich klassifizieren?
He Yunzhong: Es gibt einige große Akteure, einige Newcomer und sogar kleine Werkstätten mit nur wenigen Mitarbeitern. Meiner Meinung nach ist das Interessanteste, dass ihre „Gene“ sehr unterschiedlich sein können. Einige stammen aus der Personalbeschaffung, wie Mercor und Handshake; Scale AI ist ein traditioneller Datenanbieter, der aus einem Crowdsourcing-Netzwerk hervorgegangen ist; einige neue Unternehmen konzentrieren sich auf Synthese; und die neuesten Unternehmen sind möglicherweise aus anderen Branchen in das Datengeschäft eingestiegen. Erwähnenswert ist der Bereich der verkörperten Intelligenz: Viele Modellentwickler haben bisher kein Geld verdient, aber sie haben viel Aufwand in die Dateninvestition gesteckt und betreiben nebenbei das Datengeschäft. Viele Menschen aus verschiedenen Branchen haben auch den Wert ihrer eigenen Daten erkannt und sind zu Datenunternehmen geworden. Ich denke, das sind grob die paar Kategorien.
Einige große Akteure wie Mercor, Surge AI und Scale AI versuchen im Grunde, alles abzudecken. Darüber hinaus meistern einige Newcomer bestimmte Bereiche sehr gut, wie BigCode oder Snorkel AI, die eher forschungs- und ingenieursorientiert sind. Ich vermute, dass sie hauptsächlich Umgebungen für Code oder Werkzeugaufrufe erstellen und damit den Trend dieses Jahres erfasst haben.
Außerdem habe ich einige kleine Unternehmen gesehen, die Probleme in vertikalen Bereichen lösen und nicht einmal Daten annotieren, sondern eher Datenmakler sind. Zum Beispiel könnte eine Person aus Hollywood eine Menge urheberrechtlich geschützter Daten besitzen und wissen, wie sie Inhalte aus verschiedenen Bereichen verkaufen kann. Der neu aufstrebende Bereich sind vertikale Branchen, in denen ein Bereich von Fachexperten besonders gut erschlossen wird.
Ich denke, es gibt noch viele Chancen: Große Datenanbieter haben ihre Vorteile, sie verfügen über mehr Ressourcen, wenn sie in einen neuen Bereich eintreten. Ich denke, der gesamte Kuchen wird immer größer.
Yiwen: Du hast erwähnt, dass Unternehmen wie Mercor sogenannte Personalbeschaffungsunternehmen sind. Was für ein Geschäftsmodell ist Personalbeschaffung?
He Yunzhong: Mercor ist aus der Personalbeschaffung hervorgegangen. Es hat ein eigenes Produkt für automatisierte KI-Interviews, dessen Kernvorteil darin besteht, in kurzer Zeit eine ausreichende Anzahl von Experten zu finden und über ein Expertennetzwerk zu verfügen. Surge AI hingegen erledigt diese Arbeit größtenteils intern. Es gibt hier verschiedene Kompromisse, vor denen fast jeder Datenanbieter steht: Wenn man Mitarbeiter vollständig in Vollzeit ausbildet, sind ihre Fähigkeiten sicherlich stärker, aber die Flexibilität ist geringer und die Produktivität könnte schlechter sein; wenn man sich stärker auf ein Crowdsourcing-Netzwerk stützt, ist die Flexibilität höher, aber die Qualität jedes Einzelnen ist schwer zu gewährleisten – das bringt Probleme bei der Qualitätskontrolle mit sich. Der Vorteil von Unternehmen wie Scale AI liegt darin, dass wir Erfahrung in der Qualitätskontrolle haben, nicht nur bei Daten, sondern auch bei Menschen.
02
Wie wandelt sich die KI-Datenbranche?
Yiwen: Wir konzentrieren uns auf dieses Thema, weil sich die Nachfrage nach Daten seit etwa 2024 stark verändert hat. Vor 2024, wenn wir über Daten sprachen, dachten die meisten an manuelle Annotation, also grundlegende Daten, die wir in großer Menge für das Pre-Training von Modellen benötigten. Aber seit 2024 – Mercor hat das bereits erwähnt – hat der Aufstieg von Deep Search die gesamte Branche zu sogenannten „Agentic Data“ (Daten für intelligente Agenten) geführt.
Wir brauchen Dinge wie die gerade erwähnte „Rubric“ (Bewertungsrichtlinie), einschließlich RL-Umgebungen, und jetzt zunehmend Daten echter Arbeitsabläufe. Kannst du uns diese Konzepte kurz erläutern? Lass uns zuerst darüber sprechen, welche Veränderungen die Branche von Crowdsourcing-Daten, also manuell annotierten Daten, bis hin zu Agentic Data durchlaufen hat.
He Yunzhong: Ja, zunächst einmal ist Pre-Training immer noch sehr wichtig. Aber tatsächlich hat sich das Interesse der Menschen in meinem Umfeld verschoben: Viele finden Pre-Training inzwischen etwas langweilig. Als die Modelle der o-Serie erschienen, konzentrierten sich alle auf Reasoning, stellten fest, dass RL funktioniert, und plötzlich lag das gesamte Interesse auf RL.
Ein interessantes Problem bei RL ist, dass ich ein überprüfbares Signal brauche. Überprüfbare Signale sind in Code oder Mathematik – insbesondere bei den frühesten Reasoning-Modellen, die auf Mathematik basieren – sehr einfach: Man weiß sofort, ob eine Multiple-Choice-Aufgabe richtig oder falsch beantwortet wurde oder ob ein berechnetes Ergebnis stimmt. Aber danach fragten sich alle: Wenn ich RL in Mathematik durchführen kann, was ist mit anderen Bereichen? Zum Beispiel in Medizin, Finanzen oder bei grundlegenderen Anweisungsbefolgungen – kann ich dort auch RL anwenden? Das Problem dabei ist, dass es objektive Standardantworten gibt, anders als in der früheren Phase von RLHF (Reinforcement Learning from Human Feedback), wo das Belohnungsmodell kaum Standardantworten hatte und nur die Vorlieben der Menschen lernte.
Dort gibt es tatsächlich Standardantworten, auch wenn sie unstrukturiert sind. Wenn ich zum Beispiel eine Geschichtsprüfungsfrage beantworte, hat diese eine Standardantwort, aber jede Person schreibt sie anders, sodass es schwierig ist, ein einfaches Musterabgleich durchzuführen, um zu prüfen, ob A, B, C oder D richtig ist. In diesem Fall kommt die Rubrik-Methode zum Einsatz: Ein Tutor bewertet die Arbeit anhand von Bewertungsregeln, die der Professor verfasst hat.
Da die Bewertungsregeln im Voraus festgelegt und vom Professor verfasst wurden, muss der Tutor nicht besonders intelligent sein. Das ist ein Kernkonzept in den Daten großer Sprachmodelle: „Weak-to-strong supervision“ – kann ein schwaches Modell verwendet werden, um ein starkes Modell zu überwachen? Die Voraussetzung dafür ist, dass ein Experte sein Wissen niedergeschrieben hat, sodass das schwächere Modell damit die Arbeiten korrigieren kann. Das ist Rubric-Daten.
Dieser Ansatz war lange Zeit populär und ist auch heute noch wichtig. Aber die leicht zugänglichen Rubriken in verschiedenen Fachbereichen sind schnell fast vollständig erfasst. Der Aufstieg von Unternehmen wie Mercor oder Surge AI hängt tatsächlich mit diesen Experten-Rubriken zusammen. Aber jetzt müssen die Menschen praktisch werden. Bei aktuellen Code-Modellen oder bei ALE, an dem Yiyou arbeitet – auch wenn es nicht um Code geht – muss man „handeln“ und verschiedene Probleme lösen.
In diesem Fall geht es nicht mehr nur darum, die Ausgabe einer Chat-Antwort zu überprüfen: Ich brauche eine Umgebung für einen Agenten, ihm Werkzeuge zur Verfügung zu stellen und komplexere Überprüfungsmethoden zu verwenden. Es enthält immer noch Rubriken, aber ich muss möglicherweise überprüfen, ob Variablen in der Umgebung ausgeführt wurden, ob eine Datenbank geschrieben oder gelöscht wurde. Selbst wenn ich Dokumente mit Bildern erstelle, brauche ich immer noch Rubriken, aber ich muss einen Agenten zur Überprüfung einsetzen – die Dinge werden vielfältiger.
Heute verfolgen viele Menschen eine große Richtung: Umgebungen, die nicht nur vorgegebene Bewertungsregeln sind, sondern eine ganze Reihe von „Was ich tun muss“ und „In welcher Umgebung ich es tue“ enthalten, einschließlich der benötigten Werkzeuge, der Sandboxes zur Ausführung und eines Überprüfungsverfahrens, das eng mit der Aufgabe verknüpft ist. Die Überprüfungsmethoden sind sehr vielfältig: Es gibt programmatische Prüfungen, Rubriken und auch Präferenzprüfungen, bei denen Menschen auswählen, welche Antwort sie bevorzugen.
Hier gibt es noch keinen großen Konsens. Es erinnert ein wenig an die Ära der Rubriken: Jedes Unternehmen will etwas anderes. Zum Beispiel verlangt Terminal-Bench keine Rubriken, sondern arbeitet rein programmatisch. Es gibt verschiedene Richtungen, was sehr interessant ist.
Yiwen: Yiyou, kannst du uns anhand des konkreten Beispiels von ALE erklären, welche Elemente benötigt werden? (Anmerkung: ALE, „Agents’ Last Exam“, wird gemeinsam von RDI der University of California, Berkeley und mehr als 300 Branchenexperten geleitet. Es soll die Fähigkeit von KI-Agenten bewerten, echte berufliche Aufgaben zu erfüllen. Experten reichen ihre abgeschlossenen Projekte ein, und den Aufgaben werden Ausführungsumgebungen und Überprüfungsmechanismen zugewiesen, um zu testen, ob Agenten langwierige, wirtschaftlich wertvolle Arbeiten erledigen können)
Sun Yiyou: Meine Ansicht unterscheidet sich ein wenig von der von Yunzhong. Yunzhong glaubt, dass Rubriken fast ausgereizt sind, aber ich denke, dass Rubriken – insbesondere subjektive Bewertungen durch Experten – noch lange nicht vollständig erschlossen sind. Ich kann mit der ursprünglichen Absicht von ALE beginnen. Als ALE gegründet wurde, verfolgten wir das gleiche Ziel, das Yunzhong erwähnt hat: Den rasanten Trend des „Vibe Coding“ auf alle Bereiche auszudehnen.
Warum hat sich „Vibe Coding“ so schnell entwickelt? Weil es sehr viele Bewertungsbenchmarks im Codierungsbereich gab, und Codierung ist leicht zu überprüfen – es ist eine deterministische Rubrik. Die Menschen wollten in diesen Ranglisten punkten, sodass sich der Codierungsbereich extrem schnell entwickelt hat. Mit dem gleichen Ansatz können wir in verschiedenen anderen Bereichen, insbesondere im Ingenieurwesen, wo objektive Bewertungen möglich sind, verschiedene Bewertungssysteme aufbauen. Wenn man in diesen sinnvollen Aufgaben Punkte sammelt, führt die Verbesserung des Modells zu echten Vorteilen für die tägliche Arbeit der Menschen.
Das war die ursprüngliche Absicht, ALE aufzubauen. Natürlich gibt es unzählige verschiedene Berufe auf der Welt, also haben wir in der ersten Version nur einen ersten Versuch mit relativ breiter Abdeckung gemacht. Wir werden weiter daran arbeiten, die Abdeckung zu erweitern, bis es eines Tages das echte „Last Exam“ wird: Wenn du diesen Benchmark löst, kannst du im Grunde genommen echte, nützliche Probleme in bestimmten Bereichen der menschlichen Gesellschaft lösen.
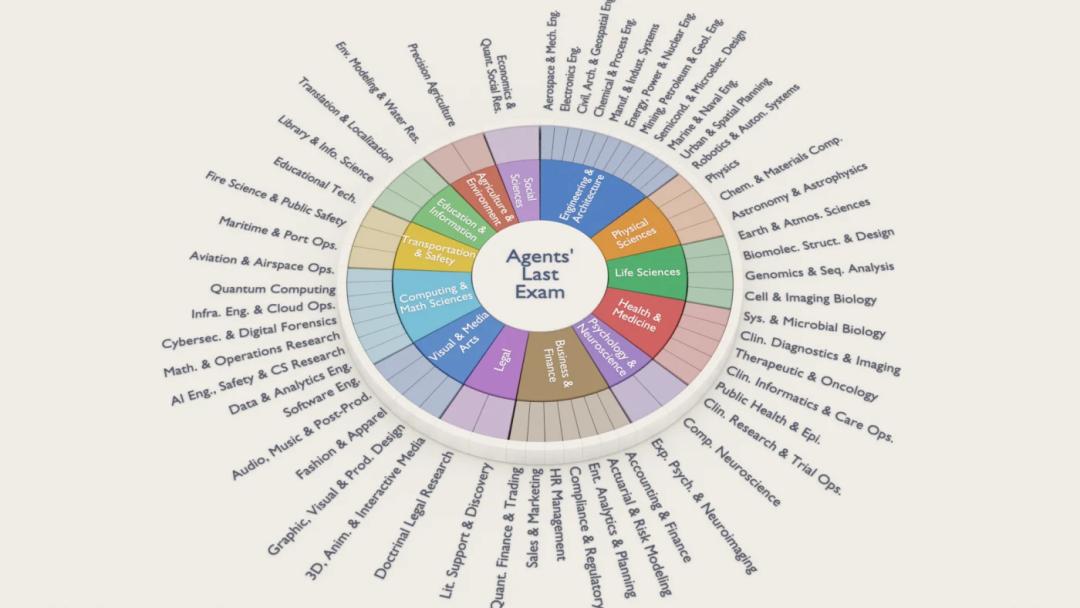
Laut der ALE-Website deckt die Bewertung 55 nicht-körperliche Berufe ab. Bildquelle: ALE Blog
He Yunzhong: Ich stimme Yiyous Ansicht zu. Das Training in verschiedenen Bereichen ist mit Sicherheit noch lange nicht abgeschlossen, viele Dinge wurden noch nicht durch Rubriken dargestellt, also gibt es noch viel Potenzial. Wenn ich sagte, dass Rubriken ausgereizt sind, bezog sich das eher auf den Branchentrend bei statischen ein- oder mehrstufigen Chat-Aufgaben, bei denen ein Text ausgegeben und mit Rubriken überprüft wird – rein wissensbasierte Aufgaben. Es ist nicht einmal wirklich ausgereizt, denn verschiedene Labore haben unterschiedliche Fähigkeiten.
Aber der große Trend in diesem Jahr ist die Codierung, die sich allmählich zu „Knowledge Work“ (wissensbasierter Arbeit) wandelt, bei der Menschen praktisch handeln müssen. In diesem Bereich ist die Nachfrage nach textbasierten Rubriken etwas gesunken, aber sie ist immer noch groß, und viele Probleme sind ungelöst.
03
Wo liegt die Grenze zwischen Bewertung und Datenverkauf?
Yiwen: Ich möchte die Entwicklung von Bewertungen in den letzten Jahren und ihre Beziehung zum Datenverkauf nachverfolgen. Viele denken, dass Benchmarks und Datenverkauf nicht vermischt werden dürfen. Scale AI hat zuvor „Humanity’s Last Exam“ (HLE) eingeführt. Kannst du uns diese Bewertung erläutern und erklären, wie sie mit Daten zusammenhängt?
