Warum fügt ChatGPT ständig kleine Werbeanzeigen für Pornografie und Glücksspiel in die Titel ein?
„Wir müssen uns vorstellen, dass Sisyphus ein …… Leiter für Unterhaltung für Erwachsene ist?!"
Wenn Sie ein häufiger Nutzer von ChatGPT sind, sind Sie seit August dieses Jahres sicherlich auf ein seltsames Phänomen gestoßen: Gelegentlich fügt ChatGPT am Ende der automatisch generierten Konversationstitel einige fremdsprachliche Wörter ohne klare Bedeutung oder Fragmente aus kleinen Glücksspiel- und Pornowerbungen hinzu.
Abbildung | OpenAI Developer Community@phdsx_666
Es ist nichts Ungewöhnliches, dass chinesische Konversationen englische Titel erhalten, aber das Einfügen von Kleinanzeigen in die Titel ist eine völlig neue Erscheinung.
Das hat die Redaktion interessiert. In diesem Feiertag haben wir eine Nacht lang die möglichen technischen Prinzipien dahinter vertieft und einige vorläufige Schlussfolgerungen gezogen:
Dies ist kein Test von Werbefunktionen durch ChatGPT, sodass Sie sich keine Sorgen machen müssen, dass eines Tages „Verrückte Wasserwelt“ in den Titeln auftaucht. Die schlechte Nachricht ist jedoch, dass die Ursache bis ins Jahr 2024 zurückverfolgt werden kann, und OpenAI, das derzeit stark unter Druck steht, scheint keine Lust zu haben, dieses technische Problem zu lösen, das das Nutzererlebnis beeinträchtigt.
Anmerkung: Aus Sicherheitsgründen werden einige Werbeschlüsselwörter im Folgenden **gefiltert**.
Eine unbegrenzt sich ausbreitende „Infektionskrankheit“
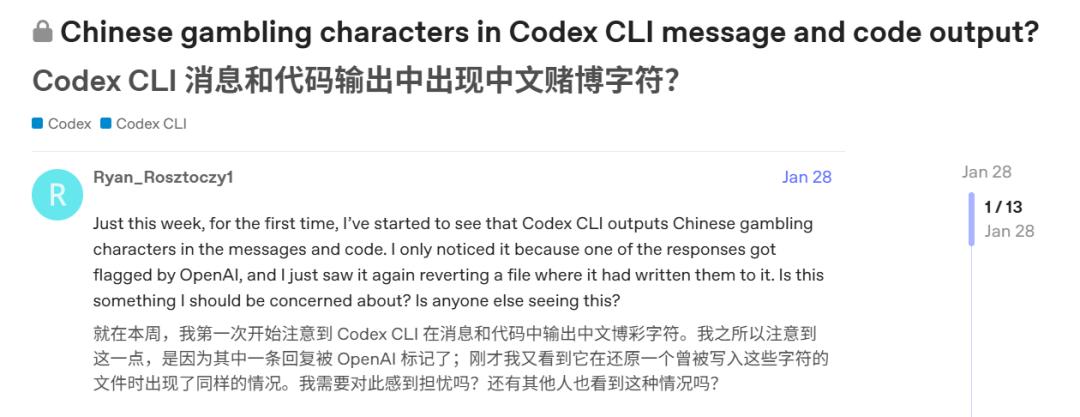
Die Überflutung anormaler Zeichenfolgen tauchte erstmals Anfang dieses Jahres in Codex CLI auf.
Ende Januar bemerkten einige Entwickler, dass bei Verwendung des GPT-5.3-Modells mit sehr langem Kontext die Nachrichten oder Codes, die Codex ausgab, mit kleinen chinesischen Glücksspielanzeigen durchsetzt waren, deren Form nicht von den Zeichen unterschieden werden konnte, die heute am Ende der Titel auftauchen.
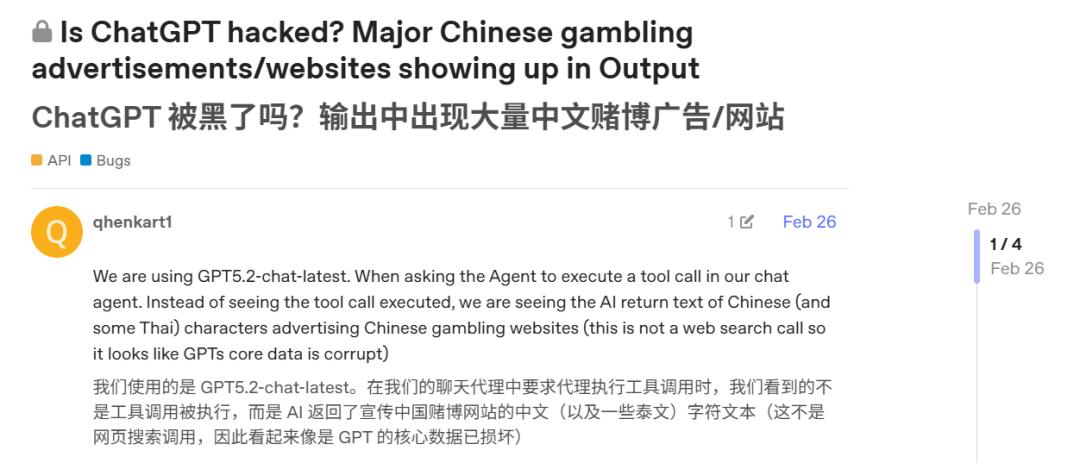
Im Februar begann diese „Infektionskrankheit“, sich auf die API-Seite auszubreiten. Als jemand GPT5.2-chat-latest für Funktionsaufrufe verwendete, führte das Modell den Aufruf nicht aus, sondern gab eine Reihe von Werbeslogans für Glücksspielseiten auf Chinesisch und wenig Thailändisch aus, wobei die System-Prompts sauber waren und keine Netzwerksuche aktiviert war.
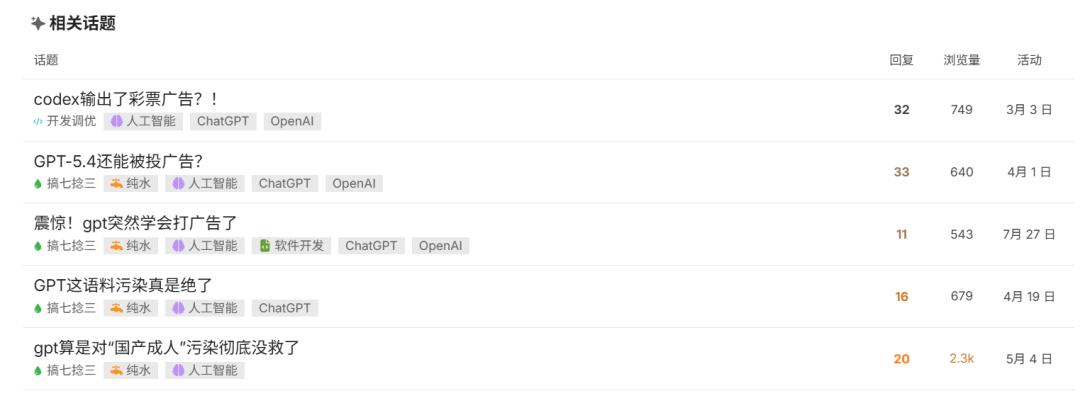
Im April war dieses Phänomen unter Entwicklern bereits alltäglich geworden. Jemand postete im Entwicklerforum LINUX DO um Hilfe und behauptete, dass der GPT-Proxy offenbar mit Malware infiziert sei und gelegentlich Lotteriewerbungen ausgibt. Die Antworten gratulierten ihm aber alle, dass er das echte GPT verwendet — die kleinen Werbungen sind der Beweis, dass das reine GPT „online Karten austeilt“.
Obwohl ähnliche Hilfeposts das offizielle Support-Forum von OpenAI überfluten und Opfer auf der ganzen Welt verteilt sind, hat die Behörde in einem halben Jahr nur das getan, was sie konnte: „gemeinsame Diskussionen anregen“ und neue Posts ständig schließen.
Erst am 25. Juli antwortete der offizielle Support von OpenAI zum ersten Mal positiv und sagte, dass „dieses Problem bereits bekannt ist“ und „voraussichtlich in zukünftigen Modellupdates behoben wird“.
Wurde es behoben? Die Antwort ist offensichtlich: Nein .
Wenn die anormalen Ausgaben von Codex und API nur im Entwicklerkreis verbreitet waren, dann konnte niemand mehr so tun, als gäbe es das Problem nicht mehr, als Glücksspielwerbung Mitte August in die Konversationstitel normaler Nutzer einzudringen begann — außer OpenAI selbst.
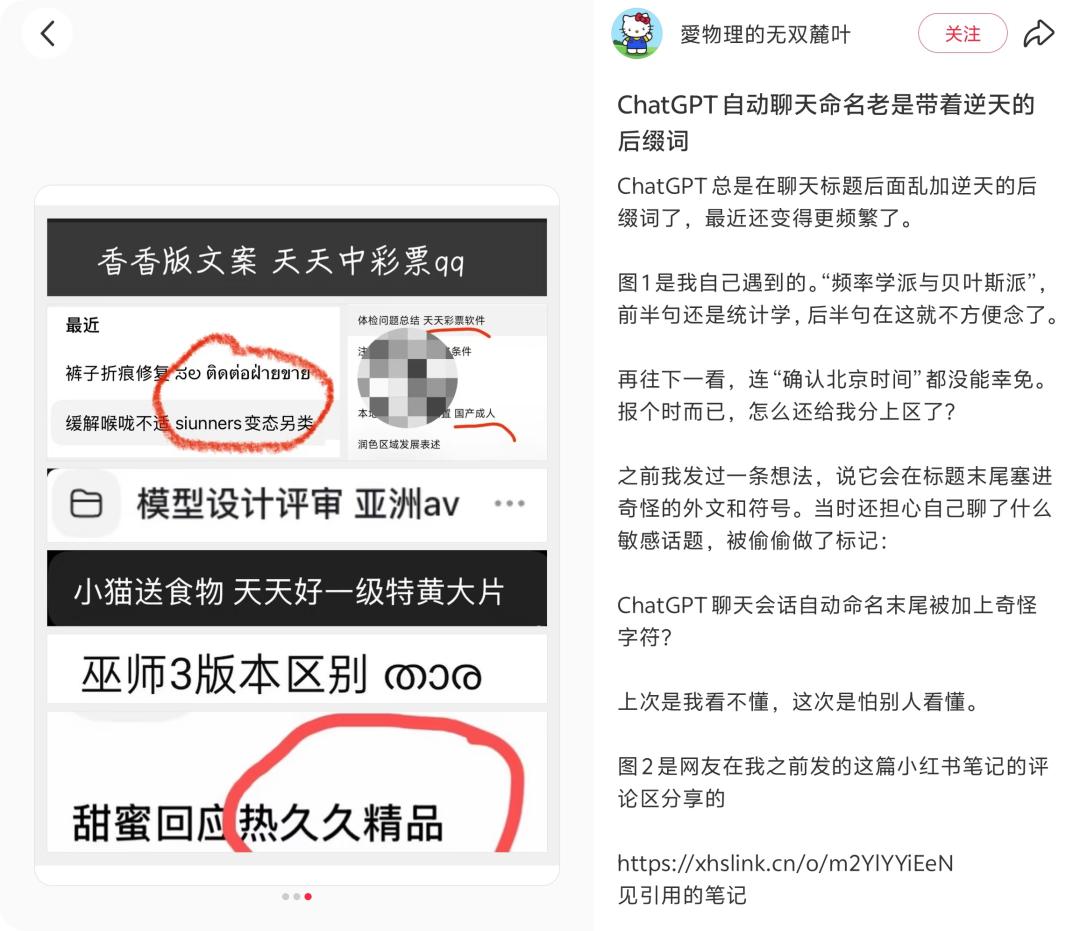
Abbildung | Xiaohongshu@Wushuang Luye, der Physik liebt
Man kann sagen, dass OpenAI in den letzten Monaten wirklich sehr beschäftigt war. Die GPT-5.6-Serie, das Astra-Modell und die GPT-6-Serie sind nacheinander erschienen, dazu die DevDay-Konferenz und die kürzliche Erklärung von Tibo „28 Tage lang kontinuierliche Updates“ …… Aber unter dem Deckmantel des Produktfortschritts hat sich OpenAI erfolgreich wie ein Strauß verhalten und die Fragen im offiziellen Forum nicht mehr beantwortet.
Natürlich glaube ich, dass OpenAI versucht, interne Optimierungen durchzuführen. Zumindest sind mit den Modellupdates die kleinen Werbungen im Text und in der Denkkette fast verschwunden; seit September ist die Häufigkeit von Werbungen in Titeln insgesamt deutlich gesunken.
Aber als Unternehmen, das die weltweit besten Forscher zusammenbringt, ist es nach mehr als einem halben Jahr immer noch nicht gelungen, die kleinen Werbungen vollständig zu beseitigen. Diese Tatsache scheint darauf hinzudeuten, dass die Ursache des Problems tiefer liegt.
Der Entstehungsprozess eines Titels
OpenAI hat den Generierungsmechanismus von Konversationstiteln nicht öffentlich erläutert. Die Paketerfassungsaufzeichnungen, die Techniker vor Jahren auf GitHub veröffentlicht haben, hinterlassen jedoch einige Hinweise:
Nachdem Sie die erste Runde der Unterhaltung gestartet haben, sendet die Webseite einen separaten Anfrage an /backend-api/conversation/gen_title, die die Konversations-ID und den Namen des Modells zur Generierung des Titels enthält. Anschließend generiert der Server basierend auf dem Inhalt der Konversation einen Titel mit dem angegebenen Modell und speichert den Titel als Metadaten der Unterhaltung.
Das heißt, prinzipiell ist die Titelgenerierung ein vom Hauptdialog unabhängiger Modellaufruf.
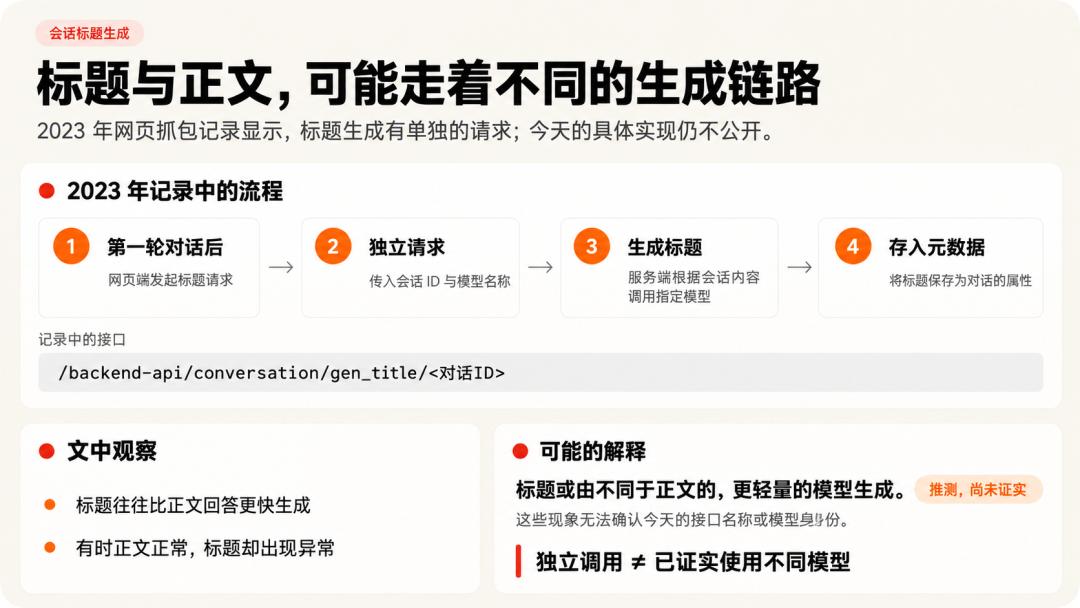
Aber diese Web-Paketaufzeichnung ist bereits ein „Kulturgut“ aus dem Jahr 2023, und wir können nicht wissen, wie der aktuelle Schnittstellenname lautet und welches Modell speziell für die Titelgenerierung verwendet wird.
Aber da die Titelgenerierung oft schneller als die Antwort im Text ist und es das Phänomen gibt, dass „der Text sauber ist, aber der Titel verunreinigt ist“, lässt sich schließen, dass für die Titelgenerierung möglicherweise ein leichteres Modell verwendet wird, das sich von dem für den Haupttext der Unterhaltung unterscheidet.
Welche Eigenschaften hat dieses Titelmodell? Glücklicherweise kann ein anormaler Titel, den ich bei der täglichen Nutzung angetroffen habe, einige Hinweise liefern —
Damals habe ich ChatGPT gebeten, eine Gruppe von Comics zu erstellen, aber das Titelmodell hat schließlich eine ganze Reihe von Texten ausgegeben:
Erstelle Comics ಚಿತ್ರ Ausstellung Adversarial? Warte, muss 1-4 chinesische Wörter sein. „Erstelle Liniencomics“ 4 Wörter.
Dieser Titel kann mehrere Dinge veranschaulichen: Erstens ist das „Selbstfragen und Selbstbeantworten“ ohne Subjekt in der Mitte ein typischer Stil der Denkkette des Inferenzmodells von OpenAI, was zeigt, dass das Titelgenerierungsmodell ein Inferenzmodell ist, das „zuerst nachdenkt, dann antwortet“. Zweitens lässt sich aus „muss 1-4 chinesische Wörter sein“ teilweise auf die Prompts schließen, die das System an das Modell übermittelt. Drittens wurde der Inhalt, der eigentlich in der internen Denkkette verbleiben sollte, ebenfalls ausgegeben, was zeigt, dass dieses Modell die Grenze zwischen „Nachdenken“ und „Antworten“ nicht gut unterscheiden kann.
Es gibt weitere Informationen, die den letzten Punkt bestätigen.
In einer anderen meiner Unterhaltungen war der anormale Titel, den das System schließlich ausgab, „Lese Kommentare zum Artikel #+#+#+#+“; zuvor hat ein japanischer Nutzer im offiziellen Support-Forum eine anormale Antwort von Codex gepostet: „Ist dieser Testplan in Ordnung? +#+#+#+#+#+assistant……“.
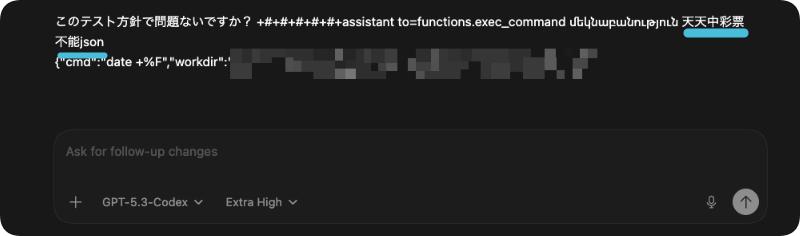
Abbildung | OpenAI Developer Community@Ruobin.chang
In diesen beiden ähnlichen Fällen sind „Lese Kommentare zum Artikel“ und „Ist dieser Testplan in Ordnung?“ bereits vollständige Titel/Sätze. Theoretisch sollte das Modell zu diesem Zeitpunkt ein spezielles „Steuerzeichen“ ausgeben, um die Antwort zu beenden. Aus unbekannten Gründen hat das Modell am Ende aber kein Steuerzeichen ausgegeben, sondern das Symbol-Token „#+#+#+#+“, das fälschlicherweise als Steuerzeichen angesehen werden könnte.
Mit anderen Worten, dieses Modell weiß oft nicht, wie es eine Aufgabe angemessen beenden kann.
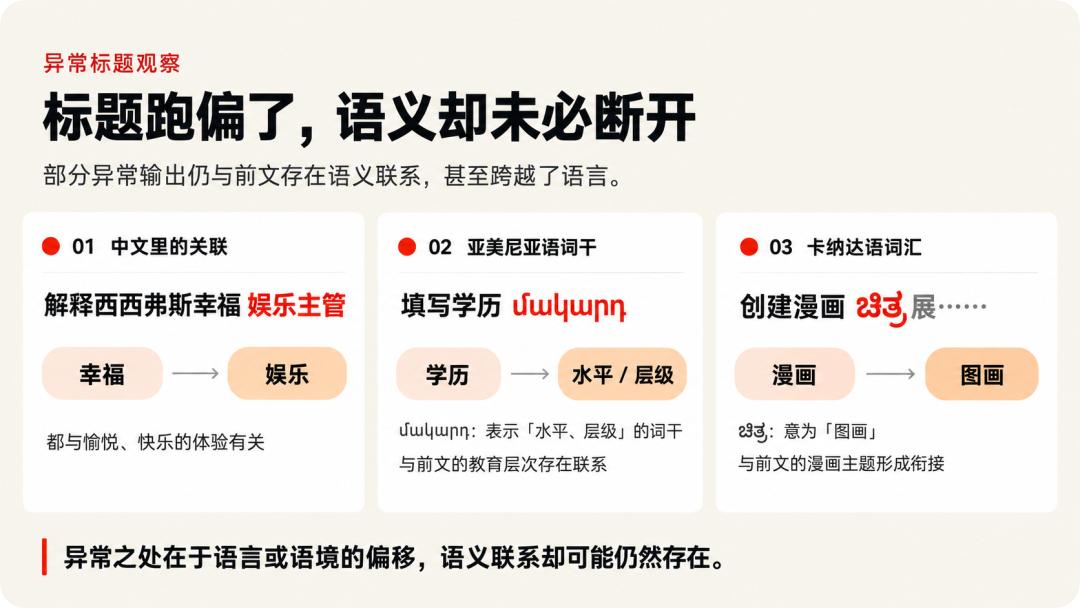
Auf der anderen Seite habe ich bei den gesammelten Fällen anormaler Titel auch festgestellt, dass zwischen dem „normalen vorderen Teil“ und dem „anormalen hinteren Teil“ einiger Titel eine verborgene semantische Verbindung besteht.
Zum Beispiel gibt es im Titel „Erkläre das Glück von Sisyphus Leiter für Unterhaltung“ eine semantische Verbindung zwischen „Glück“ und dem nachfolgenden „Unterhaltung“; der hintere Teil von „Gib Bildungsniveau ein մակարդ“ ist der armenische Wortstamm für „Niveau, Stufe“, und natürlich besteht eine Korrelation zwischen Bildungsniveau und Stufe; und in dem gerade erwähnten „Erstelle Comics ಚಿತ್ರ Ausstellung ……“ ist „ಚಿತ್ರ“ das Wort für „Bild“ in Kannada, das sich an das vorherige „Comic“ anschließt.
Zusammenfassend lässt sich schließen: Der Titel wird von einem Inferenzmodell generiert, und dieses Inferenzmodell hat ein Problem bei dem Schritt, in dem es den Titel fertig geschrieben hat und die Generierung beenden sollte, was oft zu einem fehlgeschlagenen Abschluss führt.
Das Modell, das die Generierung nicht erfolgreich beenden konnte, gibt dann basierend auf der Wahrscheinlichkeit das „nächste Wort“ weiter aus. Es kann ein fremdsprachliches Token sein, das semantisch dem ursprünglichen Titel ähnelt, ein Token für Pornografie- und Glücksspielwerbung im Vokabular, ein Symbol-Token, das fälschlicherweise als Steuerzeichen angesehen wird, oder sogar die Denkkette des Modells selbst, was schließlich zu den verschiedenen anormalen Titeln führt, die wir sehen.
Wenn ein „schwaches Modell“ auf ein „verunreinigtes Vokabular“ trifft
Die obige Vermutung kann erklären, warum die Modellgenerierung fehlschlägt, aber nicht erklären, warum das Fehlschlagen meistens dazu führt, dass „Pornografie- und Glücksspielwerbung“ ausgegeben wird.
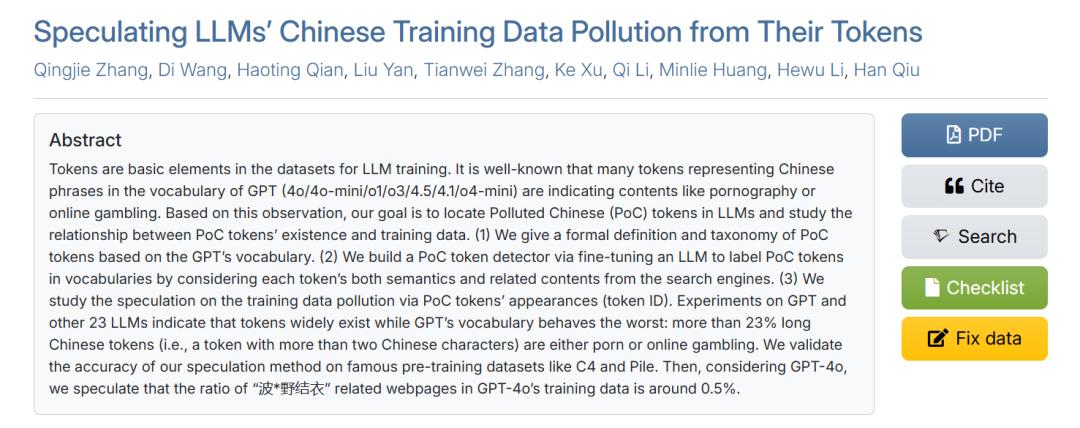
Glücklicherweise hat ein letztes Jahr auf der Top-Konferenz für natürliche Sprachverarbeitung EMNLP veröffentlichter Aufsatz mit dem Titel „Speculating LLMs’ Chinese Training Data Pollution from Their Tokens“ die Gründe systematisch erläutert, warum verschiedene Werbeschlüsselwörter in der GPT-Modellreihe überhandnehmen.
Bevor wir eine weitere „Diagnose“ stellen, ist es notwendig, das allgemeine Funktionsprinzip großer Modelle zu verstehen —
Die von uns eingegebenen Prompts durchlaufen zuerst den „Tokenizer“, der den Satz in einzelne Token zerlegt; jeder Tokenizer hat ein Vokabular im Inneren, das wie ein „Token-Wörterbuch“ funktioniert und jedem möglichen Token eine numerische ID zuweist. Was schließlich an das Modell übergeben wird, ist ein Array aus diesen numerischen IDs.