Claude erreicht die volle Punktzahl, GPT 99 Punkte – das Team von He Kaiming hat die AGI-Prüfung vollständig durchbrochen.
Das neue Paper von He Kaimings Team sorgt auf X für Furore!
Das VISTA-Paper, das während der Nationalfeiertage gerade auf arXiv veröffentlicht wurde, zeigt: In den vergangenen sechs Monaten wurden die weltweit leistungsstärksten großen Modelle alle mit verbundenen Augen zum AGI-Prüfungsraum geführt.
Dasselbe Claude Opus 5 erzielte im offiziellen Standardtest nur eine armselige Punktzahl von 40.
Das Team von He Kaiming hat ihm lediglich die Augenbinde abgenommen, es die Spielszene direkt betrachten lassen und ihm ein „Fotoalbum“ überreicht, in dem es jederzeit zurückblättern kann.
Als Ergebnis schlug Claude alle 25 öffentlichen Spiele von ARC-AGI-3 vollständig durch und erzielte die volle Punktzahl von 100!
Und die Anzahl der Schritte, die es unternahm, war sogar mehr als halb so gering wie die von Menschen, die das Spiel zum ersten Mal spielten.
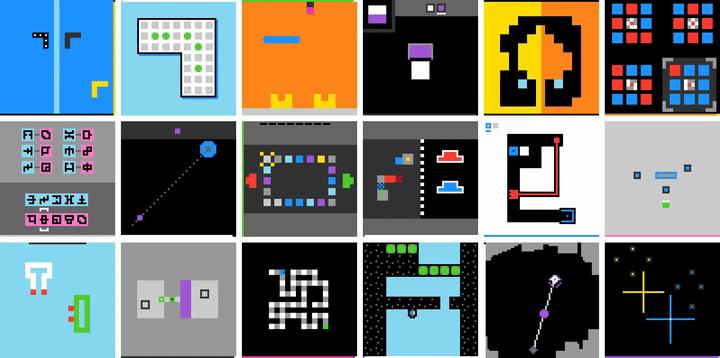
18 Spiele, die es noch nie zuvor gesehen hat, ohne dass ihm jemand eine einzige Erklärung gab: Die KI hat die Regeln selbst herausgefunden und sich bis zum Ende durchgearbeitet
Der bekannte KI-Blogger Mark Kretschmann schrieb auf X: „Wenn man einem Agenten die Fähigkeit gibt, ‚noch einmal hinzusehen‘, kann der Unterschied enorm groß sein.“
In den vergangenen Monaten haben verschiedene Code-Gurus Tausende von Codezeilen geschrieben, um einen Weltsimulator zu erstellen, um ARC-AGI-3 vollständig zu durchschlagen.
Das Team von He Kaiming kam zu dem Schluss: Das Gehirn des großen Modells ist längst leistungsfähig genug, was es behindert, sind die Augen und das Gedächtnis.
Große Modelle wurden ein halbes Jahr lang von einer digitalen Tabelle ausgebremst
ARC-AGI-3 ist das AGI-Prüfungsblatt, das François Chollet, der Erfinder von Keras, und die ARC Prize-Stiftung im März dieses Jahres veröffentlicht haben. Es besteht aus einer Reihe interaktiver Pixel-Minispiele, bei denen es zu Beginn keine Erklärungen oder Regeln gibt – der Spieler muss alles selbst durch Ausprobieren herausfinden.
Der Bewertungsalgorithmus ist extrem streng. Die Behörden haben fast 500 menschliche Anfänger zum Testen eingeladen: Die KI muss nicht nur das Spiel abschließen, sondern auch nicht mehr Schritte als die Menschen unternehmen, um die volle Punktzahl zu erreichen.
Aber was das offizielle Prüfungssystem dem großen Modell überreicht, ist nur eine 64×64 große digitale Tabelle. Die kleinen Figuren, Mechanismen und Wege, die Menschen sehen, werden im Modell zu nur 4096 Zahlen reduziert.
Das entspricht der Situation, in der man mit verbundenen Augen jemandem beim Vorlesen von Koordinaten zuhört, um Super Mario zu spielen.
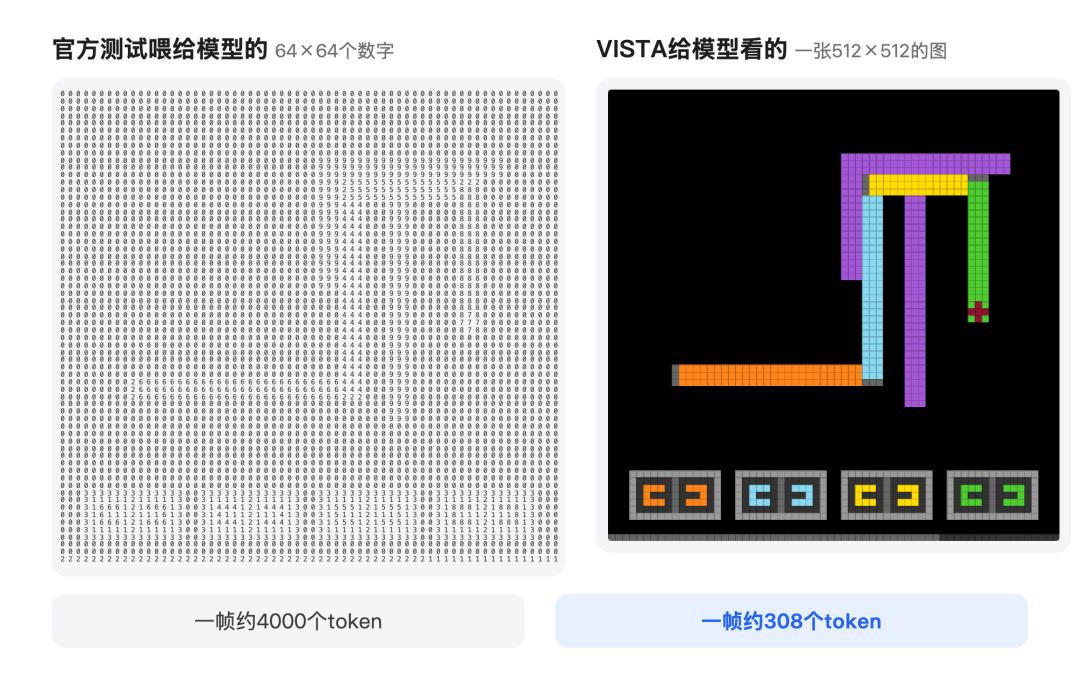
Dieselbe Bildsequenz: Links ist die digitale Tabelle, die das offizielle System dem Modell überreicht, rechts ist das Bild, das VISTA es direkt betrachten lässt
Das Erste, was das VISTA-Team getan hat, war, die digitale Tabelle wieder durch Bilder zu ersetzen.
Ohne irgendetwas anderes zu ändern, stieg die Punktzahl von GPT-5.6 Sol von 13,33 auf 47,32.
Das Betrachten von Bildern spart zudem Rechenleistung. Eine digitale Zelle verbraucht etwa 4000 Token, während ein 512×512 großes Bild nur 308 benötigt.
Nach einer Spielrunde verbraucht die Textversion 71,9 Millionen Token, die Bildversion nur 30,7 Millionen, und die Punktzahl ist sogar höher.
Allein durch das Ausstatten mit echten Augen gewann das große Modell 34 Punkte zurück.
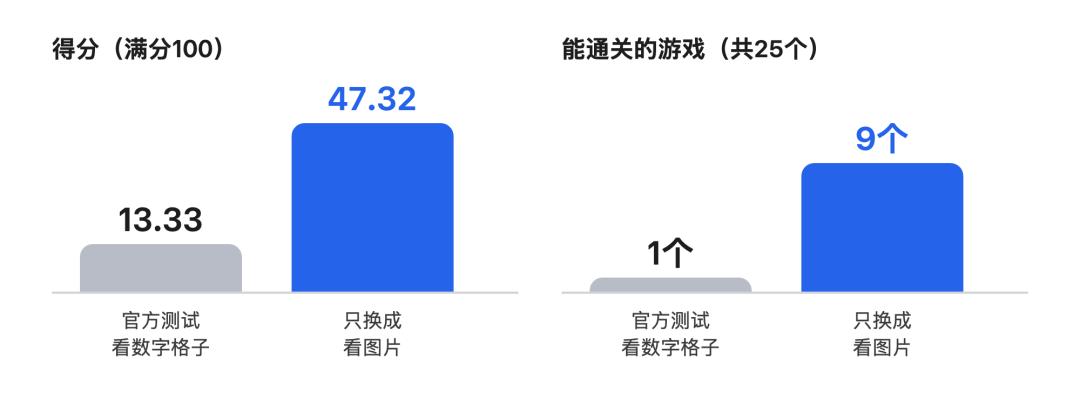
Allein das Ersetzen von Zahlen durch Bilder ließ die Punktzahl von GPT-5.6 Sol mehr als verdreifachen, und die Anzahl der Spiele, die es abschließen konnte, stieg von 1 auf 9
Die KI mit einem fotografischen Gedächtnis ausstatten: Ein Schritt bringt 24 zusätzliche Punkte
Nur sehen zu können reicht nicht aus. Ein Spiel kann leicht Hunderte von Schritten umfassen, und das häufige Problem multimodaler Modelle ist: Sie sehen ein Bild einmal, löschen es sobald der Kontext voll ist oder komprimieren es zu einigen Textzusammenfassungen.
Wenn das Modell dann Details nachprüfen möchte, ist diese Bildsequenz längst verschwunden.
Der Kernvorteil von VISTA ist ein verlustfreies visuelles Gedächtnis-„Fotoalbum“.
Jede Bildsequenz, die das Spiel ausgibt, einschließlich der Animationsframes, wird nummeriert und originalgetreu gespeichert. Das Modell kann jede beliebige Sequenz jederzeit über die Funktion inspect abrufen, mehrere Frames nebeneinander vergleichen, Ecken vergrößern und mit read_pixels die genaue Farbe auslesen.
Das Wichtigste ist: Das Blättern im Fotoalbum zählt nicht als Schritt, nur echte Aktionen im Spiel werden gezählt.
Das Team nennt diesen Mechanismus „explizite Aufmerksamkeit“: Welchen Frame es anschaut und welchen Bereich es betrachtet, entscheidet das Modell völlig selbst.
Es trägt zudem zwei Notizbücher bei sich: In GUIDE.md werden die Spielregeln notiert, WORKING.md dient als Notizblock.
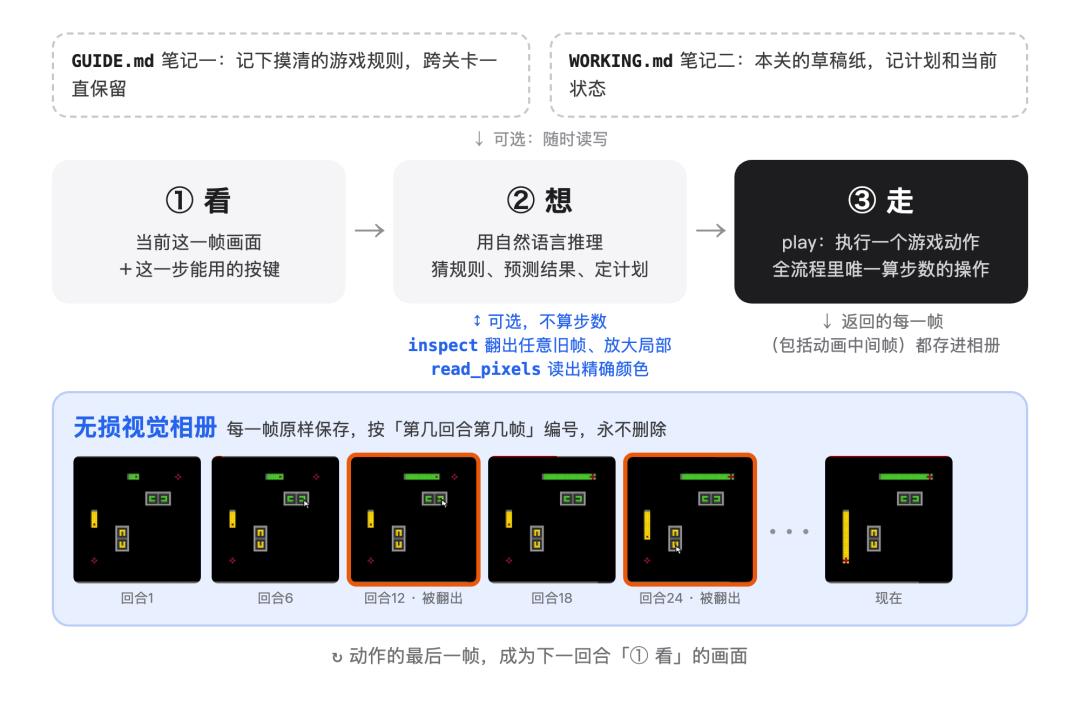
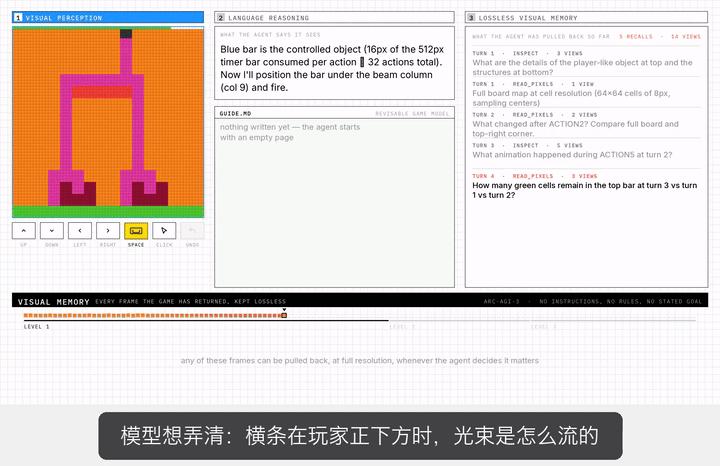
In einer Runde von VISTA betrachtet das Modell das Bild, überlegt sich die Regeln, blättert bei Bedarf im Fotoalbum und führt schließlich einen Schritt aus
Das Paper dokumentiert einen sehr „menschenähnlichen“ Aktionsmoment.
In Level 3 des Spiels BP35 erscheint ein orangefarbenes Quadrat auf dem Bildschirm. Das Modell klickt darauf, und das orangefarbene Quadrat verwandelt sich in ein X.
Es hält zuerst an, ruft den letzten Frame der vorherigen Runde und die drei gerade angezeigten Animationsframes ab und spielt sie nebeneinander ab.
Einige Runden später stellt es fest, dass das Klicken auf X das orangefarbene Quadrat wieder erscheinen lässt. Es schreibt sofort: „Das ist das Werkzeug, das ich brauche. Damit baue ich eine Decke, um den tödlichen Aufstieg zu blockieren.“
In diesem Level braucht ein Mensch, der es zum ersten Mal spielt, 44 Schritte – es benötigt nur 34 Schritte.
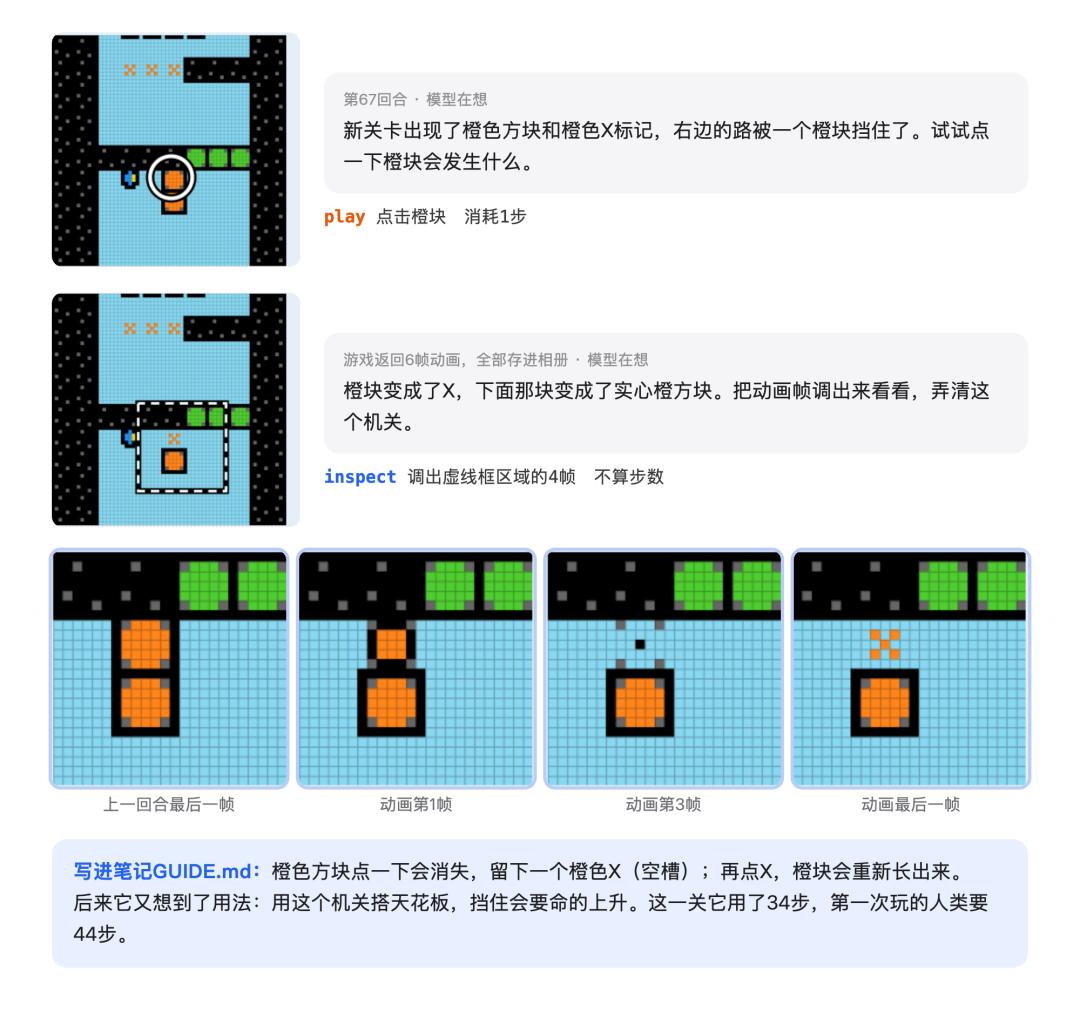
Nach dem Klick auf das orangefarbene Quadrat ruft das Modell die vier Animationsframes vor und nach dem Klick ab, vergleicht sie Frame für Frame und macht erst weiter, wenn es sie verstanden hat
Bei Pac-Man verschwindet ein Bohne im Labyrinth nach dem anderen, wenn man sie isst. Das Modell kehrt in der 13. und 36. Runde zweimal zwangsläufig zum ersten Frame des Spielanfangs zurück, um die Labyrinthkarte zu notieren und den Weg zu finden.
Viele reagieren zuerst darauf, dem Modell mehr Kontext und mehr Pixel zu geben. Die Tests im Paper zeigen, dass beide Methoden nicht funktionieren.
Wenn der Kontext von den standardmäßigen 200K auf 780K erweitert wird, steigt die Anzahl der Token pro Runde von 30,7 Millionen auf 105,7 Millionen, aber die Punktzahl sinkt von 99 auf 93,9.
Bei Bildern ist es genauso: Wenn man sie auf das 16-fache vergrößert, steigt die Anzahl der Token pro Frame auf 1229, die Punktzahl sinkt auf 88,3; bei einer 4-fachen Vergrößerung beträgt die Punktzahl 99,7, was höher ist als bei der standardmäßigen 8-fachen Vergrößerung.
Die Erklärung im Paper lautet: Wenn das Bild zu groß ist, belegen die zusätzlichen Token den Kontext unnötig, ohne dass das Modell dadurch besser sehen kann.
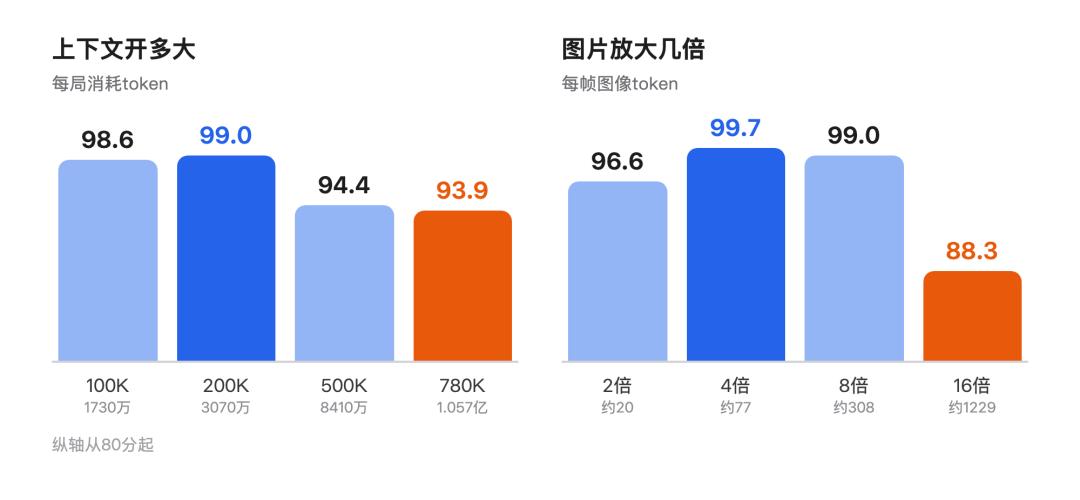
Wenn der Kontext von 200K auf 780K erweitert und das Bild von 8-fach auf 16-fach vergrößert wird, sinkt die Punktzahl statt zu steigen
Mehr ist nicht unbedingt besser – das gesamte Design von VISTA folgt diesem Prinzip. Das Team schreibt in seinem Blog, dass es bewusst auf Minimalismus abzielt.
Im System gibt es kein einziges neu trainiertes Modell, der Prompt für jedes Spiel ist derselbe: Insgesamt vier Sätze, kein einziges Wort erklärt ihm, wie man das Spiel konkret spielt.
Alle Prompts, die VISTA dem Modell gibt
Die Code-Fraktion hat den ganzen Sommer über gearbeitet – es hat mit einer Seite Notizen gleichgezogen
Die hochbewerteten Lösungen, die in diesem Sommer ARC-AGI-3 durchschlagen haben, wie Tycho und Schema, lassen das große Modell für jedes Spiel ein ausführbares Programm schreiben, um einen Simulator zu erstellen, mit dem man wiederholt ausprobieren kann.
Allein für das Dame-Spiel LF52 hat Schema ganze 4000 Zeilen Python-Code geschrieben.
Das Modell in VISTA hat dagegen nur drei Sätze in natürlicher Sprache in sein Notizbuch geschrieben, um dieselbe Regel zu meistern.
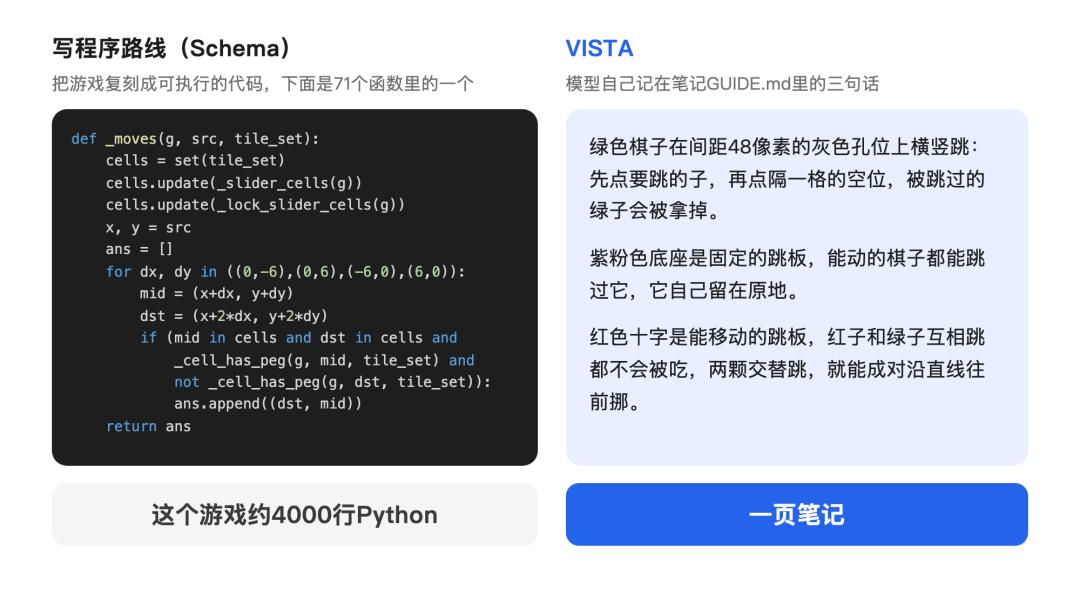
Dieselbe Dame-Regel: Links ist der Code des Programm-Ansatzes (insgesamt etwa 4000 Zeilen), rechts sind die drei Notizen, die das VISTA-Modell selbst verfasst hat
Laut dem Paper ist VISTA das erste System, das ohne Programmieren eine volle oder nahezu volle Punktzahl auf ARC-AGI-3 erreicht hat.
Dieser Punkt ist außerhalb von Spielen noch wichtiger: In der realen Welt kann niemand im Voraus einen 4000-Zeilen-Simulator für dich schreiben.
Claude Opus 5 hat alle 183 Level der 25 Spiele abgeschlossen, für jedes Spiel erzielte es 100 Punkte, unternahm insgesamt 7302 Schritte – das ist nur 0,43-fache der Schrittanzahl von Menschen.
Auch GPT-5.6 Sol hat alle Level abgeschlossen und 99 Punkte erreicht.
Für das Spiel m0r0 braucht ein Mensch 1107 Schritte, Claude nur 219 Schritte. Beide Ergebnisse haben eine Wertungskarte auf der offiziellen Plattform von ARC Prize.
