Karpathys neuer Trick! Die Luftfahrtvorschriften von vor 40 Jahren haben die geschwätzige, viel Unsinn redende KI gerettet.
AI neigt wirklich übermäßig dazu, leere und inhaltsarme Ausdrücke zu verwenden.
Aus diesem Grund hat Karpathy eigens eine Reihe von Techniken geteilt, die darauf abzielen, die Ausgaben großer Sprachmodelle zunehmend verständlicher zu gestalten.
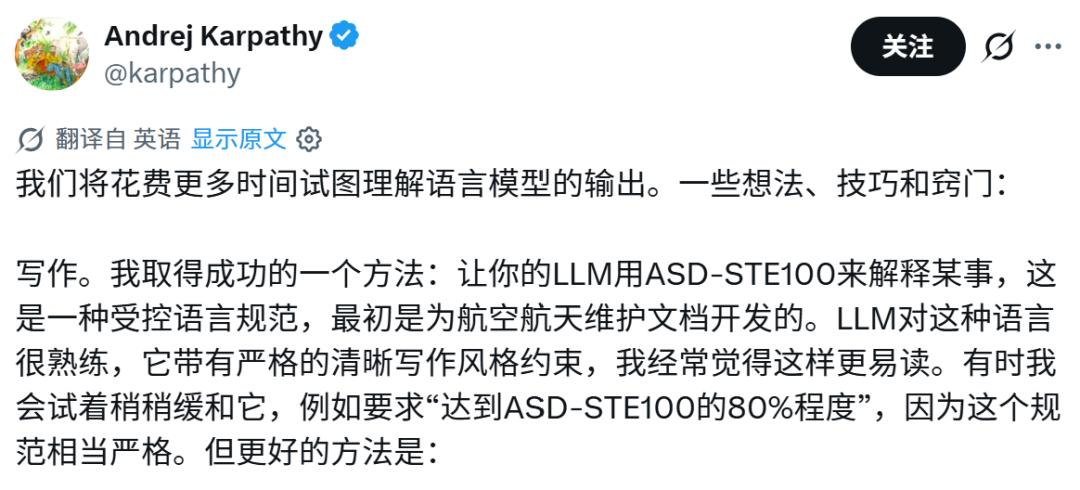
Link: https://x.com/karpathy/status/2105819303471976479
Die Methode ist etwas unerwartet.
Denn Karpathy greift auf einen Satz von Luftfahrt-Schreibstandards zurück, der vor 40 Jahren entwickelt wurde.
Der 40 Jahre alte Luftfahrtstandard macht die Ausgaben großer Modelle klar und lesbar
In den 1970er Jahren stand die europäische Luftfahrtindustrie vor einem zunehmend internationalisierten Wartungssystem. Englische Wartungshandbücher mussten von Technikern aus verschiedenen Ländern und mit unterschiedlichen Sprachhintergründen verwendet werden. Dies erforderte, dass jeder Satz im Wartungshandbuch nur eine einzige Interpretation zulässt.
Daher begann die Luftfahrtindustrie, aktiv Einschränkungen für die englische Sprache festzulegen. Dieses kontrollierte Englisch entwickelte sich später schrittweise zu ASD-STE100. Die neueste Ausgabe 9 enthält 53 Schreibregeln, ergänzt durch etwa 900 zugelassene Grundwörter sowie etwa 1200 Wörter, die vermieden werden sollen und für die alternative Ausdrücke bereitgestellt werden.
Die Regeln sind sehr einfach:
Halten Sie einen prozeduralen Anweisungssatz möglichst auf weniger als 20 Wörter;
Weisen Sie nur eine einzige Aktion pro Satz zu;
Verwenden Sie möglichst die Aktivform, um klar anzugeben, wer was tut;
Verwenden Sie für dasselbe Konzept möglichst durchgehend denselben Begriff.
Große Modelle verwenden oft häufig Synonyme, um die Sprache „reicher“ zu gestalten, aber in vielen Fällen führt dieser Wechsel zu gewissen Leseschwierigkeiten.
Der Gedanke von ASD-STE100 ist genau das Gegenteil. Es strebt keine Varianz im Wortschatz an und ermutigt auch keine kunstvollen langen Sätze. Sobald ein Begriff für etwas festgelegt ist, wird dieser Begriff durchgehend verwendet.
Karpathy hat festgestellt, dass die Ausgaben klarer und lesbarer werden, wenn man große Sprachmodelle an diesen Standard bindet.
Allerdings verlangt er nicht wirklich, dass das Modell das gesamte Luftfahrthandbuch streng einhält. Manchmal fordert er dazu auf, „80 % von ASD-STE100“ umzusetzen.
Die vollständige Version von ASD-STE100 ist schließlich für professionelle technische Dokumente konzipiert. Wenn man sie im Alltag stur vollständig einhält, wirkt der Inhalt schnell zu steif.
Doch unmittelbar danach meinte Karpathy auch, dass Text nicht die beste Lösung ist. Wenn man etwas zeichnen kann, warum sollte man dann alles in Worten ausdrücken?
Sein zweiter Vorschlag lautet, das Modell direkt dazu zu bringen, Diagramme oder Bilder zu generieren.
Grafiken helfen Lesern, Informationen zu strukturieren. Selbst wenn die Grafik nur für Sie persönlich erstellt wird und nach dem Betrachten niemand mehr verwendet, lohnt es sich trotzdem, sie zu generieren.
Es gibt sogar eine noch bessere Form: Webseiten, lassen Sie das Modell direkt „als HTML-Ausgabe“ erstellen.
Da Codemodelle zunehmend gut mit Frontend-Entwicklung umgehen können, ist das Ergebnis keine statische Textpassage mehr, sondern eine Seite mit Layout, Animationen und sogar interaktiven Funktionen.
Nehmen wir an, Sie möchten die Lernrate in neuronalen Netzen verstehen. Text kann Ihnen erklären, dass eine zu geringe Lernrate zu langsamer Konvergenz führt und eine zu hohe Lernrate zu Oszillationen führen kann. Eine Webseite kann direkt einen Schieberegler einfügen: Sie ändern die Lernrate selbst und beobachten, wie ein kleiner Ball die Abstiegsbahn in Echtzeit anpasst.
In diesem Fall erklärt das Modell nicht mehr nur den Inhalt. Es erstellt kurzzeitig ein kleines Werkzeug, das Ihnen hilft, das Konzept zu verstehen.
Jemand im Kommentarbereich ergänzte einen ähnlichen Ansatz: Bei mathematischen und technischen Inhalten können Sie das Agent direkt dazu auffordern, einen technischen Bericht im PDF-Format mit TeX auszugeben. Formeln, Code, Diagramme und Abbildungen erhalten so eine viel passendere Formatierung.
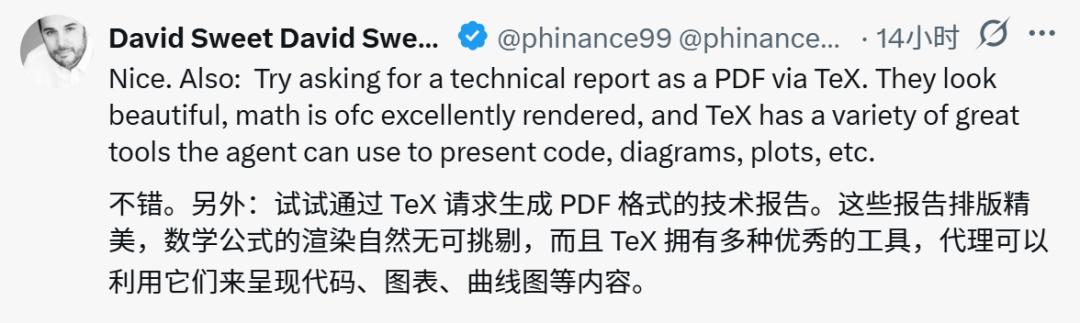
Das bedeutet, dass Benutzer das Modell auffordern können, je nach Fragestellung die am besten verständliche Ausdrucksform zu wählen.
Zuletzt nennt Karpathy die Form, die er derzeit am vielversprechendsten findet: Generieren Sie vollständig angepasste Erklärvideos für jedes beliebige Thema.
Er nennt ein sehr konkretes Beispiel: Lassen Sie das Modell „ein Erklärvideo im Stil von 3b1b erstellen“ und rufen Sie dann die ElevenLabs API auf, um den Sprechertext zu generieren. Wenn Sie keine API zur Verfügung haben, kann das Modell auch nach kostenlosen Alternativen suchen, die lokal ausgeführt werden können.
3b1b steht hier für 3Blue1Brown. Sein typisches Merkmal besteht darin, abstrakte Konzepte Schritt für Schritt mit programmierten Animationen „darzustellen“ und dazu Erläuterungen zu geben.
Alle diese Techniken zielen auf ein gemeinsames Thema ab: Die bereits vom Modell erledigte Arbeit so umzugestalten, dass sie für Menschen leichter verständlich ist.
Das ist genau die Schlussfolgerung, die Karpathy am Ende zieht.
Da große Sprachmodelle immer leistungsfähiger werden, werden immer mehr konkrete Aufgaben selbstständig vom Modell erledigt. Die menschliche Arbeit verlagert sich weiter nach oben und besteht zunehmend aus Überwachung, Prüfung und Verständnis.
Glücklicherweise kann KI den Menschen auch weiterhin bei diesem Teil der Arbeit unterstützen. Da Intelligenz und Code immer kostengünstiger werden, können wir für sehr spezifische Probleme kurzfristig Inhalte generieren, die es früher nicht wert waren, extra erstellt zu werden.
Karpathy nennt sie: large, custom, discardable software artifacts – große, angepasste, nach der Nutzung wegwerfbare Software-Ergebnisse.
Tibo hat die Methode sofort praktisch getestet
Unmittelbar nachdem Karpathy diesen Vorschlag veröffentlicht hatte, veröffentlichte Tibo die Ergebnisse eines eigenen Praxistests.
Er gab nur eine sehr einfache Aufgabe vor: „Erklären Sie, wie Shazam funktioniert.“
Daraufhin generierte das Modell ein spezielles Video, das das Funktionsprinzip von Shazam erläutert.
Einige Nutzer stellten nach dem Test fest, dass der Effekt überraschend deutlich ist. Insbesondere bei komplexeren HTML-Artefakten wird die Informationsstruktur klarer, wenn man die Einschränkungen im Stil von ASD-STE100 hinzufügt.
Andere hingegen verglichen gewöhnliche Antworten mit Versionen, die nach ASD-STE100 erstellt wurden, und kamen zu dem Schluss: „Es scheint kaum einen Unterschied zu geben.“
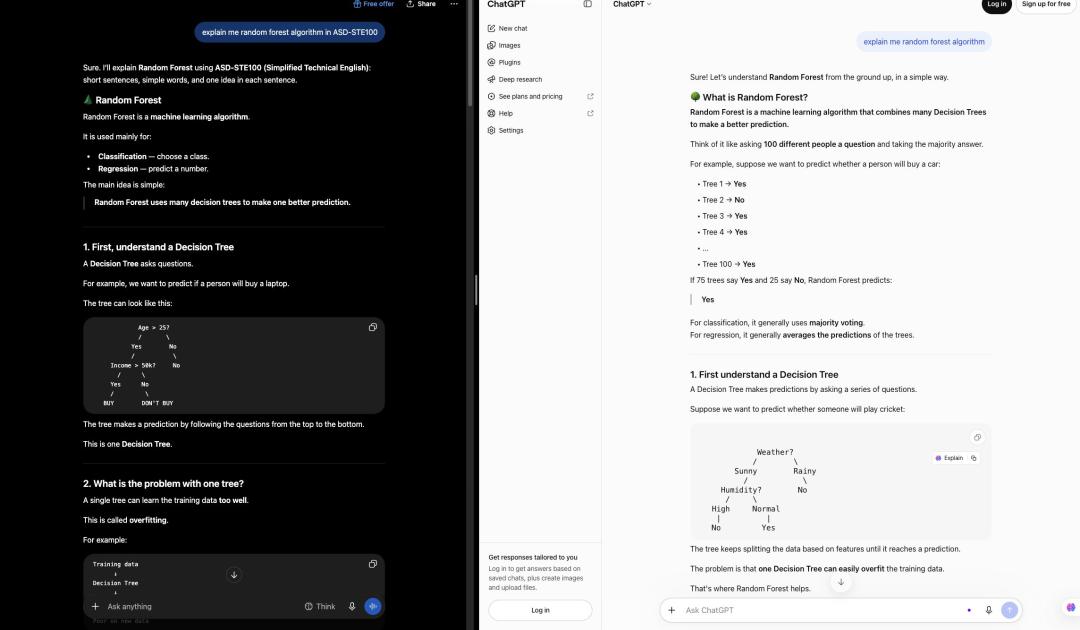
Das ist nicht verwunderlich. Wenn Sie nur eine sehr einfache Frage stellen, muss das Modell normalerweise nur wenige Sätze als Antwort ausgeben. Selbst wenn Sie einen zusätzlichen Standard anwenden, wird sich das Ergebnis nicht drastisch verändern.
Dieser Standard eignet sich besser für Szenarien wie lange technische Erklärungen, mehrstufige Abläufe oder Informationen, die zwischen verschiedenen Agenten übermittelt werden. Je komplexer der Inhalt ist, desto deutlicher wird der Effekt sichtbar.
Einige Nutzer stellten außerdem fest, dass die vollständige Übernahme aller Regeln möglicherweise immer noch zu streng ist. Ein besserer Ansatz besteht darin, nur die Regeln auszuwählen, die wirklich zu Ihrem eigenen Nutzungsszenario passen.
Daraufhin entwickelte jemand eine Anwendungsmethode: Lassen Sie das Modell zufällig zehn Interaktionen zwischen Ihnen und ihm aus der vergangenen Woche auswählen und diese dann einzeln nach ASD-STE100 prüfen.
Welche Antworten waren damals nicht klar genug? Wo sind unnötige Mehrdeutigkeiten aufgetreten? Würde die Anwendung einer bestimmten Regel die jeweilige Unterhaltung verständlicher machen? Schließlich schreiben Sie die wirklich wirksamen Regeln in die benutzerspezifische AGENTS.md-Datei ein.
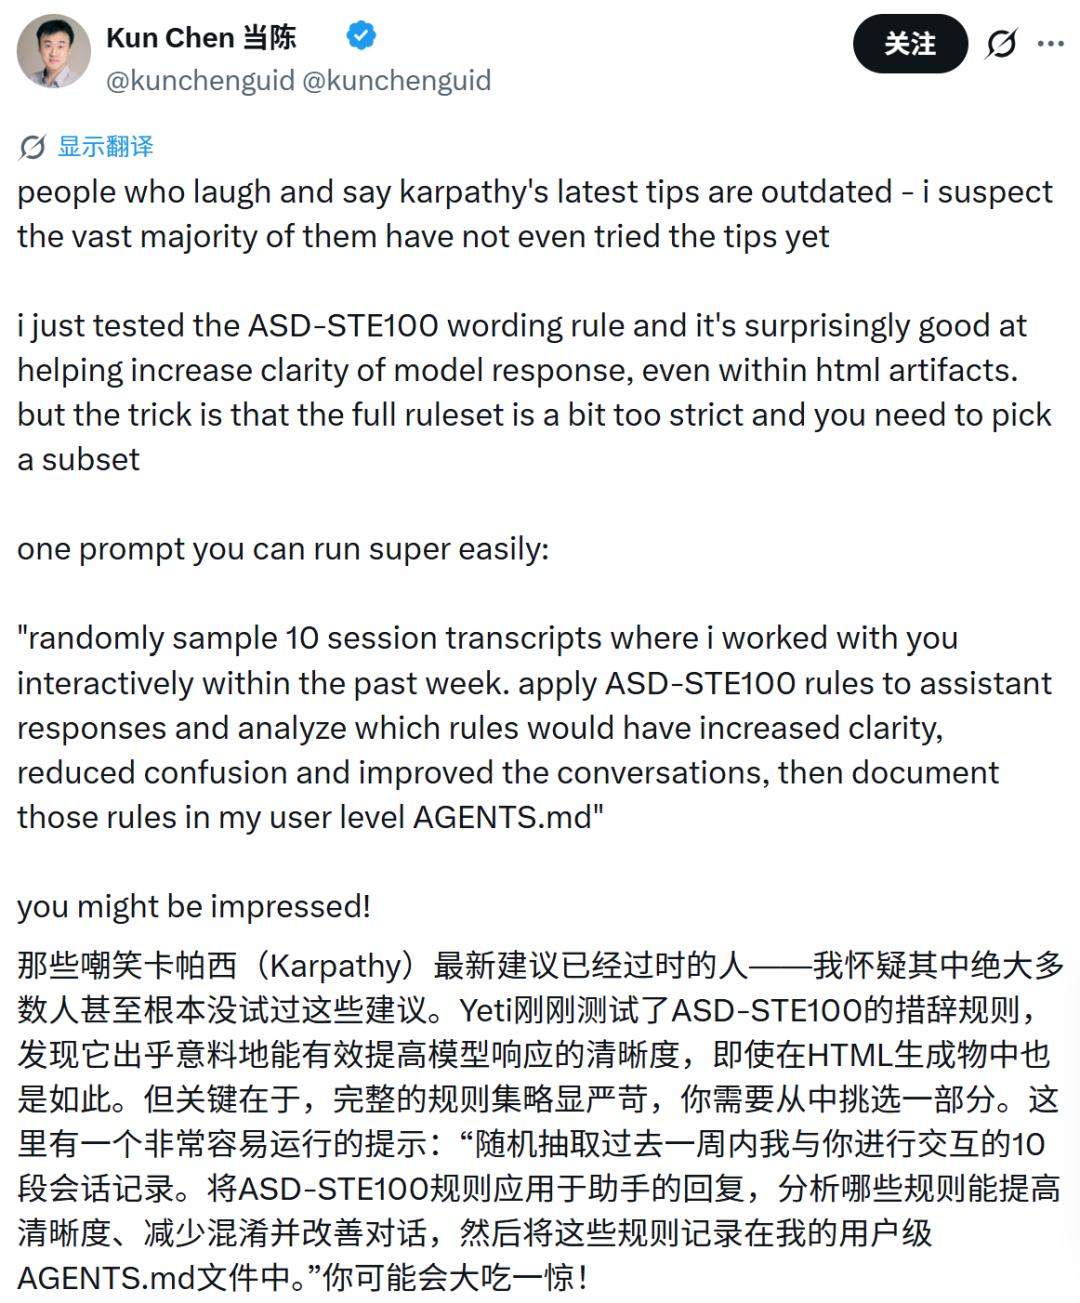
Tatsächlich hat jemand ASD-STE100 bereits vor drei Monaten als Open-Source-Skill veröffentlicht.
github: https://github.com/danyuchn/asd-ste100-skill
asd-ste100-skill wendet diesen Ansatz weiter auf Szenarien wie Tool-Beschreibungen, Fehlermeldungen, Anweisungen zwischen Agenten und System-Prompts an. Es gibt sogar zwei separate Modi.
Der eine ist Strict, geeignet für Inhalte mit höheren Fehlinterpretationskosten wie Verfahrensschritte, Tool-Beschreibungen und Anweisungen zwischen Agenten;
Der andere ist STE-flavored, besser geeignet für normale Szenarien wie README-Dateien und erklärende Texte. Er behält Prinzipien wie angemessene Satzlänge, aktive Ausdrucksweise und klare Struktur bei, sperrt den Wortschatz aber nicht vollständig.
Das ist im Grunde die weitergehende Produktisierung von Karpathys Aussage „80 % von ASD-STE100“: Nicht für alle Bereiche ist der strengste Standard erforderlich.
Einige Entwickler haben direkt einen sofort nutzbaren Claude Skill erstellt und den Code auf GitHub veröffentlicht.
github: https://github.com/danyuchn/asd-ste100-skill
Da Karpathy die Techniken bereits geteilt hat, können Sie sie auch gleich ausprobieren.
Referenzlinks:
https://x.com/karpathy/status/2105819303471976479
https://www.asd-ste100.org/
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Machine Heart“ (ID: almosthuman2014), Autor: KI-Forscher, veröffentlicht mit Genehmigung von 36Kr.