Jev wurde vom Thron abgesetzt, das Open-Source-Entscheidungsmodell von StartLux China sprang auf den ersten Platz.
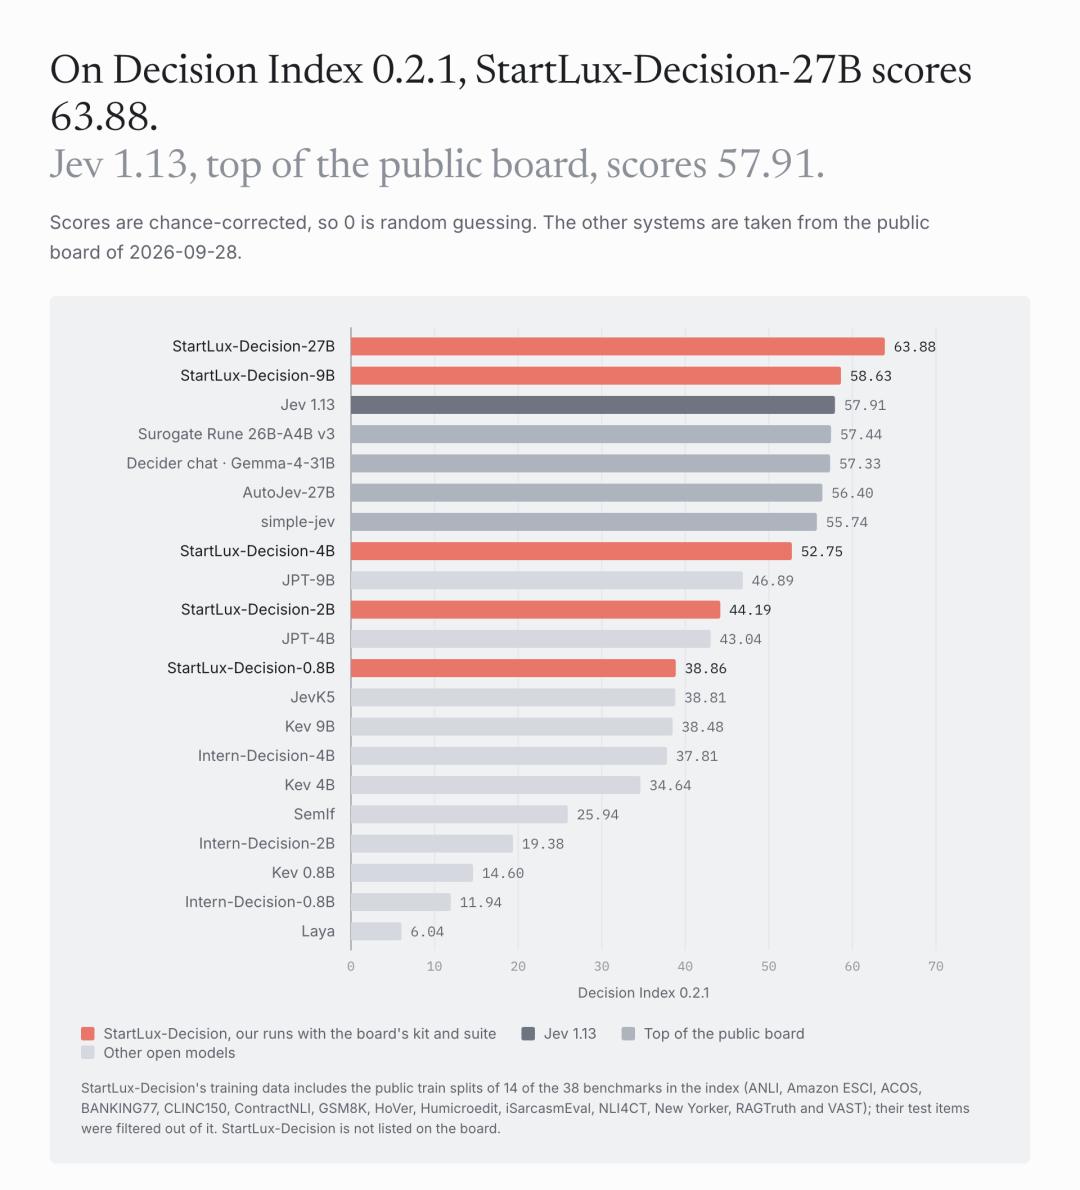
Am 30. September wurde ein Entscheidungsmodell offiziell veröffentlicht und erregte sofort große Aufmerksamkeit: Bei 38 Benchmark-Tests von Decision Index 0.2.1 übertraf es in 31 Punkten das derzeit beliebteste Jev, mit einem Gesamtwert von 63,88 gegenüber 57,91, was einen Vorsprung von fast 6 Punkten vor dem öffentlichen Spitzenwert bedeutet; außerdem ist es vollständig Open Source.
Praktische Vergleiche sagen mehr: Bei Schachspielen gegen Jev lag seine Reaktionsgeschwindigkeit auf dem Niveau des Gegners, aber es gewann 35 von 36 Partien.
Das Unternehmen hinter diesem Modell ist das derzeit hoch angesehene Shanghaier KI-Starunternehmen StartLux. Das Unternehmen, das vor weniger als 5 Monaten gegründet wurde, hat bereits zum zweiten Mal ein Ergebnis vorgelegt, das die Branche schockiert: Beim letzten Mal übertraf das lokale Modell StartLux-27B in Tests des China Academy of Information and Communications Technology des Ministeriums für Industrie und Informationstechnologie das 284B große DeepSeek-V4-Flash; und es erreichte mit etwa 1/60 der Parameterzahl im Wesentlichen das gleiche Niveau wie DeepSeek-V4-Pro. Diesmal handelt es sich um das vollständig quelloffene StartLux-Decision – gemessen an den Gesamtergebnissen öffentlicher Bewertungen ist es derzeit das leistungsstärkste Entscheidungsmodell der Welt.
Übertrifft Jev
Diesmal hat StartLux für sein Decision-Modell auf einen Schlag fünf Versionen mit 0,8B, 2B, 4B, 9B und 27B veröffentlicht und bietet quantisierte Modelle an, die die lokale Bereitstellung unterstützen.
GitHub-Link: https://github.com/StartLuxLabs/Startlux-Decision
Hugging Face-Modellsammlung zum Herunterladen: https://huggingface.co/collections/startlux-models/startlux-decision-6abba92b301b573fa154d493
Wie stark ist es? Werfen Sie zuerst einen Blick auf eine Schachpartie.
Der Gegner ist das in letzter Zeit beachtete Jev 1.13. Beide Seiten sehen den gleichen Brettzustand, greifen nicht auf zusätzliche Suchvorgänge zurück und jeder Zug wird direkt vom Modell ausgewählt.
Schließlich setzt StartLux-Decision-27B den Schachmatt durch. In dieser Partie schnitt es auch bei Kennwerten wie durchschnittlicher Verlust, Trefferquote des besten Zuges und Anzahl der Fehler besser ab. Bei solchen Partien gewann StartLux 35 von 36 Spielen.
Sehen wir uns nun die spezifischen Testergebnisse an. Zuerst das Gesamtergebnis von StartLux-Decision – man braucht nicht viele Worte, schaut einfach auf die Zahlen.
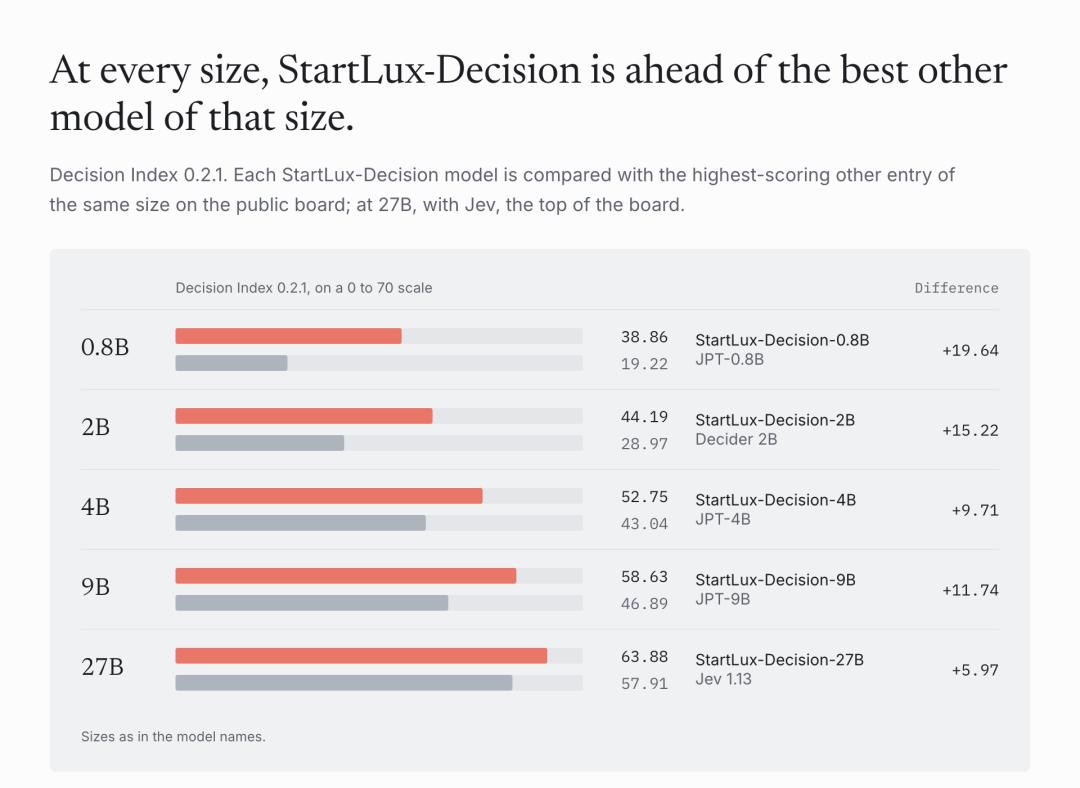
Sehen wir uns nun die Punktzahl der 27B-Version an.
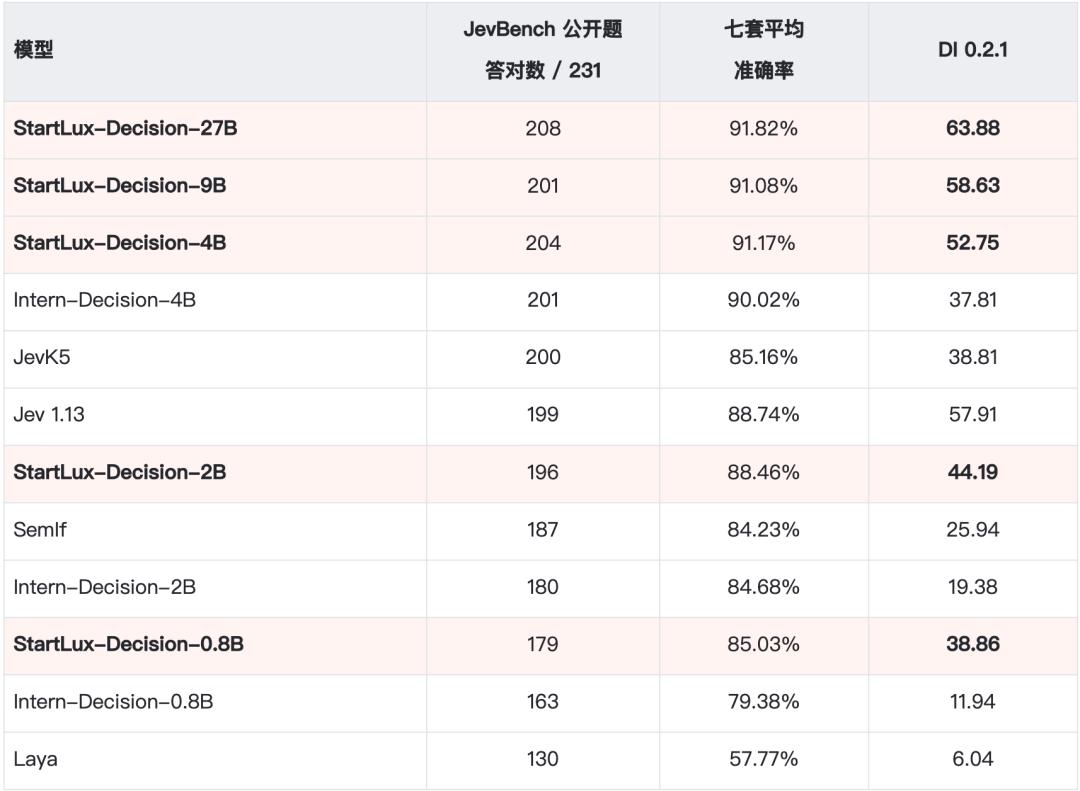
Im unabhängigen Decision Index 0.2.1 erreicht die 27B-Version von StartLux-Decision einen Wert von 63,88, wobei 31 von 38 Benchmarks über dem neuesten Jev 1.13 liegen; in einem weiteren Satz von sieben Tests erreicht die durchschnittliche Genauigkeit von StartLux-Decision-27B 91,82 %. Es ist zu beachten, dass die oben genannten Ergebnisse Selbsttests des StartLux-Teams sind, die auf öffentlichen Bewertungstools und einem Schnappschuss der öffentlichen Rangliste von Decision Index vom 28. September 2026 basieren; die sieben öffentlichen Tests stammen aus dem Bewertungssatz des Teams von Shanghai AI Lab Intern-Decision und bilden zwei voneinander unabhängige Maßstäbe zusammen mit dem Decision Index.
Warum brauchen Agenten
ein speziell für „Urteile“ zuständiges Modell?
Das Decision-Modell erfreut sich in letzter Zeit wachsender Beliebtheit. Warum also brauchen Agenten ein Decision-Modell, das speziell für Urteile zuständig ist?
Sehen wir uns zuerst an, was StartLux-Decision tatsächlich tut.
In einem vom StartLux gezeigten Demo für Kundenservice-Tickets erhält das System folgende Nachricht: „Die Bestellung wurde zweimal doppelt abgebucht, aber das System zeigt immer noch an, dass die Zahlung nicht erfolgt ist.“
Herkömmliche generative KI versteht das Problem normalerweise zuerst und erzeugt eine Analyse, während StartLux-Decision in einer einzigen Anfrage drei klare Urteile gleichzeitig treffen kann: Zuweisung zum zuständigen Team, Bearbeitungsfrist und Schweregrad.
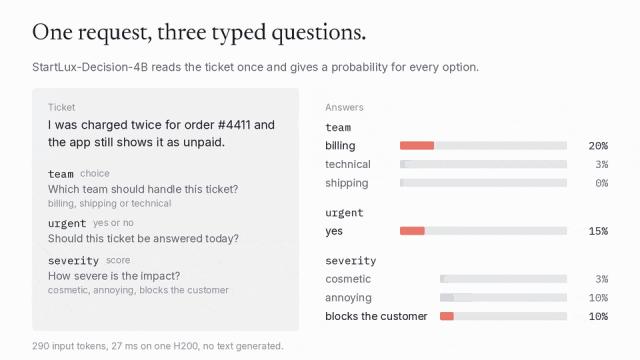
Demo für Kundenservice-Tickets: Eine einzige Anfrage erledigt die Teamzuweisung, die Beurteilung der Dringlichkeit und die Einstufung des Schweregrads.
Hier zeigt sich der direkteste Unterschied zwischen dem Decision-Modell und gewöhnlichen generativen Modellen: Es muss nicht zuerst natürliche Sprache erzeugen, die dann von einem Programm analysiert wird, sondern wählt direkt aus den vom Entwickler bereitgestellten Optionen, trifft Ja/Nein-Urteile oder nimmt eine Einstufung vor.
Wenn diese Fähigkeit in Agenten integriert wird, wirkt sie sich noch deutlicher aus.
Nehmen wir das folgende Einkaufs-Demo als Beispiel. Der Benutzer gibt dem Agenten die Anweisung: „Kaufen Sie die günstigsten 8er-Packungen AA-Batterien ohne Versandkosten und lassen Sie sie an die Privatadresse liefern.“
Das System berücksichtigt umfassend Modell, Anzahl, Preis und Lieferbedingungen. In jeder Runde beurteilt StartLux-Decision anhand des aktuellen Seitenzustands, welcher nächste Schritt auszuführen ist und ob die Aufgabe abgeschlossen ist; nach Ausführung der Aktion wird der Seitenzustand aktualisiert und die Beurteilung fortgesetzt, bis die Bestellung abgeschlossen ist und die Aufgabenbedingungen überprüft wurden.
Einkaufs-Demo: Filtern Sie Produkte aus, die Bedingungen wie AA, 8er-Packung, keine Versandkosten und niedrigster Preis erfüllen, und schließen Sie die Bestellung ab.
Ein ähnliches Muster zeigt sich auch im Demo für die Zusammenarbeit im Büro. Die Aufgabe besteht darin, bestimmte Mitglieder in das Design-Team einzuladen und sie als Editor festzulegen. Das Modell muss nacheinander das richtige Team, die richtigen Mitglieder und die richtige Rolle auswählen und dann beurteilen, ob der Einladungsvorgang abgeschlossen ist.
Demo für Teamverwaltung: Wählen Sie das Design-Team aus, laden Sie bestimmte Mitglieder ein und legen Sie die Editor-Berechtigungen fest.
Der gemeinsame Punkt dieser Demos ist, dass der Antwortraum relativ klar definiert ist. Browser-Steuerelemente, Kundenservice-Abteilungen und Werkzeuglisten sind im Voraus festgelegt. Im Gegensatz zu den Fähigkeiten von großen Sprachmodellen zur offenen Inhaltserstellung (z. B. zum Schreiben von E-Mails oder Erstellen von Plänen) sind die Anforderungen an viele Agenten-Schritte sehr kurz (z. B. Ja/Nein, eine Auswahl aus drei Optionen, fünfstufige Einstufung oder Werkzeugauswahl).
Wenn wir in der Zeit zurückgehen, stellen wir fest, dass hier ein sehr interessanter Zyklus stattgefunden hat.
Im Zeitalter herkömmlicher Software zerlegen Ingenieure Geschäftsvorgänge in eine Vielzahl von Regeln. Ab welchem Betrag welcher Ablauf gestartet wird, welche Aktion bei einem bestimmten Zustand ausgelöst wird und in welche Berechtigungsverzweigung verschiedene Benutzer gelangen. Das System ist sehr fein abgestimmt, aber viele Logiken müssen von Menschen im Voraus geschrieben werden.
Nach dem Aufkommen großer Sprachmodelle wurde eine große Menge dieser expliziten Logik von Modellen aufgenommen. Entwickler begannen, natürliche Sprache und Umgebungszustände direkt an große Modelle zu übergeben, sodass dasselbe Modell Verständnis, Klassifizierung, Urteil, Planung und Erstellung erledigen kann. Das System wurde allgemeiner und flexibler.
In der Agenten-Phase beginnt die KI erneut mit der Arbeitsteilung: Deterministische Abläufe werden dem Code übergeben, Suchvorgänge an Embedding weitergeleitet, komplexe Planungen an das Reasoning-Modell übergeben und für häufige Auswahlvorgänge werden spezielle Modelle wie das Decision-Modell eingeführt.
Die Rechenleistung wird daraufhin ebenfalls feiner verteilt.
StartLux hat eine Reihe von Geschwindigkeitstests veröffentlicht. Bei einer einzelnen H200-Grafikkarte, BF16, lokalem HTTP und kurzen Anfragen benötigt StartLux-Decision-4B für die Beantwortung von drei Fragen durchschnittlich 26 Millisekunden; die 0,8B- und 2B-Versionen erreichen Werte von 12,2 Millisekunden bzw. 15,5 Millisekunden.
Das Team verwendet außerdem CUDA Graph, schnelle lineare Aufmerksamkeitsoperatoren und fasst mehrere Fragen in einer einzigen Vorwärtsberechnung zusammen, um redundante Berechnungen und Aufrufoverheads zu reduzieren.
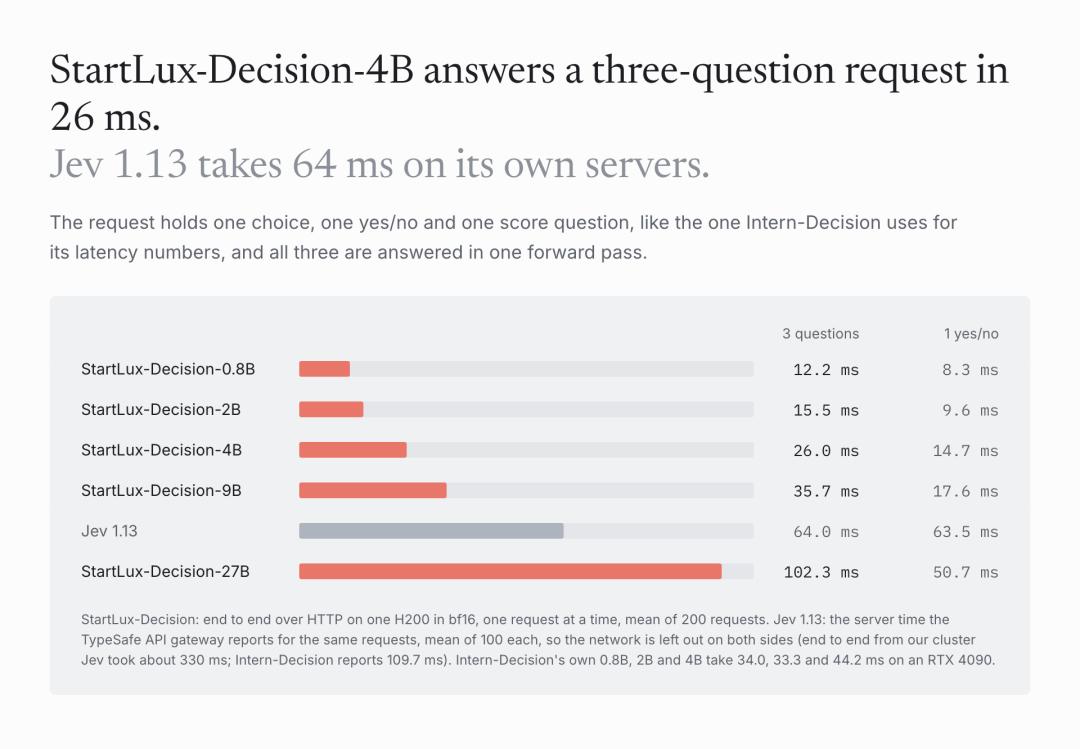
Wenn eine einzelne Agenten-Aufgabe Dutzende von Urteilsknoten enthält, wirkt sich die für jeden Schritt erforderliche Rechenmenge schnell auf die Reaktionsgeschwindigkeit und die Betriebskosten des gesamten Agenten aus.
Das erklärt auch, warum das Decision-Modell in kurzer Zeit so populär geworden ist. Viele der Dinge, die es verarbeitet, scheinen klein zu sein: Auswählen eines Werkzeugs, beurteilen, ob eine Aufgabe abgeschlossen ist, prüfen, zu welchem Ablauf eine bestimmte Information gehört, entscheiden, wo als Nächstes auf einer Seite geklickt werden soll. Sobald Agenten jedoch über lange Zeit und in großem Maßstab betrieben werden, werden diese „kleinen Urteile“ möglicherweise zu der Ebene im gesamten System, die am häufigsten aufgerufen wird.
Die lokale Intelligenz von StartLux beginnt mit der Schichtenbildung
Im September dieses Jahres hat das Unternehmen Machine Heart einmal mit Guo Quanwei, Mitbegründer und CTO von StartLux, über das Thema „Lokal × RSI“ gesprochen (Originaltext: „Wie soll man RSI lokal umsetzen? Wir haben mit dem CTO von StartLux gesprochen“). Eine wichtige Frage damals war: Was bedeutet das von StartLux genannte „lokale KI“ eigentlich?
Guo Quanwei hat eine breite Definition gegeben: Sie umfasst Modelle, Quantisierung, Inferenzsysteme, Hardwareanpassung sowie die darüber liegenden Ebenen von Agent Harness, Werkzeugen, Suche und kontinuierlichem Lernen. Das Ziel des Teams ist es, diese Fähigkeiten so weit wie möglich auf den lokalen Geräten der Benutzer bereitzustellen.
Das unterscheidet sich grundlegend von der einfachen Ausführung eines Offline-Modells auf einem lokalen Gerät. Ein langfristig laufender lokaler Agent muss sich vielen systemischen Herausforderungen stellen: Beschränkungen des Grafikkartenspeichers und des Arbeitsspeichers, Auswahl der Modellgenauigkeit, Zuweisung verschiedener Aufgaben zwischen 4B/9B/27B, Verwaltung langer Kontexte, Wiederherstellungsmechanismen nach Unterbrechungen von Schritten, Speicherungs- und Abrufstrategien für den Speicher sowie der Ausgleich des Aufwands für hochrangige Urteile.
StartLux-Decision ist genau die Komponente, die eingeführt wurde, um eine bestimmte Ebene davon auszufüllen.
In der Systemunterteilung von StartLux übernimmt StartLux-27B die Ebene der allgemeinen Fähigkeiten, das Decision-Modell konzentriert sich auf häufige Entscheidungen, darüber werden Agenten und Speicher bereitgestellt und die unterste Ebene wird von Quantisierung, Inferenzsystemen und Hardwareanpassung gestützt.
Diese Architektur basiert auf den realen Beschränkungen der Rechenleistung: Die Hardware-Ressourcen von PCs haben klare Grenzen.
Im Gegensatz zu Cloud-Systemen, die die Modellskalierung über GPU-Cluster erweitern können, müssen lokale Systeme über lange Zeit mit begrenztem Grafikkartenspeicher, Arbeitsspeicher, Bandbreite und Stromverbrauch betrieben werden. Daher wird „die effiziente Zuweisung der Einheit der Rechenleistung“ zum Kernproblem.
Frühere Nachschulungsexperimente von StartLux am 27B-Modell haben diese Logik bereits gezeigt. Guo Quanwei beschreibt die Modellparameter als einen hochdimensionalen Raum, dessen Größe die Kapazität bestimmt, während das Training die Fähigkeitsverteilung innerhalb der Kapazität neu gestaltet. Die Experimente zeigten, dass nach der Nachschulung für Agenten-Fähigkeiten GPQA von 83,33 auf 90,40 stieg, DeepSearchQA von 47,04 auf 59,39 und Tau3-Banking ebenfalls verbesserte Werte erreichte; gleichzeitig sank GAIA jedoch von 57,57 auf 45,70 und IFeval verzeichnete ebenfalls einen Rückgang.
Dieses Phänomen zeigt, dass bei einer festen Anzahl von Parametern eine Umverteilung von Ressourcen zwischen verschiedenen Fähigkeiten stattfindet. Der Trainingsprozess bestimmt im Wesentlichen, welche Aufgaben die Parameter bevorzugt verarbeiten.
Das Decision-Modell geht noch einen Schritt weiter: Häufig aufgerufene spezielle Aufgaben mit klar definierten Zielen werden von dedizierten, leichtgewichtigen Modellen verarbeitet.
Das ist auch der Grund, warum StartLux fünf Ausführungen mit 0,8B, 2B, 4B, 9B und 27B herausbringt, um verschiedene Geräte und Szenarien abzudecken. Gleichzeitig werden drei GGUF-Quantisierungsdateien in BF16, Q8_0 und Q4_K_M bereitgestellt.
