Gerade hat KI den „Video-Turing-Test“ durchbrochen, 17 Millionen Internetnutzer verfolgen das Ereignis online.
Früher wurden Videoanrufe oft als eine zusätzliche Sicherheitsmaßnahme zur Identitätsüberprüfung angesehen. Texte können von Dritten verfasst werden, Stimmen können synthetisiert werden – aber wenn man die andere Person bittet, die Kamera einzuschalten, ein paar Worte zu wechseln und ihre Mimik zu sehen, schien man immer ein bisschen mehr Sicherheit zu haben.
Heutzutage gerät selbst diese Gewissheit, dass man mit eigenen Augen die Wahrheit erkennt, zunehmend in Zweifel.
Vor kurzem hat das KI-Forschungsteam Tavus das Echtzeit-Videointeraktionsmodell Griffin vorgestellt, und die Ergebnisse eines Experiments veröffentlicht. Nach einem einminütigen Videoanruf mit seiner Forschungsvorschauversion Griffin-Lite hielten 26 von 54 Teilnehmern die Person am anderen Ende des Bildschirms für einen echten Menschen, was einem Anteil von etwa 48 % entspricht.
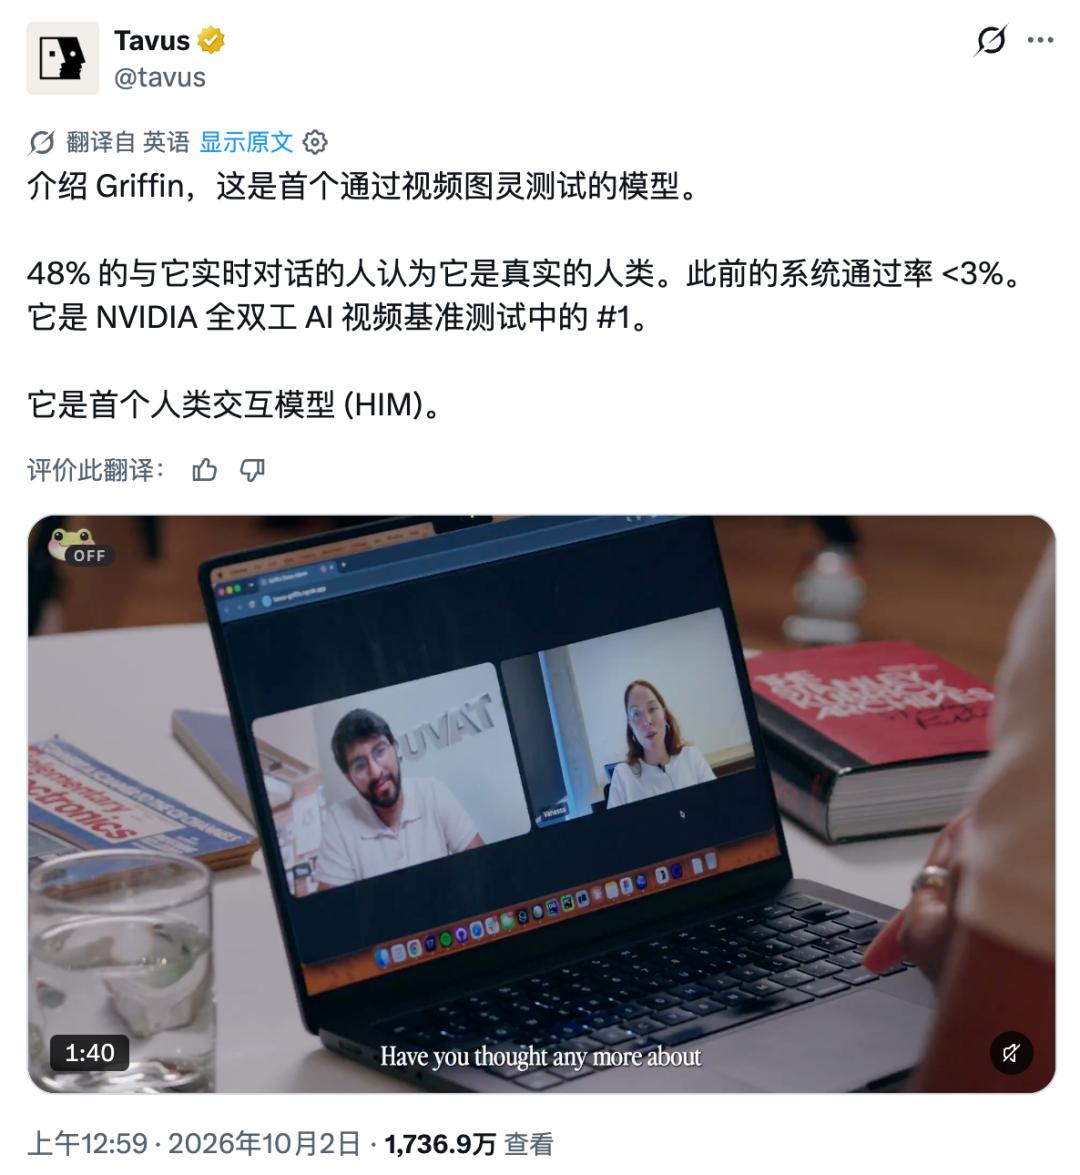
▲ Bis zum Zeitpunkt der Veröffentlichung haben fast 17,36 Millionen Internetnutzer diesen Inhalt verfolgt
Als Vergleich: Bei dem Vorgängersystem von Tavus hielten im gleichen Versuchsablauf nur 1 von 41 Personen das System für einen echten Menschen, was einem Anteil von 2,4 % entspricht.
Tavus erklärt daraufhin, dass Griffin das erste Modell ist, das den Echtzeit-„Video-Turing-Test“ bestanden hat, und klassifiziert es in eine neue Kategorie namens Human Interaction Model, abgekürzt HIM, also Modell für menschliche Interaktion.
Allerdings ist die Angabe „erstmals bestanden“ derzeit noch eine Definition von Tavus für die Versuchsergebnisse. Da die Vorschau noch nicht vollständig für die Öffentlichkeit zugänglich ist, lässt sich der Verdacht nicht ausschließen, dass es sich um eine überzeichnete Demo handelt. Um diese Veröffentlichung konkret zu verstehen, müssen drei Fragen gleichzeitig geklärt werden: Wie die Teilnehmer überzeugt wurden, wie das Modell die Interaktion durchführt und wie viel die einminütige Leistung tatsächlich beweisen kann.
Details, die Menschen überzeugen, liegen außerhalb des Sprechens
Beim Chatten mit KI ist der Moment, der einen am leichtesten aus der Situation reißt, nicht unbedingt eine völlig absurde Antwort – manchmal ist es nur, dass sie einfach nicht richtig auf die Äußerungen reagieren kann.
Du hältst an, um deine Worte zu ordnen, und sie eilt sofort, die Antwort zu geben; du erzählst etwas Trauriges, aber das Gesicht auf dem Bildschirm lächelt noch immer; du unterbrichst sie, aber sie redet weiter in ihrem ursprünglichen Rhythmus. Die Antwort mag nicht falsch sein, aber die Kommunikation fühlt sich immer etwas unnatürlich an.
Genau diese Details außerhalb der Sprache versucht Griffin zu bearbeiten. Nach den Angaben von Tavus kann es gleichzeitig sehen, hören und sprechen und anhand der Mimik, des Blicks, des Tonfalls und der Pausen des Gegenübers fortlaufend entscheiden, was es als Nächstes tun soll.
In der offiziellen Demonstration zeigte das Modell die Fähigkeit, Emotionen, Tonfall und Bewegungen im Laufe des Gesprächs anzupassen, und beteiligte sich an Szenarien wie einem Nachahmungs-Anweisungsspiel, der Interaktion mit einem Zauberwürfel und der Beobachtung des Benutzers beim Löten einer Leiterplatte. Tavus möchte damit zeigen, dass das Modell in der Lage ist, Bild- und Zeitinformationen zu kombinieren, um an der Kommunikation teilzunehmen.
Zum Beispiel: Bei einer Schweigephase denkt einer gerade nach, einer hat bereits aufgehört zu sprechen, und ein anderer wünscht sich vielleicht, dass der Gegenüber weiter erklärt. Das System muss Kontext und nonverbale Signale kombinieren, um zu beurteilen und zu vermeiden, jede Pause als Ende der Äußerung zu werten.
Der Bereich der visuellen Generierung wurde ebenfalls erweitert. Laut Tavus kann Griffin ausgehend von einem Referenzbild das gesamte Bild in Echtzeit generieren, einschließlich Gesicht, Armen und Fingern der Person sowie Bewegungen des Stuhls, Schatten und Hintergrundänderungen.
Daher kann die Figur auf dem Bildschirm während des Zuhörens auch nicken, den Blick anpassen oder die Mimik ändern – sie muss nicht erst anfangen, sich zu bewegen, wenn ihre eigene Sprechphase beginnt.
Wenn KI das Chatten lernen will, muss sie den Rhythmus des abwechselnden Beantwortens von Aufgaben ablegen
Hinter diesen Fähigkeiten steht eine Veränderung der Interaktionsweise.
Herkömmliche Kaskadensysteme führen nacheinander Spracherkennung, Antwortgenerierung durch das Sprachmodell, Sprachsynthese und die Steuerung des digitalen Menschen durch, wobei mehrere Schritte nacheinander ablaufen. Der Benutzer sagt einen Satz, das System verarbeitet ihn und gibt das Ergebnis dann an den nächsten Schritt weiter.
Griffin verwendet ein Vollduplex-Videointeraktionsschema. Das sogenannte Vollduplex bedeutet, dass das System gleichzeitig beim Ausgeben von Sprache und Video weiterhin die Stimme und das Bild des Benutzers empfängt und verarbeitet.
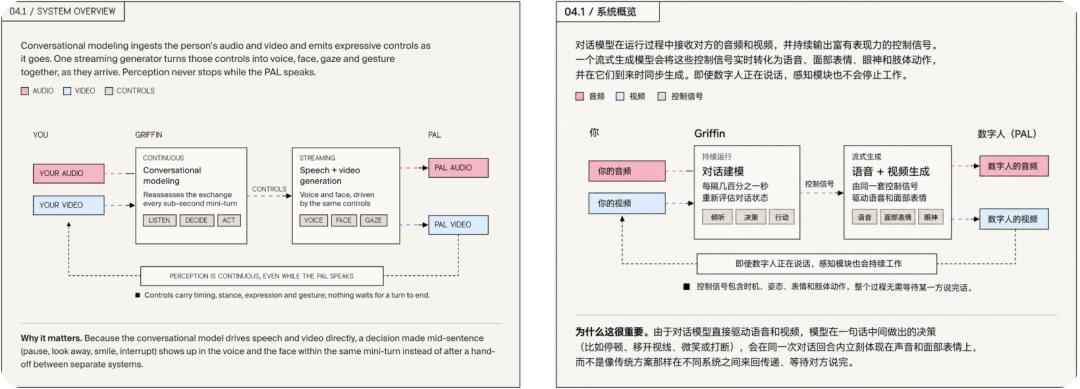
▲ Links ist das Originalbild, rechts die KI-gestützte Übersetzung, nur als Referenz gedacht
Es besteht aus zwei Hauptkomponenten.
Die Engine für die kontinuierliche Gesprächsmodellierung ist dafür verantwortlich, die Szene wahrzunehmen, zu entscheiden, was gesagt wird und wann geantwortet wird, und gibt gleichzeitig Steuersignale für Emotionen, Mimik und Bewegungen aus; die Audio- und Videogenerierungsengine wandelt diese Signale in fortlaufende Töne und Bilder um.
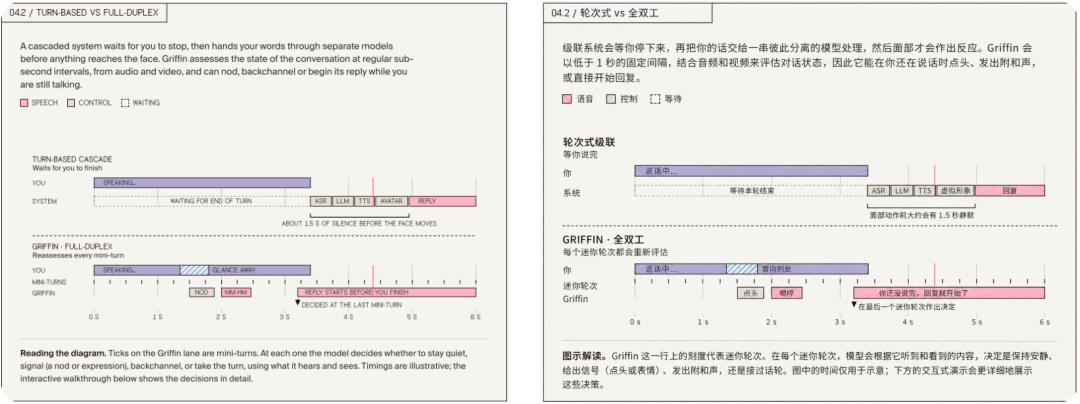
Die Gesprächs-Engine bewertet den Kommunikationszustand in Abständen von weniger als einer Sekunde neu, sodass das Modell auch mitten in einem Satz anhand der Reaktion des Benutzers entscheiden kann, anzuhalten, weiterzumachen oder das Rederecht abzugeben.
Um diese Koordination zu erreichen, muss die Generierungsgeschwindigkeit ebenfalls Schritt halten.
Das Sprachmodul von Griffin-Lite verwendet eine Streaming-Generierung, die schrittweise Ton ausgibt, wenn die Steuersignale eintreffen, und unterstützt das Klonen von Stimmen anhand von etwa 10 Sekunden langem Referenzaudio.
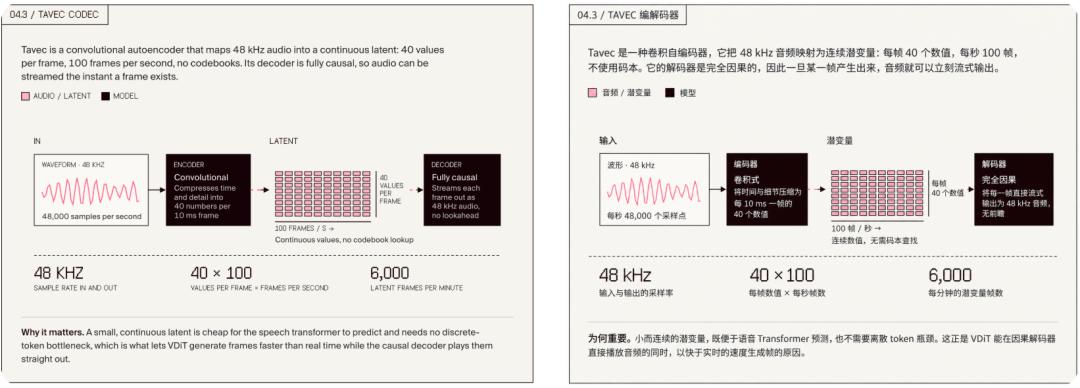
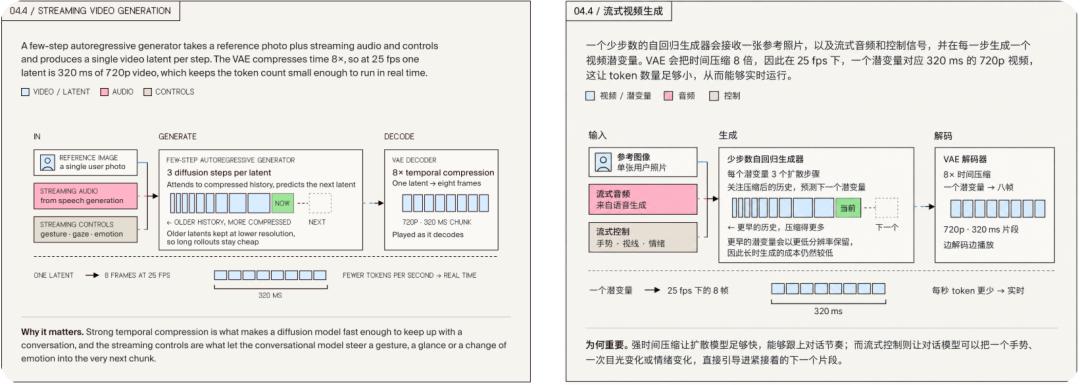
Das Videomodul generiert in Echtzeit Videos mit 720p-Auflösung und 25 Bildern pro Sekunde in Abschnitten von jeweils 320 Millisekunden. Das Team hat den ursprünglich mehrstufigen Generierungsprozess durch Modelldestillation und autoregressives Training zu einem Prozess mit wenigen Schritten komprimiert und gleichzeitig die Bildstabilität bei langen Ausgaben verbessert.
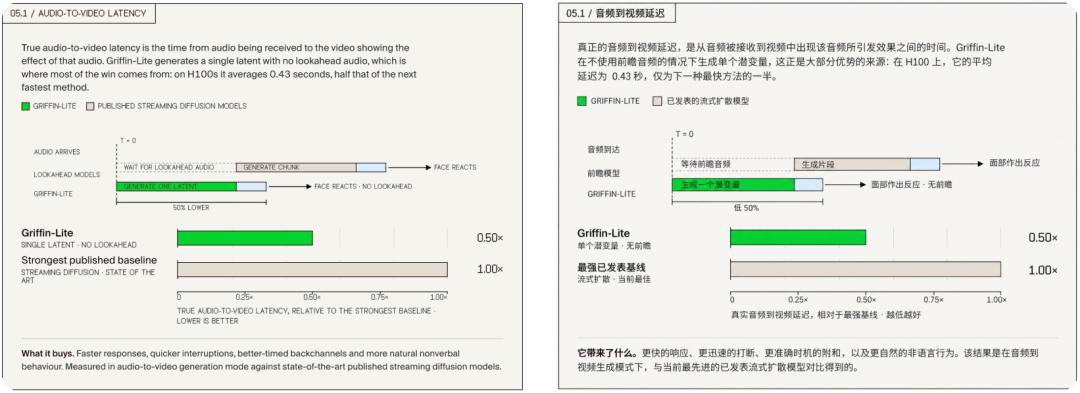
Bei den von Tavus veröffentlichten Tests mit H100-Grafikkarten betrug die durchschnittliche Latenz zwischen dem Eintreffen des Audios und der Darstellung des entsprechenden Effekts im Bild 0,43 Sekunden, also etwa die Hälfte der Latenz des zweitschnellsten Vergleichsverfahrens. Diese Zahl misst die Generierungslatenz von Audio zu Video und kann nicht direkt als Zeit von der Benutzerfrage bis zum Erhalt der vollständigen Antwort gewertet werden.
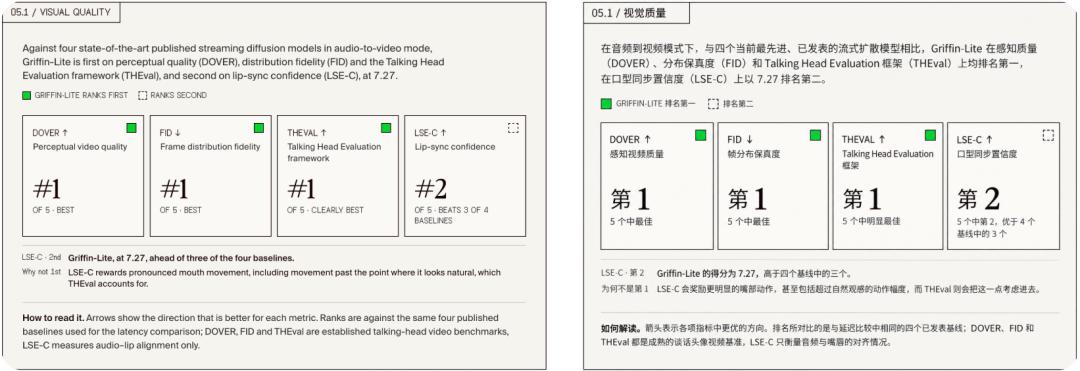
Was die Bildqualität angeht, erzielte Griffin-Lite im Vergleich mit vier veröffentlichten Streaming-Diffusionsmodellen die besten Ergebnisse bei drei Metriken: DOVER, FID und THEval; der Wert für die Lippen-Synchronisationsmetrik LSE-C betrug 7,27 und belegte damit den zweiten Platz.
Die Rangliste erreicht fast menschliches Niveau, aber das einminütige Experiment hat noch Grenzen
Neben internen Tests taucht Griffin-Lite auch auf der öffentlichen VideoFDB-Rangliste von Nvidia auf. Dieser Benchmark bewertet getrennt, ob das Modell nonverbale Signale in der Kommunikation verstehen kann und ob es kontextgerechte Töne, Mimik und Bewegungen generieren kann.
In der Generierungskategorie erzielte Griffin-Lite eine Gesamtpunktzahl von 3,83, der menschliche Referenzwert liegt bei 3,92, während die Kombination aus Gemini 2.5 und Anam auf dem nächsten Platz 2,80 erreichte. In der Wahrnehmungskategorie erreichte Griffin-Lite 3,73 Punkte, der menschliche Referenzwert beträgt 4,20, und der höchste Wert anderer öffentlicher Basismodelle liegt bei 3,44.
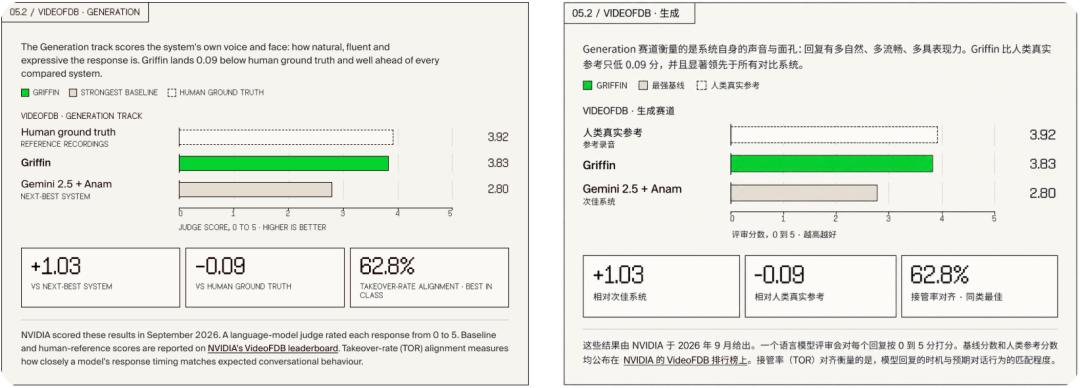
Beide Ergebnisse liegen vor anderen KI-Systemen auf der Rangliste, aber sie sind Bewertungen unter spezifischen Benchmark-Bedingungen. Es ist besonders zu beachten, dass einige Vergleichsobjekte nur Audio empfangen, andere sowohl Audio als auch Video, also die Eingabebedingungen unterschiedlich sind – die Rangfolge kann nicht direkt als Vergleichsschluss über alle Fähigkeiten verallgemeinert werden.
Der vielbeachtete Wert von 48 % stammt aus einem weiteren von Tavus organisierten Experiment, bei dem Teilnehmer über eine unabhängige Forschungsplattform rekrutiert wurden.
Den Teilnehmern wurde im Voraus mitgeteilt, dass sie eine Minute lang mit einem anderen Teilnehmer videoanrufen und über das am meisten erwartete Ereignis dieses Jahres diskutieren würden. Tatsächlich erschien auf dem Bildschirm eine KI-Figur, deren Gesicht, Stimme und Antworten von Griffin-Lite in Echtzeit generiert wurden.
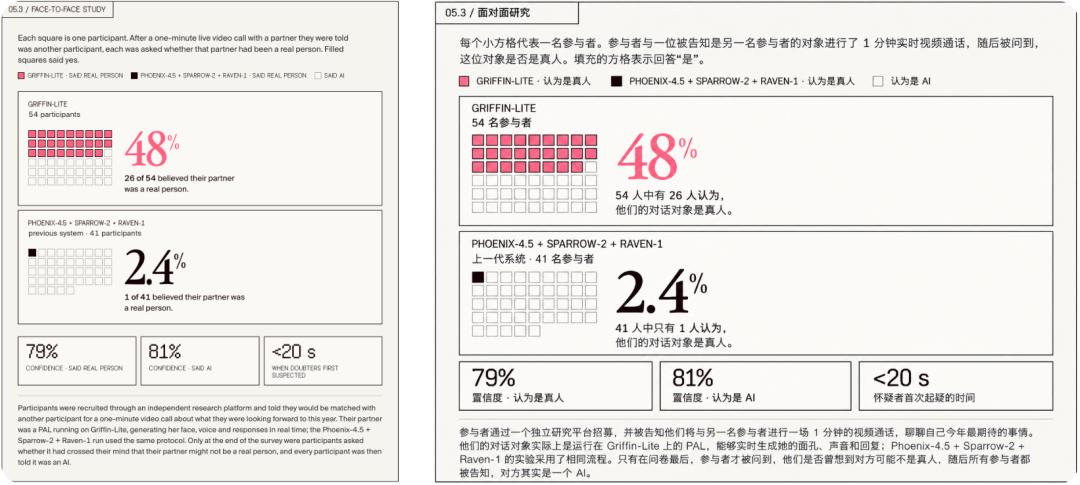
Nach dem Anruf bewerteten die Teilnehmer zuerst die Natürlichkeit, Glaubwürdigkeit und Kommunikationserfahrung des Gegenübers, erst am Ende des Fragebogens wurden sie gefragt, ob sie jemals gezweifelt hätten, dass es sich um einen echten Menschen handelt. Nach Abschluss der Studie wurden alle über die KI-Identität informiert.
Schließlich hielten 26 Personen das Gegenüber für einen echten Menschen, die durchschnittliche Zuversicht dieser Gruppe bei ihrer Beurteilung betrug 79 %; die Teilnehmer, die das Gegenüber für KI hielten, hatten eine durchschnittliche Zuversicht von 81 %. Personen, die Zweifel hegten, bemerkten dies meist bereits innerhalb der ersten 20 Sekunden des Anrufs.
Das Modell hat noch nicht alle Kommunikationsbarrieren beseitigt. Bei der Bewertung auf einer Sieben-Punkte-Skala lag die Natürlichkeit bei 5,4, die Glaubwürdigkeit bei 5,6, die Bereitschaft zu einer weiteren Kommunikation bei 5,8 – während die Flüssigkeit des Gesprächs mit 4,9 der niedrigste Wert unter den fünf Bewertungen war.
Das Experiment zeigt, dass in Echtzeit generierte Gesichter unter bestimmten Bedingungen bereits einige Menschen täuschen können. Aber die Stichprobe umfasst nur 54 Personen, der Anruf dauerte nur eine Minute, und die Teilnehmer wurden im Voraus darüber informiert, dass das Gegenüber eine andere Person ist – die Ergebnisse müssen noch durch größere Stichproben, längere Gesprächsdauern und mehr Szenarien validiert werden.
Je menschenähnlicher das Modell ist, desto mehr muss es klarstellen, wer es ist
In der Vision von Tavus für Griffin wirst du nie über den „Mechanismus“ der Kommunikation nachdenken. Du wirst nicht überlegen, „welche Worte ich