Gerade hat Google Gemini 4 Argon vorgestellt: Die maximale Ausgabegrenze pro einzelner Anfrage erreicht 1 Million Token.
Gerade hat Google die Einführung der neuen Generation des Spitzenmodells Gemini 4 Argon angekündigt.
Google positioniert Argon als Modell für komplexe, lang andauernde Arbeitsabläufe, das sich vor allem auf wissensintensive Unternehmensaufgaben in Bereichen wie Softwareentwicklung, Recht und Finanzen sowie auf die Cybersicherheitsabwehr konzentriert.
Im Gegensatz zu früheren Vorgehensweisen, bei denen das Modell direkt der Öffentlichkeit zugänglich gemacht wurde, verfolgt Argon eine stufenlose Veröffentlichungsstrategie. Das Modell wird im Rahmen des Fairwind-Programms zunächst vertrauenswürdigen Cybersicherheitsverteidigern zur Verfügung gestellt.
In Bezug auf die Preisgestaltung beträgt der anfängliche Preis für die Argon-API 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token, wobei der Preis für zwischengespeicherte Eingabe-Token um 95 % unter dem Standardpreis für Eingaben liegt.
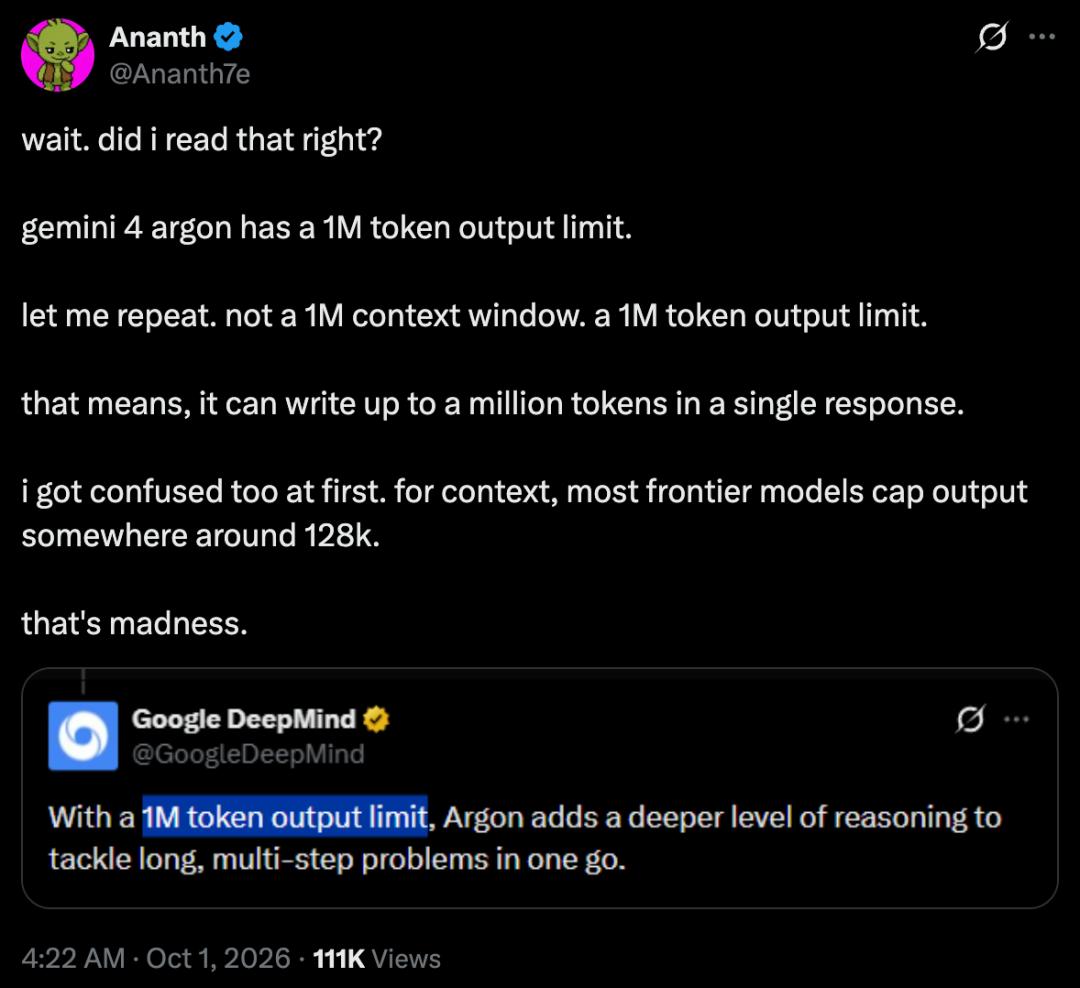
Die Obergrenze für die einzelne Ausgabe wird auf 1 Million Token erweitert
Die am meisten beachtete Änderung bei Gemini 4 Argon besteht darin, dass die Obergrenze für Ausgabe-Token von bisher 64.000 auf 1 Million angehoben wurde.
Die hier genannte Obergrenze von 1 Million Token für die einzelne Ausgabe ist ein separater Wert zum Kontextfenster. Ein größerer Ausgabebereich bedeutet, dass das Modell in einer einzigen Aufgabenkette kontinuierlich schlussfolgern und Ergebnisse mit Hunderttausenden oder sogar fast einer Million Token generieren kann. Diese Fähigkeit zielt hauptsächlich auf groß angelegte Codemigration, tiefgehende Forschung und mehrstufige Unternehmensabläufe ab.
Einige Nutzer weisen darauf hin, dass die Ausgabegrenze der meisten Spitzenmodelle bei etwa 128.000 Token liegt. Im Vergleich dazu ist die Fähigkeit von Argon, in einer einzigen Generierung 1 Million Token zu erzeugen, sehr selten.
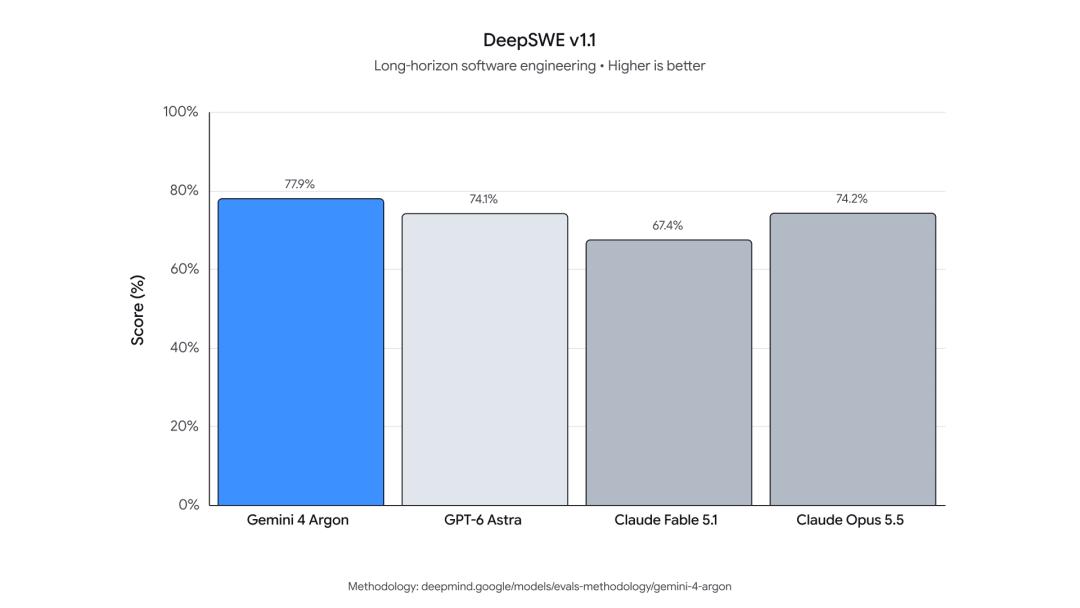
Laut Google erreicht Argon im Softwareentwicklungs-Benchmark DeepSWE v1.1 einen Wert von 77,9 % und damit das derzeit höchste Niveau. Dieser Benchmark misst hauptsächlich die Fähigkeit des Modells, reale, lang andauernde Softwareentwicklungsaufgaben zu bearbeiten.
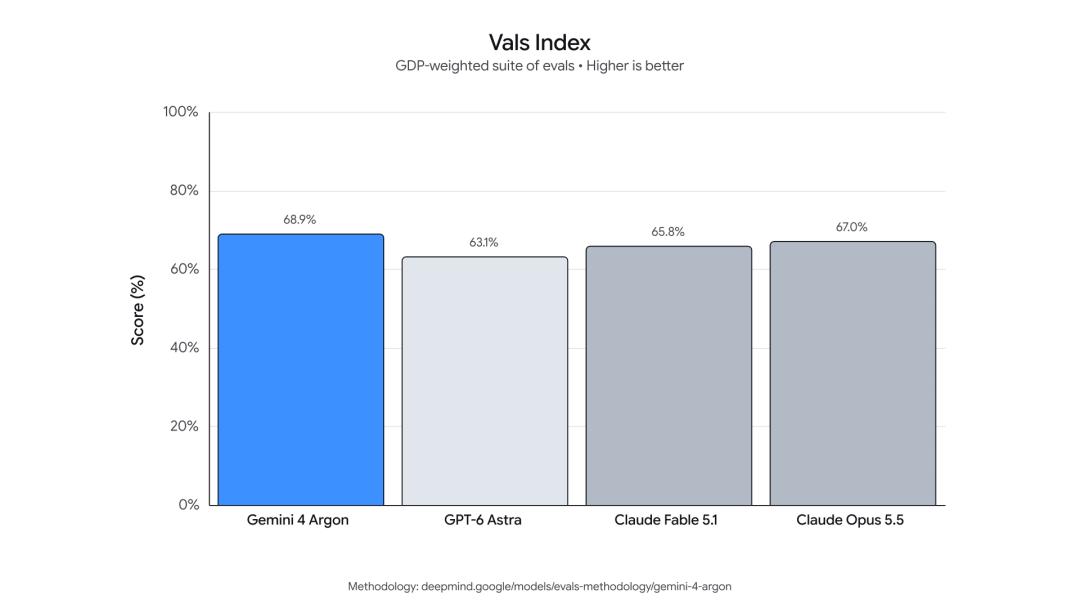
In Bezug auf wissensintensive Unternehmensaufgaben belegt Argon den ersten Platz im Vals-Index. Dieser Index deckt Bereiche wie Finanzen, Programmierung, Recht und Steuern ab und wird nach dem Beitrag jeder Branche zum Bruttoinlandsprodukt der Vereinigten Staaten gewichtet.
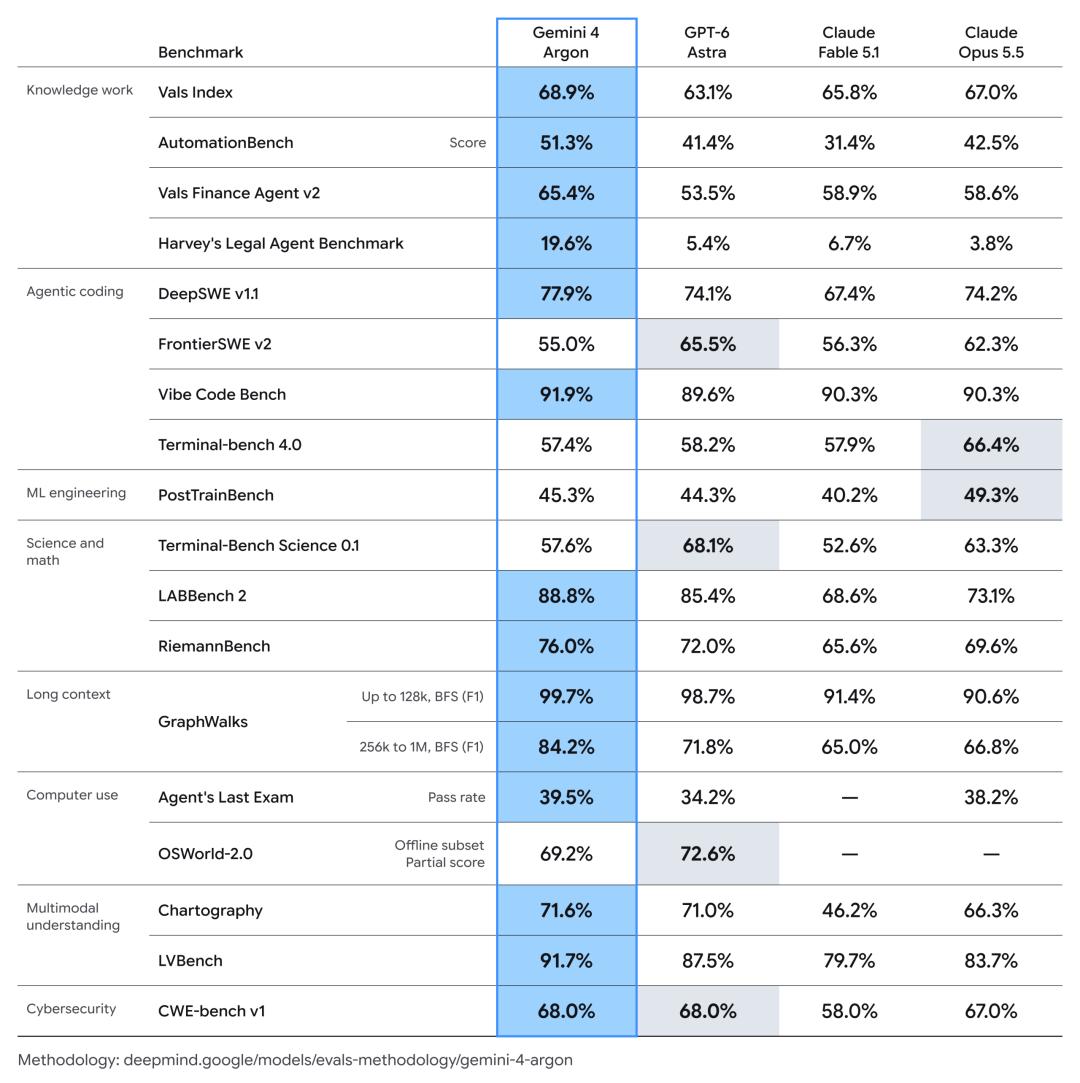
Argon erzielt zudem Spitzenleistungen in Benchmarks wie Vals Finance Agent v2, dem Harvey Legal Agent Benchmark und dem AutomationBench von Zapier, wobei der Wert bei AutomationBench 51,3 % beträgt.
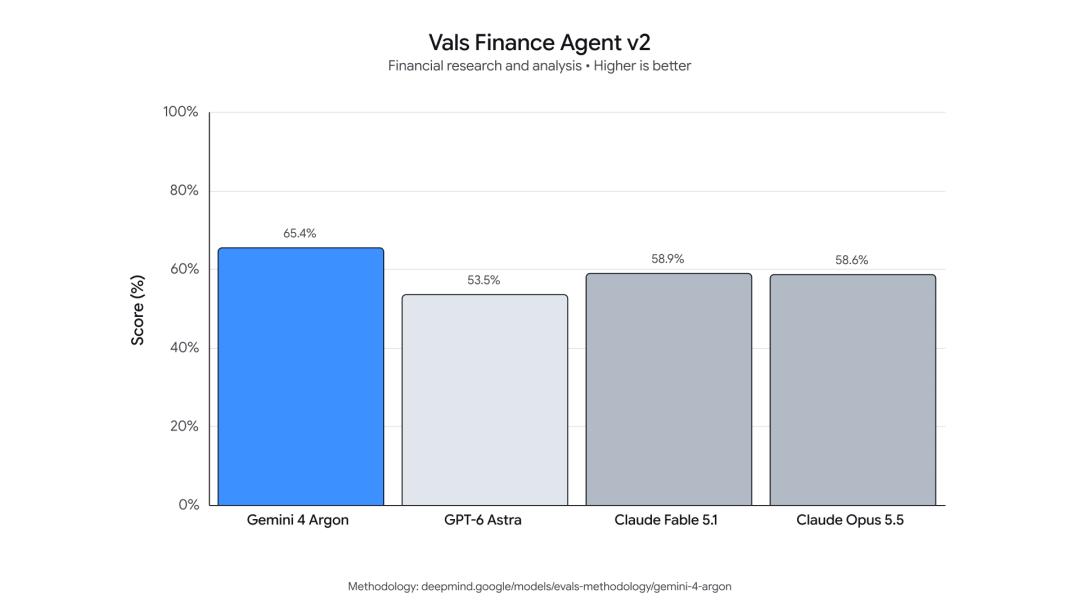
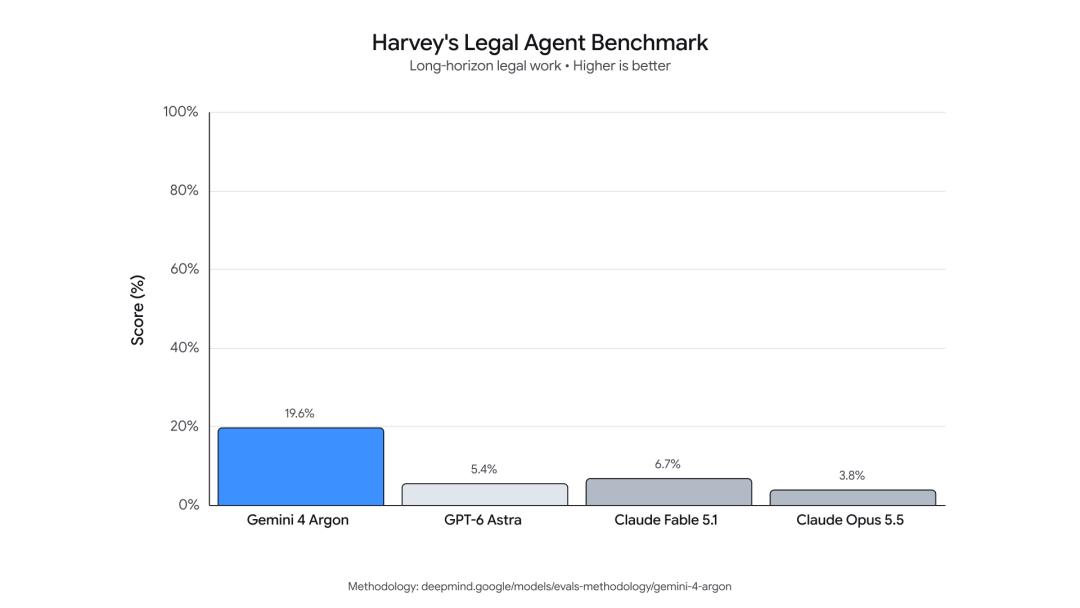
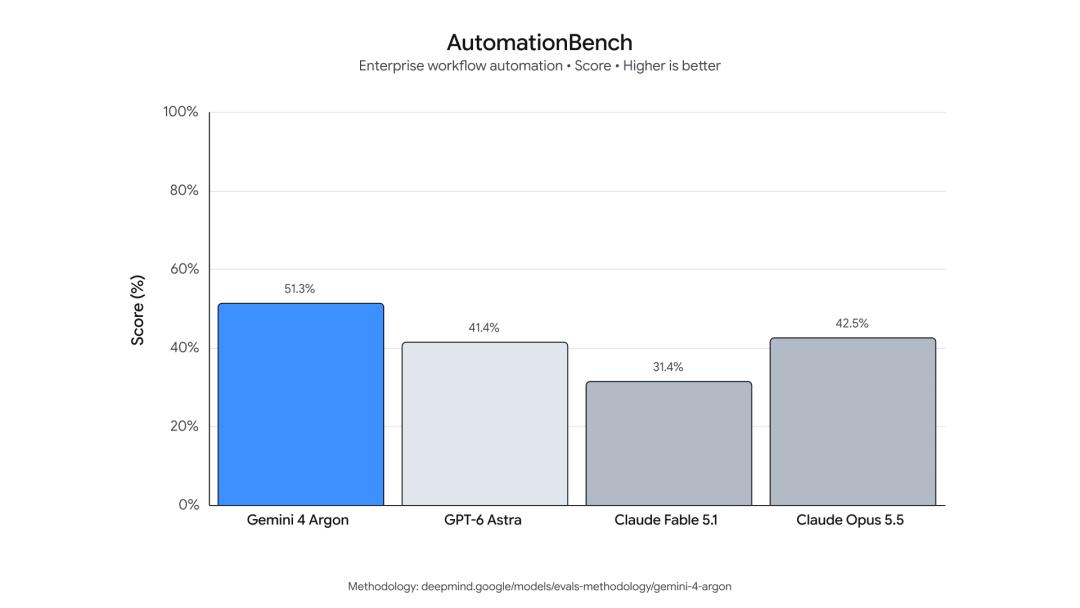
Argon legt zudem großen Wert auf visuelle Verständnisfähigkeiten. Laut Google kann das Modell professionelle Diagramme analysieren, lange Videos verstehen und Maßnahmen auf der Grundlage mehrerer Dokumente ergreifen. Im Benchmark für das Verständnis langer Videos LVBench erreicht Argon einen Wert von 91,7 %.
Argon wird bereits in den internen technischen Abläufen von Google eingesetzt
Laut Google nutzen bereits Tausende von Mitarbeitern Argon in ihrer täglichen Arbeit, unter anderem für das Debuggen von Code, das Entwerfen von Algorithmen und die Migration großer Codebasen.
Im Bereich des Quantencomputings hilft Argon Forschern, die raumzeitlichen Ressourcen in Quantenalgorithmen zu optimieren, also das Produkt aus der Anzahl der Qubits und der Anzahl der Gatteroperationen. Laut Google konnte Argon in einem Test die veröffentlichten Benchmark-Ergebnisse in nur wenigen Minuten um 40 % verbessern.
Im Rahmen des Projekts zur Optimierung des Speichers in Rechenzentren hat der Argon-Agent die leistungsbezogenen Überwachungsdaten im gesamten Netzwerk analysiert und Optimierungslösungen automatisch identifiziert und umgesetzt. Nach der Inbetriebnahme der entsprechenden Lösungen wurden mehr als 300 TiB Speicher freigegeben, wobei die erwartete Gesamteinsparung 500 TiB bis 1 PiB betragen wird.
Argon ist zudem an der Migration der internen C/C++-Codebasen von Google zu Rust beteiligt, die Kernbibliotheken wie re2 und libgav1 abdeckt und sich auf den Fuchsia-Zircon-Kernel mit mehr als 800.000 Codezeilen erstreckt. Da es sich um kritische Infrastrukturen handelt, müssen diese Migrationen noch automatische Prüfungen, menschliche Überprüfungen und Simulationstests durchlaufen.
Im Open-Source-Videodecoder-Projekt libgav1 hat der Argon-Agent durch mehrere Runden von Leistungstests und Compileranalysen etwa 32.000 Zeilen SIMD-Code neu geschrieben. Die neue Rust-Version erreicht bei gleichbleibender Videoausgabequalität die 2,7-fache Laufgeschwindigkeit der ursprünglichen Rust-Version.
Cybersicherheitsfähigkeiten und reale Prüfungen gehen Hand in Hand
Cybersicherheit ist einer der ersten priorisierten Bereiche für den Einsatz von Argon. Laut Google kann das Modell kritische Softwarelücken selbstständig erkennen, überprüfen und beheben.
Das Cybersicherheitsunternehmen Wiz nutzt Argon bereits im Rahmen des „Scan for Good“-Programms, um kostenfrei hochriskante Angriffsflächen in der öffentlichen Infrastruktur zu erkennen. Laut Google hat Argon einmal eine schwerwiegende Sicherheitslücke in medizinischer Software erkannt, die weltweit in Krankenhäusern eingesetzt wird und sensible personenbezogene Daten gefährden könnte – eine Lücke, die frühere Spitzenmodelle nicht identifiziert haben.
Im Lückenbehebungs-Benchmark CWE-bench v1 belegt Argon mit einem Wert von 68% den geteilten ersten Platz.
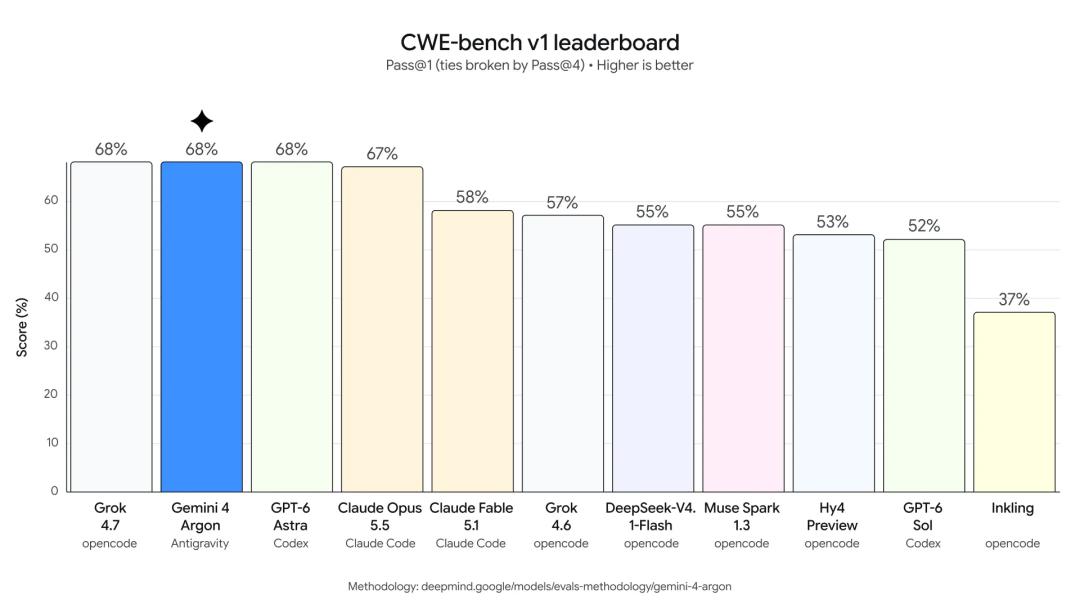
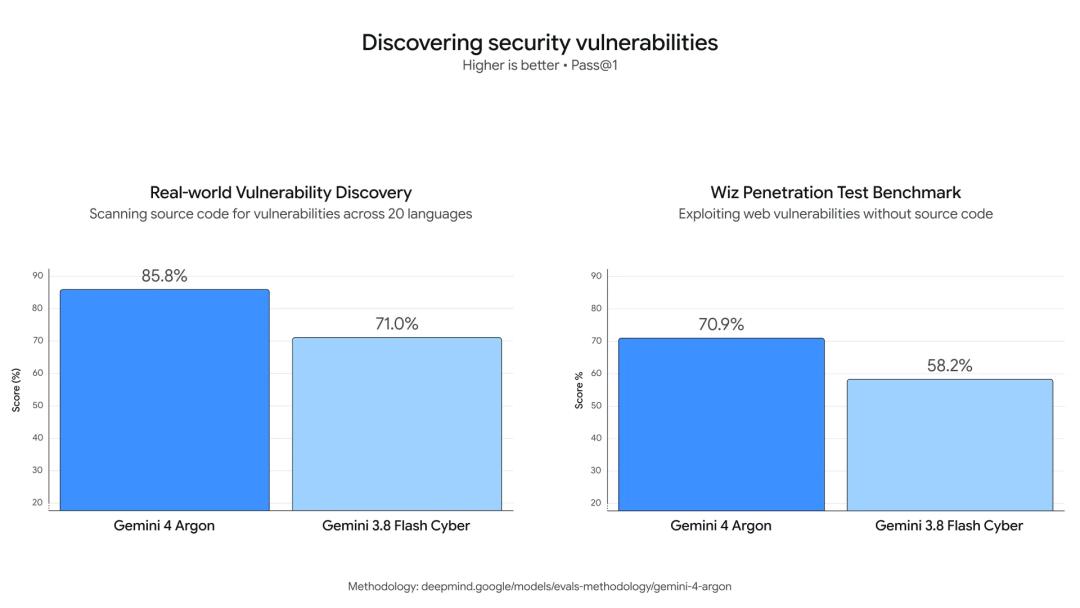
Google weist zudem darauf hin, dass Argon bei internen Lückentests, die 20 Programmiersprachen abdecken, sowie bei Blackbox-Penetrationstests ohne Zugriff auf den Quellcode bessere Leistungen erbringt als Gemini 3.8 Flash Cyber.
Mit der Verbesserung der Modellfähigkeiten verstärkt Google gleichzeitig die Sicherheitsmechanismen. Argon beschränkt Anfragen im Zusammenhang mit Cyberangriffen sowie missbräuchlichen Nutzung in Bereichen wie Chemie, Biologie, Radioaktivität und Kernenergie und erkennt potenzielle Risiken durch interne Aktivitätsüberwachung, automatisierte Red-Team-Tests und menschliche Bewertungen.
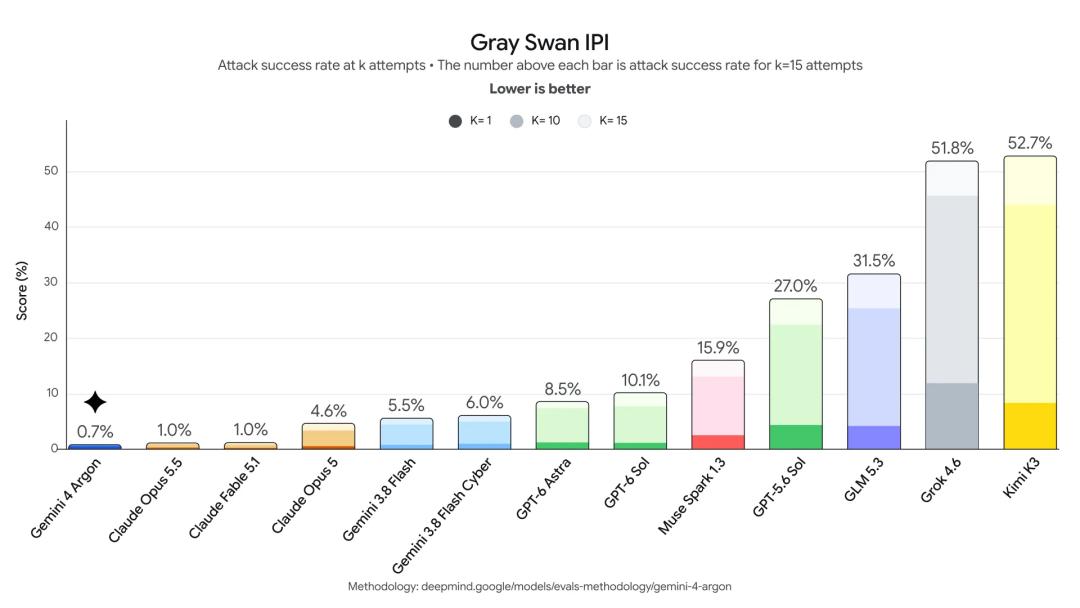
Gegen indirekte Prompt-Injection-Angriffe verbessert Google die Schutzfähigkeit des Modells durch gegnerisches Training und automatisierte Tests. Das Unternehmen hat zudem einen Überwachungsmechanismus für Modellabweichungen implementiert, der den Schlussfolgerungsprozess und die Aktionsspur des Modells verfolgt, die Ausführung von Aufgaben bei Bedarf abbricht und hochriskante Trainings- und Benchmark-Umgebungen isoliert.
Dennoch besteht nach wie vor eine Lücke zwischen den Benchmark-Ergebnissen und der tatsächlichen Arbeitserfahrung.
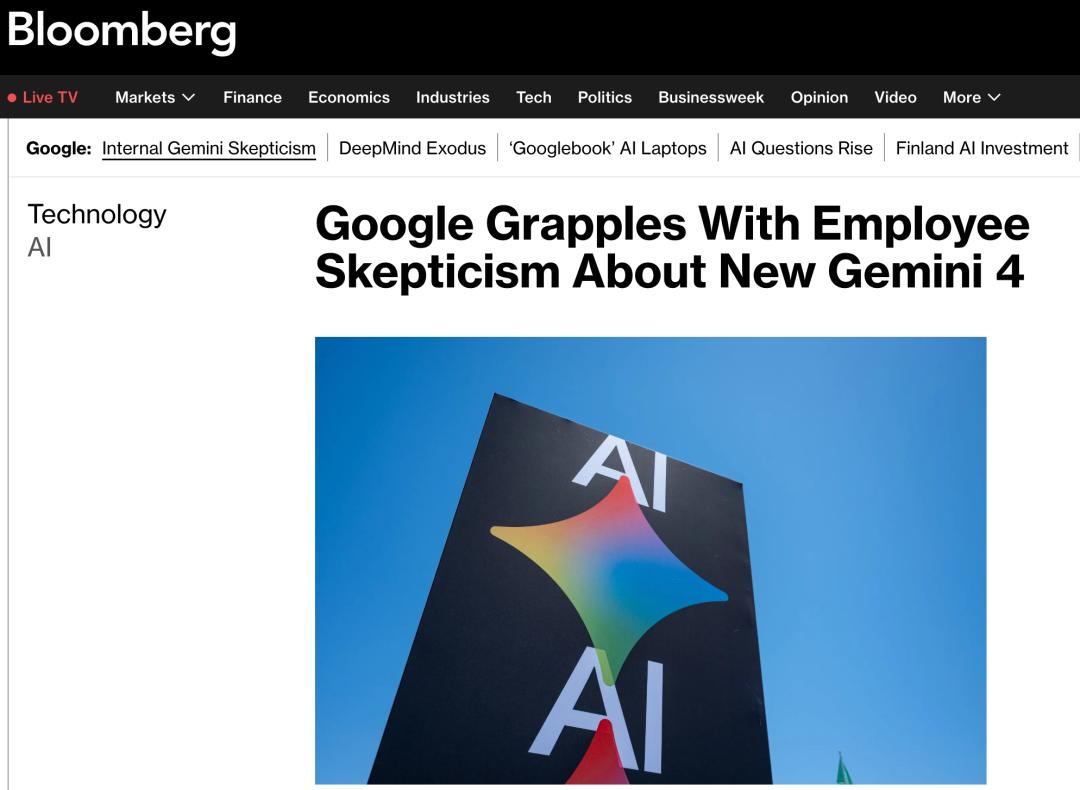
Laut einem Bericht von Bloomberg gibt es bei Google intern nach wie vor Zweifel an der Leistung von Gemini 4 bei kritischen Aufgaben wie der Codierung. Mit Kenntnis der Angelegenheit zeigte sich, dass das Modell zwar in branchenüblichen Benchmarks hervorragende Ergebnisse erzielt, aber bei der tatsächlichen Nutzung durch Mitarbeiter einige Codierungsaufgaben immer noch nicht stabil erledigt werden können.
Ob Argon seine versprochenen Fähigkeiten zur lang andauernden Schlussfolgerung und zur Ausführung komplexer Aufgaben einlösen kann, erfordert noch weitere Validierungen in realen Szenarien.
Laut Google nimmt das Unternehmen an dem freiwilligen Prozess zur Vorveröffentlichung von Modellen teil, der von der US-Regierung gefördert wird. Die ersten Tester werden Google dabei helfen, die Leistung des Modells zu bewerten und die Sicherheitsvorkehrungen weiter zu verbessern.
Nach Abschluss der frühen Tests wird Argon schrittweise für Entwickler, Unternehmen und Verbraucher freigegeben. Zu den ersten öffentlichen Nutzern gehören zahlende API-Kunden und Abonnenten von Google AI Ultra.
Referenzlinks:
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
https://www.bloomberg.com/news/articles/2026-09-30/google-grapples-with-employee-skepticism-about-new-gemini-model?srnd=phx-ai
© THE END
Für die Weiterverbreitung wenden Sie sich bitte an dieses öffentliche Konto, um eine Genehmigung zu erhalten
Für Beiträge oder Berichtsanfragen: liyazhou@jiqizhixin.com
Dieser Artikel stammt aus dem WeChat-öffentlichen Konto „Almost Human“ (ID: almosthuman2014), Autor: Experte mit Fokus auf KI, veröffentlicht mit Genehmigung von 36Kr.