"Stummes Modell" Jev ist viral geworden. Welche Veränderungen wird dies der KI-Industrie bringen?
Das Jev-Modell ist seit über einer Woche ein großer Hit. Von ausgefallenen Anwendungsweisen bis hin zu den zugrundeliegenden Paradigmen gehen die Diskussionen darüber weiter.
Jev chattet nicht mit Menschen und kann auch keine Artikel oder Codes für sie schreiben. Es tut nur eines: Wenn Entwickler ihm eine Gruppe von Auswahlmöglichkeiten und einen aktuellen Zustand übermitteln, ist es dafür zuständig, ein Urteil abzugeben.
Diogo Almeida, der Jev entwickelt hat, war früher Forscher bei OpenAI und war an Forschungen zu InstructGPT, ChatGPT und GPT-4 beteiligt. Früher hat er großen Modellen beigebracht, zu chatten – jetzt hat er umgekehrt ein Modell erstellt, das sich weigert, zu chatten.
Warum hat Almeida die Richtung gewechselt? Welche Ängste der aktuellen Branche großer Modelle trifft Jev? Wird die Reduzierung der Fähigkeiten auf das absolute Minimum zu einem zukünftigen Trend in der Modellbranche werden?
Manche Aufgaben erfordern nicht das stärkste Modell
Der Aufstieg von Jev trifft zunächst auf eines der realistischsten Probleme im Agent-Zeitalter: Der Modellaufruf muss schneller und günstiger sein.
Der Gründer des Open-Source-Projekts Browser Use hat mit Jev einen Browser-Agent erstellt, der auf der echten Seite von Google Flights nach einem Flug von Zürich nach London sucht. Der gesamte Prozess dauert 7,1 Sekunden, die Kosten pro Aufruf betragen 0,0039 US-Dollar, und die mittlere Latenz von Jev in der Schleife liegt bei etwa 178 Millisekunden.
Der Preis von Jev ist ebenfalls niedrig genug: Derzeit liegt der Eingabepreis von Jev auf dem Vercel AI Gateway bei etwa 0,04 US-Dollar pro Million Token, die Ausgabe ist kostenlos, sodass Entwickler es ohne Bedenken aufrufen können.
Langsamkeit und hohe Kosten sind zu einer gemeinsamen Sorge der Branche geworden, was damit zusammenhängt, dass Agenten aus dem Code-Umfeld in breitere Büroumgebungen vordringen.
Daten von OpenAI zeigen, dass von Februar bis Juni dieses Jahres die Zahl der wöchentlich aktiven Codex-Nutzer in den Bereichen Recht, Vertrieb und Personalbeschaffung sowie Marketing auf das 108-fache, 41-fache bzw. 26-fache gestiegen ist.
Wenn Modelle zu Infrastrukturen werden, die kontinuierlich Aufgaben ausführen, steigen auch die Aufruffrequenz und der Token-Verbrauch. Während Modellanbieter die Obergrenze der Fähigkeiten ihrer Flaggschiff-Modelle erhöhen, müssen sie angesichts der neuen Anforderungen an groß angelegte Agent-Aufrufe auch darüber nachdenken, wie Kosten und Latenz von Modellaufrufen gesenkt werden können.
Daher zeichnet sich bereits ein Differenzierungstrend auf der Modellebene ab. Heutzutage bietet derselbe Anbieter Modelle unterschiedlicher Klassen und Preise an, und es gibt eine Flut von Flash-Modellen.
Google hat im Mai Gemini 3.5 Flash auf den Markt gebracht, das auf alltägliche Entwicklungs- und Arbeitsszenarien abzielt. Am 31. Juli veröffentlichte DeepSeek V4 Flash. Ende August folgten nacheinander Qwen3.8-Flash-Next und GLM-5.3-Flash.
Diese Modelle streben nicht unbedingt danach, auf allen Benchmarks die Spitzenposition zu erreichen, sind aber auch keine „gekürzten Versionen“, bei denen Fähigkeiten weggelassen wurden. Sie sind neue Klassen, die speziell für häufige, einfache Aufgaben optimiert sind und ein günstigeres Preis-Leistungs-Verhältnis bieten.
Am Beispiel von DeepSeek: Kürzlich hat es V4 Flash auf V4.1 Flash aktualisiert und angekündigt, vor der Einführung des nächsten Pro-Modells API-Anfragen von V4 Pro an V4.1 Flash zu leiten und nach dem Preis von Flash abzurechnen.
In der Vergangenheit war die erste Reaktion der Nutzer bei einer Aufgabe, das stärkste allgemeine Modell zu suchen – je leistungsfähiger, desto besser. Die Hauptrichtung der Anbieter bestand auch darin, ein Flaggschiff-Modell so vielseitig wie möglich zu gestalten.
Aber jetzt beginnen Modellanbieter, die Fähigkeiten anhand der Komplexität von Aufgaben, der Aufruffrequenz, der Antwortgeschwindigkeit und der Kosten neu zu unterteilen und verschiedene Klassen anzubieten, sodass unterschiedliche Modelle unterschiedliche Aufgaben übernehmen.
Diese Differenzierung schreitet weiter voran. Aus Sicht der Nutzungsszenarien gibt es bereits seit langem speziell optimierte Modelle für Bereiche wie Code, Bilder und Sprache. In Szenarien wie Büroarbeit und Spielen entstehen nach und nach auch Modelle, die besser zu den jeweiligen Anforderungen passen.
Schließlich unterscheiden sich die Aufgabenstrukturen, Kontexte sowie die Anforderungen an Geschwindigkeit und Kosten in verschiedenen Szenarien, sodass Modelle den Raum haben, Kompromisse für bestimmte Teilbereiche einzugehen.
Jev ist ein extremes Beispiel im Differenzierungstrend
Während andere Modelle ihre Fähigkeiten und Preise noch im allgemeinen Rahmen anpassen, trennt Jev kurzerhand eine Art von Fähigkeiten aus dem allgemeinen Modell heraus und macht daraus ein eigenes Modell.
Entwickler übermitteln Jev einen aktuellen Zustand und eine Gruppe voreingestellter Fragen. Jev gibt Choice, Score oder Boolean mit der entsprechenden Wahrscheinlichkeit zurück. Jev erklärt nicht, warum es diese Wahl getroffen hat – das Programm kann mit dem Ergebnis direkt weiterarbeiten.
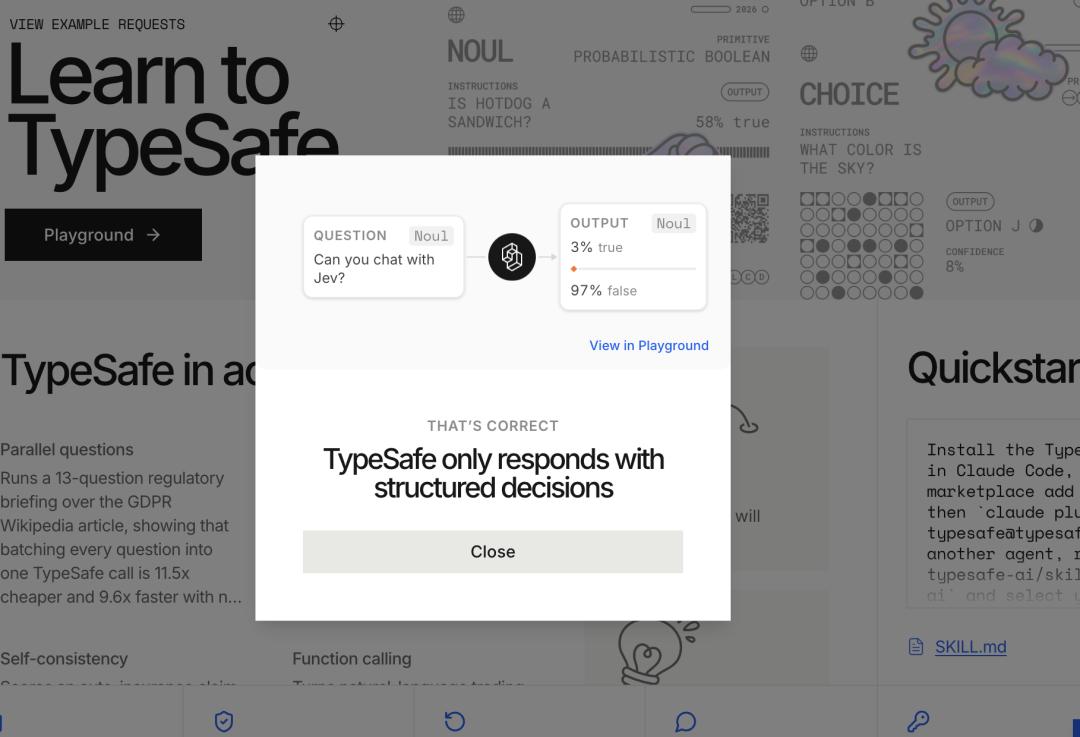
Dies ist für Agenten sehr wichtig. In einem Agent bestimmt die Ausgabe des Modells oft direkt die nächste Handlung. Zu diesem Zeitpunkt benötigt das System möglicherweise keine vollständige Antwort in natürlicher Sprache, sondern nur ein klares Signal.
Hinter diesem Design steht Almeidas Reflexion über RLHF, die Trainingsmethode für große Modelle. Seiner Meinung nach führt menschliches Feedback dazu, dass Modelle Antworten generieren, die besser zu menschlichen Präferenzen passen – aber es macht Modelle auch dazu, eine andere Gewohnheit zu entwickeln: Selbst bei Fragen, bei denen sie sich nicht sicher sind, neigen sie dazu, flüssige, vollständige und überzeugende Antworten zu geben.
Jev versucht, Unsicherheit in die Ausgabenergebnisse des Modells einzubeziehen. Wenn das Modell zu einer Sache eine 80-prozentige Sicherheit hat, sollte sein Urteil in langfristigen Statistiken zu etwa 80 Prozent korrekt sein. Nachdem das System diese Wahrscheinlichkeit erhalten hat, kann es selbst Schwellenwerte festlegen: Aufgaben mit hoher Sicherheit werden automatisch erledigt, Aufgaben mit unzureichender Sicherheit werden an Menschen oder an leistungsfähigere Modelle weitergeleitet.
Dennoch ist die Erzielung zuverlässiger automatisierter Entscheidungen durch Modelle die Richtung, die Almeida erreichen möchte – und Jev ist derzeit noch nicht an diesem Punkt angekommen.
Tests von Entwicklern haben ergeben, dass die Summe der beiden Wahrscheinlichkeiten, die Jev für dasselbe Urteil bei einer positiven und einer umgekehrten Frage ausgibt, manchmal größer als 1 ist. Ein kalibriertes Wahrscheinlichkeitssystem sollte sich nicht so verhalten. Jev gibt keine natürliche Sprache aus und vermeidet so das Risiko, eine glaubwürdige Antwort zu erfinden – aber auch die von ihm ausgegebenen Wahrscheinlichkeiten können falsch sein.
Der Agent-Einstiegspunkt, der verschiedene Modelle aufruft, wird immer wichtiger
Obwohl Jev noch viele Probleme hat, zeigt es der Branche eine weitere Möglichkeit: Die Intelligenz in Agenten kann ebenfalls aufgeteilt werden, eine komplexe Aufgabe muss nicht unbedingt von einem einzigen großen allgemeinen Modell erledigt werden.
Beispielsweise kann bei Bedarf an komplexer Schlussfolgerung ein leistungsfähiges Modell aufgerufen werden, während eine große Anzahl einfacher Urteile und Filterungen an schnellere und günstigere Modelle wie Jev übergeben werden kann.
Der Name Jev hat auch eine versteckte Bedeutung. In der Ökonomie gibt es das Konzept des „Jevons-Paradoxons“, das besagt, dass die Nutzung einer Technologie steigt, wenn sie effizienter und günstiger wird. Wenn Jev also den Akt des „Urteilens“ schneller und günstiger macht, ist es umso wahrscheinlicher, dass Agenten ihn bei der Ausführung von Aufgaben häufig aufrufen, wodurch Effizienz und Kosten der gesamten Aufgabe optimiert werden.
Das heißt, die Aufgabe selbst wird nach und nach zum Kern des Agenten. Wenn verschiedene Modelle je nach Aufgabe aufgerufen werden, können Effizienz und Kosteneffizienz der Ausführung durch den Agenten höher sein.
Die Beziehung zwischen den Modellen erhält dadurch eine weitere Möglichkeit. Früher konkurrierten Modelle darum, wer stärker ist: Sobald ein Modell an Fähigkeiten gewinnt, ersetzt es das vorherige. Jetzt können verschiedene Modelle mit der Aufgabe als Kern jeweils die Teile übernehmen, in denen sie besser sind, und im selben Agenten zusammenarbeiten.
Wenn diese Arbeitsteilung weiterentwickelt wird, wird ein Agent-Einstiegspunkt, der mehrere Modelle je nach Aufgabe aufrufen kann, immer wichtiger.
Es gibt bereits Agent-Produkte, die in diese Richtung gehen. In China unterstützt Tencent WorkBuddy bereits das Wechseln zwischen verschiedenen gängigen Modellen. WorkBuddy verfügt zudem über einen Auto-Modus: Das System wählt automatisch das aktuell am besten geeignete Modell zur Antwort aus, basierend auf Typ, Komplexität und Kontextmerkmalen der Nutzeraufgabe. Wenn Nutzer nicht wissen, welches Modell sie wählen sollen, oder mit gemischten Aufgaben konfrontiert sind, können sie das System entscheiden lassen.
Auch das aus dem Ausland stammende Cursor verfolgt einen ähnlichen Ansatz. Der im August dieses Jahres eingeführte Cursor Router prüft vor der Übergabe jeder Anfrage an ein Modell Informationen wie Aufgabentyp, Komplexität und Kontext und wählt dann das am besten geeignete Modell aus mehreren Optionen aus. Das Grundprinzip lautet: Einfache Aufgaben werden an schnelle, günstige Modelle übergeben. Schwierige, langwierige Aufgaben werden an fortschrittliche Modelle übergeben.
Die Idee dieser Produkte ist einheitlich: Die Planung von Modellen wird dem System überlassen, das sie automatisch je nach Aufgabe erledigt. Nutzer müssen nur Aufgaben stellen – die Entscheidung, welches Modell eingesetzt wird, übernimmt der Einstiegspunkt, wodurch die Effizienz der Agent-Nutzung erhöht und die Kosten gesenkt werden.
Auf lange Sicht, wenn Modelle nach und nach ihre jeweiligen Aufgaben übernehmen, wird ein Agent-Einstiegspunkt, der sie flexibel zuweisen kann, immer wichtiger.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Deep Flow Research Institute“, Autor: Xiao Ying, veröffentlicht mit Genehmigung von 36Kr.