Ein Startup-Unternehmen möchte die CPU revolutionieren.
Kürzlich ist ein relativ neues CPU-Startup aufgetaucht: Nuvacore, gegründet von den erfahrenen Ingenieuren Gerard Williams III, John Bruno und Ram Srinivasan, die zuvor bei Apple, Nuvia und Qualcomm tätig waren.
Aus ihren Lebensläufen geht hervor, dass sie alle über reichhaltige Erfahrung im Design von kundenspezifischen CPUs verfügen. Zum Beispiel war Williams zuvor Mitbegründer von Nuvia, das später von Qualcomm übernommen wurde. Darüber hinaus hat Nuvacore David Williamson, den ehemaligen Leiter des CPU-Engineerings bei Apple, als Senior Vice President of Hardware Engineering eingestellt.
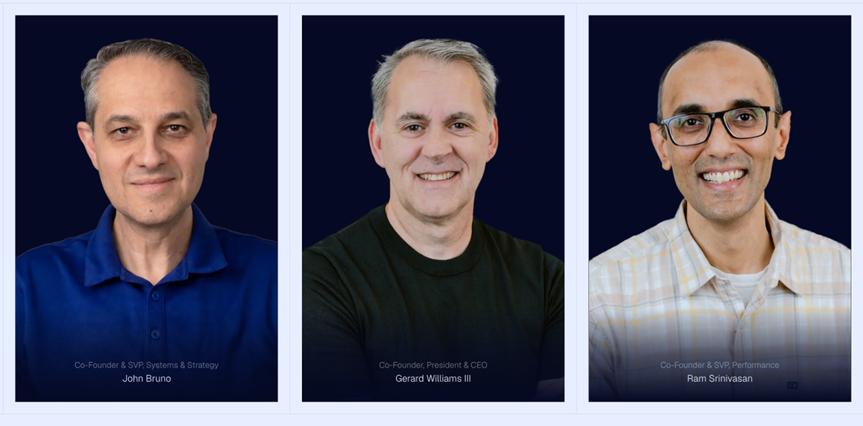
Es ist hervorzuheben, dass der Hintergrund des Gründungsteams des Unternehmens nicht eine einfache Aneinanderreihung von Lebensläufen ist. Diese Personen haben die bahnbrechendsten CPU-Architekturen der letzten zwanzig Jahre entwickelt. Sie sind keine Manager, die Chipprojekte leiten, sondern Architekten, die wichtige Mikroarchitekturentscheidungen in Bereichen wie der Tiefe der Out-of-Order-Ausführung, Strategien zur Zweigvorhersage, dem Design von Speichersubsystemen und dem Energiemanagement getroffen haben, die die Leistung des Chips direkt beeinflussen – und ihre Bemühungen haben zu enormen Erfolgen geführt.
Erwähnenswert ist, dass dieses Unternehmen Unterstützung von HSG erhalten hat. Angesichts der bisherigen Erfolgsbilanz von HSG ist die Zukunft dieses Unternehmens besonders aufmerksam zu verfolgen.
Warum ausgerechnet CPU?
Die Entscheidung, sich auf das CPU-Segment zu konzentrieren, hängt natürlich mit dem Hintergrund des Teams zusammen. Andererseits hängt sie auch mit dem Wandel der Anforderungen in der Branche zusammen.
Wie in den letzten Monaten vielfach diskutiert wurde, bewegen sich große Marktteilnehmer in eine bestimmte Richtung, um auf Agentic AI zu reagieren. Die Vera CPU von NVIDIA, die zuvor von Arm vorgestellte AGI-CPU und die Positionierung der Xeon-Prozessoren von Intel als Inferenzprozessoren zeigen alle, dass die Hauptrolle von CPUs in der Agentic AI in der Orchestrierung liegt: die Verwaltung von Tool-Aufrufen, das Routing zwischen Modellen und die Bearbeitung von Steuerungsflüssen, bei denen GPUs und Beschleuniger ursprünglich nicht stark sind. Diese Zusammenfassung ist zutreffend – aber die Realität geht weit darüber hinaus.
Überlegen Sie, was ein Agentensystem den ganzen Tag lang tut. Es taucht nicht auf, bearbeitet eine Reihe von Aufgaben und geht dann nach Hause. Stattdessen läuft es kontinuierlich. Es behält Kontextinformationen über Gespräche hinweg, die sich über Stunden oder sogar Tage erstrecken, ruft ständig Inferenzspuren aus dem Speicher ab, aktualisiert Vektorspeicher und prüft vorhandenes Wissen, bevor es über die nächste Aktion entscheidet. Diese Speicherzugriffe sind allgegenwärtig. Sie sind unregelmäßig, unvorhersehbar und unterscheiden sich stark von den klaren, wiederholbaren Mustern, die CPU-Cache-Architekten in den letzten 30 Jahren optimiert haben.
Die CPU arbeitet nicht isoliert. Sie muss mehrere Tools aufrufen, Sub-Agenten starten, auf Antworten warten und die Ergebnisse in die nächste Entscheidung einfließen lassen. Gleichzeitig teilt sie sich die gleichen Systemressourcen mit der benachbarten GPU, der zugrunde liegenden Speicherarchitektur und dem Netzwerk, das alle anderen Systeme verbindet. Klingt kompliziert? Das ist es tatsächlich. Und jeder kleine Effizienzverlust in diesem Zyklus bleibt nicht klein, er summiert sich auf. In Produktionsmaßstäben laufen Millionen von Agenteninteraktionen gleichzeitig ab, was Anforderungen an Latenz und Konsistenz stellt, die weit über die Auslegungsmöglichkeiten heutiger Server-CPUs hinausgehen.
Das Design der aktuellen Generation von Hochleistungs-CPUs basiert auf Workload-Annahmen, die vor dem Laufmodell von Agenten entstanden sind. Server-CPUs sind für vorhersehbare unternehmensweite Workloads auf Durchsatz optimiert, während Client-CPUs für Spitzenleistung und aggressives Energiemanagement optimiert sind. Keines der beiden Designs passt perfekt zu einem Prozessor, der Millionen von Agenteninteraktionen kontinuierlich, effizient und mit geringer Latenz koordinieren muss.
Auf der Grundlage der oben genannten Überlegungen lässt sich unsere optimistische Interpretation von Nuvacore grob wie folgt zusammenfassen: Das Team hat sich das aktuelle Marktumfeld angesehen und ist zu dem Schluss gekommen, dass bisher niemand wirklich einen Prozessor grundlegend entwickelt hat, der für Agentic AI geeignet ist. Die AGI-CPU von Arm stellt lediglich eine Verbesserung bestehender Produkte dar. Das Designkonzept von NVIDIA Vera zielt darauf ab, parallel zur GPU zu arbeiten. Intel Xeon wurde um einige Erweiterungen auf einer traditionellen Architektur ergänzt.
Zusammenfassend lässt sich sagen, dass der gesamte Markt auf der Grundlage von Annahmen iteriert, die bereits existierten, bevor die Merkmale von Agenten-Workloads wirklich verstanden wurden – was ihr Vertrauen in den Einstieg in dieses Segment weiter stärkt.
Das Rätsel der Befehlssatzarchitektur
Nachdem sie sich für das CPU-Segment entschieden hatten, sind sie entschlossen in dieses Feld eingetreten.
Das Unternehmen hat sich zum Ziel gesetzt, „allgemeine CPU-Kerne“ zu entwickeln, um die „intensiven und kontinuierlichen Anforderungen fortschrittlicher KI-Systeme und Agenten-Computing“ zu erfüllen – eine Aussage, die sehr interessant ist. Sie entwickeln keinen TPU, keinen Matrixbeschleuniger und keinen dedizierten Inferenz-Engine wie Cerebras und Groq. Sie entwickeln eine CPU. Die Kernargumentation von Nuvacore lautet, dass diese CPU einen grundlegenden Wandel im Bereich des Agenten-Computing herbeiführen muss. Das ist eine sehr interessante Sichtweise.
In einem am 29. September veröffentlichten Artikel stellte das Unternehmen die Besonderheiten des von ihnen entwickelten WarpCore vor. Demnach folgt das Produkt dem sogenannten „Core-First“-Entwicklungsmodell:
„Core First ist ein Ansatz, der die traditionellen Entwicklungsmethoden der Branche durchbricht und uns, das Nuvacore-Team, die Freiheit gibt, zuerst den absolut besten und leistungsstärksten Kern zu entwickeln und dann den Befehlssatz auszuwählen, der am besten zu dem System passt, das wir – oder unsere Partner – bauen wollen.“
Nuvacore gibt an, dass sie nicht zu Beginn des Projekts eine Befehlssatzarchitektur auswählen, sondern den Großteil des grundlegenden CPU-Kern-IPs zuerst entwickeln und dann den Befehlssatz auswählen können, der zu dem System passt, das sie selbst oder ihre Partner letztendlich bauen wollen.
Das unterscheidet sich stark von der traditionellen CPU-Designmethode, bei der die Zielbefehlssatzarchitektur (ISA) normalerweise von Anfang an die Entwicklungsrichtung bestimmt. Nuvacore gibt an, dass die Entkopplung von Teilen der Mikroarchitektur vom Befehlssatz es ihren Ingenieuren ermöglicht, sich freier auf Leistung, Energieeffizienz und Chipfläche zu konzentrieren.
Das Unternehmen hat noch nicht bekanntgegeben, welche ISA WarpCore letztendlich verwenden wird. In seinen Stellenausschreibungen wird jedoch erwähnt, dass die Architekturen RISC-V, Arm64 und x86 für seine Ingenieurstätigkeit relevant sind – was darauf hindeutet, dass die zugrunde liegende Entwicklung unter vollständiger Berücksichtigung der Flexibilität der ISA erfolgt.
Das bedeutet natürlich nicht, dass der Befehlssatz einfach in der letzten Phase zum Kern hinzugefügt werden kann. Dekodierung, Privilegienebenen, Speicherreihenfolge, Ausnahmebehandlung und Softwarekompatibilität stellen nach wie vor erhebliche Einschränkungen für das CPU-Design dar. Bei Nuvacore können jedoch offensichtlich viele leistungskritische Mechanismen entwickelt werden, bevor die Befehlssatzarchitektur (ISA) festgelegt wird.
Die vom Unternehmen veröffentlichten Stellenausschreibungen geben Hinweise auf die Art seiner grundlegenden Arbeit. Das Unternehmen sucht Ingenieure für die Bereiche Zweigvorhersage, Befehlsplanung, Umbenennung von Registern, Out-of-Order-Ausführung, Lade-/Speicherdesign, Cache- und Speichersubsysteme, Konsistenz und Leistungsmodellierung. Darüber hinaus sucht das Unternehmen nach Mitarbeitern für Positionen in den Bereichen RTL, Verifikation und physisches Design, deren Tätigkeiten die Prozesse bis zum Tape-Out und der Verifikation nach dem Chipherstellung abdecken.
Die rechtlichen Fragen im Zusammenhang mit der endgültigen Auswahl der Befehlssatzarchitektur (ISA) sind ebenfalls noch nicht geklärt. RISC-V ist relativ unkompliziert, da es keine Architekturlizenz wie bei Arm erfordert. Eine Arm-Implementierung, die auf der eigenen Mikroarchitektur von Nuvacore basiert, würde irgendwann eine entsprechende Arm-Architekturlizenz erfordern – was sich als schwierig erweisen könnte, da Arm sein Geschäft mit dem Verkauf von CPU-Design-IP betreibt, insbesondere angesichts der vergangenen Rechtsstreitigkeiten zwischen Arm und Qualcomm/Nuvia. Schließlich ist die Hürde bei x86 noch höher, da die Rechte zur Implementierung streng kontrolliert werden.
Das führt zu einer weiteren Möglichkeit: WarpCore könnte darauf ausgelegt sein, als wiederverwendbares CPU-IP für Partner mit entsprechenden Architekturlizenzen zur Anpassung zur Verfügung zu stehen. Das Unternehmen hat noch nicht klargestellt, ob sein langfristiges Geschäftsmodell auf vollständigen CPUs, lizenzierbaren Kern-IPs, halbkundenspezifischen Chips oder einer Kombination aus den drei Komponenten basieren wird.
Derzeit sind wichtige Details wie der Prozessknoten von WarpCore, die Cache-Hierarchie, die Pipeline-Konfiguration, Vektorfunktionen oder Tape-Out-Pläne noch nicht bekannt. Die bewusste Offenhaltung der Entscheidung über die Befehlssatzarchitektur (ISA) macht es jedoch zu einem der ungewöhnlichsten neuen CPU-Projekte, die derzeit entwickelt werden.
Schwierige Fragen, die Nuvacore beantworten muss
Vor diesem Hintergrund lassen sich einige echte Herausforderungen erkennen. Zunächst konzentrierte sich die bisherige Erfolgsbilanz des Nuvacore-Teams hauptsächlich auf den Client-Bereich, nicht auf den Rechenzentrumsbereich. Sein Ruf wurde bei Apple aufgebaut, wo Chips für ein geschlossenes Ökosystem entwickelt werden, das über bekannte Wärmeableitungsleistungen, bekannte Workloads, bekannte Software-Stacks und einen einzigen Kunden verfügt: Apple selbst. Obwohl Nuvia bei seiner Gründung im Jahr 2019 das Ziel verfolgte, in den Rechenzentrumsbereich vorzudringen, wurde es vor der Markteinführung von Serverprodukten übernommen. Das von Qualcomm tatsächlich auf den Markt gebrachte Produkt ist Oryon – ein ausgezeichneter Laptop-Chip, aber letztendlich nur ein Laptop-Chip.
Die wenig bekannte Seite der Arbeit im Rechenzentrum lautet: Es handelt sich nicht um glanzvolle Ingenieurstätigkeit. Auf verschiedenen Konferenzen erhält niemand Applaus für die Themen Zuverlässigkeit, Verfügbarkeit und Wartbarkeit (RAS) – zumindest nicht auf den beliebtesten Konferenzen. Aber wenn Sie sicherstellen müssen, dass eine CPU in einem Produktionsrack fünf Jahre lang ununterbrochen läuft, ist das die wirklich wichtige Arbeit. Fehler zu erkennen und zu isolieren, bevor sie einen Knoten zum Absturz bringen, perfekt mit dem Hypervisor-Stack zusammenzuarbeiten und die NUMA-Topologie so gut zu verstehen, dass keine unerwarteten Engpässe entstehen – das ist das Wesen der Arbeit im Rechenzentrum.
Intel und AMD betreiben seit Jahrzehnten genau diese Arbeit auf der x86-Architektur. Diese Fähigkeit ist tief in ihrer Organisationsstruktur verwurzelt und lässt sich nicht in Produkt-Roadmaps ablesen. Es handelt sich um ein tief verwurzeltes organisatorisches Gedächtnis, das aus jahrelangen harten Gesprächen mit Unternehmenskunden bei Ausfällen um zwei Uhr morgens stammt. Auch das Neoverse-Projekt von Arm ist erwähnenswert. Diese Chips sind im Rechenzentrum nicht erfolgreich, weil ihre Benchmark-Ergebnisse gut sind, sondern weil Arm Jahre damit verbracht hat, eng mit Unternehmen wie AWS, Microsoft und Google zusammenzuarbeiten, um eine ausführliche Liste von rechenzentrumspezifischen Anforderungen zu lösen, die man niemals in Pressemitteilungen sieht. Diese Zeit der Zusammenarbeit ist nicht optional, sondern eine notwendige Voraussetzung für den Erfolg.
Es gibt keinen Grund anzunehmen, dass das Nuvacore-Team diese Arbeit nicht bewältigen kann; die erforderlichen Fähigkeiten können erlernt und eingestellt werden. Aber dies unterscheidet sich stark von den Projekten, die sie zuvor entwickelt haben, und die Unterschiede sind nicht zu vernachlässigen. Bemerkenswert ist, dass die vom Unternehmen veröffentlichten Stellenausschreibungen Positionen für den Leiter des Betriebssystems, den Leiter der Firmware, den Leiter für Telemetrie und Beobachtbarkeit sowie den Leiter der Software-Verifikation umfassen. Die Stellenliste ist korrekt. Die Frage ist, ob dieser Ausführungszeitraum angesichts der Geduld von HSG und potenziellen Kunden realistisch ist.
Es gibt noch eine weitere Herausforderung, die bisher nicht ausreichend berücksichtigt wurde: Sind Rechenzentren wirklich bereit für die nächste Generation von Chips? Ich denke nicht – aber der Grund ist möglicherweise nicht der, den Sie vermuten. Es handelt sich nicht um ein Problem der technischen Reife, sondern um Ermüdung. Rechenzentrumsarchitekten haben keine freie Zeit, um sich nach weiteren Anbietern für die Bewertung umzusehen. Chief Information Officers sind bereits erschöpft von der Verwaltung bestehender Systeme und bemühen sich, die neue Generation von KI-Infrastruktur in bestehende Umgebungen zu integrieren.
Alle Unternehmen, die neue Chips auf den Markt bringen, unterschätzen stets die Kosten, die Kunden letztendlich für die Entscheidung zur Einführung dieser Chips aufwenden müssen. Die Bewertung von Chips, die Zertifizierung, die Integration, die Schulung von Teams und die Unterstützung bei auftretenden Fehlern – all das verbraucht die begrenzten Ressourcen von Unternehmen.
Dass eine neu entwickelte CPU tatsächlich in Rechenzentren eingeführt wird, tritt normalerweise in einem von drei Fällen ein: Ein Hyperscale-Rechenzentrum übernimmt sie als kundenspezifischen Chip; ein etablierter OEM verspricht, eine Plattform um sie herum aufzubauen; oder der Unterschied in Leistung und Effizienz ist groß genug, um den Kostendruck zu erhöhen und Unternehmen zu einer Neubewertung zu bewegen.
Ich gehe davon aus, dass Nuvacore den dritten Weg verfolgt. Um diesen Weg zu beschreiten, muss es jedoch vor der Auslieferung von Serienchips Designaufträge von Hyperscale-Rechenzentren (höherwahrscheinlich) abschließen oder Partnerschaften mit OEMs aufbauen (möglicherweise). Dies erfordert einen hohen Einsatz von Vertrauenskapital, da das Produkt mindestens zwei bis drei Jahre bis zum Tape-Out benötigt. Ich vermute, dass das Nuvacore-Team bereits über einen Teil dieses Vertrauenskapitals verfügt. Ob die Finanzierung ausreicht und der Zeitplan mit den mehrjährigen Planungszyklen der Produkt-Roadmaps von Hyperscale-Rechenzentren übereinstimmt, ist derzeit noch unklar.
Abschließend können wir kurz über das Wort „CPU“ sprechen? Ich habe das Gefühl, dass es heute viele Aufgaben übernimmt, für die es ursprünglich nicht ausgelegt war.
Gegenwärtig ist „CPU“ eher ein Positionierungsbegriff als eine genaue Beschreibung der Architektur. Was wir tatsächlich diskutieren – egal ob es sich um Nuvacore, die AGI-CPU von Arm, NVIDIA Vera oder Intel Xeon mit AMX-Technologie handelt – ähnelt eher einem „Host-Prozessor in heterogenen Computersystemen im Zeitalter der KI“. Das ist eine genauere Bezeichnung, auch wenn sie niemals in Produktspezifikationen auftauchen wird. Daher verwenden alle derzeit das Wort „CPU“ und hoffen, dass Kunden die eigentliche Bedeutung selbst verstehen.
Nuvacore wird sich diesem Problem direkt stellen müssen. Was genau sie entwickeln, wird direkt