10,7-fache Beschleunigung: Sobald diese Edge-Inferenz-Engine quelloffen veröffentlicht wird, laufen große Modelle auf dem Roboter-Endgerät endlich völlig ruckelfrei.
In der zweiten Septemberwoche war die Szene der verkörperten Intelligenz sehr lebhaft.
Am 8. veröffentlichte Songyan Power das HERON-World Model; am 9. brachte Agility Robotics auf einen Schlag AGILE 2.0 und GE-Act 2.0 heraus; am 10. stellte Unitree das Open-Source-Modell UnifoLM-WLA-1.0 mit 6 Milliarden Parametern und rund 2500 Stunden echter Maschinendaten vor, das 64 Aufgaben mit einem einzigen Modell steuert; bis zum 15. ergänzte Songyan dann noch HERON-CRA. Acht Tage, drei Hersteller von Roboterkörpern, fünf Modelle.
Gleichzeitig treten Roboter zunehmend beschleunigt in die physische Welt ein. Am 20. September veranstaltete Qiyuan Robot eine neue Produktpräsentation, auf der zwei persönliche Roboter offiziell zum Verkauf angeboten wurden, wobei das Modell Q1 ab 19999 Yuan erhältlich ist. Bereits am 10. September kündigte Ubtech an, Auslandsaufträge im Wert von über 50 Millionen Yuan erhalten zu haben, die Produkte wie Walker C1 und U-World U1 umfassen. Auch die Bewertungsmaßstäbe des Kapitalmarkts ändern sich entsprechend: Man beginnt, Unternehmen für verkörperte Intelligenz anhand von entkonsolidierten Wiederkaufraten, operativen Netto-Cashflows und echten Erfüllungskosten (also den Aufwendungen für Bereitstellung, Einrichtung und Wartung nach der Auslieferung) neu zu bewerten.
Wenn sich diese beiden Entwicklungslinien kreuzen, tritt ein zentrales Problem zutage: Wie lassen sich komplexe, leistungsstarke große Modelle für verkörperte Intelligenz effizient und stabil auf die Hardware von Roboterkörpern mit extrem begrenzter Rechenleistung bereitstellen? Genau hier liegt der Kernwert von Edge-Inferenz-Engines.
Am 15. September veröffentlichten die Tsinghua-Universität gemeinsam mit Wuyuan CoreQ und der Shanghai Jiao Tong-Universität APXInf als Open-Source-Projekt, eine Edge-Inferenz-Engine speziell für Modelle der verkörperten Intelligenz. Sie beantwortet gleichzeitig zwei Fragen:
Wie lässt sich in Edge-Umgebungen mit begrenzter Rechenleistung, Arbeitsspeicher und Leistungsaufnahme eine nutzbare Inferenzgeschwindigkeit für Modelle der verkörperten Intelligenz auf dem Roboterkörper erreichen?
Wie lässt sich eine kontinuierlich anpassbare, stets aktuelle Edge-Optimierungsfähigkeit aufbauen, wenn sich die Modelle ständig weiterentwickeln?
Für die erste Frage liefert APXInf eine Reihe von Zahlen als Antwort: Ohne das π0.5-Modell selbst zu verändern, wird durch end-to-end Full-Stack-Optimierung die Inferenzlatenz unter der FP8-Konfiguration des Thor-Chips von 278 ms auf 26 ms gesenkt. Die end-to-end-Beschleunigung beträgt etwa das 10,7-fache, und die Frequenz von 38,46 Hz führt die Robotersteuerung in den Echtzeitbereich.
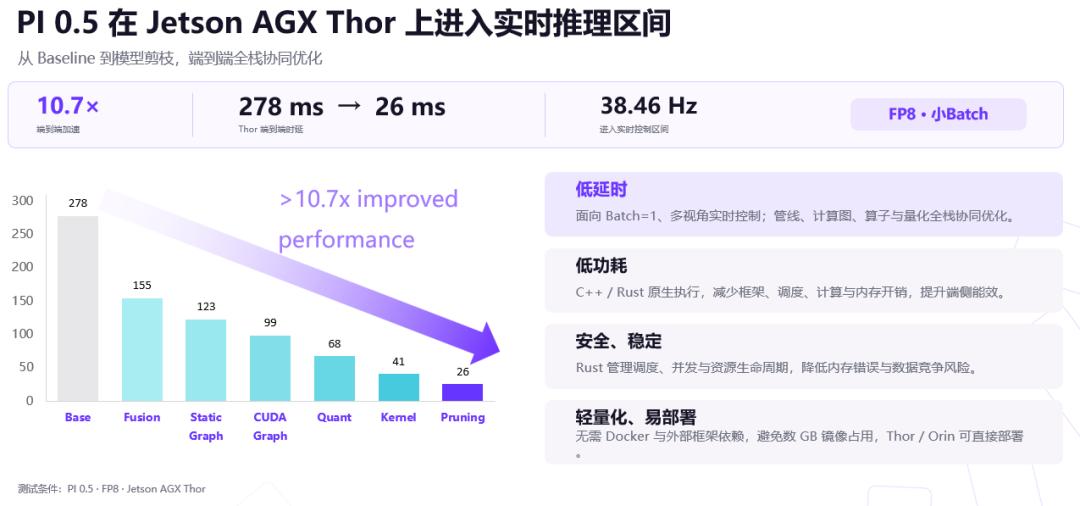
Die Antwort auf die zweite Frage liegt in der Art und Weise, wie das APXInf-Repository aufgebaut ist. Es wandelt die Modellanpassung, -optimierung und -validierung, die ursprünglich auf wenige Experten angewiesen waren, in einen wiederverwendbaren Arbeitsablauf um, der von Agenten genutzt werden kann.
Projektadresse: https://github.com/RLinf/APXinf-robo
Warum erfordert die verkörperte Intelligenz eine spezielle Edge-Inferenz-Optimierung?
Um diese Frage zu beantworten, muss zuerst die Position der Inferenz-Engine in einem Roboter klar erkannt werden.
Ein Körper für verkörperte Intelligenz besteht grob aus einer Hauptsteuerungseinheit, einem Rechenleistungsmodul und Peripheriegeräten. Ein Steuerungsablauf läuft wie folgt ab: Die Hauptsteuerung erfasst Beobachtungen, das Rechenleistungsmodul leitet einen Aktions-Chunk ab, sendet diesen an den Arm oder das Fahrgestell zur Ausführung und geht dann zum nächsten Frame über. Die Inferenz-Engine ist genau in der Mitte dieses Ablaufs eingebettet: Sie bestimmt, wie viele Millisekunden eine Inferenz dauert, welche Hertz-Zahl die Steuerungsfrequenz erreichen kann und wie groß, heiß und teuer das Rechenleistungsmodul sein muss.
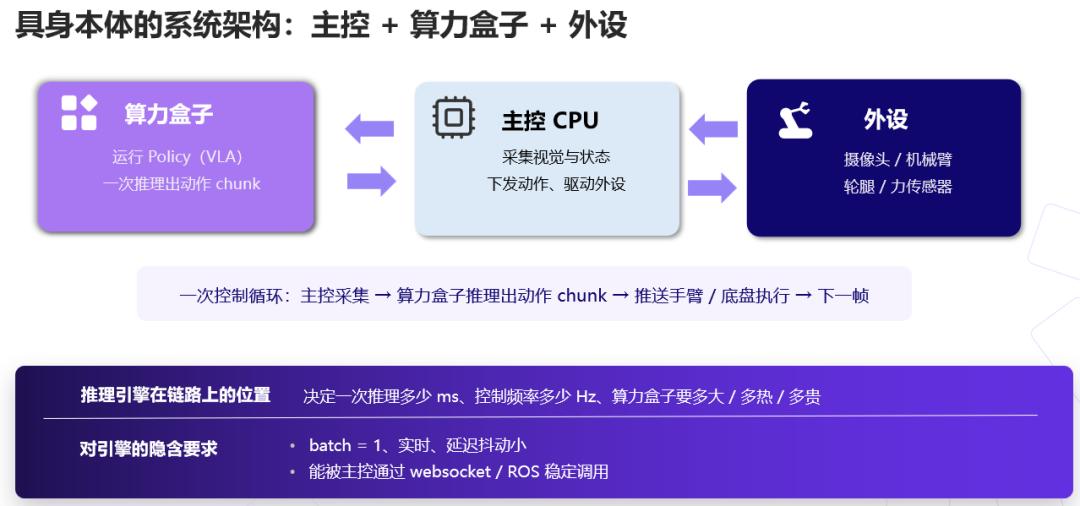
Diese Position stellt sehr spezifische Anforderungen an die Engine: Kleiner Batch-Einsatz, Echtzeitfähigkeit, geringe Latenzschwankungen und stabiler Aufruf durch die Hauptsteuerung über Websocket oder ROS. Genau diese Punkte sind die Stärken von Cloud-Inferenz-Frameworks nicht.
Allgemeine Inferenz-Frameworks nutzen ein einheitliches Zwischenformat, um Modelle schichtweise zu verarbeiten, und übergeben sie dann an die Backend-Ebene zur Generierung ausführbaren Codes. Ein einziger Kompiliervorgang deckt so viele Modelle und Hardwaregeräte wie möglich ab. Lösungen wie vLLM und SGLang sind hingegen auf den Cloud-Durchsatz ausgelegt. Beide sind für ihre jeweiligen Anwendungsfälle sehr erfolgreich, aber ihre Vorteile basieren auf der Voraussetzung einer großen Anzahl von Modellarten, großen Batches und ausreichendem Planungsspielraum – die drei Bedingungen, die im Edge-Bereich für verkörperte Intelligenz nicht erfüllt sind.
Daraus ergeben sich drei praktische Engpässe bei der Edge-Bereitstellung von Modellen für verkörperte Intelligenz.
Edge-Leistung. Auf der Edge-Seite sind Rechenleistung, Bandbreite, Leistungsaufnahme und Wärmeabfuhr gleichzeitig begrenzt, während eine einzelne Inferenz die mehrperspektivische Wahrnehmung, die Vorwärtsberechnung des Modells und die Aktionsgenerierung abschließen und mit stabilem Rhythmus auf die Hauptsteuerung reagieren muss. Die Speicherbandbreite von Edge-Modulen unterscheidet sich um das 4- bis 8-fache von der unabhängigen Grafikkarte, die Leistungsaufnahme um das 5- bis 10-fache. Deshalb können Modelle, die in der Cloud reibungslos laufen, auf Thor oder Orin deutlich schlechtere Ergebnisse erzielen.
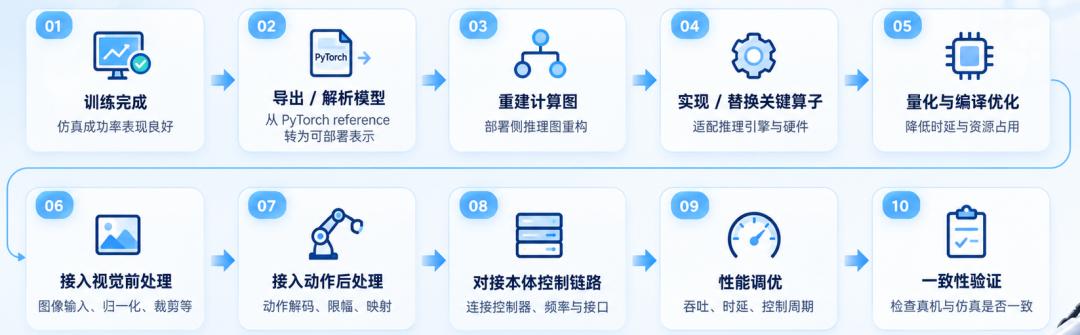
Personal und Zeit. Die Bereitstellung von Modellen auf Edge-Hardware ist kein einfacher Kopiervorgang, sondern ein umfangreiches Systemprojekt. Es durchläuft den gesamten Prozess von der Anpassung der unteren Architektur, der Kompilierung der Kernoperatoren und der Genauigkeitsquantisierung bis hin zur Optimierung der Software- und Hardwareleistung und der Simulationsvalidierung. Dieser Vorgang dauert normalerweise mehrere Wochen und erfordert fachübergreifende Experten, die sich sowohl mit Inferenzsystemen als auch mit der Optimierung von Operatoren auskennen – solche Fachkräfte sind in jedem Unternehmen für verkörperte Intelligenz sehr rar. Noch wichtiger ist: Kleinste Änderungen an der Hardware können alle bisherigen Arbeiten zunichte machen. Sobald der Chip ausgetauscht wird, müssen alle Operator-Auswahlen, Speicherlayouts und Pipeline-Anordnungen von Grund auf neu erstellt werden.
Stabilität. Dass ein Demo funktioniert, ist etwas anderes als ein langfristig stabiler Betrieb. Letzterer muss mit kontinuierlicher Wahrnehmungssteuerung, begrenzten Ressourcen und der Zusammenarbeit mehrerer Module umgehen können. Das größte Risiko besteht nicht darin, dass es etwas langsamer läuft, sondern dass es während des Betriebs zu Schwankungen, Einfrierungen oder unkontrollierten Zuständen kommt.
Wenn diese drei Punkte zusammenkommen, ergibt sich ein multiplikativer Effekt:
Der Gesamtaufwand für die Bereitstellung des Modells auf dem Roboter ≈ (einmalige Integration + einmalige Optimierung) × Anzahl der Robotermodelle × Anzahl der Chip-Plattformen × Anzahl der Modelliterationen.
Jede Variable auf der rechten Seite wächst rasant: Die Anzahl von Robotermodellen steigt, die Chips werden vielfältiger und der Iterationszyklus der Modelle verkürzt sich extrem. Tatsächlich sind die fünf Modelle innerhalb von acht Tagen zu Beginn des Artikels ein direktes Beispiel für diese Situation. Es ist nicht praktikabel, das Team einfach zu vergrößern. Was benötigt wird, ist eine wiederverwendbare Infrastrukturebene: Sie muss nicht nur die einzelne Inferenz an die Grenzen der Hardware bringen, sondern auch die Integration des nächsten Modells und des nächsten Chips ermöglichen, ohne von Grund auf neu anzufangen.
Genau diese Ebene soll APXInf bilden.
Wie schafft es APXInf, die Inferenz in den Echtzeitbereich zu bringen?
Betrachten wir zuerst die erste Herausforderung: Wie kann die Inferenzeffizienz auf begrenzter Hardware maximal ausgeschöpft werden.
APXInf verfolgt nicht das primäre Ziel, ein einheitliches allgemeines IR zu schaffen, sondern legt den Fokus auf die Entwicklung spezialisierter Ausführungspfade für Modellfamilien. Die Modellstruktur, das Gewichtslayout, der Speicherbereich, die Operator-Fusionslösung und die Ausführungsreihenfolge werden direkt im Code abgebildet. Nur gemeinsame Funktionen, die in mehreren Modellen validiert wurden, werden zu gemeinsamen Modulen weiterentwickelt. Dieses Design ermöglicht eine Optimierung, die tief in die Modellstruktur und die Hardwareeigenschaften eindringt, um gezielte Anpassungen bei der Operator-Auswahl, dem Speicherlayout und dem Ausführungsablauf vorzunehmen und zusätzlichen Aufwand zu reduzieren, der durch die Kompatibilität mit allgemeinen Szenarien entsteht.
Zur Laufzeit werden nur die Steuerungsfunktionen beibehalten, die für die Echtzeit-Inferenz auf der Edge wirklich benötigt werden:
Für die Operator-Ausführung wird CUDA Graph verwendet, um die gesamte Grafik zu erfassen und stabil abzuspielen. Die Kernel-Auswahl wird durch Autotune generiert und dauerhaft gespeichert;
Der Arbeitsspeicher wird von der Modellebene als fester Workspace verwaltet, mit festen Formen, vorab zugewiesenen und stabilen Adressen, um den Datentransport auf dem heißen Pfad zu reduzieren;
Die Planung konzentriert sich auf die Echtzeit-Inferenz mit kleinem Batch und führt keine Continuous Batching oder Paged Attention ein, die für den Durchsatz großer Batches ausgelegt sind.
Da zur Laufzeit keine komplexen Heuristiken ausgeführt werden, sind die Ausführungspfade vorhersehbar, reproduzierbar und überprüfbar.
Diese Spezialisierung erstreckt sich bis auf die Kompilierungsebene: Beim Kompilieren wird die Rechenleistung der lokalen GPU abgefragt, und Kernel werden nur für diese eine Architektur kompiliert. Die Quellcodes von CUDA Kernel, CUTLASS und FlashAttention sind im Repository integriert. Für die Bereitstellung werden keine Docker-Images oder Abhängigkeiten von externen Frameworks benötigt, wodurch mehrere Gigabyte große Images eingespart werden.
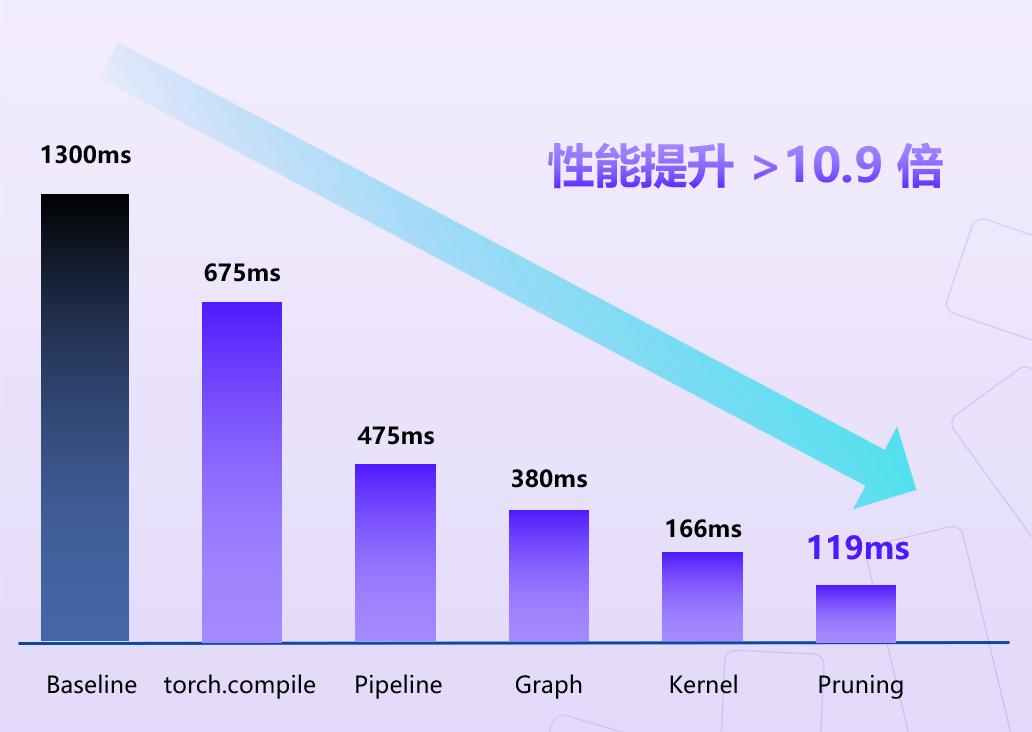
Letztendlich führt diese Full-Stack-Optimierung zu einer enormen Steigerung der Effizienz. Die Optimierungsstufen auf Orin zeigen dies: Der Ausgangswert liegt bei 1300 ms, und durch schrittweise Optimierungen mit torch.compile, Pipeline, Graph, Kernel und Pruning sinkt er schließlich auf 119 ms, was einer Gesamtverbesserung von über 10,9-fach entspricht. Auf Thor verhält es sich genauso.
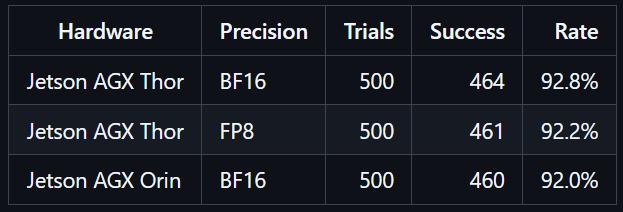
Was die Leistung betrifft, sieht das offizielle Bewertungsprotokoll 50 Episoden für alle 10 Aufgaben von LIBERO-10 vor, mit einem festen Seed-Wert von 7 und einer Replan-Schrittweite von 5, was insgesamt 500 Rollouts ergibt. Die Erfolgsrate unter Thor FP8 beträgt 92,2 %, unter Thor BF16 92,8 % und unter Orin BF16 92,0 %. Als Referenz liegt die Referenzimplementierung von π0.5 bei 92,4 %.
Nicht nur schnell, sondern auch stabil: APXInf konzentriert sich auf leistungsstarke Operatoren in der unteren Ebene, um die Leistung maximal auszunutzen. Der Hauptteil des Inferenz-Frameworks wird in der Rust-Sprache entwickelt. Als Systemsprache ermöglicht Rust eine kostengünstige, feingranulare Steuerung des Systemlaufzeits und erzielt eine bessere Planung und Parallelverwaltung. Gleichzeitig reduziert das erzwungene RAII-Konzept und das Eigentümersystem von Rust das Risiko von Speicherproblemen erheblich, unterstützt eine sicherere und robustere Verwaltung des Ressourcenlebenszyklus und beschränkt unsichere Codebereiche streng auf feste FFI-Grenzen. Der systemweite Wert dieser mittleren Ebene besteht darin, versteckte Fehler wie Zeigerfehler und Datenkonflikte so weit wie möglich vor der Inbetriebnahme zu beseitigen. Für einen Roboter, der kontinuierlich arbeiten soll, reicht es nicht aus, „38 Hz zu erreichen“ – er muss auch „nach acht Stunden Dauerbetrieb noch 38 Hz stabil halten“.