Vier Wege für chinesische GPUs
Der inländische GPU-Sektor klingt wie ein Wettbewerb, oder?
Bei genauerem Hinsehen ist das überhaupt nicht der Fall: Es gibt vier völlig unterschiedliche Entwicklungspfade. Sehen wir uns zuerst die Grundlagen an: Der Marktanteil von NVIDIA auf dem chinesischen KI-Chip-Markt lag 2022 noch bei etwa 95 %. Laut der Prognose von Bernstein wird er bis Mitte 2026 insgesamt auf 8 % fallen, und der Hochleistungsbereich ist fast vollständig durch inländische Produkte ersetzt worden.
Aus einer anderen Perspektive schätzt Reuters, dass NVIDIA immer noch etwa 55 % des Gesamtmarkts hält. Zählt man beide Zahlen zusammen, ergibt sich: Der Hochleistungsbereich ist die Domäne inländischer Anbieter, während der Mittel- und Niedrigleistungsbereich noch in einem heftigen Wettkampf steckt.
Diese vier Unternehmen verfolgen auch unterschiedliche technische Routen.
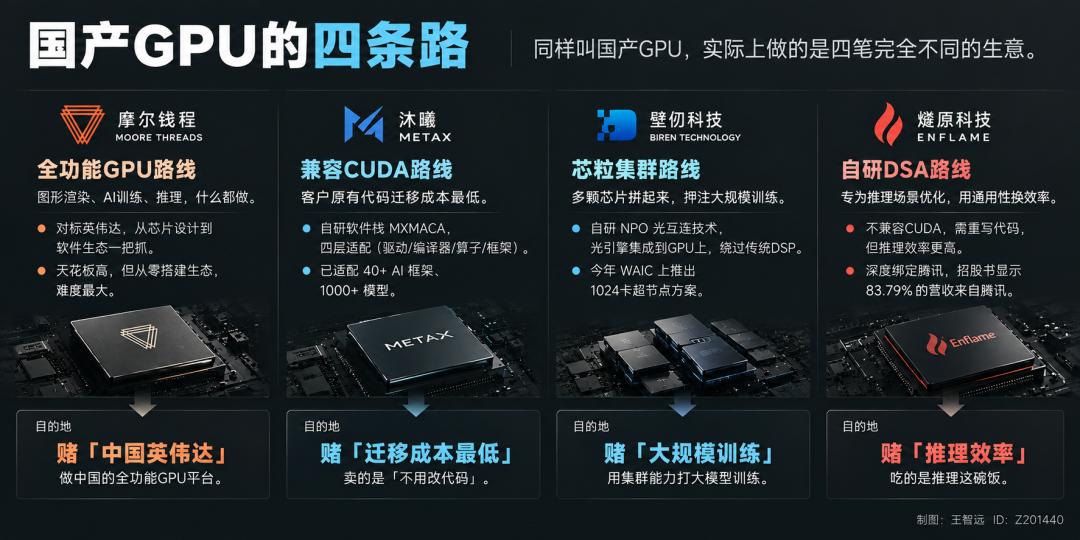
Moore Threads verfolgt den Ansatz einer voll funktionsfähigen GPU, die Grafikrendering, KI-Training und Inferenz abdeckt; es folgt dem Weg von NVIDIA und übernimmt alles von der Chip-Entwicklung bis zur Software-Ökosystem.
Die Obergrenze ist sehr hoch, aber die Tatsache, dass alle Bereiche abgedeckt werden, bedeutet, dass Chip-Architektur, Software-Stack und Entwickler-Ökosystem alle von Grund auf neu aufgebaut werden müssen. Der Burggraben, den NVIDIA über mehr als zwanzig Jahre aufgebaut hat, muss das Unternehmen von vorne nachvollziehen.
MetaX hingegen hat sich für die CUDA-Kompatibilität entschieden.
Der Code, der ursprünglich auf NVIDIA-Grafikkarten ausgeführt wurde, kann mit minimalem Migrationsaufwand auf die Karten von MetaX übertragen werden. Der Preis dafür? Man wird für immer dem Tempo von NVIDIA hinterherlaufen: Jedes Mal, wenn die Konkurrenz eine neue Generation aktualisiert, muss man ihr folgen.
Das selbst entwickelte Software-Stack MXMACA hat vier Anpassungsebenen implementiert, die Treiber, Compiler, Operatoren und Frameworks vollständig abdecken, und wurde bereits für mehr als 40 KI-Frameworks und über 1000 Modelle angepasst.
Einfach ausgedrückt verkauft MetaX den Vorteil „kein Code muss geändert werden“.
Am interessantesten ist Biren, das auf Chiplets setzt: Da ein einzelner Chip nicht beliebig groß gemacht werden kann, werden mehrere kleine Chips wie Bausteine zusammengesetzt.
In Kombination mit der selbst entwickelten NPO-optischen Interkonnektionstechnologie wird die optische Engine direkt in die GPU integriert, um herkömmliche DSP-Chips zu umgehen und eine Übertragung mit niedriger Latenz über große Entfernungen zu ermöglichen. Auf dem diesjährigen WAIC stellte das Unternehmen ein 1024-Karten-Superknoten-Lösung vor.
Es setzt auf das groß angelegte Training: Wenn eine einzelne Karte nicht ausreicht, springt ein Cluster ein. Das Zusammenfügen von Chips ist einfach, aber die Kommunikationslatenz und Konsistenz zwischen den Chips sind die eigentlichen Probleme, die NPO lösen soll.
Enflame geht den einzigartigsten Weg: Es hat eine eigenentwickelte DSA-Architektur, die speziell für Inferenzszenarien optimiert ist und nicht mit CUDA kompatibel ist. Benutzer müssen den Code neu schreiben, aber in Inferenzszenarien ist die Effizienz höher.
Dieser Kompromiss, Allgemeinheit gegen Effizienz einzutauschen, zeigt, wie überzeugt das Unternehmen von der Einschätzung des Anwendungsfalls ist. Es konzentriert sich auf das Inferenzgeschäft und ist eng mit seinem größten Kunden Tencent verbunden. Laut den Zahlen im Prospekt stammen 83,79 % der Einnahmen von Tencent – das Unternehmen ist tief verbunden, und Tencent ist sein größtes Testfeld.
Nun, diese vier Unternehmen werden alle als „inländische GPU“ bezeichnet, aber ihre Endziele sind völlig unterschiedlich: Moore Threads will das chinesische NVIDIA werden, MetaX wirbt mit minimalem Migrationsaufwand, Biren setzt auf groß angelegtes Training, und Enflame konzentriert sich vollständig auf das Inferenzgeschäft.
Man sieht, vier Wege führen zu vier verschiedenen Zielen – das ist keineswegs derselbe Wettbewerb.
Wie werden diese Ziele ausgewählt? Sie werden von der Marktstruktur bestimmt. Im Jahr 2025 machte der Inferenzbereich bereits 67 % des KI-Servermarktes aus, während der Trainingsbereich nur 33 % ausmachte. Das Volumen der Inferenznachfrage ist vier- bis fünfmal so groß wie das des Trainings.
Enflame konzentriert sich ausschließlich auf Inferenz, genau der Bereich mit dem schnellsten Wachstum. Huawei und Cambricon verfolgen den Ansatz eines vollen Stacks für Training und Inferenz und decken beide Bereiche ab. Trotz aller Unterschiede zwischen den vier Wegen gibt es eine gemeinsame Realität, die nicht umgangen werden kann: Hier eine Gruppe von Daten:
Im Jahr 2025 wurden 1,65 Millionen inländische KI-Beschleuniger ausgeliefert. Huaweis Ascend belegte mit 810.000 Einheiten den ersten Platz, T-Head folgte mit 265.000 Einheiten auf dem zweiten Platz, Cambricon und Kunlunxin belegten gemeinsam den dritten Platz mit je 116.000 Einheiten. Zusammen machen die vier „kleinen Drachen“ weniger als 7 % des Marktes aus.
Nur 7 % – man bedenke, dass Huawei allein die Hälfte des Marktes einnimmt. Der eigentliche Hauptakteur in diesem Sektor ist Huawei, während die vier kleinen Drachen eher wie vier verschiedene Nebenflüsse sind, deren Wassermenge noch sehr gering ist.
Und NVIDIA: Betrachtet man den Gesamtmarkt aus einer anderen Perspektive, hält es immer noch etwa 55 % des Anteils, aber der Hochleistungsbereich ist fast vollständig ersetzt. Wenn man beide Zahlen zusammen betrachtet, stellt man fest, dass der Hochleistungsbereich fast ein separater Markt ist, während der Mittel- und Niedrigleistungsbereich noch in einem harten Wettkampf steckt.
Interessanterweise stoßen sie unabhängig von ihrem gewählten Weg auf genau dieselben Engpässe.
......
Erster Engpass: Die Fertigungstechnologie. Alle inländischen GPU-Unternehmen müssen Auftragsfertiger suchen, und SMIC ist die unvermeidliche Wahl.
Die Kapazität für fortschrittliche Fertigungsverfahren ist knapp, und Huawei hat etwa 43 % davon gebunden. Von jeweils 10 Wafern mit fortschrittlicher Fertigungstechnologie, die SMIC produziert, gehen mehr als 4 an Huawei, der Rest steht den anderen GPU-Unternehmen zur Verfügung, die in der Warteschlange stehen.
Dieses Problem lässt sich nicht übereilen: Der Bau einer Waferfabrik erfordert Investitionen von mehreren zehn Milliarden Yuan und einen Zeitraum von drei bis fünf Jahren, der nicht durch Finanzierung beschleunigt werden kann.
Laut der Prognose im CHIPS IV-Bericht von Goldman Sachs vom September 2026 wird die Lücke bei fortschrittlichen Fertigungsverfahren in China bis 2035 von 92 % auf 34 % sinken. Die Richtung ist positiv, aber derzeit stehen diese vier Unternehmen immer noch in der Warteschlange.
Die Lagerumschlagsdauer von Moore Threads beträgt 658 Tage – fast zwei Jahre an Produktionskapazität stapeln sich im Lager und binden das gesamte Cashflow. Das Unternehmen produziert große Mengen, sobald es Zugang zu Kapazitäten bekommt, eine Überlebensstrategie, die durch die Kapazitätsknappheit erzwungen wird.
Zweiter Engpass: Das Ökosystem. Jedes Unternehmen hat seinen eigenen Software-Stack, der nicht mit denen anderer kompatibel ist.
Wenn ein KI-Unternehmen inländische GPUs nutzen möchte, muss es die Toolchain des jeweiligen Anbieters verwenden, den Code neu schreiben und die Frameworks neu anpassen. Bei einem Wechsel zu einem anderen Lieferanten sind erneut Anpassungen und Debugging erforderlich. Die Lernkosten des Teams und die Zeit für die Fehlerbehebung sind alle versteckte Ausgaben.
Beim Einkauf darf man nicht nur die Parameter der einzelnen Karten betrachten, sondern muss prüfen, ob die gesamte Toolchain gut funktioniert und das Team sie beherrschen kann.
Ein treffender Satz lautet: Der Hardware-Unterschied schrumpft, der eigentliche Engpass liegt im Software-Ökosystem. Zwischen dem Stadium „funktionsfähig“ und dem Stadium „gut nutzbar“ klafft noch eine riesige Lücke.
Man sieht, vier Unternehmen mit vier verschiedenen Software-Stacks bedeuten, dass jedes Unternehmen unabhängig ein unvollständiges CUDA neu aufbaut.
Der Burggraben von NVIDIA besteht nicht nur aus der Toolchain selbst, sondern aus Operator-Bibliotheken, Debugging-Erfahrungen und Community-Fragen, die Millionen von Entwicklern weltweit über mehr als zwanzig Jahre angesammelt haben. Dafür gibt es keine Abkürzungen.
Die Fehler, die ein Ingenieur im NVIDIA-Ökosystem gemacht hat, und die erlernten Fähigkeiten werden bei dem Wechsel zu einer inländischen GPU vollständig nutzlos.
Außerdem wiederholt jedes Unternehmen das Rad neu: Compiler, Operator-Bibliotheken, Debugging-Tools werden alle von Grund auf neu entwickelt. Die Ressourcen sind auf vier parallele Pfade verteilt. Ursprünglich hätte die Konzentration von 10 bis 20 Milliarden Yuan ein brauchbares Ökosystem aufbauen können, jetzt wird der Betrag auf vier Teile verteilt, jeder Teil beträgt nur 2 bis 3 Milliarden Yuan – und reicht nicht aus, um ausreichende Tiefe zu erreichen.
Diese Zeitdifferenz kann nicht durch das Einstellen von mehr Personal ausgeglichen werden. Das Problem der fragmentierten Ökosysteme ist kurzfristig nicht lösbar.
Dritter Engpass: Die Kunden.
Wovon haben inländische GPU-Unternehmen in den letzten Jahren gelebt? Von Bestellungen im Bereich der vertrauenswürdigen Informationstechnologie (Xinchuang). Beschaffungen von Regierungen und Staatsunternehmen bilden die Grundbasis. Aber das Xinchuang-Segment hat eine niedrige Obergrenze und begrenzte Budgets. Um wirklich groß zu werden, müssen die Unternehmen den kommerziellen Markt erschließen.
Große Internet-Unternehmen, Cloud-Dienstanbieter und Anbieter von großen KI-Modellen interessieren sich nicht dafür, ob ein Produkt inländisch ist. Sie prüfen, ob die Karte ihre Anwendungen ausführen kann, ob die Leistung ausreicht, ob das Ökosystem kompatibel ist und ob das Preis-Leistungs-Verhältnis gut ist.
Ein Unternehmen für große KI-Modelle gibt jedes Jahr mehrere hundert Millionen Yuan für Rechenleistung aus. Die Wahl des falschen Chipherstellers bedeutet, dass mehrere zehn Millionen Yuan an Anpassungsaufwand umsonst sind. Daher kann diese Einkaufsentscheidung nicht nur anhand von Parametern getroffen werden.
Derzeit befinden sich die Unternehmen genau am Schnittpunkt zweier Märkte: Die Gewinne aus dem Xinchuang-Bereich schwinden, während der Wettbewerb im kommerziellen Markt gerade erst begonnen hat.
Enflame bezieht den Großteil seiner Einnahmen von Tencent. Die tiefe Verbindung ist sowohl ein Vorteil als auch ein Risiko: Wenn Tencent seine Einkaufsstrategie anpasst, hat das enorme Auswirkungen. Andererseits sind die größten Gewinner Systemintegratoren wie Inspur, die fest mit ByteDance und Alibaba verbunden sind und einen unangefochtenen Spitzenanteil am Markt für Superknoten haben.
Warum sind es Systemintegratoren und nicht Chiphersteller? Weil Großkunden ein komplettes, betriebsbereites Lösungspaket wollen. Chips, Netzwerke und Software werden gemeinsam ausgeliefert – wer näher am Kunden ist, hat die Entscheidungsgewalt.
Ich habe nachgeprüft: Ein Jahresumsatz von 3 Milliarden Yuan ist eine entscheidende Überlebensgrenze.
Warum 3 Milliarden Yuan? Die Fixkosten von GPU-Unternehmen sind extrem hoch. Ein einzelner Tapeout mit fortschrittlicher Fertigungstechnologie kostet mehrere hundert Millionen Yuan, ein Forschungs- und Entwicklungsteam von Hunderten von Mitarbeitern kostet jährlich mehr als eine Milliarde Yuan, und weitere hundert Millionen Yuan werden in den Software-Stack investiert. Zusammen ergibt sich ein fester Aufwand von 2 bis 3 Milliarden Yuan.
Wenn der Umsatz unter dieser Zahl liegt, lassen sich nicht einmal die laufenden Betriebskosten decken, geschweige denn die früheren F&E-Investitionen zurückerhalten.
Im ersten Halbjahr erzielte Moore Threads einen Umsatz von über 1,7 Milliarden Yuan, Biren über 1,2 Milliarden Yuan, MetaX über 1,3 Milliarden Yuan. Der Nettogewinn von MetaX, der den Aktionären des Mutterunternehmens zuzurechnen ist, ist positiv und beträgt über 600 Millionen Yuan – aber nach Abzug der F&E-Ausgaben ist das Unternehmen immer noch im Verlust. Die anderen drei Unternehmen sind natürlich ebenfalls im Verlust.
Cambricon und Hygon haben diese Grenze bereits überschritten: Ihr Halbjahresumsatz beträgt 5,9 Milliarden Yuan bzw. 9 Milliarden Yuan, der Nettogewinn von Cambricon liegt bei 2,3 Milliarden Yuan. Ihre Preisbildungslogik unterscheidet sich völlig von der der vier kleinen Drachen – sie agieren eher wie Infrastrukturunternehmen als wie Chip-Startups.
Die 3-Milliarden-Yuan-Grenze beschränkt nicht nur den Umsatz, sondern auch die Bewertung, die der Kapitalmarkt dem Unternehmen zuweist.
......
Das Kurs-Umsatz-Verhältnis (PS) von Moore Threads liegt bei etwa 70, das von MetaX bei 95. Das bedeutet, dass der Markt bereit ist, für jeden Yuan Umsatz 70 bis 95 Yuan Marktkapitalisierung zu zahlen.
Cambricon und Hygon haben ebenfalls Aufschläge, aber die Logik ist anders: Ihr Halbjahresumsatz überschreitet 3 Milliarden Yuan, ihr Geschäftsmodell hat sich bewährt, und ihre Bewertung basiert auf der aktuellen fundamentalen Lage.
Und die vier kleinen Drachen? Ihr Umsatz liegt noch hinter dieser Grenze zurück, und ihre Bewertung basiert auf der Erwartung „wie groß du in Zukunft werden kannst“. Einfach ausgedrückt: Die einen verkaufen Möglichkeiten, die anderen verkaufen Sicherheit.
Enflame ist ein typisches Beispiel: Der Ausgabepreis betrug 142 Yuan, das Unternehmen beschaffte 6 Milliarden Yuan an Kapital, und der Aktienkurs verdoppelte sich am ersten Handelstag nach dem Börsengang. Auf dem Primärmarkt richtet sich die Bewertung nach der technischen Route und den Auftragsreserven, auf dem Sekundärmarkt wird die Erwartung direkt gehandelt – die Investoren stimmen mit den Füßen ab.
Aber der Börsengang ist ein einmaliges Ereignis. Die echte Prüfung besteht darin, ob das Unternehmen weiterhin Aufträge erhalten und die 3-Milliarden-Yuan-Grenze überschreiten kann.
Die vier kleinen Drachen haben insgesamt etwa 23 Milliarden Yuan durch ihre Börsengänge beschafft. Die Geschwindigkeit, mit der das Kapital hereinkommt, zeigt, dass Investoren glauben, dass sie diese Grenze überschreiten können.
Aber die Bewertungen, die die Institutionen diesen vier Unternehmen zuweisen, unterscheiden sich stark voneinander.
Warum gibt es so große Unterschiede? Der Markt bewertet im Grunde die „Sicherheit“ der verschiedenen Routen.