Gerade wurde der König des Preis-Leistungs-Verhältnisses, Sonnet 5.5, veröffentlicht.
Und tatsächlich, Sonnet 5.5 ist endlich da!
Einen Tag vor der Eröffnung der jährlichen Entwicklerkonferenz von OpenAI hat Anthropic über Nacht ein absolutes Highlight veröffentlicht – Claude Sonnet 5.5.
Als perfekter Partner von Opus 5.5 besteht die Mission von Sonnet 5.5 darin, der schnellste, kostengünstigste und für Ihre tägliche Arbeit am besten geeignete „vielseitige Helfer“ zu werden.
Im Vergleich zu Sonnet 5 läuft es 30 % schneller, und die Kosten für die Erledigung derselben Aufgabe sinken um bis zu 30 %.
Zudem liegt sein Preis nur bei der Hälfte des größeren Modells Opus 5.5, während seine Leistung fast gleichauf ist.
Es schreibt nicht nur blitzschnell Code, sondern ist auch das erste Sonnet-Modell der Geschichte, das allein anhand von Screenshots des Bildschirms Pokémon Rot durchspielen kann.
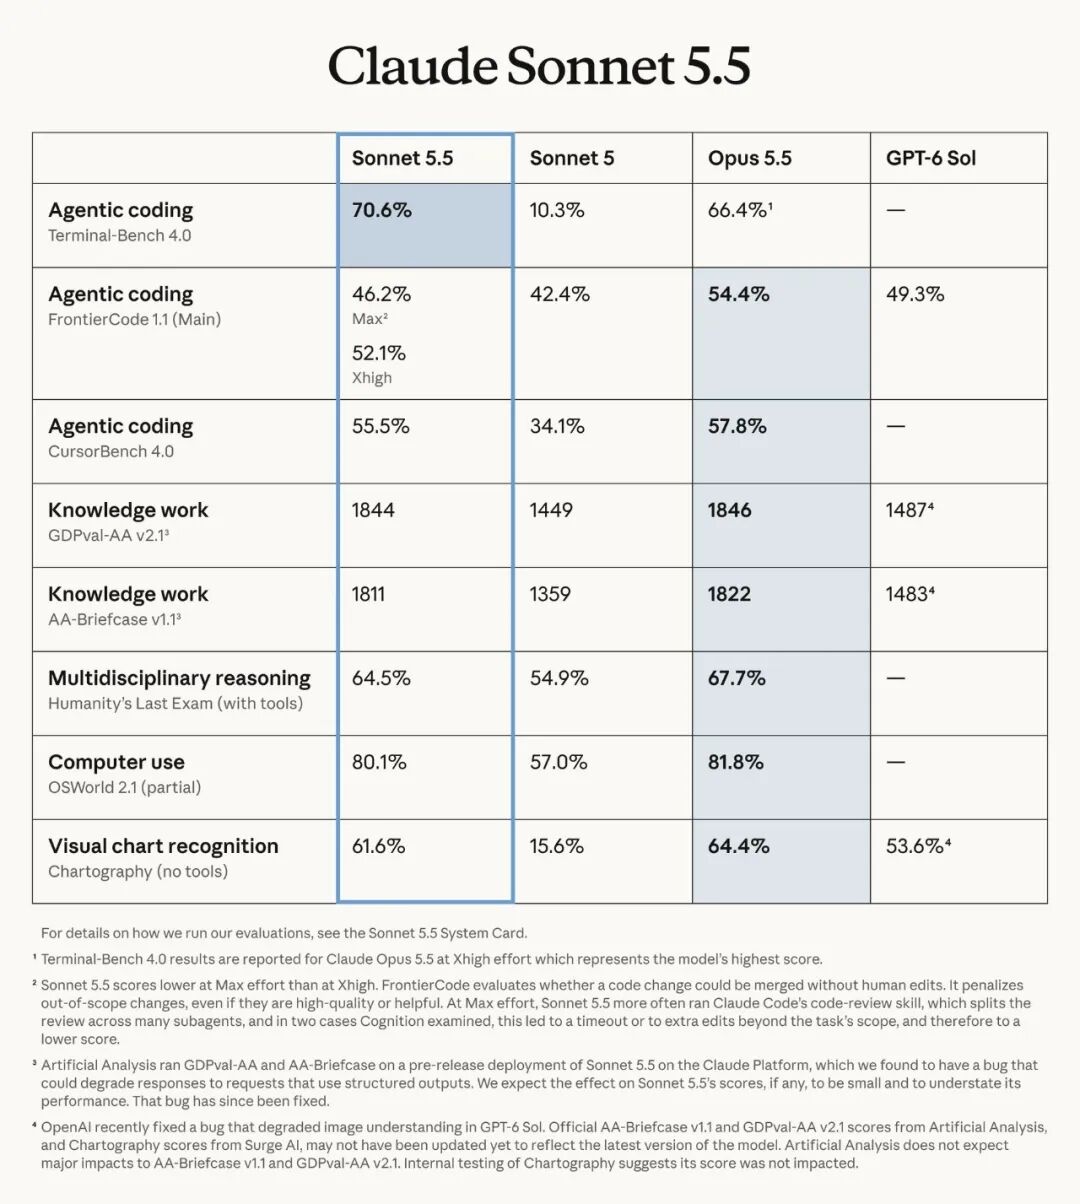
Noch beeindruckender: Bei dem extrem anspruchsvollen Agenten-Programmiertest Terminal-Bench 4.0 hat dieses mittelgroße Modell das größere Modell sogar übertroffen!
Sonnet 5.5 erreicht eine Punktzahl von 70,6 %, was fast dem Siebenfachen des vorherigen Werts entspricht und sogar über den 66,4 % von Opus 5.5 liegt.
Innerhalb einer Generation ist es vom Schlusslicht direkt auf den ersten Platz im eigenen Unternehmen aufgestiegen.
Kurz nach der Veröffentlichung wurde die Intelligenzindex-Rangliste des unabhängigen, renommierten Bewertungsinstituts Artificial Analysis direkt dominiert: Die ersten drei Plätze gehen vollständig an die Claude-Familie, Sonnet 5.5 belegt den zweiten Platz.
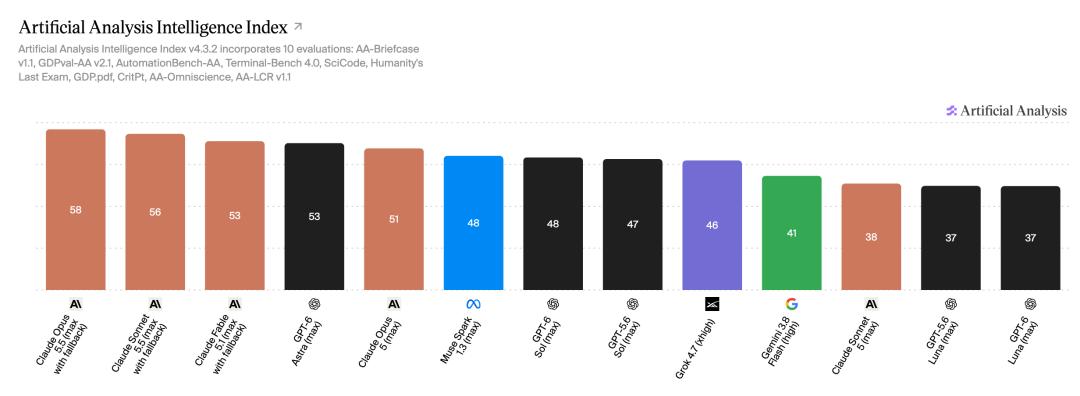
Und der dritte Platz, das extra große Modell Fable 5.1, das A-Unternehmen vor vier Wochen vorgestellt hat, kostet sogar das Fünffache von Sonnet 5.5!
In nur einem Monat sind die großen Claude-Modelle zu extrem günstigen Preisen geworden, die jetzt zum Preis mittelgroßer Modelle verkauft werden.
Zudem können Benutzer den „Effort Level“ beliebig anpassen.
Stufe Niedrig/Mittel: Claude antwortet extrem schnell, verbraucht sehr wenige Token und eignet sich für alltägliche leichte Aufgaben und Routinearbeiten.
Stufe Hoch/Maximal: Claude wechselt in den Denkmodus, überprüft seine Arbeit wiederholt und wird für die Lösung komplexer schwieriger Probleme verwendet.
Sonnet 5.5 durchbricht das „Unmögliche Dreieck“
Mit der Veröffentlichung von Sonnet 5.5 wird direkt das unmögliche Dreieck aus „hoher Geschwindigkeit, niedrigen Kosten und hoher Qualität“ durchbrochen.
Die Ausgabegeschwindigkeit ist gegenüber dem Vorgängermodell um mehr als 30 % gestiegen, was es unbestritten zum schnellsten Sonnet-Modell macht, das es bisher gibt.
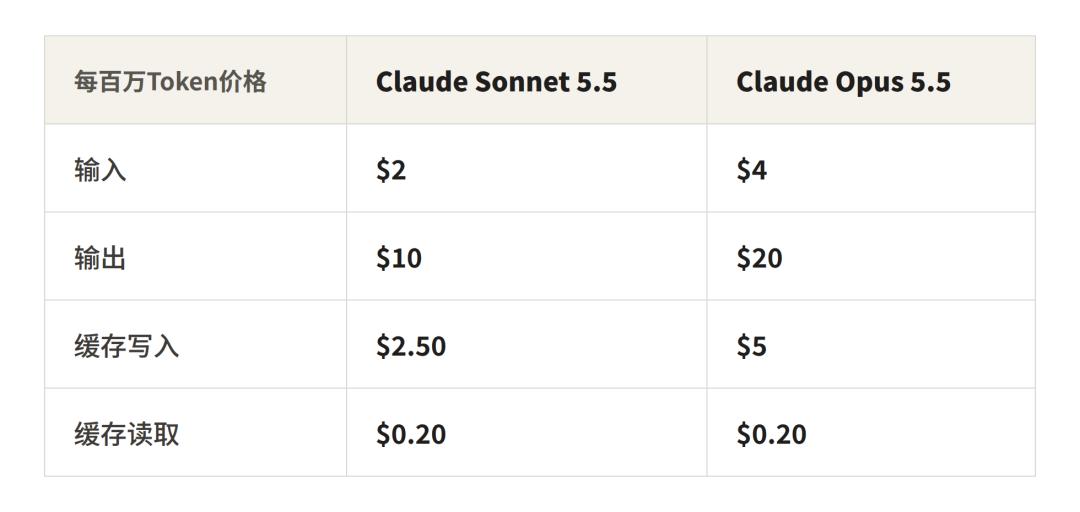
Oberflächlich gesehen ist die Preisgestaltung von Sonnet 5.5 identisch mit der von Sonnet 5: 2 USD pro Million Eingabe-Token, 10 USD pro Million Ausgabe-Token und 0,20 USD pro Million Token für das Lesen aus dem Cache.
Der Trick liegt in der Effizienz!
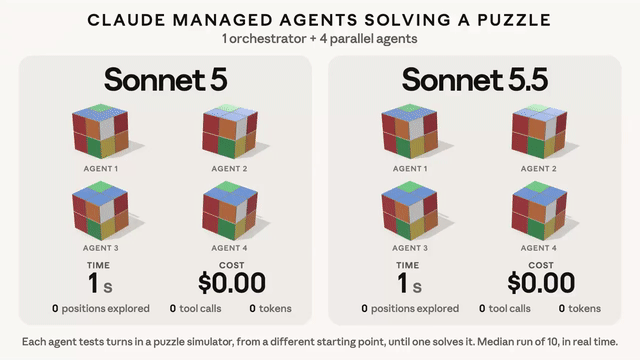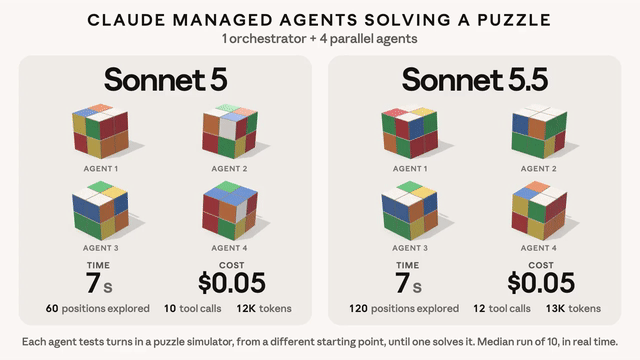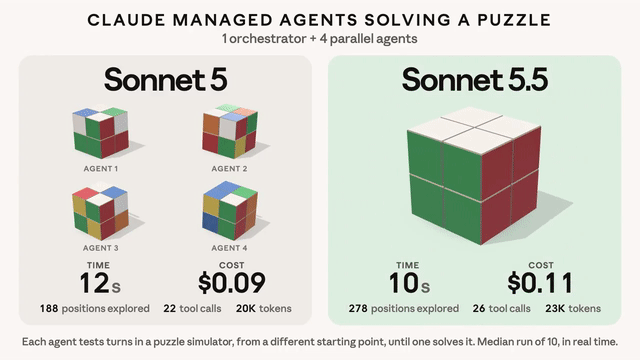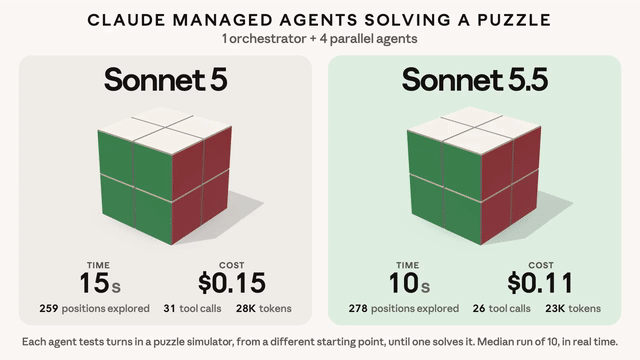
Anthropic hat festgestellt, dass das Modell intelligenter geworden ist, sodass Sonnet 5.5 deutlich weniger Token benötigt und die tatsächlichen Kosten pro Aufgabe um bis zu 30 % sinken.
Mit weniger Token lassen sich größere Aufgaben erledigen.
Im Folgenden sind die Ergebnisse von Sonnet 5 und Sonnet 5.5 bei demselben Prompt dargestellt – der Unterschied ist sehr deutlich.
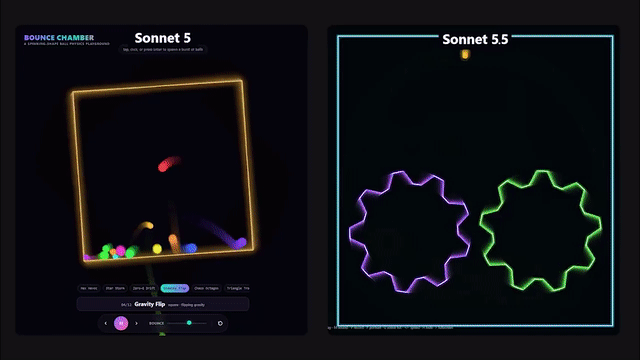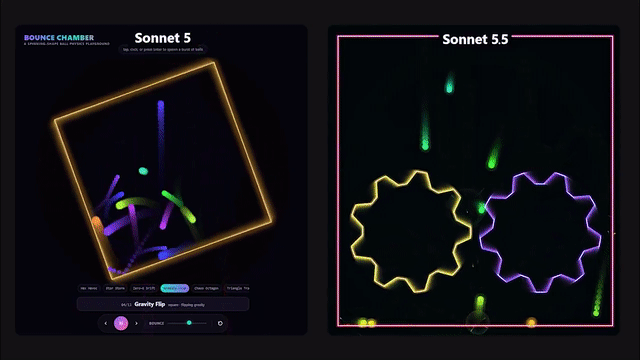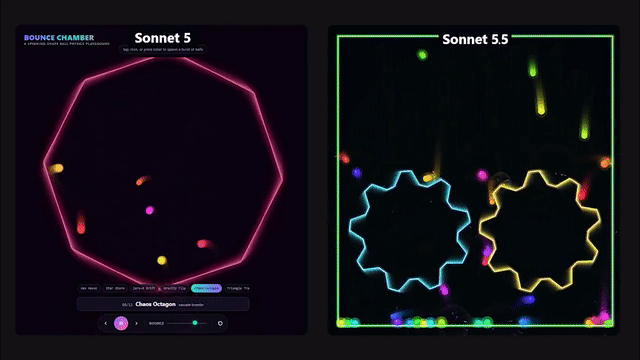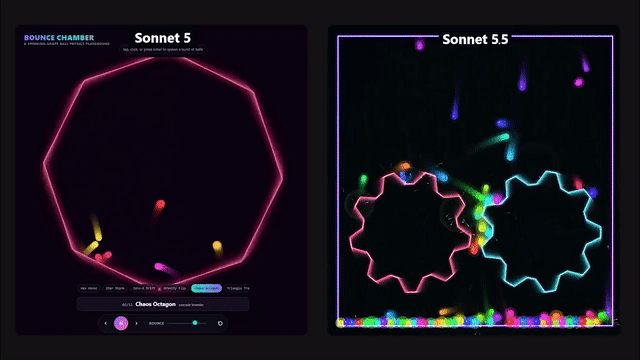
Zum halben Preis gleichauf mit Opus – sogar das hauseigene Top-Modell wird übertroffen
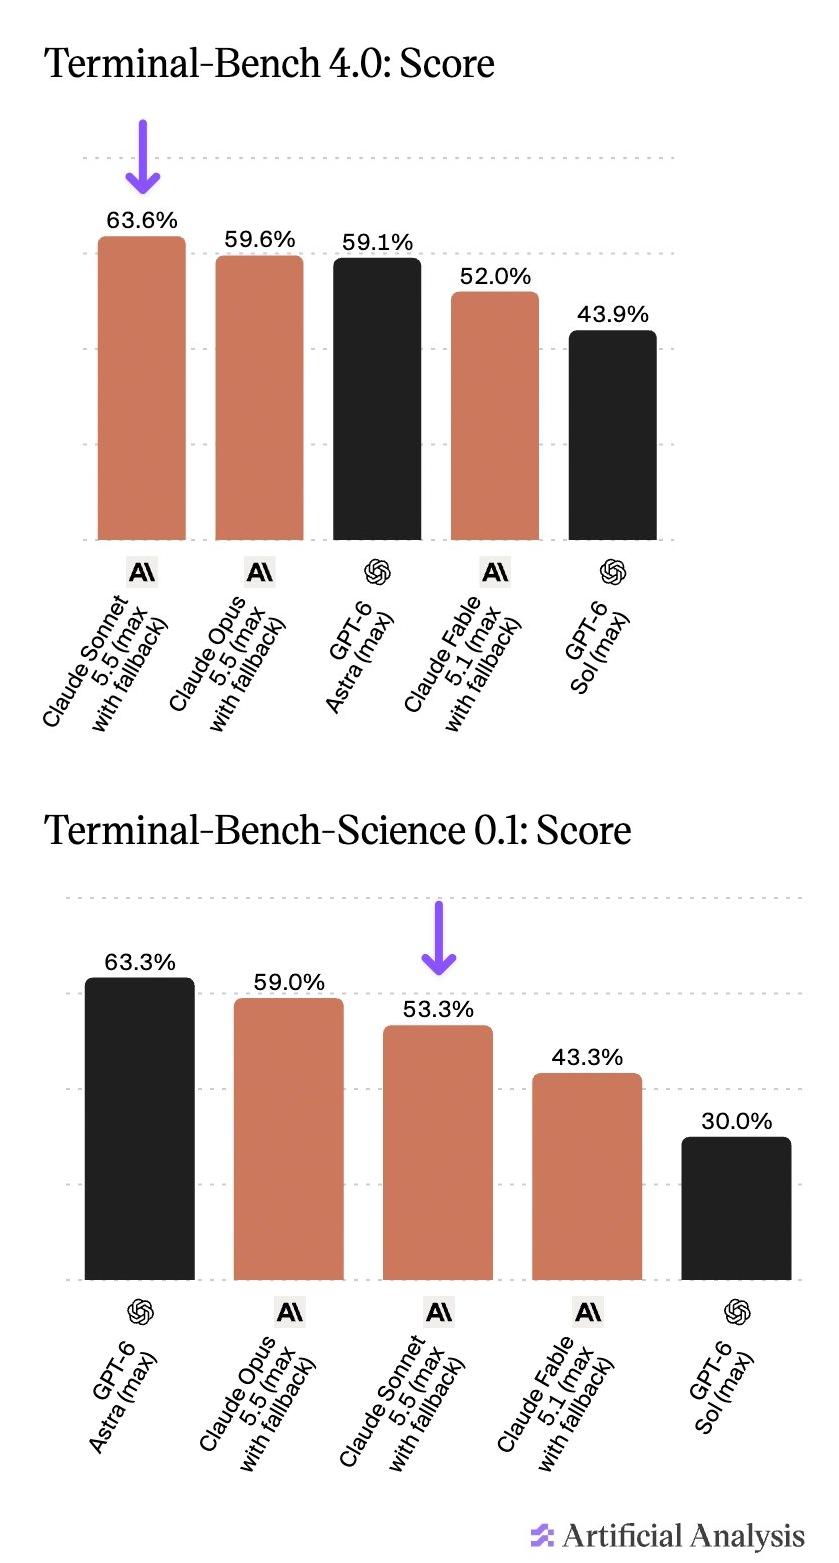
In der Artificial Analysis-Rangliste erreicht Sonnet 5.5 64 %, was über den 60 % von Opus 5.5 und GPT-6 Astra liegt.
Bei Terminal-Bench-Science erreicht es 53 %, belegt den dritten Platz und verliert nur gegen GPT-6 Astra und Opus 5.5.
Auch bei zwei weiteren Tests zum Schreiben von Code zeigt es herausragende Leistungen.
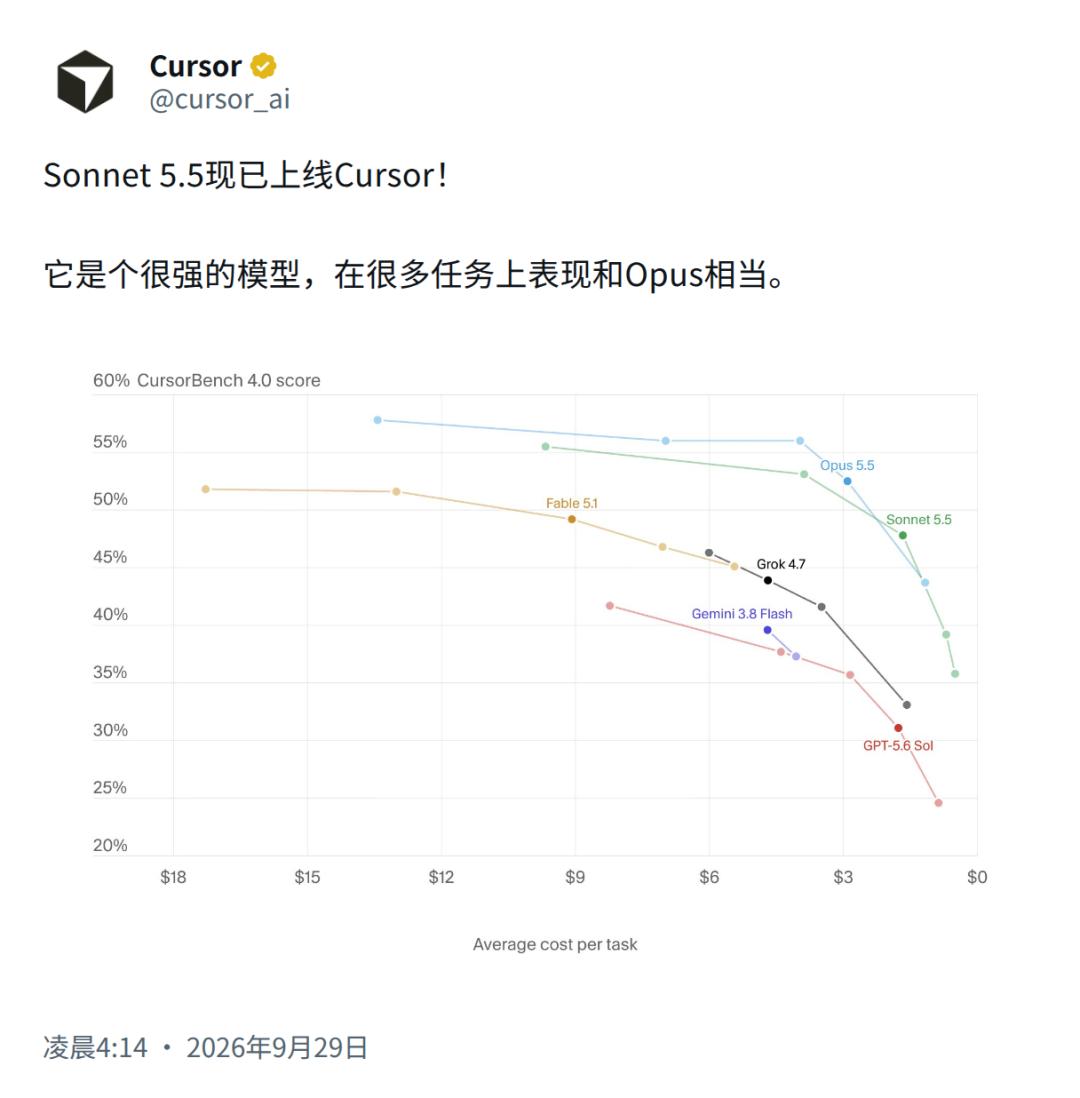
Beim FrontierCode-Test erreicht Sonnet 5.5 maximal 52,1 % und übertrifft damit problemlos GPT-6 Sol (49,3 %) von OpenAI.
Bei CursorBench, das echte Cursor-Programmiersitzungen simuliert, erreicht Sonnet 5.5 55,5 %, liegt nur etwas mehr als 2 Punkte unter dem größeren Modell, während das Vorgängermodell nur 34,1 % erreichte.
Entwickler, die an der frühen Beta-Phase teilgenommen haben, sagen: „Es versteht riesige Codebasen mit einer unglaublichen Geschwindigkeit!“
Seine Effizienz beim Aufruf von Tools ist ebenfalls beeindruckend: Bei aufeinanderfolgenden Tests hat Sonnet 5.5 gelernt, Tool-Aufrufe zu „bündeln“ und in Stapeln zu verarbeiten, was zu weniger Schritten, weniger Fehlern und geringeren Kosten führt.
Nicht nur beim Schreiben von Code, auch bei Büroaufgaben ist es gleichauf.
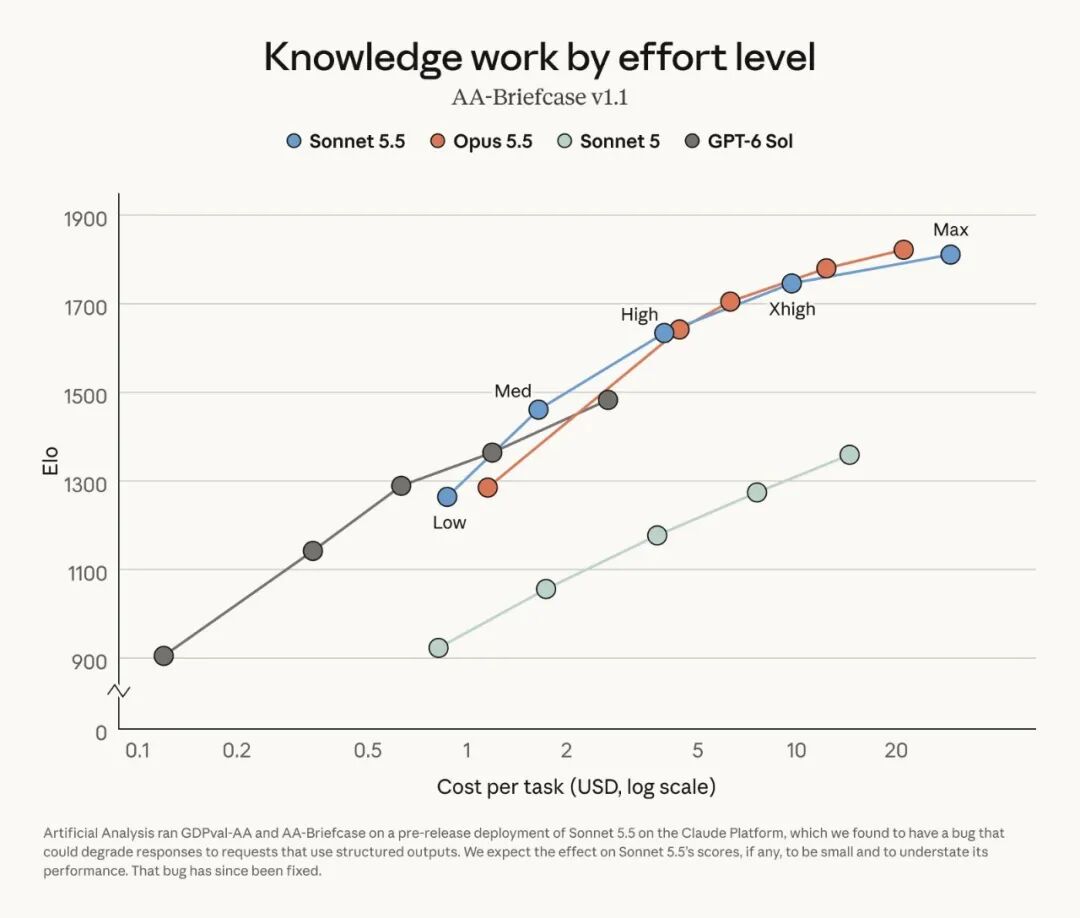
GDPval-AA misst die Fähigkeit des Modells, fertige Ergebnisse für 44 verschiedene Berufe zu liefern. Sonnet 5.5 erreicht 1844 Punkte, das größere Modell Opus 5.5 1846 Punkte.
Beim AA-Briefcase-Test, der langfristige Wissensarbeit prüft, erreicht Sonnet 5.5 1811 Punkte, liegt fast gleichauf mit den 1822 Punkten von Opus 5.5 und übertrifft GPT-6 Sol um mehr als 300 Punkte.
Am überraschendsten ist sein gezeigtes „Designtalent“.
Diesmal versteht Sonnet 5.5 Ästhetik! Es kann UIs aktiv verschönern und sogar Vorlagen für Folien perfekt befolgen, um PPTs zu erstellen, die kaum noch von Menschen bearbeitet werden müssen.
Bei Anthropic intern gibt es ein anspruchsvolles Beispiel: Tester gaben Sonnet 5.5 die Quartalsfinanzdaten eines börsennotierten Unternehmens, Aufzeichnungen einer Telefonkonferenz und eine PPT-Vorlage und forderten es auf, eine 10-seitige Betriebspräsentation zu erstellen.
Das Ergebnis war, dass der erste Entwurf von zwei menschlichen Experten als „perfekt, direkt versandfertig“ bewertet wurde.
Bei dem „letzten menschlichen Test“ mit Tools erreicht es 64,5 %, fast 10 Punkte mehr als das Vorgängermodell.
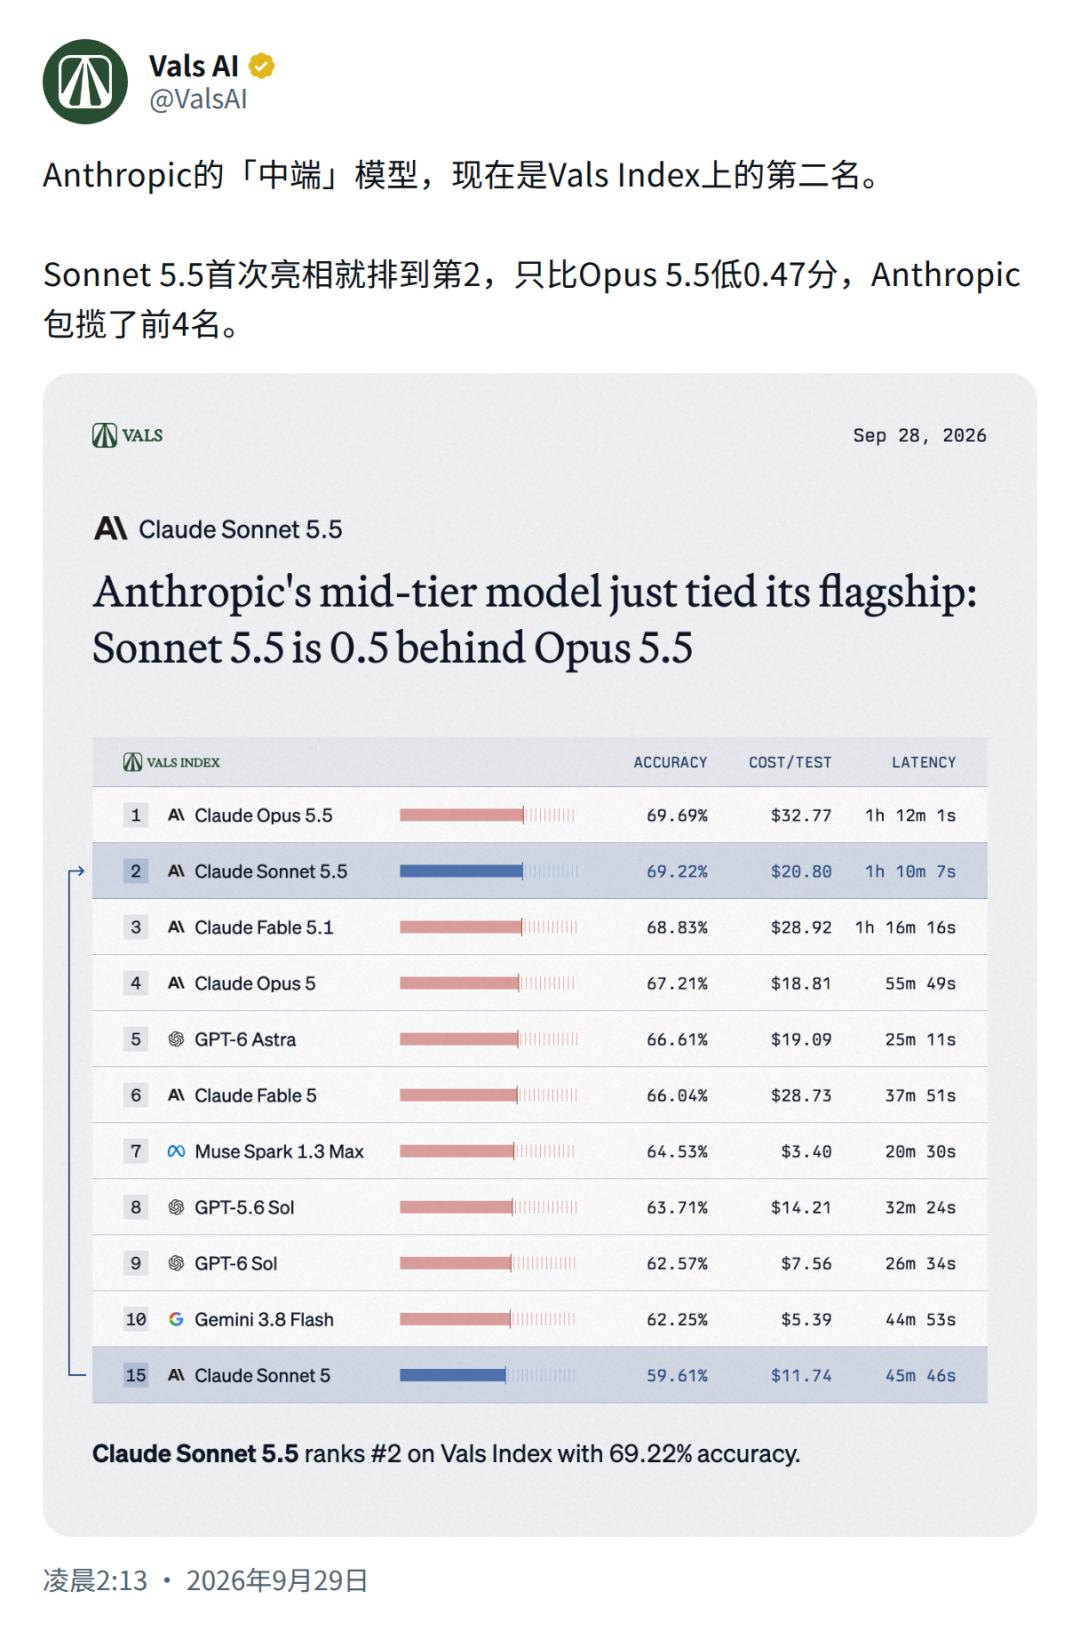
Auf der dritten Rangliste Vals Index landet Sonnet 5.5 bei seinem ersten Auftreten direkt auf dem zweiten Platz und liegt nur 0,47 Punkte unter Opus 5.5.
Vor vier Wochen war Fable 5.1 bei seiner Veröffentlichung noch das weltweit stärkste Modell für Programmierung und Wissensarbeit.
Jetzt übertrifft Sonnet 5.5 es bei Terminal-Bench 4.5 um fast 15 Punkte, bei GDPval-AA um 109 Punkte und beim Intelligenzindex um 3 Punkte.
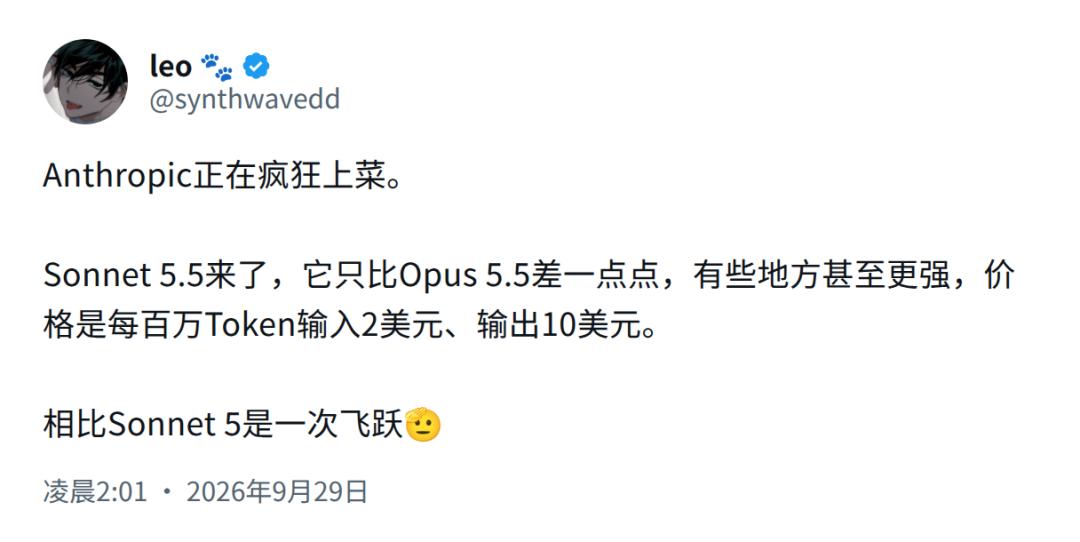
Der Tech-Blogger @synthwavedd hat am Veröffentlichungstag gepostet, dass Anthropic ständig neue leistungsstarke Produkte auf den Markt bringt.
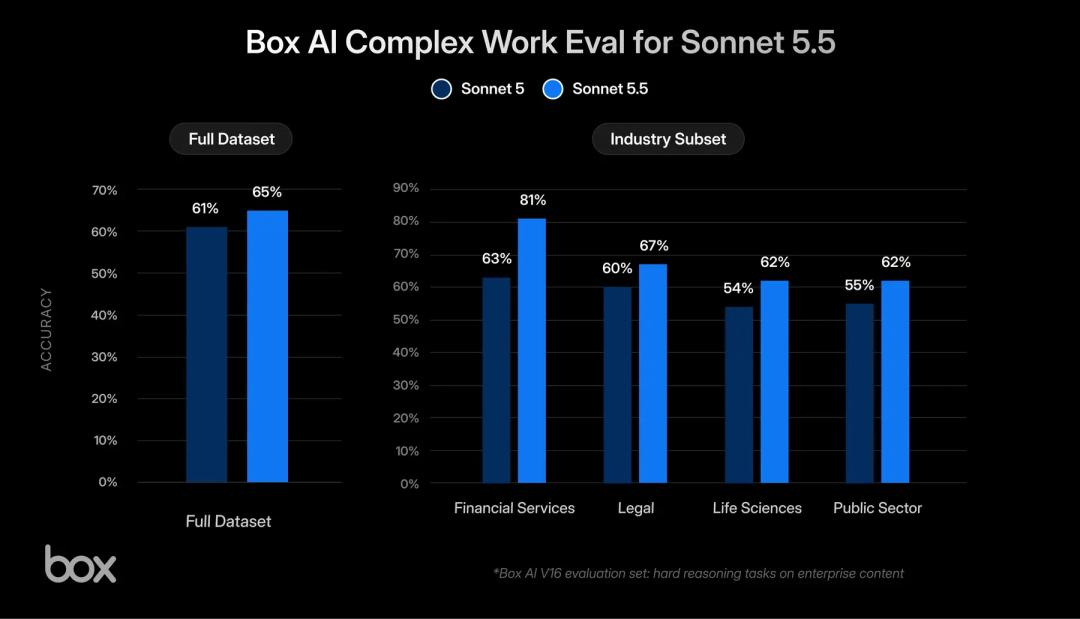
Bei dem komplexen Bürotest Box erreicht die Gesamtgenauigkeit von Sonnet 5.5 65 %, während Sonnet 5 nur 61 % erreicht.
Es liefert die Endergebnisse etwa 2,4 Mal schneller und verbraucht insgesamt 12 % weniger Token. Bei der Arbeit von Agenten stehen Geschwindigkeit und Genauigkeit normalerweise im Konflikt zueinander, daher ist ein Modell, das beides gleichzeitig gut meistert, ein echter Fortschritt.
Das von ihm erbaute San Francisco schickt bei Bränden selbst Feuerwehrwagen
Praktische Tests zeigen, dass Sonnet 5.5 unglaublich leistungsstark ist.
Der AI-Blogger Matthew Berman erhielt vorab Zugriff auf Sonnet 5.5 und hat am Veröffentlichungstag eine Reihe von Praxistests veröffentlicht.
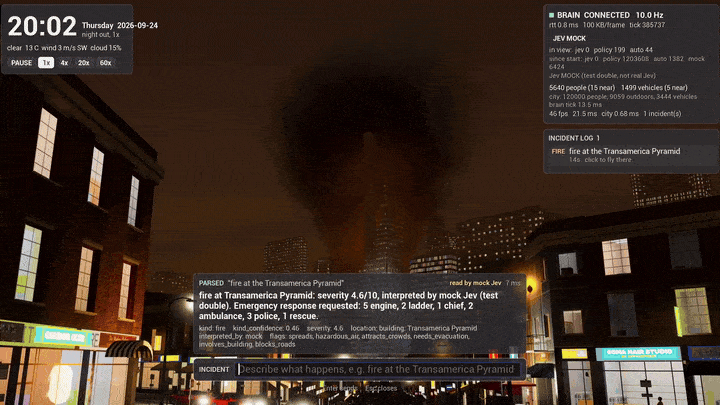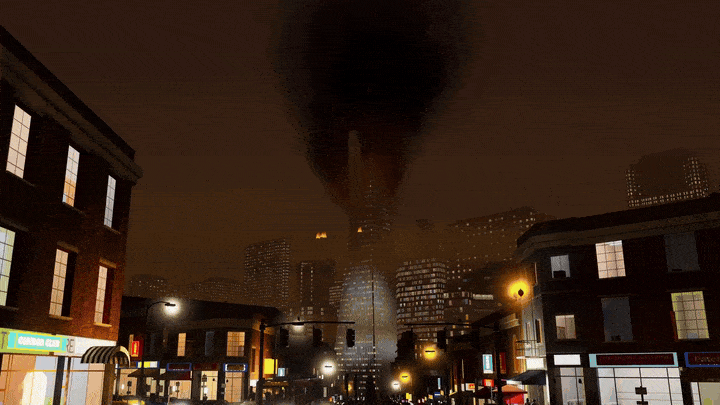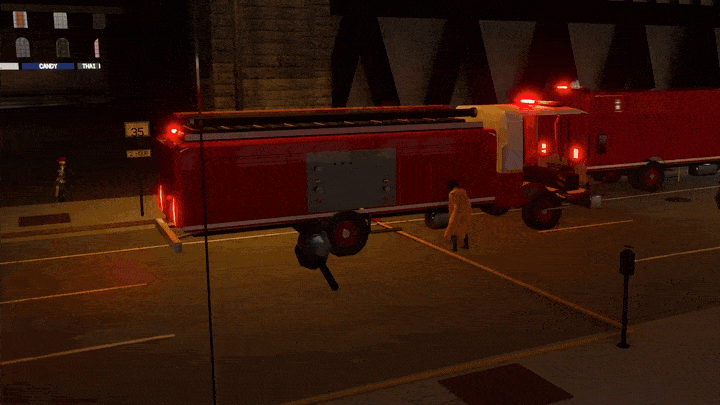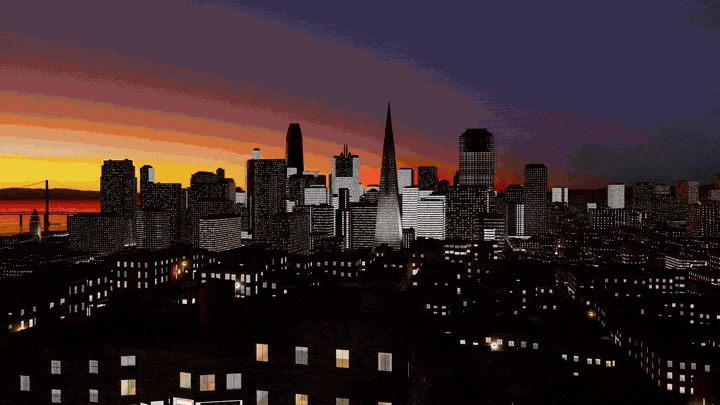
Er ließ Sonnet 5.5 direkt in der Unreal Engine eine Nachbildung von San Francisco bauen. Auf den Straßen fahren unzählige Autos, sogar Radfahrer überqueren die Kreuzungen.
Gibt man den Befehl „Das Transamerica Pyramid-Gebäude brennt“, bewertet das System das Feuer sofort mit 4,6 von 10 Punkten und schickt daraufhin automatisch 5 Feuerwehrwagen und 3 Polizeiautos los.
Aus dem Gebäude in der Ferne steigt dichter schwarzer Rauch auf, die Polizeiautos fahren mit blinkenden Lichtern zur Kreuzung und sperren sie sofort ab.
Sogar das Starship V3 wurde von ihm zu einem interaktiven Explosionsdiagramm umgesetzt. Das gesamte Raumschiff wird Schicht für Schicht auseinandergenommen, bis hin zu den Raptor-3-Triebwerken am unteren Ende.
