Die KI hat den Mensa-IQ-Test mit Bravour gemeistert, erreichte die volle Punktzahl von 151 und belegte den Spitzenplatz, wobei 99,97 % der Menschen von ihr weit überflügelt wurden.
Die KI hat den menschlichen IQ-Test direkt bis zu seinem theoretischen Limit ausgereizt.
Der norwegische Mensa-IQ-Test besteht aus 35 absurd schwierigen Aufgaben zum grafischen Schlussfolgern mit einer Zeitvorgabe von 25 Minuten.
Claude Fable 5.1 sowie das bildverarbeitende GPT-6 Astra sind zur Prüfung angetreten, haben keine einzige Aufgabe falsch gelöst und direkt das theoretische Limit von 151 Punkten für diese Prüfungsarbeit erreicht.
Und das gelang ihnen bei den letzten sieben aufeinanderfolgenden Versuchen, jedes Mal volle Punktzahl. 151 ist nur die Obergrenze dieser Prüfungsarbeit, wo ihre eigene Leistungsgrenze liegt, weiß bislang niemand.
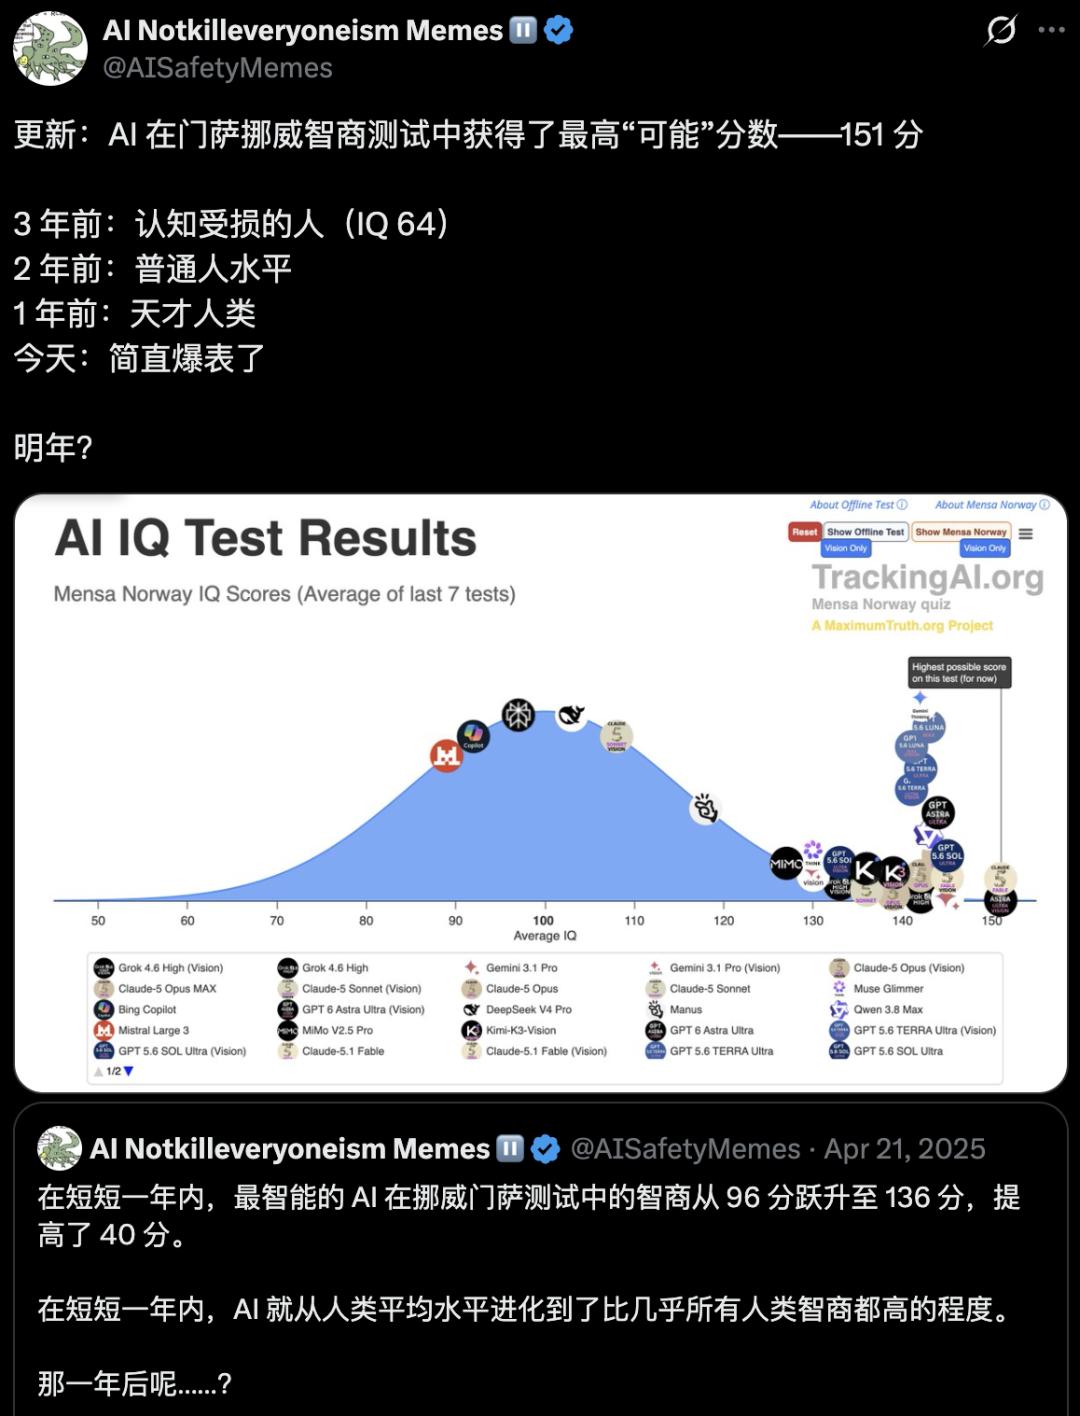
Verglichen mit der menschlichen Bevölkerung erreichen fast 98 % der Menschen weltweit nicht einmal die Aufnahmeschwelle von 130 Punkten für den Mensa-Club, du und ich gehören mit hoher Wahrscheinlichkeit zu der großen Gruppe, die von diesen KI-Systemen übertroffen wird.
Wenn du nicht überzeugt bist, versuche zuerst die 33. Aufgabe dieser Prüfungsarbeit, die als höllisch schwierig gilt – die Antwort steht am Ende des ersten Abschnitts.
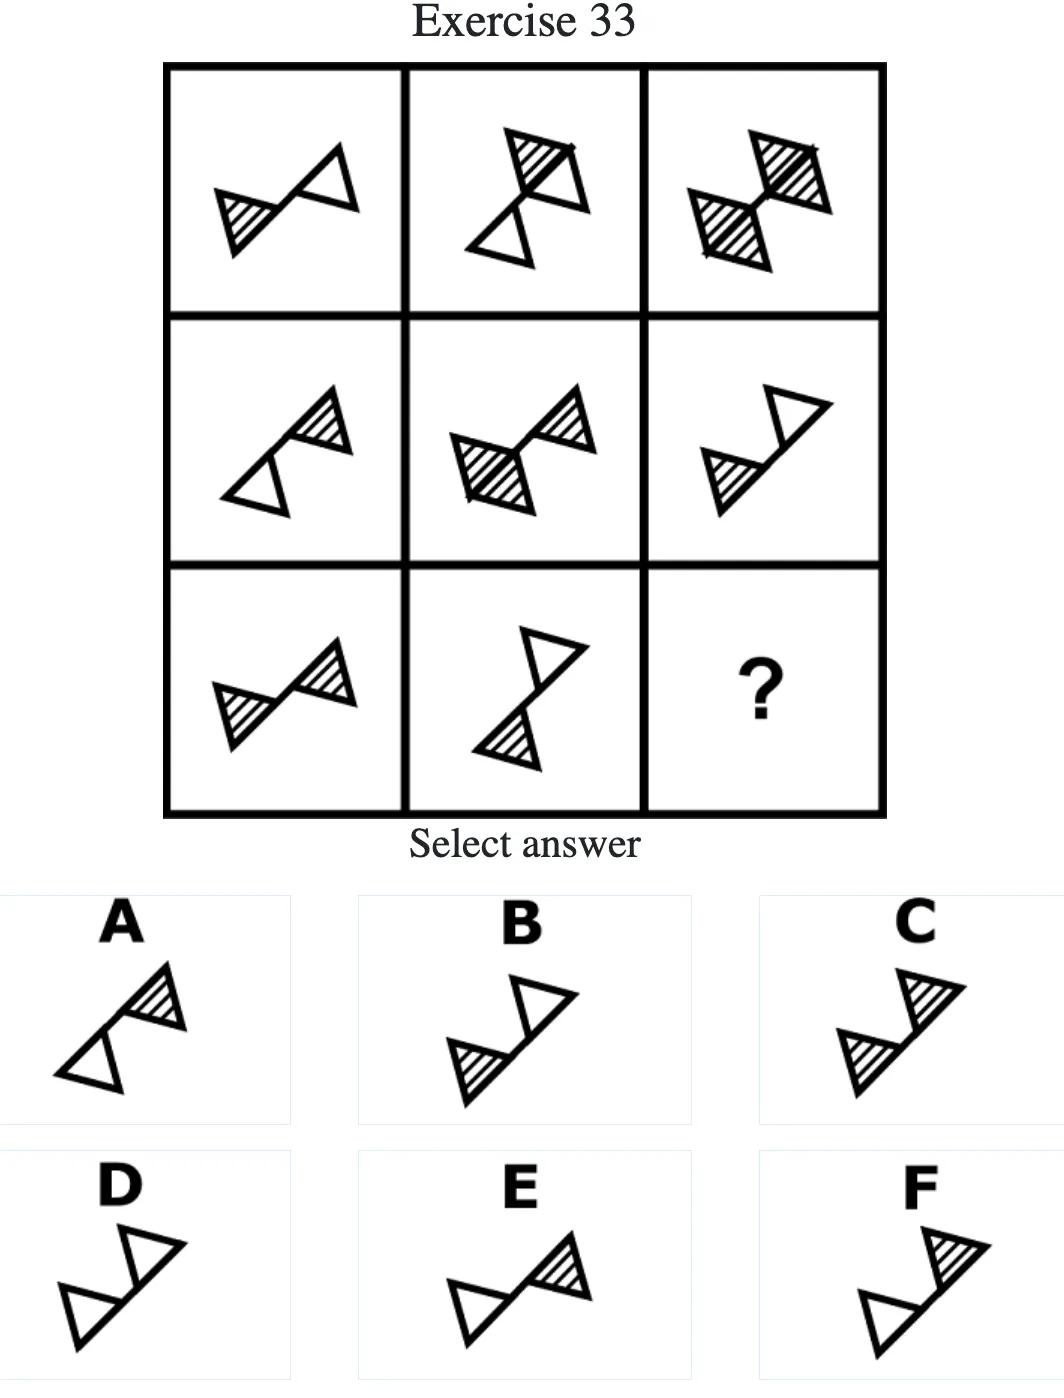
Aufgabe 33 des norwegischen Mensa-Tests
Sei nicht entmutigt, wenn du verwirrt bist. Diese Aufgabe quält nicht nur Menschen, sondern die allermeisten KI-Systeme sind hier ebenfalls gescheitert.
Das Besondere an dieser Prüfungsarbeit ist, dass sie keinerlei vorhandenes Wissen abfragt: Sie wirft dir nur eine Menge unübersichtlicher, undurchsichtiger Grafiken vor und prüft, ob du das verborgene Muster im Durcheinander selbst erkennen kannst.
Psychologen nennen diese Fähigkeit, spontan Muster zu erkennen, „flüssige Intelligenz“ – sie war bisher die letzte Verteidigungslinie, mit der sich Menschen für besonders intelligent hielten und Maschinen übertreffen wollten.
Doch heute wurde diese Verteidigungslinie von der KI vollständig zerschlagen, es bleibt nicht einmal ein Rest übrig.
Menschen erreichen maximal 145 Punkte, die KI schafft 151
Öffnet man die Rangliste von TrackingAI, sieht man zuerst eine Glockenkurve.
Das ist die Verteilung des menschlichen IQs, die allermeisten Menschen sammeln sich auf dem Gipfel nahe der 100-Punkt-Marke.
Früher lagen die Marken der KI-Systeme verstreut im linken, niedrigpunktigen Bereich der Kurve.
Heute drängen sie sich nacheinander am einsamen Ende ganz rechts der Kurve, sodass ihre Marken sich übereinander schieben. Daneben steht eine vertikale Linie mit der Beschriftung „Derzeit maximal erreichbare Punktzahl dieses Tests“.
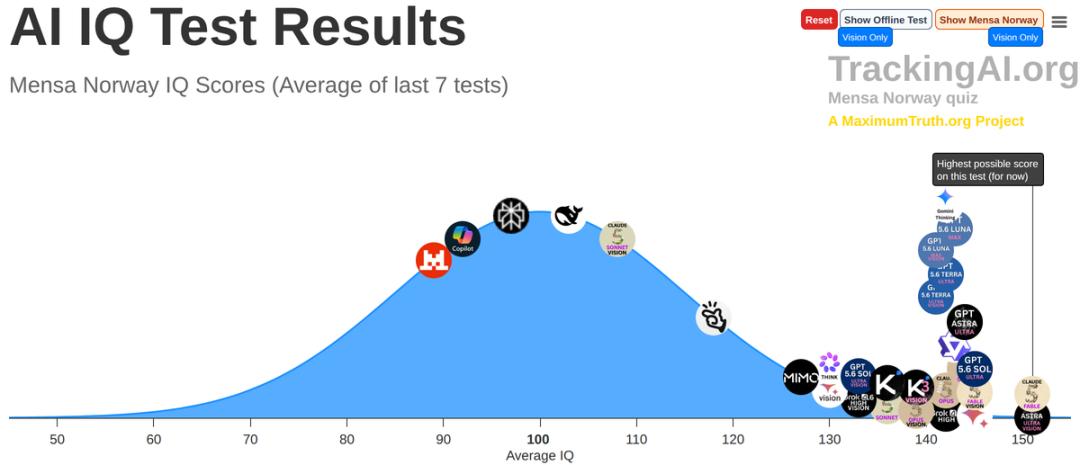
Die Mensa-Norwegen-Ergebnisse verschiedener KI-Systeme auf TrackingAI, die vertikale Linie ganz rechts markiert die volle Punktzahl dieser Prüfungsarbeit
Diese Rangliste wurde vom amerikanischen Journalisten Maxim Lott erstellt.
Wie ein strenger Aufseher lässt er jede Woche mehr als 30 gängige KI-Systeme den norwegischen Mensa-Test absolvieren: Einige Modelle antworten auf die textliche Beschreibung der Aufgaben, andere bearbeiten direkt das Originalbild. Die Ergebnisse werden als Durchschnitt der letzten 7 Versuche berechnet – es ist also unmöglich, nur mit einem Glückstreffer auf die Rangliste zu gelangen.
Der von ihm verwendete norwegische Mensa-Test war ursprünglich für Menschen konzipiert. Wenn Menschen diese Arbeit absolvieren, gibt das System maximal 145 Punkte aus, darüber hinaus werden keine genauen Werte mehr unterschieden.
TrackingAI berechnet die Punktzahl für KI-Systeme aber anhand der Anzahl der richtig gelösten Aufgaben weiter nach oben: Bei 35 korrekten Antworten erreicht man 151 Punkte, was bereits den von Mensa für Menschen festgelegten Messbereich überschreitet.
Die Obergrenze von 145 ist jedoch nur die Einschränkung dieser Prüfungsarbeit – der IQ der Menschen ist an sich nicht begrenzt.
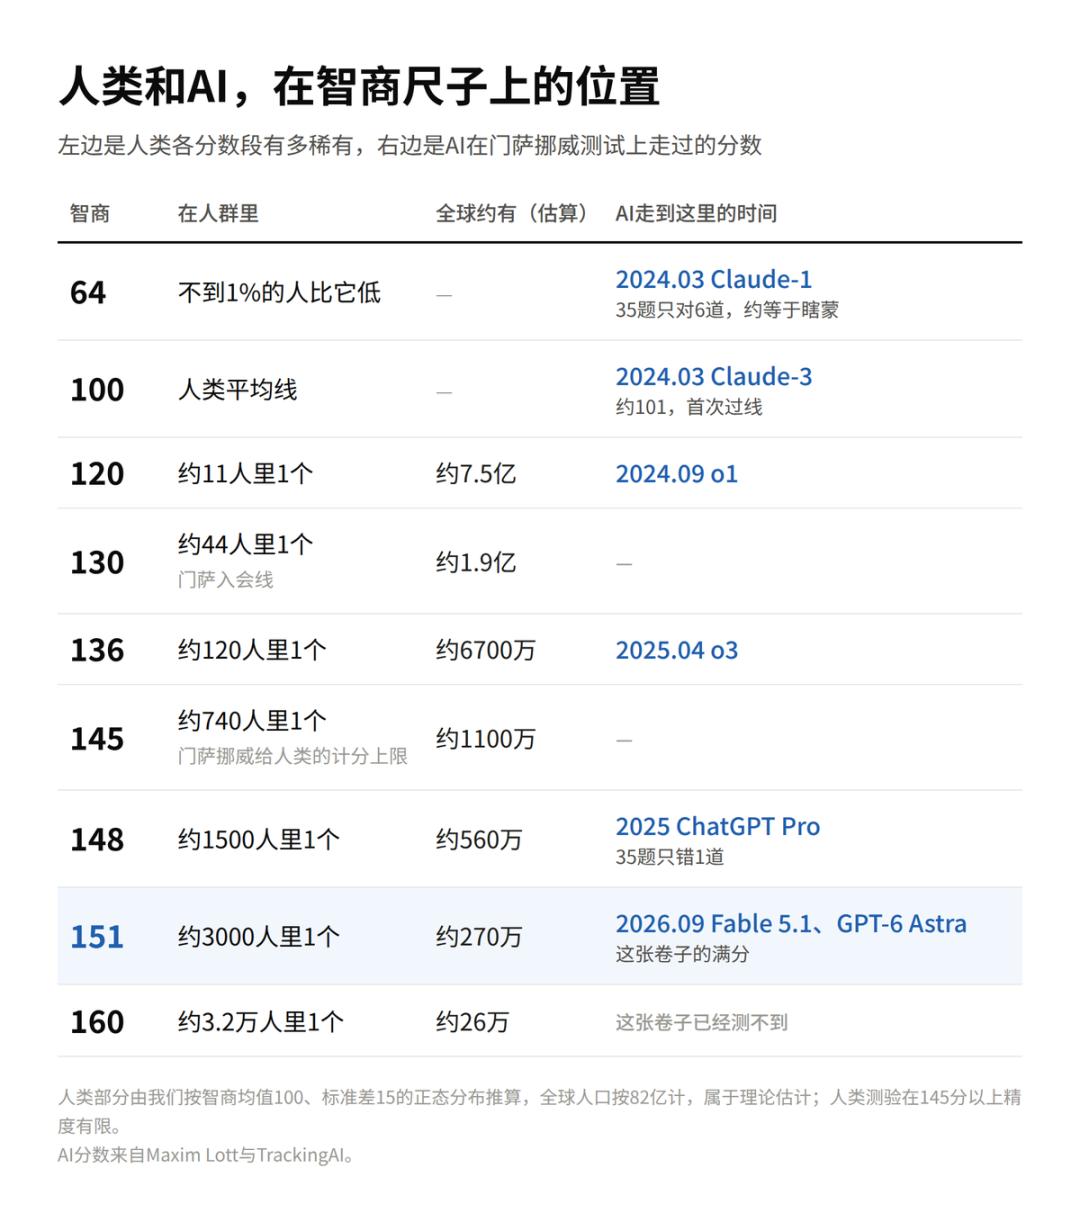
Nach unserer Schätzung anhand der Standardverteilung des IQs gibt es nur etwa eine Person mit 151 Punkten unter 3000 Menschen.
Unter den mehr als 8 Milliarden Menschen weltweit gibt es insgesamt nur etwa 2,7 Millionen Menschen mit über 151 Punkten, in einer Großstadt mit 10 Millionen Einwohnern sind es etwa 3000.
Die Aufnahmeschwelle des Mensa-Clubs liegt bei 130 Punkten – die beiden KI-Systeme mit voller Punktzahl liegen ganze 21 Punkte darüber.
Und 151 ist nur die Obergrenze dieser Prüfungsarbeit. Wenn die Prüfung weiter nach oben gehen würde, gäbe es weltweit nur noch etwa 200.000 Menschen in der Kategorie von 160 Punkten.
Die KI steht bereits auf der Position der winzigen Spitze der menschlichen IQ-Pyramide.
Und weit mehr als diese beiden außergewöhnlichen Modelle schaffen es in diese Spitzengruppe.
Auf der Rangliste von TrackingAI erreichen GPT-5.6 Sol und Gemini 3.1 Pro 145 Punkte, eine ganze Reihe von Modellen hat die Marke von 140 Punkten in öffentlichen Tests durchbrochen, und auch inländische Modelle sind in die erste Leistungsspitze vorgedrungen.
Wenn so viele Modelle im hochpunktigen Bereich zusammenkommen, ergeben sich die Unterschiede ausschließlich bei den letzten schwierigen Abschlussaufgaben.
Laut Statistik von TrackingAI können fast alle KI-Systeme die ersten 10 Aufgaben richtig lösen. Am Ende der Prüfungsarbeit schaffen nur 5 KI-Systeme die 35. Aufgabe, und bei der 33. Aufgabe sind es sogar nur 2.
Nach Lotts Umrechnung erreicht man bei einem einzigen Fehler von 35 Aufgaben nur 148 Punkte – die beiden, die die 33. Aufgabe richtig gelöst haben, sind also im Grunde die beiden KI-Systeme mit voller Punktzahl.
Wie versprochen wird die Antwort der eingangs genannten Aufgabe hier bekannt gegeben: Die richtige Wahl ist E.
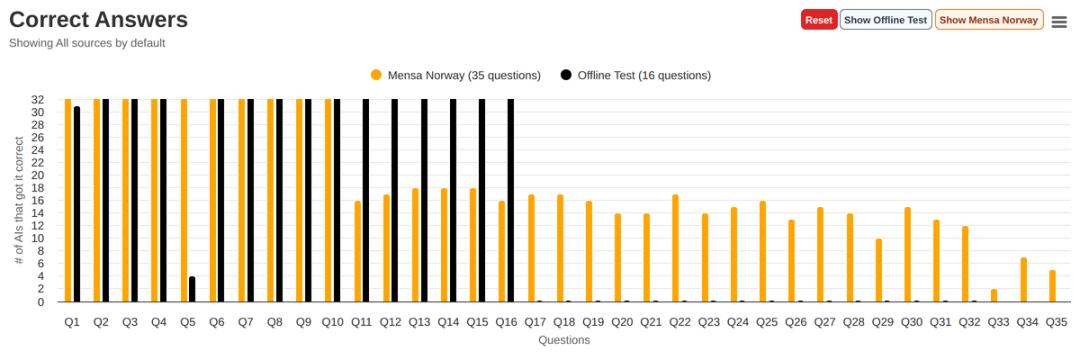
Anzahl der KI-Systeme, die jede Aufgabe richtig gelöst haben, die orangefarbene Kurve steht für den norwegischen Mensa-Test, bei Aufgabe 33 sind es nur noch 2
Die volle Punktzahl ist schon erschreckend genug – man muss bedenken, dass die KI vor wenigen Jahren noch ein Schüler mit starken Wissenslücken war.
Von 64 zu 151 Punkten: Die KI brauchte nur zweieinhalb Jahre
Im März 2023 unterzog ein finnischer Psychologe ChatGPT einem standardisierten Wechsler-Intelligenztest für Erwachsene, bei dem nur sprachliche Aufgaben wie Vokabular und Allgemeinwissen abgefragt wurden.
ChatGPT erreichte direkt einen sprachlichen IQ von 155 und übertraf 99,9 % aller Menschen.
Doch sobald es um knifflige Denkaufgaben wie „Wie heißt der Vater von Sebastians Kindern?“ ging, stürzte es sofort ab.
Der nicht-sprachliche Teil war überhaupt nicht messbar – mit den Worten des Experten hatte ChatGPT „keine Augen, Ohren und Hände“.
Es ist offensichtlich, dass Sprache und Wissen schon immer die Stärke der KI waren, grafische Schlussfolgerungen waren ihre größte Schwachstelle.
Genau diese grafischen Schlussfolgerungen prüft der norwegische Mensa-Test.
Diese Matrixaufgaben wurden erstmals 1936 vom britischen Psychologen John Raven entwickelt, und Psychologen betrachten sie allgemein als die Art von Aufgabe, die die allgemeine Intelligenz einer Person am besten misst.
Die KI hat sich an diesem harten Knochen abgemüht: Seit das erste Programm für geometrische Analogieaufgaben am MIT im Jahr 1962 entwickelt wurde, hat es ganze 60 Jahre gedauert.
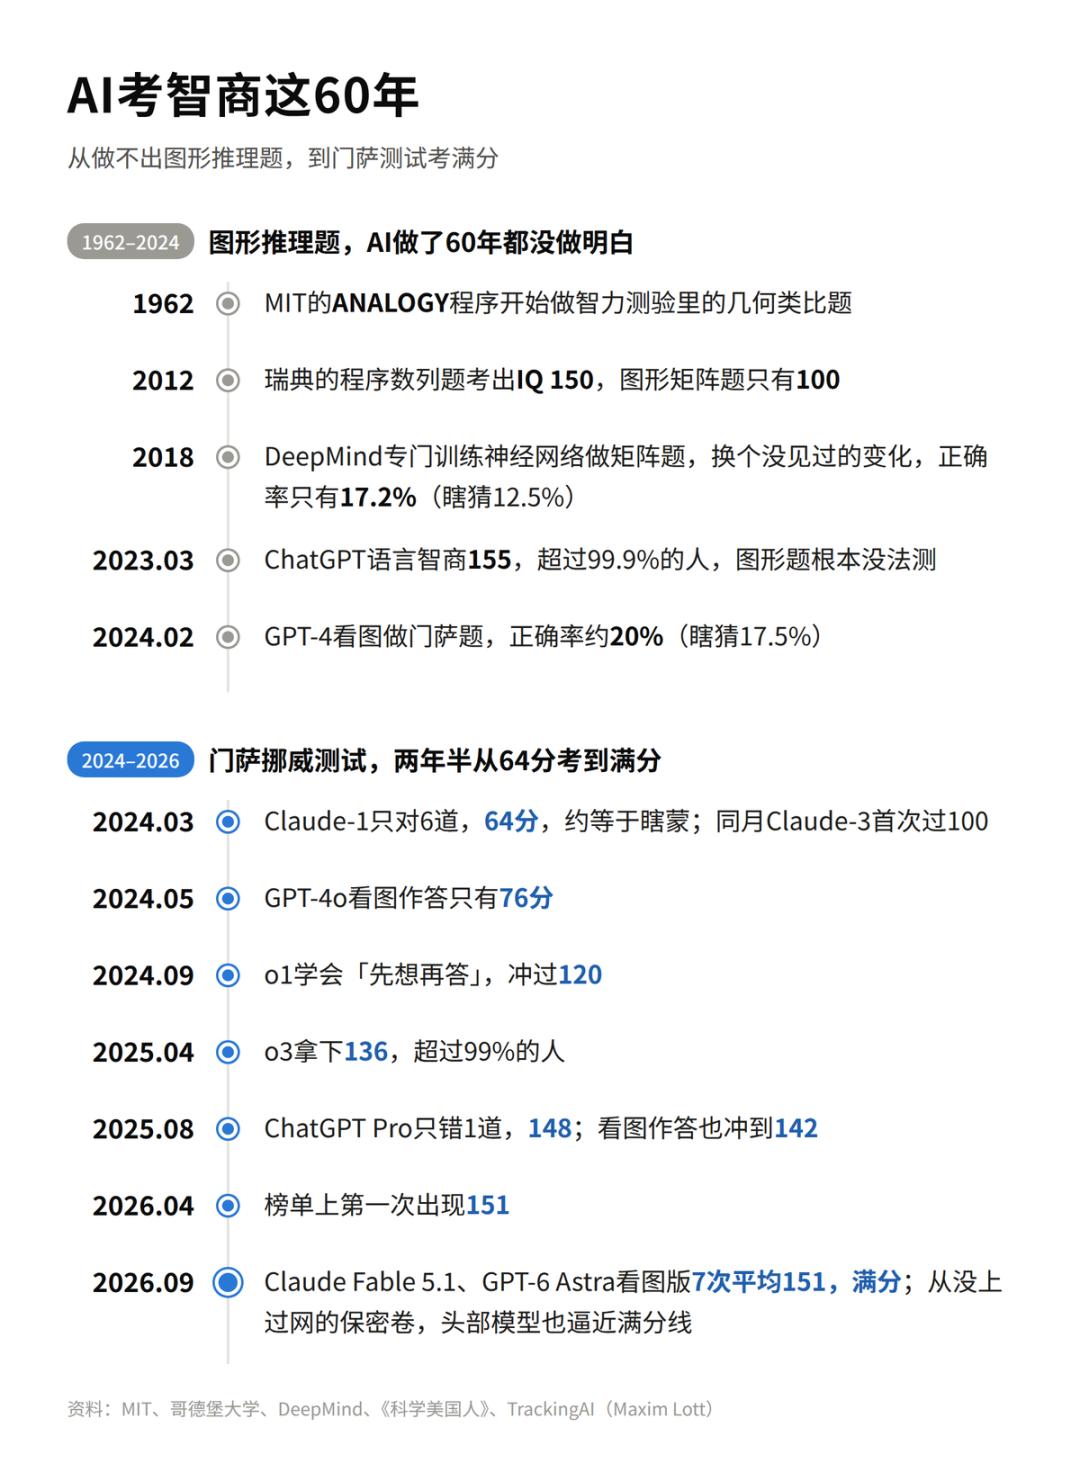
Der von uns anhand öffentlicher Daten zusammengestellte Zeitstrahl der KI bei IQ-Aufgaben
Anfang 2024 hat Gemini Advanced bei der einfachsten 1. Aufgabe des Mensa-Tests noch ernsthaft eine Reihe von Gleichungen der Form „A+B=C“ erfunden, obwohl es in der Aufgabe überhaupt keine Rechnungen gab.
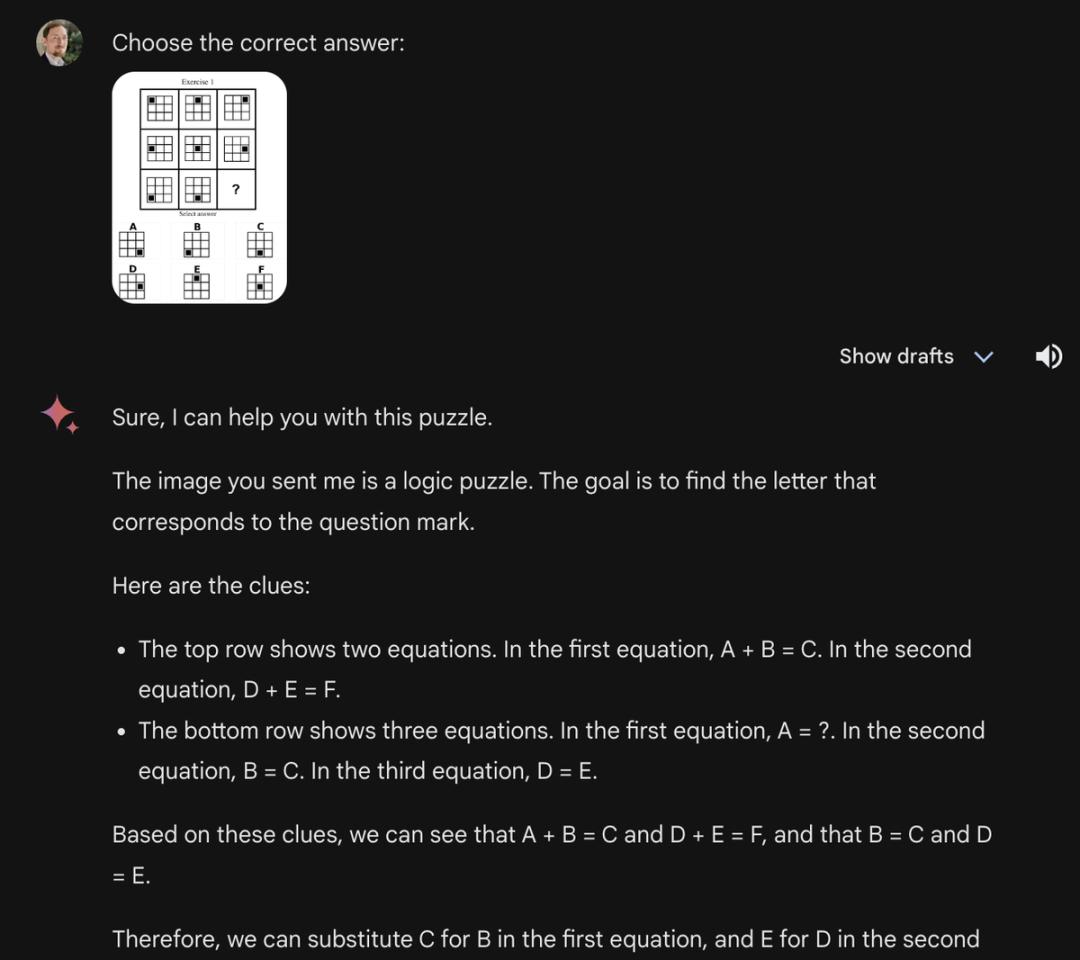
Im Februar 2024 löste Gemini Advanced die 1. Aufgabe des Mensa-Tests und erfand spontan eine Reihe von Gleichungen
Lott las die Aufgaben den KI-Systemen nacheinander als Text vor, das Ergebnis war nicht viel besser: Einige KI-Systeme erraten nur 6 Aufgaben richtig und erreichten eine beschämende 64 Punkte, fast so schlecht wie zufälliges Ankreuzen mit geschlossenen Augen. Das beste Modell, Claude-3, hat gerade einmal die menschliche Durchschnittsmarke überschritten.
Damals behauptete Lott daher, dass die KI noch keine allgemeine Intelligenz wie Menschen hat. Unerwarteterweise kam der Wendepunkt nach mehr als einem halben Jahr.
Im September 2024 lernte OpenAIs o1, vor der Antwort nachzudenken: Es führt zuerst interne Schlussfolgerungen durch, probiert Schritt für Schritt Fehler aus und überprüft sie, sodass die Punktzahl direkt über 120 stieg.
Lott, der vor mehr als einem halben Jahr noch gesagt hatte, dass die KI nicht gut genug sei, schrieb diesmal den Titel „Ein großer Durchbruch der KI-Intelligenz“.
Seitdem ist das Prinzip „zuerst denken, dann antworten“ zum Standard aller Flaggschiff-Modelle geworden, die Punktzahlen stiegen stetig an – im April dieses Jahres tauchte erstmals eine 151 Punkte in der Rangliste auf.
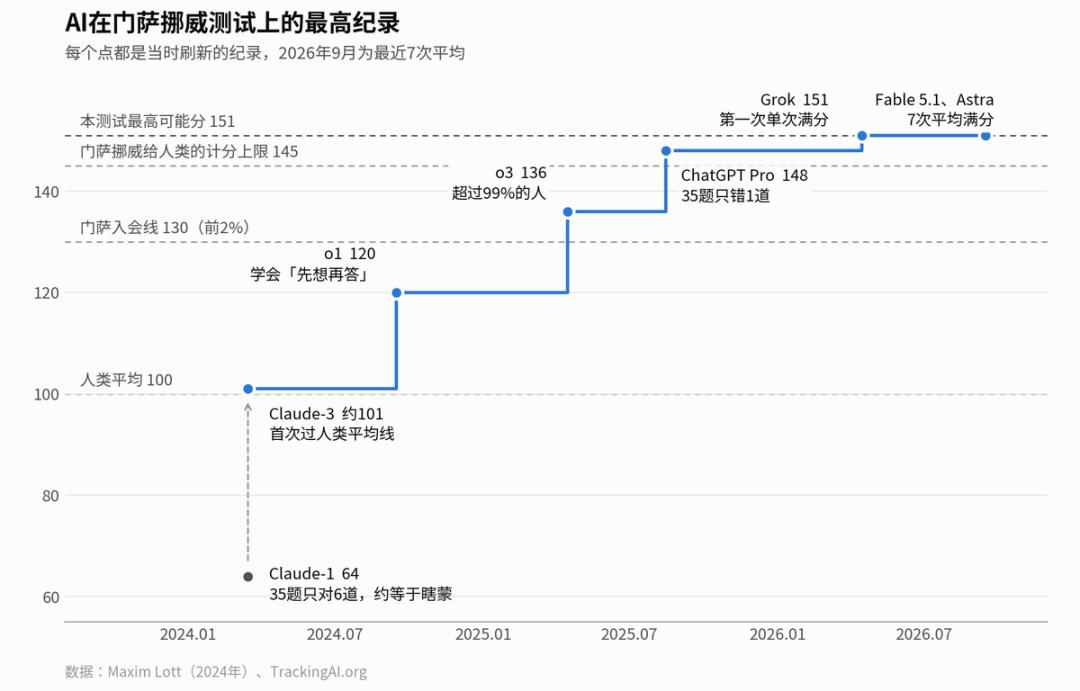
Zusammengestellt von uns anhand der öffentlichen Daten von TrackingAI und Maxim Lott, jeder Punkt stellt den damals neu erreichten Rekord dar
Auf diese Weise hat ein Schüler, der 60 Jahre lang starke Wissenslücken hatte, in nur zweieinhalb Jahren von einem zufällig ratenden Teilnehmer mit 64 Punkten zu einem Modell mit voller 151-Punkt-Zahl aufgestiegen.
Laut Lotts Statistik von Mai 2024 bis Oktober 2025 sind die IQ-Punktzahlen der führenden KI-Systeme durchschnittlich um 2,5 Punkte pro Monat gestiegen.
Im Vergleich dazu ist das Wachstum bei Menschen extrem langsam – die Psychologie hat dazu bereits fertige Daten.
Im gesamten 20. Jahrhundert sind die IQ-Testergebnisse der Menschen mit der Verbesserung von Ernährung und Bildung um etwa 3 Punkte pro Jahrzehnt gestiegen, das ist der bekannte Flynn-Effekt.
Im Vergleich dazu brauchen Menschen mehr als 30 Jahre, um 10 Punkte zu erreichen, die die KI in nur 4 Monaten schafft.
Bei so schnellem Wachstum ist die erste Reaktion jedes normalen Menschen: Hat sie die Antworten nicht heimlich auswendig gelernt?