Von der Daten-Middle-Plattform zur Wissens-Middle-Plattform: Wie unternehmensweite Ontologien KI dazu befähigen, digitale Produktionsumgebungen zu verstehen und zu betreiben
Im Jahr 2026 werden auf nationaler Ebene zahlreiche Politiken verabschiedet, um die tiefe Integration von künstlicher Intelligenz und der Industrie voranzutreiben. Im April haben das Ministerium für Industrie und Informationstechnologie und das Nationale Datenbüro gemeinsam die „Mitteilung über die gemeinsame Umsetzung der Aktion „Modul-Daten-Resonanz“ im Jahr 2026“ herausgegeben, die sich auf 20 Schlüsselbranchen konzentriert, um „Daten durch Modelle zu leiten und Modelle durch Daten zu stärken“ zu fördern. Im Juni hat das Nationale Datenbüro den „Umsetzungsplan zur Förderung der Aktion zum Aufbau hochwertiger Branchendatensätze“ veröffentlicht, der ausdrücklich vorsieht, den Aufbau von Datensätzen wie Wissensdatenbanken, Wissensgraphen und Ontologien für Anwendungen von Agenturen zu verstärken. Dadurch ist die Ontologie von einem technischen Konzept zu einer industriellen Infrastruktur aufgestiegen, und der Implementierungspfad von unternehmensweiter KI wird neu definiert.
Das bedeutet, dass die Integration von KI und Industrie gerade aus dem neuen Stadium des „Wettbewerbs um Modellfähigkeiten“ in das neue Stadium des „Wettbewerbs um Daten- und Wissensinfrastruktur“ eintritt. Damit große Modelle wirklich in die Unternehmensproduktionsumgebung eindringen können, wird eine semantische Infrastruktur benötigt, die es der KI ermöglicht, Geschäftssemantik zu verstehen, komplexe Berechnungen zu verknüpfen und Systemoperationen zu steuern.
Im Prozess des Aufbaus unternehmensweiter Ontologien mit Branchenkunden wie China Unicom, Energieversorgung, Öl und Gas sowie Finanzinstituten hat sich Hai Zhi wiederholt zwei Fragen gestellt: Was ist eigentlich eine Ontologie? Welche Probleme löst eine Ontologie im Unternehmen wirklich?
Dieser Artikel wird sich auf vier Ebenen erstrecken: die Kluft zwischen Ontologien und Unternehmensdaten, die Modernisierung von Daten-Middle-Plattformen zu Wissens-Middle-Plattformen, die Beziehung zwischen Ontologien und Graphen sowie die Form von KI-orientierten multimodalen Datenbanken, um die Überlegungen und Praktiken von Hai Zhi beim Aufbau unternehmensweiter Ontologien zu teilen.
01 Warum können große Modelle Unternehmen nicht „verstehen“? Die Kluft zwischen Ontologien und Unternehmensdaten
Die Erweiterung von Kommunikationsnetzen über Datennetze hin zu semantischen Netzen ist ein unvermeidlicher Trend der industriellen Digitalisierung.
Gegenwärtig haben chinesische Unternehmen, insbesondere große staatliche Unternehmen wie China Unicom, die digitale Transformation abgeschlossen. Die digitale Transformation bringt eine wesentliche Veränderung mit sich: Alle Geschäftsvorgänge des Unternehmens können durch Daten beschrieben werden, und das Datenvolumen ist groß, die Komplexität der Datenverarbeitung ist ebenfalls hoch. Der größte Teil dieser Daten liegt in Form von zweidimensionalen relationalen Tabellen (wie Bestelltabellen, Kundentabellen) vor, keine eindimensionalen, sequenziell linear angeordneten Textdaten.
Wenn branchenspezifische große Modelle versuchen, in die Unternehmensproduktionsumgebung einzudringen, stoßen sie zuerst auf diese Kluft in der Datenform.
Bei der letzten Runde des Aufbaus branchenspezifischer großer Modelle haben viele Unternehmen die Textkorpora des Unternehmens für das Training großer Modelle verwendet, aber die Ergebnisse waren gering. Der Grund liegt darin, dass große Sprachmodelle hauptsächlich mit Textparametern trainiert werden, während die echten Geschäftsdaten des Unternehmens größtenteils in relationalen Tabellen und den dahinterliegenden Berechnungen vorhanden sind.
Daher ist es eher so, dass große Modelle nicht in der Lage sind, eine große Anzahl relationaler Tabellen und die dahinter tatsächlich vorhandenen Berechnungen gut zu verstehen, anstatt dass sie „Halluzinationen erzeugen“.
Wenn große Modelle diese relationalen Tabellen verstehen sollen, ist eine große Menge an Textausarbeitungen wie Prompting oder Embedding (Textvektorisierung, d. h. Umwandlung von Text in eine maschinell berechenbare Zahlenmatrix) erforderlich. Aber die kognitive Reihenfolge des Menschen lautet: Zuerst wurde die Sprache erfunden, dann die Daten – im Wesentlichen sind Daten eine weitere Abstraktion und Strukturierung der von der Sprache beschriebenen Realität. Es ist praktisch nicht realisierbar, dass große Modelle relationalen Tabellen und komplexe Berechnungen rückwärts aus Text verstehen.
Aus technischer Sicht liegt die Ursache dieses Problems darin, dass die Kernfähigkeit großer Modelle das semantische Verstehen und Generieren ist, während die Betriebslogik der digitalen Unternehmensumgebung auf deterministischer Berechnung basiert. Operationen wie Verknüpfung, Aggregation und Filterung zwischen relationalen Tabellen sowie die daraus gebildeten Geschäftsregeln und Einschränkungen bilden ein formales System parallel zur natürlichen Sprache. Es besteht eine wesentliche Spannung zwischen dem wahrscheinlichen Generierungsmechanismus, in dem große Modelle gut sind, und der Genauigkeit und Überprüfbarkeit, die dieses formale System erfordert. Große Modelle „generieren“ die wahrscheinlichste Antwort basierend auf Wahrscheinlichkeitsverteilungen, dieser Mechanismus ist von Natur aus unsicher; während das formale Berechnungssystem des Unternehmens genaue, reproduzierbare und überprüfbare Ergebnisse verlangt. Das ist der grundlegende Grund, warum große Modelle bei der direkten Anbindung an Unternehmensdaten leicht Fehler machen.
Daher muss das Unternehmen eine Kernfrage beantworten: Wie können massenhafte Daten und die zugrundeliegenden komplexen Berechnungen effektiv organisiert werden, damit die KI sie erkennen kann? Das moderne Management aller heutigen Unternehmen stützt sich auf den digitalen Betrieb, und die Probleme, die der digitale Betrieb lösen kann, sind intuitiv: Alle Geschäftsvorgänge können quantifiziert, analysiert, erklärt und zurückverfolgt werden. Das ist mit reinem Text kaum zu lösen.
Der Ausgangspunkt von Hai Zhi beim Aufbau von Ontologien ist es, die KI auf der Grundlage der bereits vorhandenen semantischen Umgebung mit der früher aufgebauten digitalen Umgebung des Unternehmens zu verbinden. Damit die KI durch dieses semantische Verstehen die digitale Produktionsumgebung erkennen und sogar übernehmen und bedienen kann. Das ist genau das, was das Unternehmen am meisten braucht.
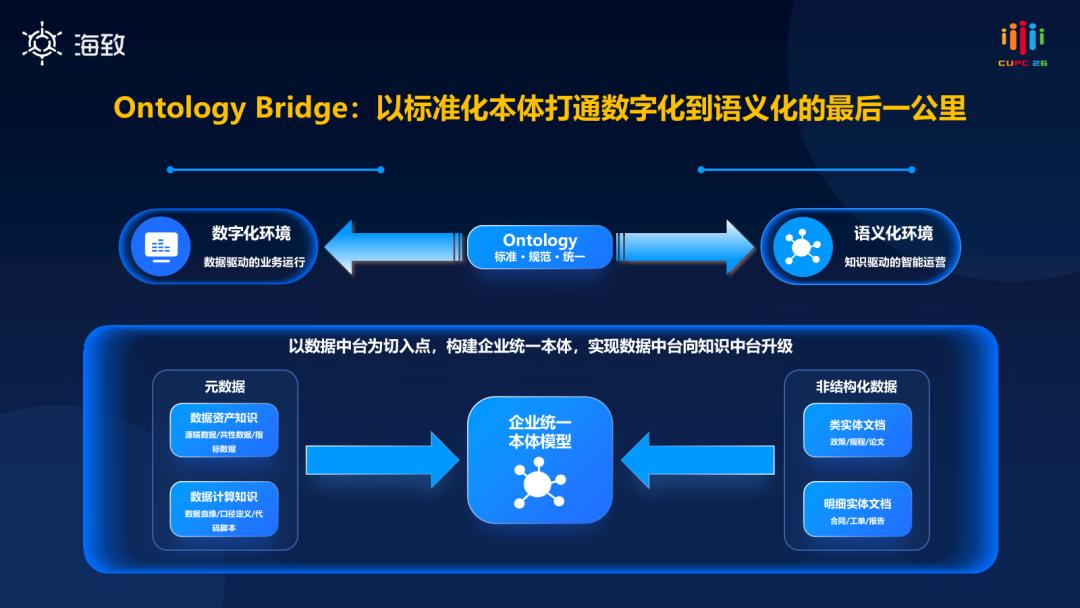
Das führt auch zur Kernpositionierung der Ontologie: Die Ontologie verbindet einerseits den Menschen (der auf natürlicher Sprache angewiesen ist, um Geschäftsabsichten auszudrücken) und andererseits das maschinelle System (das auf strukturierten Daten und deterministischer Berechnung basiert). Dass Mensch und Maschine sich darüber einig werden, „was genau dasselbe Ding ist“, ist genau das Kernproblem, das die Ontologie lösen soll.
02 Von der Daten-Middle-Plattform zur Wissens-Middle-Plattform: Es werden nicht nur Daten verwaltet
Beim früheren Aufbau von Daten-Middle-Plattformen war eines der Kernprobleme zu lösen: Das Unternehmen verfügt über eine große Anzahl von Geschäftssystemen, aber es ist unmöglich, dass diese Geschäftssysteme sich untereinander verständigen, und es ist auch unmöglich, dass ein Programmierer den Code aller Geschäftssysteme sehr gut kennt. Daher hat die Branche allgemein eine Lösung angewandt: Die Daten der zugrundeliegenden Geschäftssysteme werden extrahiert, außerhalb der Systeme ein systemübergreifendes Datenkonsens gebildet, und dann systemübergreifende Geschäftsdienste neu aufgebaut.
Das war die Logik beim Aufbau von Daten-Middle-Plattformen damals.
Heute durchläuft diese Logik eine Entwicklung: Die Daten-Middle-Plattform des Unternehmens wird zu einer Wissens-Middle-Plattform aufgerüstet.
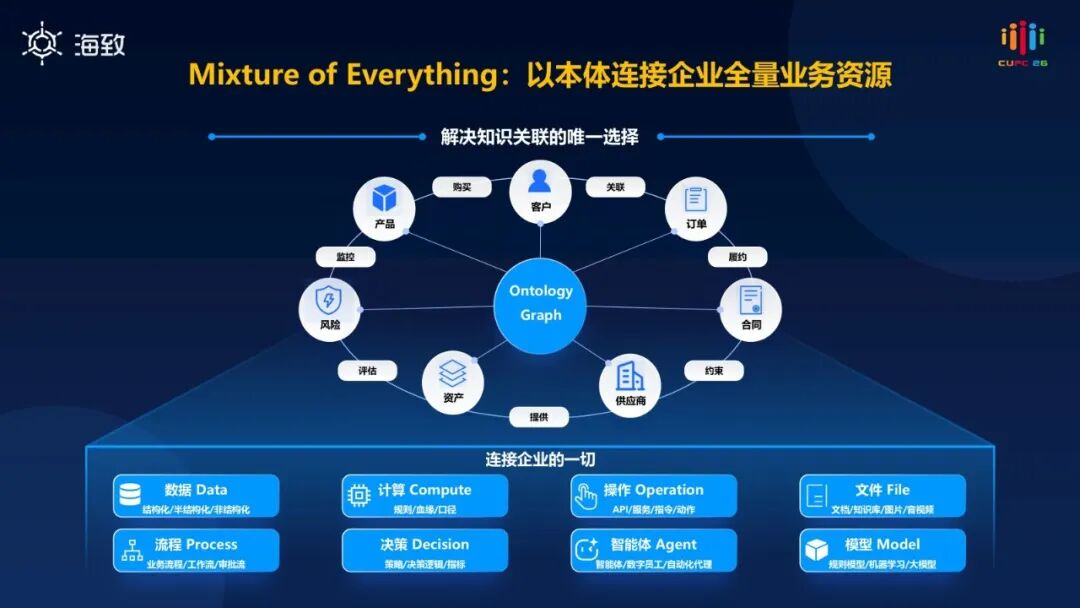
Aus der Perspektive der Architekturevolution besteht die Kernaufgabe der Daten-Middle-Plattform darin, die Probleme „Wo sind die Daten?“ und „Sind die Daten nutzbar?“ zu lösen, ihre Basiseinheiten sind Tabellen und Felder. Auf dieser Grundlage beantwortet die Wissens-Middle-Plattform weiter die Fragen „Was bedeuten die Daten?“, „Was sind die Geschäftsregeln?“ und „Wie werden Aktionen ausgeführt?“.
Das Wesen dieser Aufrüstung besteht darin, eine „semantische Steuerungsebene“ über der ursprünglichen Datenvermögensebene hinzuzufügen: Die Daten-Middle-Plattform ist für die physische Zugänglichmachung der Daten zuständig, während die Wissens-Middle-Plattform für die Erschließung der Geschäftsaussage und des Ausführungspfades der Daten sorgt, sodass die KI natürliche Sprachfragen in überprüfbare, ausführbare und rückverfolgbare semantische Aufgaben umwandeln kann.
Die Aufgabe der Wissens-Middle-Plattform besteht ebenfalls darin, eine große Anzahl digitaler Produktionsumgebungen und Systeme des Unternehmens zu verwalten. Aber der verwaltete Inhalt ist nicht mehr nur Daten, sondern muss klar erklären:
- Welche Daten sind in jedem System vorhanden;
- Welche Berechnungen können durchgeführt werden;
- Welche Geschäftsvorgänge können basierend auf jedem Berechnungsergebnis ausgeführt werden;
- Welche relevanten, von den Systemen ausgeführten Geschäftsbestimmungen in den Geschäftstexten vorhanden sind, auf die alle Geschäftssysteme abgebildet werden.
- Dieser gesamte Inhalt ist das eigentliche Wissen des digitalen Triebwerks des Unternehmens.
Ob man es Wissens-Middle-Plattform oder Wissensbasis nennt, sein Wesen ist eine zukünftige Verwaltungsplattform, die Ontologien trägt. Es kann nicht nur alle digitalen Geschäftsvorgänge des Unternehmens (einschließlich der Geschäftsvorgänge in unstrukturierter Semantik) umfassend verwalten, sondern der Verwaltungsbereich geht auch weit über den Rahmen der traditionellen Daten-Middle-Plattform hinaus.
Nur so kann die KI die gesamte digitale Produktionsumgebung des Unternehmens verstehen, und schließlich ist es möglich, über die Verbindung aller Systeme mittels AI Coding zu sprechen, um Aufgaben automatisch zu erledigen.
Auf der Ebene der technischen Umsetzung sind die Aufbaumethoden für strukturierte Systeme und strukturierte Daten in allen Branchen bereits ausreichend erforscht. Das größte tatsächliche Problem ist: Müssen strukturierte und unstrukturierte Daten verbunden werden, und wie sollen sie verbunden werden?
Aus den praktischen Erfahrungen von Hai Zhi geht hervor, dass das Ziel von Hai Zhi darin besteht, die KI nach dem Verstehen der Semantik die digitale Umgebung bedienen zu lassen, daher sollte der Aufbaupfad von Ontologien von strukturierten zu unstrukturierten Inhalten verlaufen, nicht umgekehrt. Der Grund liegt darin: Einheitliche Semantik muss Eindeutigkeit und Determiniertheit aufweisen, und als System ist die Eindeutigkeit der Daten von Unternehmensgeschäftssystemen von Natur aus besser als die beschreibenden Texte, die in Dokumenten verteilt sind.
Außerdem geht es heute um das Problem der Bedienung von Systemen: Wenn das System selbst diese Funktion nicht hat, braucht man sie in der Ontologie nicht zu verstehen. Daher sollte man zuerst die einheitliche Semantik in der strukturierten Umgebung aufbauen, dann mit Hilfe einer Technologie zur Generierung eingeschränkter Ontologien wie F1A (First Principles Alignment, d. h. eine Technologie zur Generierung eingeschränkter Ontologien nach dem Prinzip der ersten Grundsätze – ausgehend von den grundlegendsten und bestimmtesten Geschäftstatsachen wird abgeleitet, um schrittweise Ontologien zu generieren) den Dokumenteninhalt damit ausrichten.
Nach der Integration unstrukturierter Daten gibt es in der Ontologie hauptsächlich zwei geeignete Anwendungsfälle: Erstens können unstrukturierte Dokumente als Wissensdatenbank für die Abfrage verwendet werden; zweitens können diese Textinformationen bei der komplexen Berechnungsauswertung in der digitalen Umgebung effektive Korpusergänzungen liefern. Das ist die Notwendigkeit, unstrukturierte Daten zu integrieren.
Darüber hinaus ist es oft schwierig, den genauen Standort zwischen der Geschäftsseite und der Datenseite zu bestimmen, aber im Unternehmen gibt es immer zwei Arten von Berechnungen: Eine ist OLAP, Online Analytical Processing, d. h. Berechnungen für Geschäftsdatenerfassung und Berichterstellung, die die Frage „Was ist passiert?“ beantworten; die andere ist OLTP, Online Transaction Processing, d. h. Berechnungen für tägliche Geschäftsvorgänge und Transaktionsaufzeichnungen, die für „Was passiert gerade und wie soll damit umgegangen werden?“ zuständig sind.
Beim Aufbau von Ontologien muss die KI berücksichtigen: Anfangs geht es nur um die Kernanalyseberechnung basierend auf Daten, z. B. Geschäftsvorgänge der Betriebsanalyse; in Zukunft wird es sich zu transaktionalen Berechnungen für die Betriebsverbindung zwischen Systemen ausweiten, z. B. Dienste wie Lieferkettenmanagement und Kundenserviceverwaltung.
Aus der Perspektive der technischen Architektur pflegen traditionell OLAP und OLTP jeweils ein eigenes Datenmodell – das Data-Warehouse-Schichtenmodell (ausgerichtet auf Analyseszenarien, historische Daten nach Themen und Ebenen organisiert) dient Analyseszenarien, während das Transaktionsmodell (ausgerichtet auf Geschäftsprozesse, Echtzeit-Lese-Schreib-Konsistenz betont) Geschäftsprozessen dient, zwischen beiden fehlt eine einheitliche semantische Brücke.
Der Wert der Ontologie liegt darin, dass sie nicht einfach semantische Tags über das Datenmodell legt, sondern die fehlenden Handlungssemantiken (was bedeutet diese Aktion?), dynamische Prozessmodellierung (wie entwickelt sich dieser Prozess mit der Zeit?) und Einschränkungen von Geschäftsregeln (unter welchen Bedingungen darf/darf nicht ausgeführt werden?) ergänzt, wodurch der Weg von OLAP zu OLTP wirklich durchgängig wird und die Durchdringung von Datenanalyse zu Geschäftsausführung realisiert wird.
Aber OLAP und OLTP widersprechen sich im Wesentlichen nicht. Der Schlüssel liegt darin, dass beide derselben einheitlichen semantischen Spezifikation folgen müssen, die übrigen Probleme gehören eher zur Ebene der technischen Umsetzung.
03 Ontologien und Graphen: Einheitliche Semantik und Graph Engineering
Hai Zhi hat mit Wissensgraphen angefangen, daher werden Kunden oft gefragt: Was ist die Beziehung zwischen Ontologie und Graph?
Aus der Aufbauweise von OWL (Web Ontology Language, eine internationale Standardsprache zur Definition und zum Aufbau von Ontologien) ist die Ontologie auch auf Graphentheorie basiert, das ist unzweifelhaft. W3C (die internationale Standardorganisation, die Webstandards festlegt) hat im OWL-Standarddokument ausdrücklich festgelegt: Eine Ontologie definiert die Begriffe zur Beschreibung und Darstellung eines Wissensbereichs, einschließlich der computerverwendbaren Definitionen grundlegender Konzepte im Bereich und der Beziehungen zwischen den Konzepten, sodass Wissen system- und anwendungsübergreifend gemeinsam genutzt und wiederverwendet werden kann.
Beim Aufbau einer Ontologie für ein einzelnes Szenario ist es nicht unbedingt erforderlich, sie mit einer Graphdatenbank zu hosten und zu verwalten. Relationale Tabellen reichen aus, Vektorindizes auch, die Auswahl hängt von den Abfrage- und Berechnungsanforderungen des jeweiligen Szenarios ab.
Ein komplexes Problem, dem chinesische Unternehmen heute gegenüberstehen, lautet: Wenn immer mehr Szenarienontologien