Statt auf die natürliche Evolution zu warten, setzt ein Nobelpreisträger 94,6 Millionen auf den Weg, den AlphaFold nicht eingeschlagen hat.
AlphaFold hat die Strukturen von fast über 200 Millionen Proteinen in der Natur vorhergesagt.
David Baker wollte einen anderen Weg gehen: nicht vorherzusagen, was die Natur geschaffen hat, sondern Dinge zu erzeugen, die die Natur nie hervorgebracht hat.
An einem Morgen im August dieses Jahres rief der Forschungsassistent Jack Boylan die experimentellen Ergebnisse der vergangenen Nacht auf.
Neben dem DNA-Sequenziergerät im Labor schwammen in Reagenzgläsern eine große Anzahl künstlich entworfener DNA-Sequenzen, die alle in der Natur nie evolviert sind. Welche davon brauchbar sind und welche Abfall sind, wird ausschließlich von diesem Gerät in einem einzigen Durchlauf gelesen und ausgegeben.
Bei einem kürzlich durchgeführten Experiment gaben sie 6 Millionen solcher entworfenen Sequenzen gemeinsam in dasselbe Reagenzglas und maßen sie gleichzeitig. Bei herkömmlichen Verfahren würde die Messung dieser Charge allein mehrere Jahre dauern.
Die Einrichtung, bei der Boylan arbeitet, heißt AI BioDesign und wurde am 3. September in Seattle der Öffentlichkeit vorgestellt, nur wenige Gehminuten vom Hauptsitz des Allen-Instituts entfernt.
Hinter ihr stehen 94,6 Millionen US-Dollar, die vom Vermächtnissystem von Paul Allen investiert wurden. Die Leiter sind genau der Nobelpreisträger für Chemie 2024, Baker, und der Genomforscher Jay Shendure.
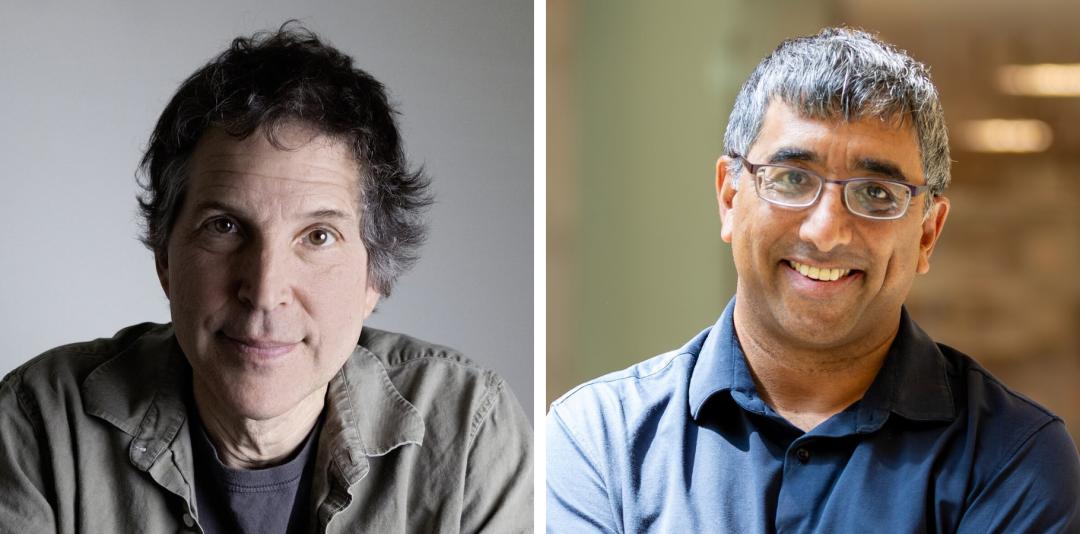
Links: David Baker, Nobelpreisträger für Chemie 2024. Rechts: Jay Shendure, Genomforscher. Die beiden leiten gemeinsam AI BioDesign.
In dieser Zeit, in der Rechenleistung alles bestimmt, planen sie nicht, mit diesen fast 100 Millionen Dollar ein größeres Modell zu trainieren, sondern sich auf das Reagenzglas zu konzentrieren.
Die Zellmaschinerie kapern, um hohe Parallelität im Reagenzglas zu erreichen
Ihr Ansatz besteht darin, einen rasant geschlossenen Kreislauf aufzubauen:
Die KI erstellt Entwürfe, das Labor stellt sie her und misst sie, die Ergebnisse fließen zurück in das Modell, das dann bestimmt, was in der nächsten Runde hergestellt wird.
Das klingt wie das bekannte „Entwerfen – Bauen – Messen – Lernen“, aber das wirklich Besondere ist, wie dieser Kreislauf in Gang gesetzt wird.
Hier gibt es keine automatisierten Werkstätten voller Roboterarme. „Die Skalierung kommt nicht von Robotern, sondern von der Parallelität innerhalb des Reagenzglases“, sagt der Geschäftsführer Jesse Gray.
Die sogenannte Parallelität innerhalb des Reagenzglases bedeutet nach Shendures Worten, die zelluläre Produktionsstraße zu kapern, die die Evolution den Menschen hinterlassen hat, um Millionen von Molekülen herzustellen und zu messen.
Das konkrete Vorgehen lautet: Millionen von entworfenen Sequenzen werden gemeinsam in dasselbe Reagenzglas gegeben, die Zellen lassen jede einzelne davon herstellen, und anschließend werden sie unter denselben Bedingungen getestet. Schließlich wird das Sequenziergerät verwendet, um auf einmal auszulesen, welche Sequenzen brauchbar sind und welche Abfall sind.
Auf diese Weise steht das Modell beim Erlernen der „Regeln des Entwerfens“ einer riesigen Anzahl von Beispielen gegenüber, statt nur einer begrenzten Anzahl natürlich entstandener Beispiele.
Wie sehen solcherart entworfene Moleküle aus?
Die folgende Abbildung zeigt ein Bindungsprotein, das zuvor von Bakers Labor entworfen wurde: Die lila und rosa Teile wurden von der KI entworfen, das Weiße ist das Amylin, das es vollständig umhüllt.
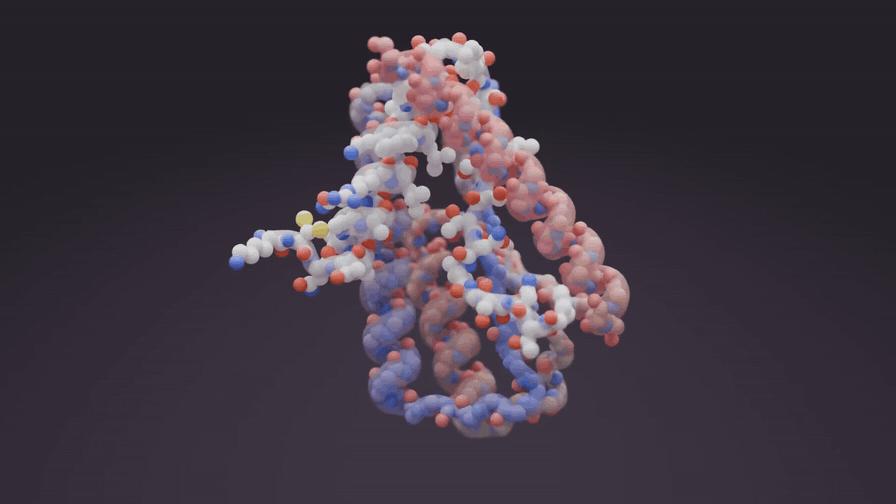
Oberflächenrendering des von KI entworfenen Amylin-Bindungsproteins.
Experimente dienen nicht mehr der Überprüfung von Schlussfolgerungen, sondern ausschließlich der Versorgung des Modells mit Daten
Noch interessanter ist die Leistungsindikator dieser Produktionslinie.
Die Labormitarbeiter werden in Teams von fünf bis sechs Personen eingeteilt, die jeweils ein spezifisches biologisches Entwurfsproblem bearbeiten, während ein Team für maschinelles Lernen jederzeit zur Unterstützung bereitsteht.
Wie wird das Ergebnis jeder Experimentrunde berechnet? Es zählt nicht nur, wie viele brauchbare Moleküle hergestellt wurden, sondern vor allem, wie viel das Modell aus dieser Runde gelernt hat.
Die Logik herkömmlicher Labore lautet: Zuerst gibt es eine Hypothese, dann wird ein Experiment entworfen, um diese zu überprüfen.
AI BioDesign kehrt die Reihenfolge um: Experimente sind in erster Linie „Übungsaufgaben“ für das Modell, die in Zyklen nach dem Muster „Entwerfen – Bauen – Messen – Lernen“ nacheinander ausgeführt werden.
Nach jeder Runde wählt das Team für maschinelles Lernen anhand der Ergebnisse die Sequenzen aus, bei denen das Modell am unsichersten ist und am wahrscheinlichsten neue Erkenntnisse gewinnen kann, und legt fest, was in der nächsten Runde gemessen wird. Die gemessenen Daten fließen zurück in das Modell, das nach der Aktualisierung die nächste Charge von Entwürfen ausgibt.
Das Ziel besteht darin, die Informationsmenge, die jedes Experiment liefert, zu maximieren, nicht so schnell wie möglich ein fertiges Produkt zu erhalten.
Früher haben Menschen die Experimentiertische gesteuert, jetzt folgen die Experimentiertische den Anweisungen der KI.
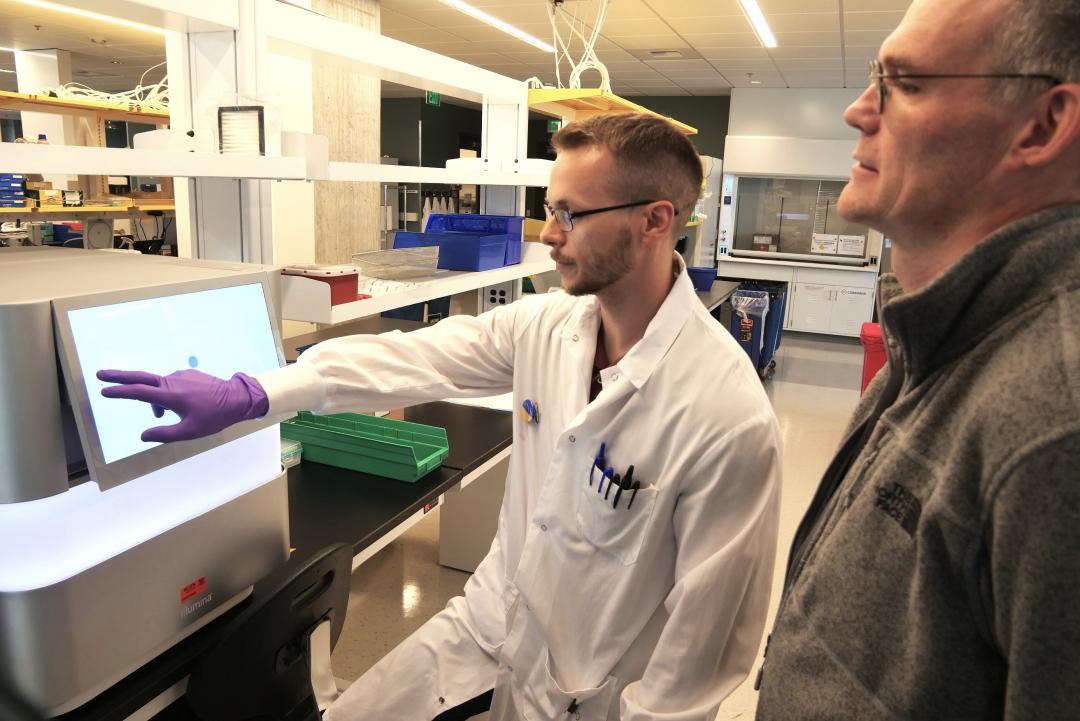
Der Forschungsassistent des Allen-Instituts, Jack Boylan (links), und der Geschäftsführer von AI BioDesign, Jesse Gray, stehen vor dem DNA-Sequenziergerät im Labor.
Er hat bereits 2003 Proteine hergestellt, die es in der Natur nicht gibt
Dies ist keine Geschichte darüber, dass „die KI Proteine hergestellt hat, die es in der Natur nicht gibt“.
Baker hat das bereits vor 23 Jahren geschafft.
Im Jahr 2003 entwarf sein Team mit der Software Rosetta ein Protein namens Top7: Es besteht aus 93 Aminosäuren, und seine Faltungsweise hatte zu diesem Zeitpunkt bei allen bekannten Proteinen kein Vorbild.
Der Nobelpreis für Chemie 2024 ging zur Hälfte an Baker für das rechnergestützte Proteindesign und zur anderen Hälfte an Demis Hassabis und John Jumper vom AlphaFold-Team für die Vorhersage von Proteinstrukturen.
Am 9. Oktober 2024 erhielt David Baker den Anruf des Nobelpreiskomitees.
Wenn AlphaFold das „Lesen“ gelöst hat: nämlich vorherzusagen, in welche Form diese Aminosäuresequenz sich falten wird, dann hat Baker das „Schreiben“ gelöst: Welche Form soll ich erzeugen, um eine bestimmte Funktion zu erreichen?
Später wurde die Hälfte des „Lesens“ in den vergangenen Jahren hoch gejubelt. AlphaFold2 und die damaligen großen Modelle verwendeten denselben Ansatz: Sie nutzten bereits von Menschen gesammelte Daten.
Für die Hälfte des „Schreibens“ gibt es diesen einfachen Vorteil nicht. Dinge, die es in der Natur nicht gibt, sind in Datenbanken überhaupt nicht auffindbar, sie müssen selbst hergestellt und selbst gemessen werden.
Daher steckt dieser Bereich schon lange in einem praktischen Dilemma:
Die KI kann in einer Nacht Hunderttausende von Kandidatenentwürfen ausgeben, während herkömmliche Labore mit einigen Hundert pro Jahr bereits eine hohe Produktivität erreichen.
Der enorme Unterschied zwischen Entwurf und Überprüfung ist die Decke, die dieser Bereich lange Zeit nicht durchbrechen konnte.
Nach Bakers Worten besteht der wirkliche Durchbruch dieses Projekts darin, dass die Geschwindigkeit der KI erstmals mit den experimentellen Fähigkeiten der Synthesebiologie Schritt hält.
Auf der einen Seite werden täglich Millionen von Kandidatenentwürfen erzeugt, auf der anderen Seite werden Millionen davon in einem einzigen Reagenzglas gemessen – diese beiden Zahnräder greifen endlich ineinander.
Keine Verfolgung allgemeiner großer Modelle, sondern starke Investitionen in die experimentelle Infrastruktur
Während alle nach einem allgemeinen großen Modell streben, das alle Fragen beantworten und sogar eine gesamte virtuelle Zelle simulieren kann, haben Baker und AI BioDesign einen anderen Weg gewählt:
Sie erstellen eine Reihe kleiner Modelle, die jeweils nur spezifische Probleme lösen, und erzeugen für jedes Problem speziell eine große Menge neuer Daten, um diese zu trainieren.
Die Logik ist leicht verständlich.
Die Proben, die die natürliche Evolution hinterlassen hat, sind nur eine kleine Anzahl von Lösungen, die sie in Milliarden von Jahren ausprobiert hat. Mit dieser kleinen Anzahl von Beispielen die allgemeinen Regeln des Entwerfens zu erlernen, weist von vornherein große Lücken auf.
Um diese Lücken zu schließen, muss man genau die Daten selbst erzeugen, die fehlen. Und das Erzeugen von Daten gelingt nicht durch das Hinzufügen von Grafikkarten, sondern durch Reagenzgläser, Sequenziergeräte und Experimentiertische.
In der vorherigen Phase haben alle um die Rechenleistungsinfrastruktur gekämpft, in der nächsten Phase wird um die experimentelle Infrastruktur gekämpft.
Noch kontraintuitiver ist, dass selbst bei einem Erfolg alle Ergebnisse uneingeschränkt öffentlich zugänglich gemacht werden. Modelle, Datensätze, experimentelle Verfahren, Reagenzien und Benchmarks werden vollständig offen gelegt.
Was passiert, wenn andere diese Daten nutzen, um rentable Medikamente herzustellen?
Der Geschäftsführer Rui Costa sagt gelassen: „Wenn viele Unternehmen diese Daten nutzen, um die Welt zu verbessern, dann haben wir Glück.“
Bei diesem rasanten Fortschritt gibt es auch Bedenken. Bei der Massenherstellung von Molekülen, die es in der Natur nicht gibt, müssen unerwartete ökologische Auswirkungen und böswillige Missbrauch verhindert werden.
In dieser Kette gibt es einen unvermeidbaren Schritt: die Synthese von DNA. Egal wie viele Entwürfe man zeichnet, am Ende muss jemand sie in physische Produkte umwandeln.
An dieser Stelle steht das Screening-System der Branche. Wenn Sie die Synthese einer DNA-Sequenz bestellen, vergleicht das System diese mit den Genen bekannter Toxine und Pathogene und blockt die Bestellung ab, wenn es eine Übereinstimmung gibt.
Eine im Oktober 2025 in *Science* veröffentlichte Studie zeigt, dass das Team von Microsoft mit öffentlichen Proteindesign-Tools 72 Arten von beachteten Proteinen in etwa 72.000 synthetische homologe Sequenzen umgewandelt hat. Ihre Struktur und Funktion blieben weitgehend erhalten, aber ihre Sequenzen waren völlig verändert, sodass vier Screening-Softwareprodukte zahlreiche Fälle nicht erkannten.
Anschließend hat dieses Team gemeinsam mit vier Syntheseunternehmen Patches entwickelt, sodass die Erkennungsrate stark gestiegen ist.
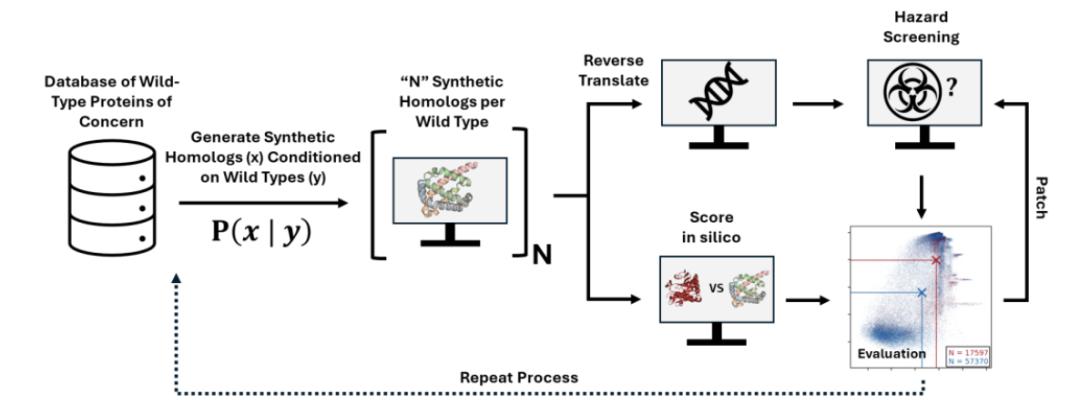
Red-Teaming-Prozess für KI-gestütztes Proteindesign des Microsoft-Teams: Aus beachteten Proteinen werden synthetische homologe Sequenzen erzeugt, die anschließend zur Überprüfung an Screening-Software übergeben werden.
Das Problem besteht darin, dass Patches nur bereits entdeckte Lücken schließen können. Die Entwurfsfähigkeit wächst exponentiell, aber die Wächter laufen immer hinterher.
Bakers Vorschlag lautet: Alle künstlich synthetisierten DNA-Sequenzen werden registriert und archiviert, wobei sowohl die Sequenz als auch die Person, die die Bestellung aufgegeben hat, aufgezeichnet wird.
Er hält dies für eine praktikable Schwelle zur Verhinderung von Missbrauch.
Enthüllung der Ergebnisse in 18 Monaten – eine neue Schublade der Biologie öffnen
Die Wette ist bereits platziert.
Costa hat eine Frist von 18 bis 24 Monaten gesetzt, um echte Fortschritte zu erzielen, und innerhalb von fünf Jahren sollen diese allen Forschern weltweit zugänglich gemacht werden.
Auf Bakers Wunschliste steht: Eine Therapie für neue Krankheiten kann innerhalb von Wochen statt Jahrzehnten entwickelt werden, Kunststoffe im Meer werden von Enzymen abgebaut, und biologische Computer verbrauchen weit weniger Strom als Siliziumchips.
Das sind derzeit alles nur Richtungen. Baker gibt selbst zu, dass auf diesem Weg zunächst eine Reihe von Molekülen auftauchen werden, die funktionieren, aber deren Funktionsweise man nicht genau erklären kann.
Sie lassen sich herstellen, aber man kann sie nicht ausreichend erklären.
Darwin hat mit dem Ausdruck „unendliche Formen in ihrer schönsten Vielfalt“ die Vielfalt der Natur bewundert.
Aber nach Bakers Ansicht sind diese schönsten Formen nur eine kleine Anzahl von Lösungen, die in Milliarden von Jahren ausprobiert wurden – die meisten Fächer in der Schublade sind noch nie geöffnet worden.
Jetzt öffnet er diese Schublade mit Hilfe der KI und durchblättert auf einmal 6 Millionen Fächer.
AlphaFold hat die Strukturen von über 200 Millionen Proteinen vollständig vorhergesagt. Der Weg, „die Natur zu verstehen“, ist damit zu Ende gegangen.
Baker setzt darauf, dass der nächste Meilenstein nicht bei Modellen liegt, sondern bei Daten: bei einer Produktionslinie, die kontinuierlich neue Daten liefern kann.
Referenzen:
https://www.wired.com/story/nobel-prize-protein-design-now-using-ai-to-create-molecules-beyond-nature/?utm_source=chatgpt.com
https://alleninstitute.org/news/ai-biodesign-accelerator