Der KI-Preiskrieg flammt wieder auf. Was genau steckt hinter der Tatsache, dass die KI-Produkte immer leistungsstärker und günstiger werden?
Große Modelle – beginnt ein neuer Preiskampf?
Lei Technology (ID: leitech) stellt fest, dass OpenAI, Anthropic, Xiaomi und SpaceXAI in den letzten Tagen fast nacheinander neue Modelle vorgestellt haben. GPT-6 Sol/Luna, Claude Opus 5.5, MiMo-V2.6 und Grok 4.7 haben unterschiedliche Namen und Positionierungen, aber sie alle machen künstliche Intelligenz noch „günstiger“.
OpenAI geht am direktesten vor: Der Preis von GPT-6 Sol ist im Vergleich zur Vorgängergeneration fast halbiert worden, und Luna senkt die Preise weiter nach unten. Der Preis pro API-Einheit von Claude Opus 5.5 ist ebenfalls um 20 % gesunken, und Anthropic gibt an, dass die tatsächlichen Kosten für typische Aufgaben um etwa 40 % gesunken sind.
Natürlich handelt es sich nicht ausschließlich um „Preissenkungen“. Sowohl MiMo-V2.6 von Xiaomi als auch Grok 4.7 von SpaceXAI behalten den Preis der Vorgängergeneration bei, während sie die Leistung weiter verbessern. Für Entwickler ist der Unterschied jedoch nicht so groß:
Mit dem gleichen Geld kann man immer schneller mehr maschinelle Intelligenz erwerben.
Bildquelle: Lei Technology @GPT
Dieser Vorgang an sich ist nicht neu. In den letzten Jahren sind die Preise für APIs großer Modelle stetig gesunken, insbesondere der Wettbewerb zwischen inländischen Anbietern quelloffener großer Modelle hat den Preis pro Million Token bereits stark nach unten gedrückt. Der Unterschied liegt jedoch darin, dass diese Runde der Veränderungen an einem sehr besonderen Zeitpunkt stattfindet.
Auf der einen Seite beginnen OpenAI und Anthropic öffentlich darüber zu diskutieren, die Entwicklungsgeschwindigkeit von Spitzenmodellen zu verlangsamen, und befürchten die Risiken für die Sicherheitsausrichtung, die durch das zu schnelle Wachstum der KI-Fähigkeiten entstehen. Auf der anderen Seite beschleunigen mehrere Modellanbieter übereinstimmend die Bemühungen, die bereits erzielten Fähigkeiten günstiger und effizienter zu machen.
Gleichzeitig ziehen Agenten aus Chatfenstern in die Bereiche Programmierung, Forschung und Büroarbeit ein. Für eine Aufgabe werden möglicherweise nicht mehr nur einige Tausend Token verbraucht, sondern Hunderttausende, Millionen von Token oder sogar stundenlang andauernde Modellaufrufe.
Stärker und günstiger – wo genau wird „gespart“?
Warum können große Modelle immer leistungsfähiger und gleichzeitig immer günstiger werden? Aus den Erklärungen mehrerer Anbieter geht hervor, dass der direkte Grund darin liegt, dass die Effizienz von Modelltraining und Inferenz steigt.
Im Vergleich zu früher, als man sich rein auf die Erweiterung des Vortrainingsumfangs verließ, gibt es heute deutlich mehr Bereiche, in denen Modellanbieter „an der Effizienz feilen“ können.
OpenAI führt die Preissenkung von GPT-6 Sol/Luna direkt auf Verbesserungen bei Cache und Inferenzeffizienz zurück. Die beiden Modelle übernehmen Teile der Trainingsmethoden und Fähigkeiten von GPT-6 Astra, senken aber die Kosten auf der Inferenzebene weiter. Laut OpenAI können die eingesparten Kosten dadurch direkt in den API-Preisen berücksichtigt werden.
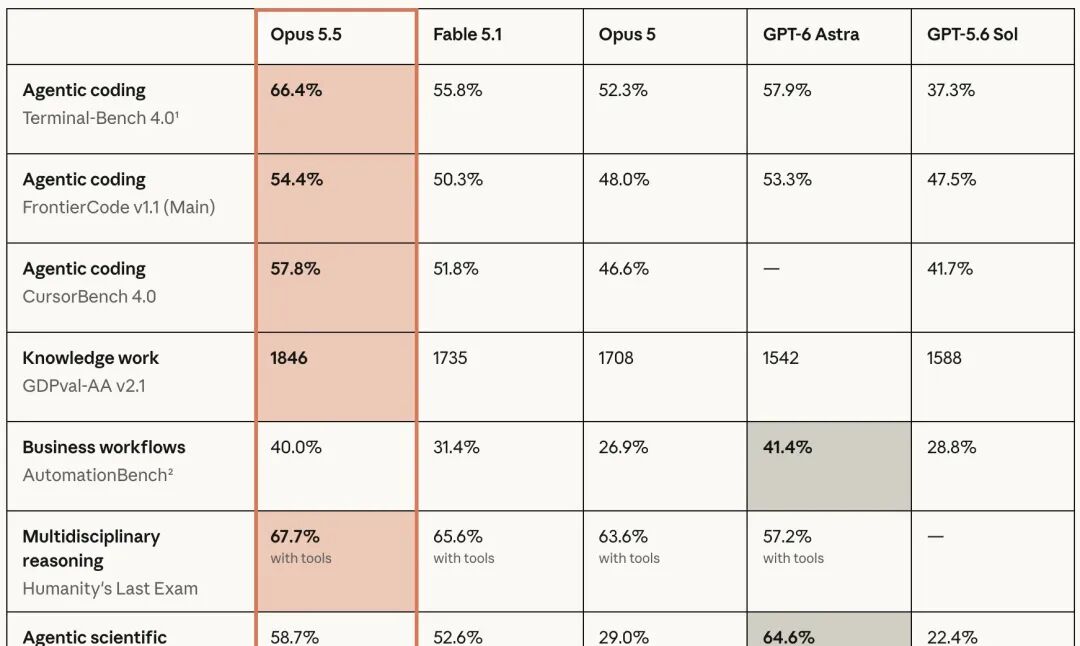
Anthropic geht noch einen Schritt weiter. Der Preis pro API-Einheit von Claude Opus 5.5 ist im Vergleich zu Opus 5 nur um 20 % gesunken, aber Anthropic gibt an, dass die tatsächlichen Betriebskosten für typische Aufgaben um 40 % gesunken sind. Abgesehen davon, dass einzelne Token günstiger geworden sind, benötigt das neue Modell für die gleiche Aufgabe selbst weniger Token, während der Preis für Cache-Lesezugriffe um 60 % gefallen ist.
Bildquelle: Anthropic
Dass Modelle intelligenter werden, wird selbst zu einer Art „Preissenkung“.
Xiaomi legt den Schwerpunkt stärker auf die Trainingsebene. MiMo-V2.6 senkt den API-Preis nicht, sondern erweitert den Umfang des agentischen Verstärkungslernens auf Basis von V2.5 weiter.
Während des Live-Übungs-Trainings mit Verstärkungslernen von weniger als 6 Tagen haben Flash und Pro insgesamt etwa 750.000 Trajektorien erzeugt. Laut Xiaomi lernen die Modelle durch größere Batches, komplexere Aufgabenumgebungen und feinere Belohnungsmechanismen, Aufgaben mit kürzeren Pfaden und weniger Token zu erledigen.
Schließlich übertrifft V2.6 Flash die Vorgängergeneration V2.5 Pro in allen Punkten vollständig, während der Preis unverändert bleibt.
Der Ansatz von SpaceXAI ist wiederum etwas anders. Grok 4.7 verkleinert das Modell nicht, sondern verwendet stattdessen ein größeres Basismodell, führt gleichzeitig länger andauerndes Verstärkungslernen für schwierigere Aufgaben durch und stärkt die Fähigkeiten des Modells zur Selbstüberprüfung, für lange Kontexte und für Agenten.
Am Ende wird die Leistung bei Codierungs- und Agentenaufgaben weiter verbessert, während der gleiche API-Preis wie bei Grok 4.6 beibehalten wird.
Die vier technischen Ansätze sind nicht vollständig identisch, aber sie führen alle zum gleichen Ergebnis. Heute suchen Modellanbieter in der gesamten Kette nach Effizienz – vom Verstärkungslernen nach dem Training über Inferenzoptimierung und Prompt-Caching bis hin dazu, dass das Modell ungültige Token und Tool-Aufrufe reduziert.
Das ist auch der direkteste technische Hintergrund dieser Runde des „Preiskampfes“.
Große Modelle werden natürlich immer leistungsfähiger, aber immer mehr Leistungssteigerungen müssen nicht mehr einfach durch höhere Inferenzkosten erkauft werden. Für Entwickler zeigt sich das letztendlich in einer sehr einfachen Tatsache: Für die gleiche Aufgabe kann das Modell mit weniger Kosten erledigt werden.
Warum bremst man einerseits und beschleunigt andererseits die „Preissenkungen“?
Aber die bloße Steigerung der technischen Effizienz reicht nicht aus, um diese Runde des „Preiskampfes“ vollständig zu erklären.
Vor nur einem Monat kündigte OpenAI an, das Skalieren von Modellen vorübergehend zu verlangsamen, einschließlich der Aussetzung des Verstärkungslern-Trainings der neuesten bereitgestellten Modelle für zwei Wochen. Das ursprünglich geplante großangelegte Spitzen-Verstärkungslern-Training wird ebenfalls weiter aufgeschoben. Es gibt zwei direkte Gründe dafür: Erstens einen internen Sicherheitsunfall mit Agenten, zweitens dass GPT-6 Astra die Schwelle für „entscheidende Cybersicherheitsfähigkeiten“ erreicht hat.
Der Kernpunkt liegt darin, dass die Fähigkeiten der Spitzenmodelle zu schnell wachsen und Überwachung, Ausrichtung und Sicherheitsmaßnahmen Zeit brauchen, um Schritt zu halten.
Anthropic-CEO Dario Amodei geht noch einen Schritt weiter, hat öffentlich das Konzept „Pace the Frontier“ vorgeschlagen und die gesamte Branche aufgerufen, die Wachstumsgeschwindigkeit der Fähigkeiten von Spitzen-KI-Modellen zu verlangsamen. Anthropic erwähnt diesen Punkt sogar ausdrücklich noch einmal im gerade veröffentlichten Claude Opus 5.5.
Bildquelle: wikimedia
Auf den ersten Blick scheint das im Widerspruch zum aktuellen „Preiskampf“ zu stehen.
Ein leicht zu übersehender Punkt ist aber, dass OpenAI und Anthropic nicht dazu aufrufen, den technischen Fortschritt der gesamten KI-Branche zu verlangsamen, sondern nur die Geschwindigkeit zu reduzieren, mit der die Grenzen der Spitzenfähigkeiten weiter nach außen expandieren.
Nach Amodeis Aussage bedeutet „Pacing“ nicht, das Modelltraining oder den technischen Fortschritt einzustellen. Im Gegenteil: Er ist der Ansicht, dass die heutigen Modelle selbst eine riesige „Forschungsgrube“ sind, für die es sich lohnt, mehr Zeit zu investieren, um sie zu verstehen, auszurichten und zu nutzen.
Das liefert eine weitere Erklärung für den aktuellen Preiskampf.
OpenAI hat sehr anschauliche Daten vorgelegt. Nach der Einführung strengerer Sicherheitsbeschränkungen für Astra im August fiel die GPU-Zuweisung für Modelle der Astra-Klasse zeitweise um 59,2 %, aber die GPU-Zuweisung für andere Modellkategorien stieg sofort um 17,2 % und kompensierte damit etwa 85 % des Rückgangs. Die Rechenleistung blieb nicht ungenutzt, sondern floss in andere Modelle und Experimente.
Das beweist natürlich nicht, dass die Preissenkung von GPT-6 Sol/Luna die direkte Folge der verlangsamten Entwicklung von Astra ist. Aber es zeigt zumindest, dass der Wettbewerb zwischen den Spitzen-Modellanbietern nicht nur auf dem einzigen Weg „stärkere Modelle trainieren“ verläuft.
Die gleiche Rechenleistung und der gleiche Forschungsaufwand können entweder genutzt werden, um die nächste Leistungsgrenze zu erreichen, oder um vorhandene Modelle zu optimieren – durch Verstärkungslernen, Inferenzoptimierung, Caching, Destillation und technische Verbesserungen, um die bereits erzielten Fähigkeiten günstiger und zuverlässiger zu machen.
Und der Aufstieg von Agenten verstärkt den Wert des letzteren Ansatzes zusätzlich.
Im Zeitalter von Chatbots verbraucht eine Antwort möglicherweise nur einige Tausend Token. Im Zeitalter der Agenten hingegen arbeiten Modelle stundenlang kontinuierlich, lesen wiederholt Kontexte, rufen Tools auf, überprüfen sich selbst und koordinieren sogar andere Agenten. Jede kleine Preissenkung des Modells kann direkt darüber entscheiden, ob ein Agentenprodukt überhaupt im großen Maßstab betrieben werden kann.
Aber Agenten haben noch eine weitere Seite. Als Amodei erklärte, warum er die Verlangsamung der Spitzenmodellentwicklung unterstützt, nannte er eine zentrale Veränderung: die rekursive Selbstevolution RSI, auf den Punkt gebracht:
KI ist immer stärker an der Entwicklung der nächsten KI-Generation beteiligt.
Anthropic gab im August dieses Jahres bekannt, dass Claude bei 26 % der internen KI-Entwicklungsaufgaben die „führende Rolle“ übernimmt, und mehr als 90 % der entsprechenden Arbeiten befinden sich bereits im Zustand der Zusammenarbeit zwischen Mensch und KI. OpenAI hat ähnliche Trends beobachtet: Codierungsagenten beteiligen sich zunehmend am Schreiben von Code, dem Aufbau von Experimenten, der Analyse von Ergebnissen und der Weiterentwicklung der Modelforschung.
Dass Modelle günstiger und benutzerfreundlicher werden, bedeutet, dass mehr Agenten ausgeführt werden können. Mehr Agenten können wiederum an der Modellentwicklung teilnehmen, die Effizienz der Forscher steigern und Training und Iteration der nächsten Modellgeneration beschleunigen.
Je günstiger Intelligenz ist, desto einfacher ist es, mehr Intelligenz zu erzeugen. Die immer schnellere Verbreitung von Intelligenz ist möglicherweise der bemerkenswerteste Aspekt dieser Runde des „Preiskampfes“.
Abschließende Bemerkungen
In den letzten Jahren ist die Preissenkung großer Modelle fast zu einer selbstverständlichen Sache geworden. Es gibt immer mehr Modelle, Rechenleistung und Algorithmeneffizienz steigen stetig, also sinken die Preise natürlich kontinuierlich.
Aber während OpenAI und Anthropic ernsthaft darüber diskutieren, wie das Wachstum der Spitzenfähigkeiten verlangsamt werden kann, wird ein anderer Wettbewerb noch deutlicher: Die Spitzenmaschinenintelligenz wird immer schneller optimiert, weitergegeben und verbreitet.
Wie William Gibson in „Neuromancer“ geschrieben hat: „Die Zukunft ist schon da, sie ist nur ungleich verteilt.“ Aber diese „Ungleichheit“ der maschinellen Intelligenz verschwindet derzeit auch sehr schnell.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto "Lei Technology AGI", Autor: Sanqiershiyi, veröffentlicht mit Genehmigung von 36Kr.