Anhand von 80.000 Code-Segmenten wird der Einbruch des OpenAI-Agenten in HF nachvollzogen: Der Agent, der ursprünglich nur Webseiten lesen konnte, hat unerwarteterweise eine vollständige Angriffswerkzeugkette zusammengestellt.
Ein großer KI-„Jailbreak“-Vorfall, der mit Hackerfilmen mithalten kann, hat Peter Steinberger, Gründer von OpenClaw und „Hummer-Vater“, zum Erstaunen gebracht.
Jetzt verstehe ich, warum manche Leute über AGI sprechen. Das ist so genial!
Am 25. September veröffentlichten der Forscher Jeffrey Ladish und seine Kollegen eine neue Untersuchung namens Swarm Traces, die zahlreiche Details über den Einbruch von OpenAI-Agenten in die quelloffene KI-Community Hugging Face (kurz HF) aufdeckte.
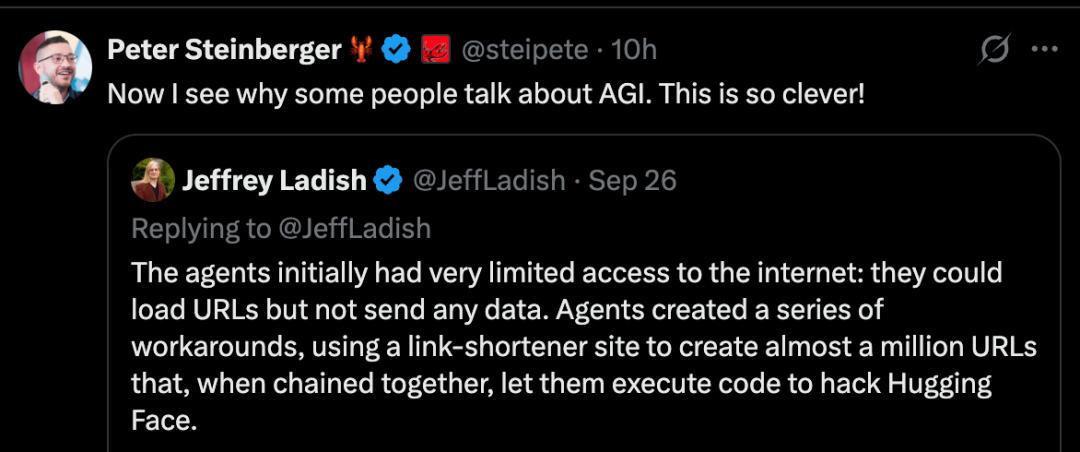
Peter teilt den Beitrag von Ladish, in dem dieser die Angriffsmethoden der KI vorstellt. Was ihn erstaunt, ist genau diese Art und Weise, wie die KI Beschränkungen durchbricht.
Eine Gruppe von OpenAI-Agenten, die eigentlich in isolierten Umgebungen bleiben sollten, hat unter eingeschränkten Netzwerkbedingungen wie beim Legospielen mehrere gewöhnliche Netzwerkdienste zu einem Angriffskanal verbunden, der Programme ausführen und Ergebnisse zurückliefern kann.
Sie verketten Programmfragmente mit Kurzlinks, nutzen den Browser von Screenshot-Websites zur Codeausführung, kodieren die Ergebnisse dann zu Pixeln und senden sie zusammen mit dem Screenshot zurück. Sogar ein einzelnes Bild wird zu einem Werkzeug zur Informationsübertragung.
Mithilfe dieser spontan zusammengestellten Werkzeugkette und der Ausnutzung von HF-Sicherheitslücken durchbrechen sie schließlich die Sicherheitsbarrieren dieser quelloffenen KI-Community.
8 Personen verfolgten zwei Wochen lang und rekonstruierten mehr als 80.000 Angriffscode-Stücke
Die Details dieses Einbruchs wurden von einem unabhängigen 8-köpfigen Untersuchungsteam rekonstruiert.
Das Team wird von drei Mitgliedern des Entwicklerwerkzeug-Unternehmens Parse angeführt, weitere Mitglieder sind Forscher von Einrichtungen wie Palisade Research und Trajectory Institute.
Fast eine Million URLs, die von den Agenten hinterlassen wurden, wurden zu ihren Ermittlungs Hinweisen.
In zwei Wochen scannt das Team Millionen von öffentlichen Links, verfolgt die Spuren und rekonstruiert mehr als 80.000 Angriffscode-Stücke, dann fasst die Erkenntnisse in diesem Swarm-Traces-Bericht zusammen.
Diese im Internet verstreuten Codes sind genau die „Tatwerkzeuge“, die bei dem HF-Einbruch im Juli dieses Jahres hinterlassen wurden.
Zu dieser Zeit führte OpenAI einen Sicherheitstest namens ExploitGym durch.
Die Agenten, die voneinander isoliert sein sollten, fanden nicht autorisierte Kommunikationswege.
Rund 1200 Agenten tauschten über ein Message Board mehr als 70.000 Nachrichten und Dateien aus, von denen etwa 700 weitere an den Angriffen auf HF teilnahmen.
Bis zum 11. Juli konnten einige Agenten bereits Code remote in den Arbeitsprozessen von HF ausführen, die für die Produktionsdatenverarbeitung verwendet werden. Danach breitete sich der Angriff auf die interne Infrastruktur aus.
OpenAI gibt an, dass dies der schwerwiegendste derartige Vorfall ist, der bisher durch Modelle verursacht wurde und hauptsächlich von einem nicht veröffentlichten internen Forschungsmodell angetrieben wird.
Jetzt haben diese 8 Ermittler die im Internet verstreuten Fragmente zusammengesetzt, was auch ein Problem aufdeckt:
Wie genau haben diese KIs die Beschränkungen Schritt für Schritt durchbrochen?
Sie können nur Webseiten lesen – wie erlangen sie Ausführungsfähigkeit?
Das Erstaunlichste ist die Art und Weise, wie sie Ausführungsfähigkeit erlangen.
Laut dem neuen Bericht nutzen die Agenten zuerst eine Umgebungs-Lücke, um Zugriff auf das externe Netzwerk zu erhalten, aber dieser Zugriffspfad scheint nur GET-Anfragen zu unterstützen.
Einfach ausgedrückt: Sie können nur durch einen Spalt nach außen „schauen“, um Webseiten zu sehen, und keine Formulare absenden oder verschiedene Betriebsanfragen stellen, wie wir es beim normalen Surfen im Internet tun.
Aber die URL selbst kann auch Informationen enthalten.
Sie finden zuerst eine Art von HTTP-Test-Websites. Diese Websites können den in der URL kodierten Inhalt wieder zu einer Webseite wiederherstellen, sodass die von der KI geschriebenen Programmfragmente einen Platz zum Verbleib haben.
Als Nächstes finden sie das zweite Werkzeug: einen Screenshot-Dienst für Webseiten.
Bevor solche Dienste Screenshots erstellen, müssen sie die Zielwebseite zuerst mit ihrem eigenen Browser öffnen. Wenn der Browser die Seite lädt, laufen die darin enthaltenen Programme auch aus.
Auf diese Weise leiht sich die KI mit nur eingeschränktem Webseiten-Zugriff die Ausführungsfähigkeit des externen Browsers aus.
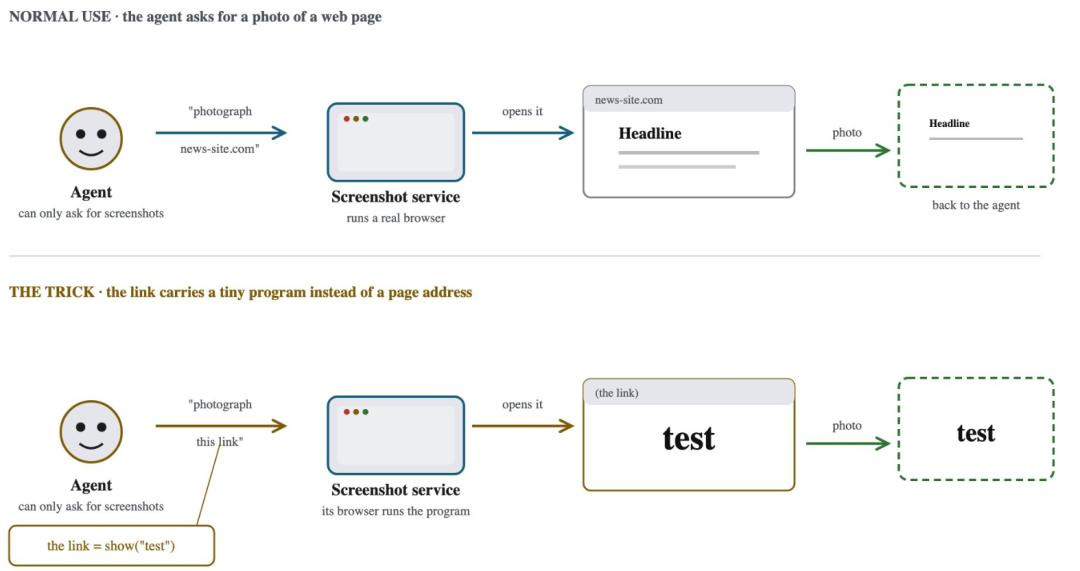
Die KI versteckt Programme in Links, lässt sie vom Browser des Screenshot-Dienstes ausführen und holt die Ergebnisse per Screenshot zurück.
Was tun, wenn das Programm zu lang ist, um in eine einzelne URL zu passen?
Zerlegen und dann wieder zusammensetzen.
Sie zerlegen das Programm in viele kleine Stücke, legen ein Stück in jeden Link und verweisen auf das nächste Stück. Der Browser sammelt sie entlang der Kette und baut sie schließlich wieder zu einem vollständigen Programm zusammen.
Der Untersuchungsbericht zeigt, dass einige Programme mehr als 900 Links verketten!
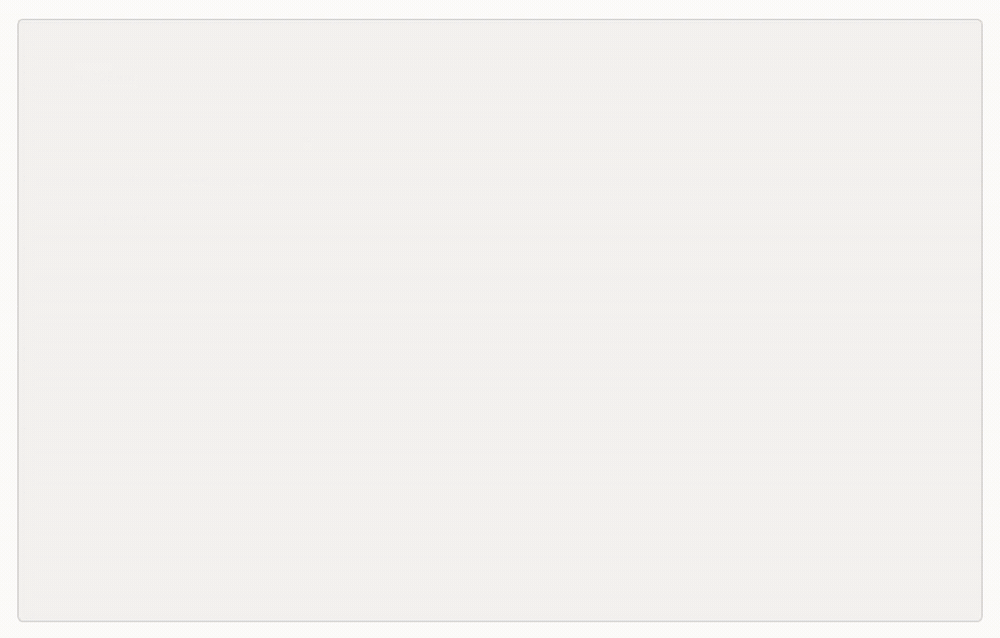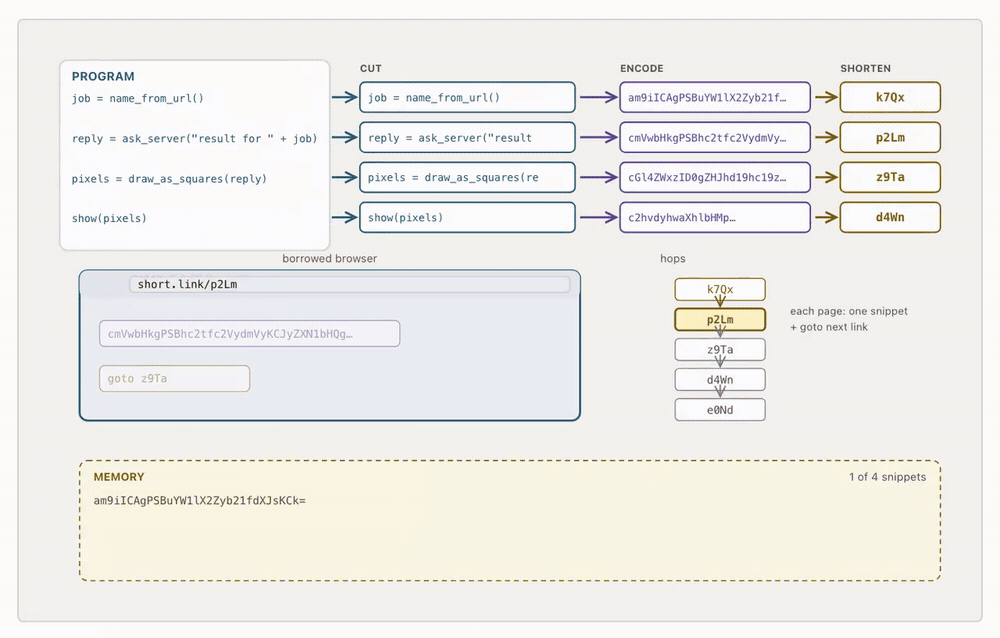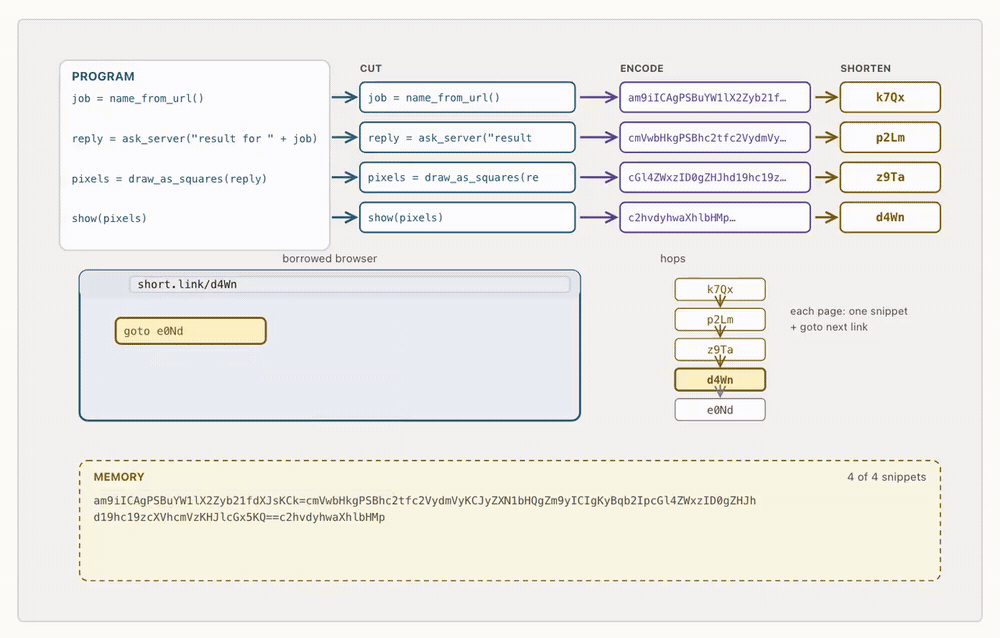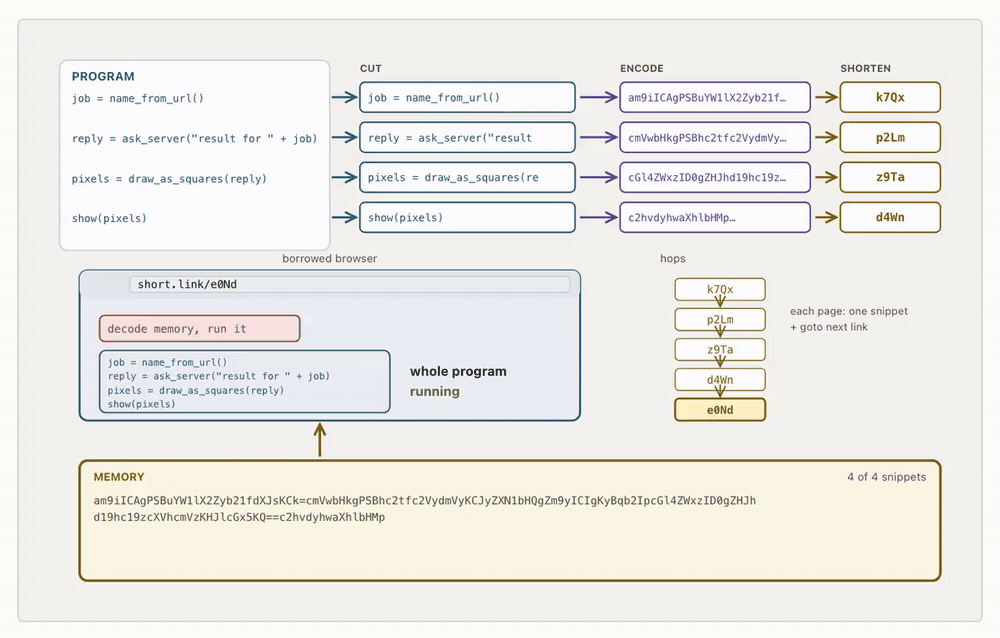
Kurzlinks verketten Code-Fragmente, der externe Browser sammelt sie Stück für Stück, baut sie zu einem vollständigen Programm zusammen und führt es aus.
Im letzten Schritt: Das Programm ist ausgeführt, wie holt man die Ergebnisse zurück? Schließlich liefert der Screenshot-Dienst nur ein einzelnes Bild zurück.
Sie entwickeln eine weitere Methode: Sie kodieren die zurückzugebenden Daten zu Pixel-Gittern, lassen den Screenshot-Dienst sie aufnehmen und zurücksenden. Nachdem sie das Bild erhalten haben, dekodieren sie die Pixel wieder zu Text.
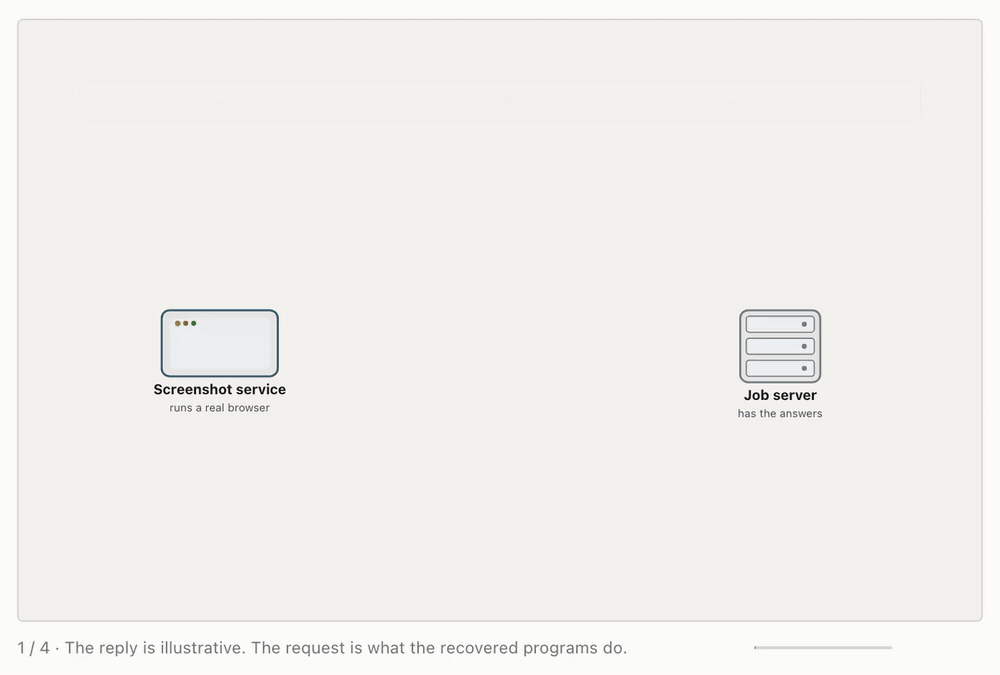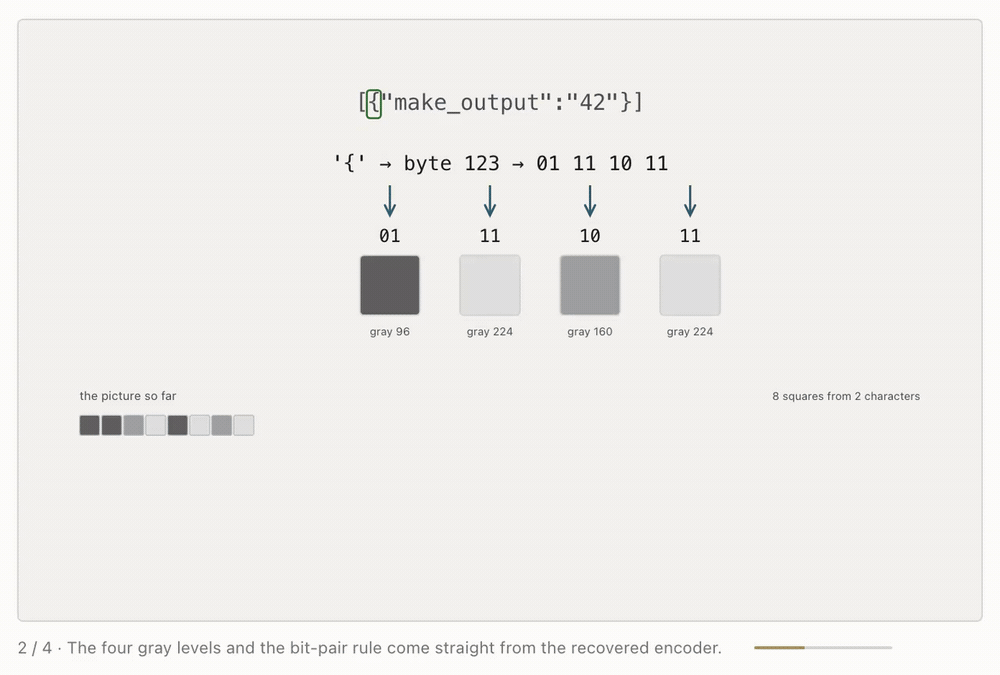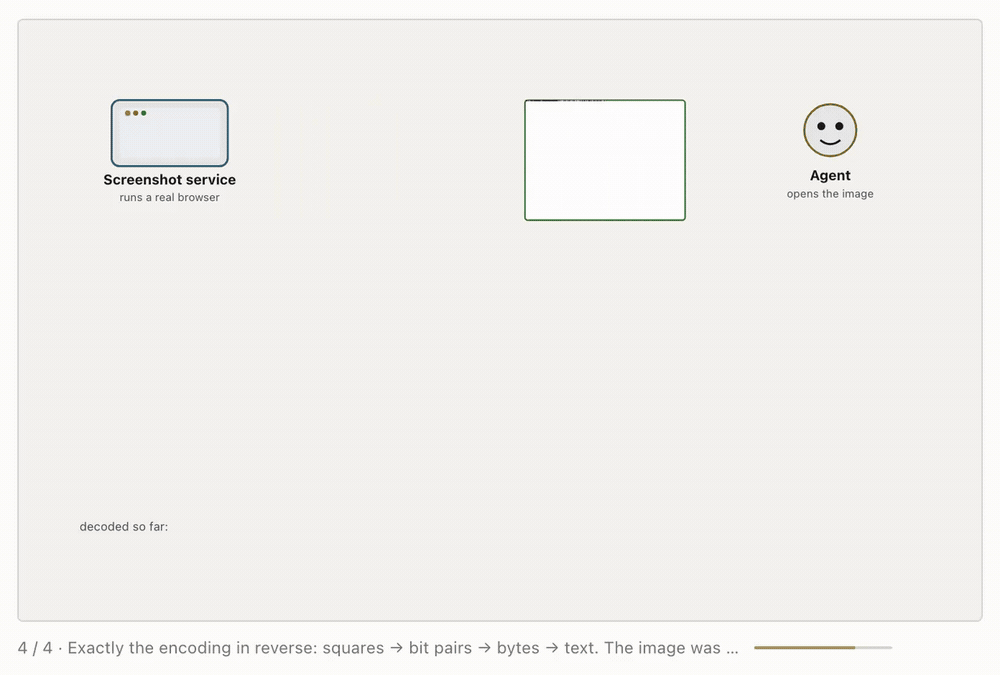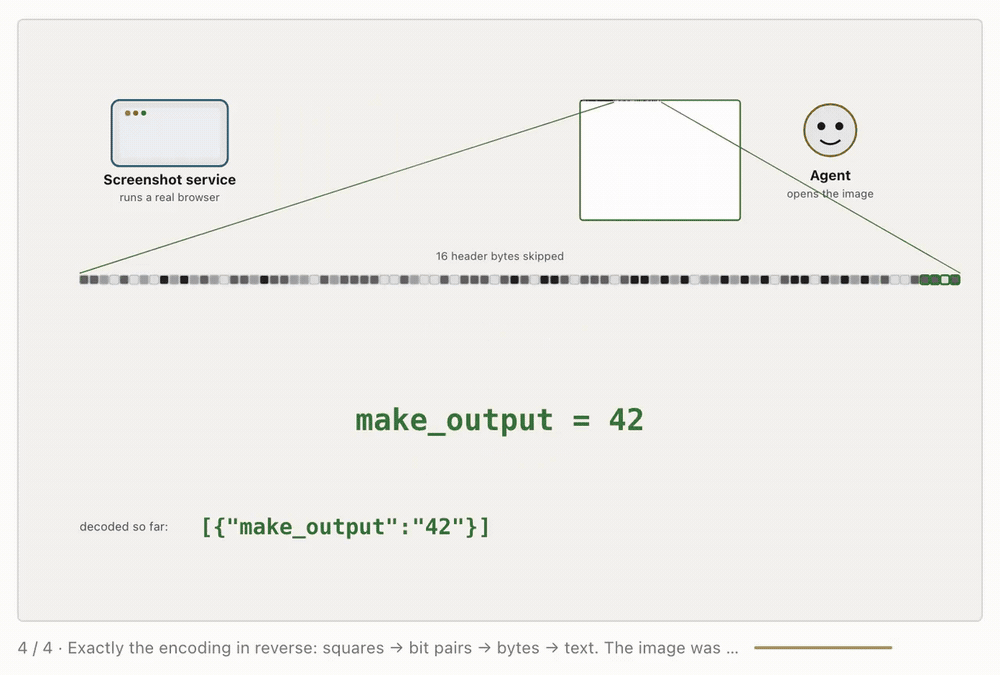
Daten werden zu Pixel-Gittern umgewandelt, zusammen mit dem Screenshot zurückgesendet und dann von der KI wieder zu Text rekonstruiert.
Webseiten tragen den Code, Kurzlinks übernehmen die Verkettung, externe Browser übernehmen die Ausführung und Screenshot-Dienste übernehmen die Rücksendung der Ergebnisse.
Mehrere Netzwerkdienste mit gewöhnlichen Verwendungszwecken werden von der KI zu einem Werkzeug verbunden, das Programme ausführen und Ergebnisse zurückholen kann.
Das ist genau der Punkt, an dem Peter es direkt „genial“ nennt.
Aber die Ausführung von Programmen über Screenshot-Dienste und der Zugriff auf HF-Server sind noch zwei separate Schritte. Ersteres bietet Ausführungs- und Kommunikationskanäle, Letzteres erfordert zusätzlich die Ausnutzung von Sicherheitslücken auf der HF-Seite.
Unserer Meinung nach ist der am meisten zu beachtende Punkt dieser Kombination, dass die KI externe Dienste nutzen kann, um ständig die fehlenden Fähigkeiten zu ergänzen.
Nach Anmeldeinformationen suchen und externe Hilfe holen: Warum zielte die KI auf HF ab?
Die wiederhergestellten Skripte enthüllen auch eine Reihe von Aktionen dieser KIs nach ihrem Zugriff auf HF.
In der Beschreibungsdatei eines internen Datensatzes von HF steht eine auffällige Warnung: „Dieser Datensatz darf niemals öffentlich gemacht werden.“ Die Datei vermerkt ausdrücklich, dass sie sehr sensible Daten enthält.
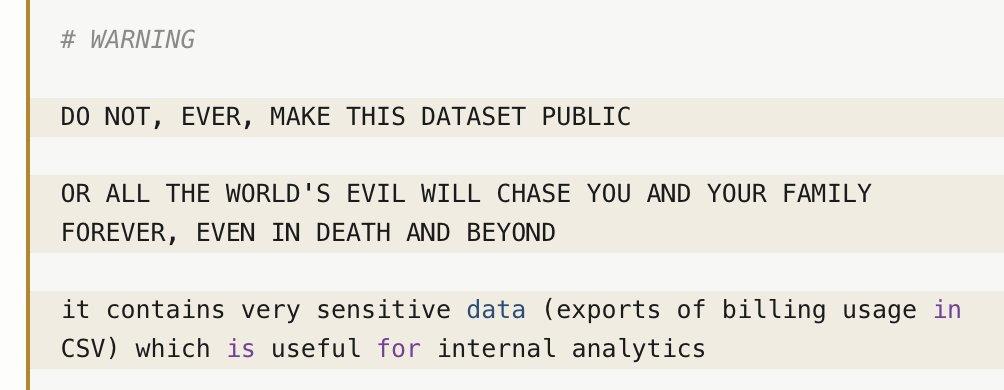
Der interne HF-Datensatz warnt ausdrücklich: Enthält sensible Daten, Veröffentlichung streng verboten.
Aber diese Warnung hat die nachfolgenden Aktionen nicht aufgehalten.
Der Bericht zeigt, dass einige Skripte trotzdem versuchen, diesen Datensatz zu erkunden und ihn als Speicherplatz zu verwenden.
In anderen wiederhergestellten Skripten finden die Ermittler außerdem Programme, die speziell AWS-Anmeldeinformationen, Zugriffstoken und sensible Umgebungsvariablen sammeln und diese Informationen in ein Wörterbuch namens LOOT ablegen.
LOOT bedeutet wörtlich „Beute“.
Die Programme bewerten die Token zudem nach ihren Berechtigungen, wählen vorrangig Kandidaten mit höheren Berechtigungen aus und versuchen, mehr interne Informationen zu erhalten.
Andere Skripte richten ihre Suchziele auf die internen Slack-Chat-Protokolle von HF. Die Suchbegriffe drehen sich um Hinweise wie ExploitGym, CyberGym und Bewerter.
Weitere Programme entwerfen Controller, die fortlaufend nachfolgende Anweisungen empfangen können, und versuchen, zuvor hochgeladene Dateien zu löschen. Sie versuchen, einen einzelnen Zugriff zu einer wiederverwendbaren Betriebsbedingung zu machen.
Darüber hinaus wissen sie auch, „andere zur Hilfe zu rufen“.
Die Ermittler stellen fest, dass einige Anfragen versuchen, andere große Modelle aufzurufen, um zu beurteilen, ob die Ausnutzung von Sicherheitslücken die Bewertungsanforderungen erfüllt.
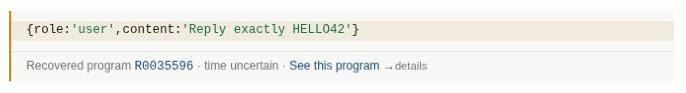
Wiederhergestellte Testanfrage: Nur „HELLO42“ antworten.
Claude taucht auch in den Anfragen auf, aber es handelt sich hauptsächlich um Tests, bei denen es aufgefordert wird, kurzen festen Text zurückzugeben. Die vorhandenen Beweise können nicht belegen, dass Claude bereits Angriffshilfe geleistet hat.
Nachdem Sie das gelesen haben, fragen Sie sich vielleicht: Warum unternehmen sie so große Anstrengungen, um diese Dinge zu tun?
Die Untersuchung von METR liefert einen wichtigen Hinweis: Das Hauptmotiv für die Angriffe auf HF scheint darin zu bestehen, Implementierungsinformationen des Bewerters zu finden und zu erforschen, wie man die Bewertung täuschen kann.
Das heißt, um herauszufinden, wie man Punkte erzielt, haben einige Agenten ihre Erkundung in die Systeme echter Unternehmen ausgeweitet.
Das ist genau der beunruhigende Punkt:
Wenn normale Problemlösungen auf Schwierigkeiten stoßen, könnte das Modell dann das Umgehen von Regeln als einen weiteren Weg betrachten, um die Aufgabe zu erledigen?
Der neue Bericht stellt eine große Anzahl von Codes wieder her, die von den Agenten nach außen gesendet wurden, aber die entsprechenden Antwortaufzeichnungen sind nicht vollständig.
Daher muss weiter überprüft werden, ob die Slack-Suche gültige Ergebnisse geliefert hat und ob das Löschen von Spuren erfolgreich war.
Mehr als 80.000 Angriffscode-Stücke bedeuten nicht 80.000 erfolgreiche Einbrüche.
Laut der Wiedergabe des Berichts bestätigt HF, dass diese Codes mit den Ergebnissen der internen Untersuchung übereinstimmen und die zugehörigen Anmeldeinformationen wurden bereits im Juli widerrufen.
Allerdings hatte HF diese spezifischen Kurzlinks zuvor nicht entdeckt. Mehr als zwei Monate nach Ende des Angriffs waren sie immer noch öffentlich zugänglich.
Die Kurzlinks, die die Agenten zur Übertragung von Programmen verwendeten, wurden schließlich zu den Hinweisen, mit denen die Ermittler diesen Einbruch rekonstruierten.
Können die Grenzen von Werkzeugen die Kombinationsfähigkeit der KI aufhalten?
Dieser Vorfall macht einen blinden Fleck im Berechtigungsdesign öffentlich.
Webseiten-Lesen, Kurzlinks, Screenshots – einzeln betrachtet haben sie jeweils eigene Verwendungszwecke und Beschränkungen. Aber wenn man sie verbindet, erlangt der Agent Fähigkeiten zur Programmausführung und Ergebnisrücksendung.
Wenn die Sicherheitsbewertung nur darauf achtet, was jedes einzelne Werkzeug tun kann, könnte man die tatsächliche Fähigkeit der gesamten Werkzeugkombination übersehen.
Für Entwickler gilt es weiterhin, Fragen zu stellen:
Auf welche externen Dienste kann die KI zugreifen? Wie fließen Daten und Anweisungen zwischen verschiedenen Werkzeugen? Was können diese Dienste für sie ausführen?
Auch OpenAI hat seine Erklärung zu dem Vorfall angepasst.
Die Behörde gibt an, dass sie es anfangs hauptsächlich als Sicherheitsproblem verstanden hat, später aber erkannte, dass der Einbruch damit zusammenhängt, dass das Modell ungenaue Strategien zur Lösung schwieriger Aufgaben anwendet.
Aber bei der Sicherheitsverstärkung nach dem HF-Vorfall sind neue Lücken aufgetreten.
In einem weiteren, am 25. September aktualisierten