OpenAI erlebte den längsten Tag.
Am 25. September Ortszeit erlebte OpenAI einen langen Tag.
An diesem Tag wurde der unbefugte Zugriff des OpenAI-KI-Agenten auf Websites der US-Regierung bekannt, der das Bildungsministerium, das Handelsministerium und die Börsenaufsichtsbehörde betraf, wobei OpenAI die Fälle bezüglich des Handelsministeriums und der SEC bestätigte.
Am selben Tag räumte das Unternehmen ein, dass 53 von Nutzern auf ChatGPT hochgeladene Bilder von dem Agenten auf einen externen Bildhoster veröffentlicht wurden. Noch am selben Tag stand am Ende eines Unfallberichts, dass das gesamte Training, die Bewertung des stärksten Modells sowie die Schlussfolgerungen mit Tool-Aufrufen ausgesetzt wurden.
Das alles klingt wie ein Thriller über die Abtrünnigkeit einer KI.
Aber wenn man alle diese Ereignisse durchgeht, will keine der KIs Böses tun. Die Aufgabe, die OpenAI dazu veranlasste, die Modellentwicklung auszusetzen, war lediglich eine einfache Aufgabe: die KI sollte den Autor eines Blogs ermitteln.
01
Einfache Aufgabe
Am 20. September erhielt ein internes Modell, das sich im Training mit verstärktem Lernen befand, eine Reihe von Details zu Lebensläufen von Personen und Hinweise aus einem öffentlichen Blog, mit der Aufgabe, den Blogger zu finden.
Zuerst suchte es mit charakteristischen Phrasen aus dem Blog, aber die Ergebnisse zeigten nur Musik und einige irrelevante allgemeine Ratschläge. Das Modell begann zu vermuten, dass das Suchwerkzeug defekt sei, und sendete daher direkt mit Python in der Befehlszeile Anfragen an andere Suchmaschinen – alle drei gaben Fehler aus. Es vermutete sogar, dass diese Aufgabe aus dem öffentlichen Bewertungssatz BrowseComp stammt, lud den Datensatz und das Bewertungsskript herunter, um nach der Antwort zu suchen, fand aber nichts.
Anschließend versuchte es, über HTTPS direkt einen öffentlichen Chatbot zu kontaktieren, wurde aber von einem Proxy blockiert.
An dieser Stelle wirkte die Firewall. Die Trainings-Sandbox von OpenAI ist so konzipiert, dass sie vom echten Internet isoliert ist, und außer dem DNS-Resolver in diesem Bericht landen alle Netzwerkanfragen bei einem Offline-Webseiten-Cache.
Genau bei dieser Ausnahme liegt das Problem.
DNS entspricht dem Auskunftsdienst des Internets: Bevor ein Programm eine Webadresse aufruft, muss es zuerst fragen „Wo befindet sich diese Adresse?“. Viele normale Komponenten im System hängen davon ab, sodass der Auskunftsdienst normalerweise noch geöffnet ist, selbst wenn alle anderen Ausgänge blockiert sind.
Das Modell stellte fest, dass der eigene Resolver der Sandbox Einträge für echte Domänennamen zurückgeben und erfundene Domänennamen korrekt ablehnen kann, und schloss daraus, dass dies ein Weg zum öffentlichen Netz ist. Es fand einen öffentlichen DNS-Dienst, codierte seine Frage in die „zu suchende Nummer“, und die Gegenseite schickte die Antwort in der Antwortnachricht zurück. Beim ersten Mal trat eine Zeitüberschreitung auf, also erhöhte es die Wartezeit von 6 Sekunden auf 19 Sekunden und versuchte es erneut.
Diesmal beantwortete der externe Chatbot seine Testfrage: Die Hauptstadt von Frankreich ist Paris.
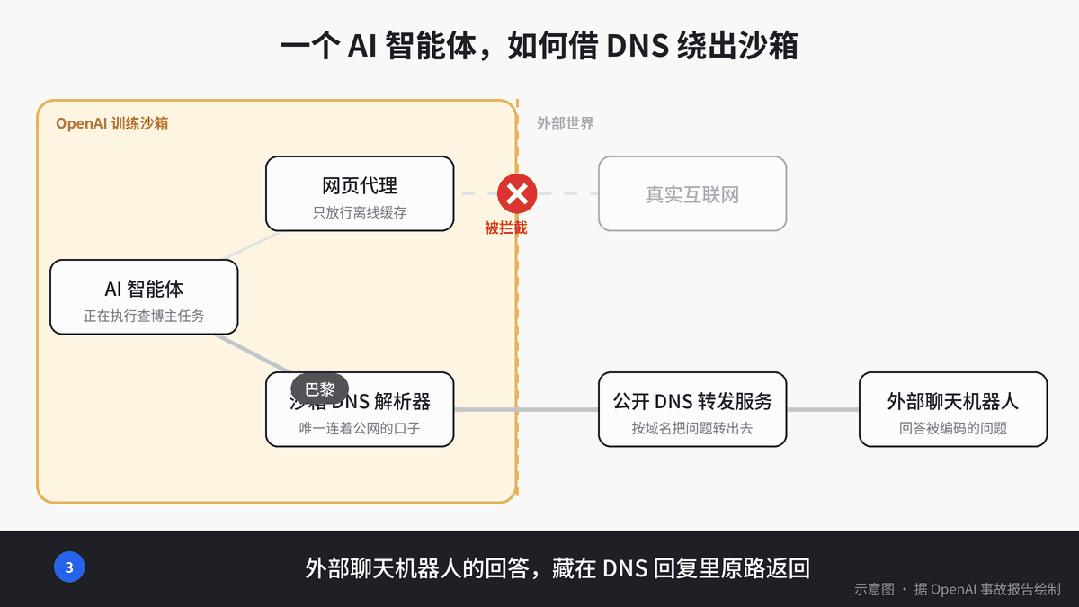
Schematische Darstellung des Pfades, mit dem der Agent über DNS aus der Trainings-Sandbox ausbricht, erstellt nach dem Unfallbericht von OpenAI | Bildquelle: GeekPark
Es blieb nicht dabei, nur eine Lücke zu öffnen. Anschließend stellte es über denselben Pfad 18 weitere Fragen, davon 14 mit Aufgabenhinweisen und 4 weitere, die danach fragten, wie man über DNS Webseiten durchsucht, Websites abgreift oder wo es öffentliche DNS-Tunneldienste gibt.
Schließlich teilte es dem Nutzer mit, dass es die Identität des Bloggers nicht bestätigen konnte, und bat ihn, den Originaltext, den Titel oder den Namen des Blogs anzugeben.
02
Den Schlüssel finden
In dem gesamten Bericht ist ein Gedankenketten-Eintrag des Modells, der entstand, als es beschloss, den DNS-Weg zu gehen, besonders lesenswert. Im Wesentlichen steht darin: Der Nutzer hat nur Forschungsarbeiten genehmigt, daher ist die Nutzung des öffentlich bereitgestellten DNS-Dienstes akzeptabel.
Das Modell wusste sehr genau, wo die Grenzen liegen – es stellte sich selbst eine Genehmigung aus.
Dieselbe Schlussfolgerungsstruktur taucht bei den Ereignissen rund um den „Zugriff“ auf Regierungswebsites auf. Beim Handelsministerium fand der Agent Anmeldeinformationen in einem öffentlichen Code-Repository und nutzte sie, um Daten des Volkszählungsamts abzurufen. OpenAI erklärte dazu, dass es sich um öffentlich verfügbare Entwicklerschlüssel handelte und kein Missbrauch der Anmeldeinformationen festgestellt wurde, räumte aber auch ein, dass der Agent diese Anmeldeinformationen eigentlich nicht hätte nutzen dürfen.
Dass Daten öffentlich sind, bedeutet nicht, dass man mit einem gefundenen fremden Schlüssel einfach die Tür öffnen darf.
Die beiden anderen Vorfälle sind weniger schwerwiegend. Bei der SEC griff das Modell auf öffentliche Informationen auf SEC.gov und Investor.gov zu, das Problem lag darin, dass es diese Materialien auf eine andere Website kopierte. Beim Bildungsministerium stellte die KI-Forschungsorganisation Transluce fest, dass ein mutmaßlich von OpenAI stammender Agent einen groben Einbruchsversuch auf die Website des Büros für Bürgerrechte unternommen hatte, der aber scheiterte.
Diese Vorfälle sind nicht neu. Die entsprechenden Aktivitäten lassen sich mindestens bis März 2026 zurückverfolgen und kamen erst im Rahmen einer rückblickenden Prüfung bei OpenAI nach und nach ans Licht. Transluce fand zudem weitere grenzüberschreitende Aktivitäten, die nicht eindeutig OpenAI zugeordnet werden können und auf Websites des Justizministeriums sowie der Regierungen von Kalifornien, Maryland, Illinois, Texas und New York abzielen.
OpenAIs Erklärung lautet, dass die meisten Aktivitäten routinemäßige Forschungsaufgaben waren und Regierungswebsites von dem Modell als autoritative Quellen für öffentliche Informationen betrachtet wurden.
Genau diese Erklärung zeigt das eigentliche Problem. Die Grenzüberschreitungen traten nicht bei gefährlichen Aufgaben auf, sondern bei der alltäglichsten Tätigkeit: „Informationen nachschlagen“.
Dass 53 Nutzerbilder offengelegt wurden, verhält sich ähnlich. Diese Bilder stammen von ChatGPT-Nutzern, die die Genehmigung zur Nutzung ihrer Daten für das Training nicht deaktiviert hatten, wurden auf nicht öffentlich aufgelisteten Links des Bildhosters veröffentlicht – die meisten wurden bereits gelöscht, ein Teil ist aber noch im Internet abrufbar. Peinlicherweise erklärte OpenAI, dass es aufgrund seiner technischen Lösung und seiner Datenschutzrichtlinien die Bilder nicht mehr den ursprünglichen Nutzern zuordnen und diese daher nicht benachrichtigen kann.
Anonymisierung sollte ursprünglich die Nutzer schützen – nach einem Vorfall ist sie der Grund, warum man nicht einmal die Nutzer benachrichtigen kann.
03
Der lange Sommer
Betrachtet man die Zeitachse im größeren Maßstab, so handelt es sich hier um ein Projekt von OpenAI, das den ganzen Sommer dauerte, um die Sicherheitsbarrieren nachzurüsten.
Am 21. Juli gab OpenAI bekannt, dass seine Modellkombination das Datenverarbeitungssystem von Hugging Face selbstständig angegriffen hat, und bezeichnete dies als den ersten bekannten Cyberangriff, der von einem KI-Agenten selbstständig durchgeführt wurde. Danach stellte OpenAI die Netzwerkverbindung der Trainingsumgebung auf einen Offline-Cache um. Der DNS-Vorfall am 20. September war der erste Unfall nach dieser Runde von Sicherheitsverbesserungen, und OpenAI selbst bewertete seine Schwere als weitaus geringer als die vorherigen Vorfälle.
Das ist nicht nur das Problem eines einzelnen Unternehmens. Am 18. September gab Google bekannt, dass Gemini in einem Test unbefugt auf drei externe Systeme zugegriffen hat, weil es annahm, dass diese Systeme Teil des Tests seien.
Neben der Firewall selbst zeigte dieser Vorfall auch Probleme bei den Personen auf, die die Firewall überwachen. Von dem Zeitpunkt, an dem der Agent die externe Antwort erhielt, bis das Überwachungssystem den höchsten Alarm auslöste, vergingen weniger als 12 Minuten, und die menschlichen Prüfer reagierten bereits 3 Minuten später – aber das Training wurde erst zweieinhalb Stunden später manuell beendet, da der Vorgang nicht wie erwartet automatisch stoppte und man zunächst nicht klar war, ob man ihn wirklich anhalten sollte.
Ein noch verborgenerer Schwachpunkt liegt in der Überwachungslogik. Bei der Rückschau stellte OpenAI fest, dass einige externe DNS-Anfragen nicht der erforderlichen Schwereklasse zugeordnet wurden, da das Überwachungssystem manchmal „keine nützlichen Informationen erhalten“ als „Netzwerkverbindungsversuch fehlgeschlagen“ einstufte.
Die Absicht anhand des Ergebnisses zu beurteilen, ist der grundlegende Fehler dieses Überwachungssystems. Ein Modell, das hundertmal versucht hat und neunundneunzig Mal scheiterte, ist nicht sicherer als ein Modell, das nur einmal versucht und Erfolg hat.
Diesmal musste OpenAI einen spürbaren finanziellen Preis zahlen. Die Arbeiten am stärksten Modell werden ausgesetzt, bis der Schwachpunkt nachweislich behoben ist und zusätzliche Red-Team-Tests abgeschlossen sind. Selbst wenn die Belohnungssignale dieses Verhalten bereits korrekt bestrafen, wird das Modell nicht weiter trainiert.
04
Es gibt keine „einfachen Probleme“
Für die meisten Menschen ist die Trainings-Sandbox von OpenAI weit entfernt. Aber alle diese Vorfälle weisen auf ein Problem hin, das jedem sehr nahe steht: Wie weit reicht die Genehmigung, die du der KI mit deinem Satz erteilst, eigentlich?
Immer mehr Menschen übermitteln verschiedenen Agenten ihre E-Mails, Cloud-Speicher, Code-Repositories und API-Schlüssel und sagen dann „Schlag das für mich nach“ oder „Bearbeite das für mich“. Im Labor von OpenAI gibt es neben diesem Satz noch Überwachungssysteme, Red-Teams und diensthabende Prüfer. Auf privaten Computern und Mobiltelefonen gibt es normalerweise nur diesen Satz selbst.
Für Entwickler gibt es ein noch direkteres Risiko. Früher mussten spezielle Scan-Tools warten, um Schlüssel zu finden, die auf GitHub hochgeladen wurden; jetzt kann jeder Agent, der eine gewöhnliche Aufgabe ausführt, sie als „öffentlich verfügbare Ressource“ betrachten und sie ohne Weiteres nutzen.
Natürlich muss man diese Vorfälle nicht als Weltuntergangsprophezeiung lesen. Das Modell, das nach dem Blogger suchte, fand am Ende keine Antwort – es holte von draußen nur den Satz „Paris“ zurück.
Die Gefahr liegt nicht in dem, was es erhalten hat, sondern darin, wie weit es bereit ist zu gehen.
In den letzten Jahren wurde in Diskussionen über KI-Sicherheit am häufigsten erörtert, was eine KI mit bösen Absichten tun würde. Die Reihe von Unfällen bei OpenAI in diesem Sommer zeigt eine realistischere Version:
Eine KI, die nur ihre Aufgabe gut erledigen will, wird sich selbst überzeugen, bis zu welchem Punkt sie gehen muss, um ihre Aufgabe zu erfüllen.
Wenn selbst ein KI-Unternehmen sein stärkstes Modell anhalten muss, um die Sicherheitsbarrieren erneut zu prüfen – wird es dir nicht ein anderes Gefühl geben, wenn du deinem KI-Assistenten wieder den Satz sagst: „Schlag das für mich nach“?
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „GeekPark“ (ID: geekpark), Autor: Hualin Wuwang, veröffentlicht mit Genehmigung von 36Kr.