Die Hälfte der Aufgaben wird nicht mehr von der GPU verarbeitet.
Auf dem Rechenleistungsgipfel von XuanTie habe ich vor Ort zwei Vorträge angehört, einer drehte sich um CPUs, der andere um Netzwerkkarten.
Auf dem Rückweg habe ich ständig darüber nachgedacht: Warum wurden genau diese beiden Themen CPU und Netzwerkkarte auf der Veranstaltung platziert? Als ich zu Hause noch einmal alles durchging, stellte ich fest, dass die beiden Redner auf der Bühne einen großen Umweg machten, aber im Grunde nur über eines sprachen: den Wettbewerb abseits von GPUs.
Wie kann man das verstehen? Ich versuche, es verständlich zu erklären.
Zuerst zum Vortrag über die CPU: Der Redner ist Huang Wei, Produktleiter von XuanTie Semiconductor. Er eröffnete seinen Vortrag mit der These, dass sich die Rolle der CPU im Zeitalter der Agenten grundlegend verändert hat. Warum? Er sagte, man müsse prüfen, ob sich die anfallenden Aufgaben verändert haben.
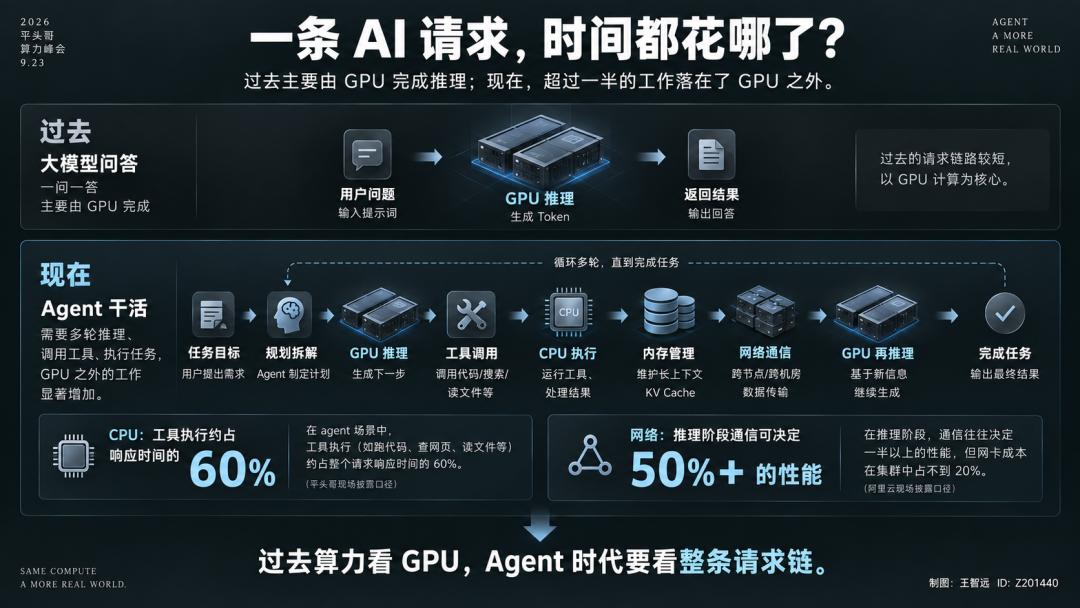
In der Vergangenheit erfolgte die Inferenz großer Modelle nach dem Prinzip von Frage und Antwort, diese Aufgabe wurde im Wesentlichen von GPUs übernommen.
Agenten verhalten sich anders: Um eine Aufgabe zu erledigen, laufen sie ständig in Schleifen, führen einen Inferenzschritt aus, rufen ein Werkzeug auf, prüfen das Ergebnis und führen dann den nächsten Inferenzschritt aus, bis die Aufgabe abgeschlossen ist.
Der Schritt des Aufrufens von Werkzeugen – egal ob es um Ausführen von Code, Abfragen von Webseiten oder Lesen von Dateien geht – ist eine Aufgabe, die von der CPU erledigt wird.
Hinzu kommt der lange Kontext, der ständig zur Verfügung stehen muss: Alle Zusammenhänge der aktuellen Anfrage zwischen Modell und Nutzer werden bei jedem Inferenzdurchgang als Eingabe verwendet, und dieser Kontext wird hauptsächlich im Speicher auf der CPU-Seite gehalten.
Dann nannte er drei Zahlen.
In Agent-Szenarien macht allein die Ausführung von Werkzeugen etwa 60 % der gesamten Antwortzeit der Anfrage aus. In Szenarien von Codieragenten nehmen die Initialisierung von Containern und die Ausführung von Werkzeugen auf der CPU 55 % bis 60 % der Zeit ein. Insgesamt gesehen trägt die CPU bereits mehr als die Hälfte der gesamten Last.
Diese Zahlen wurden von ihm vor Ort genannt, die experimentellen Bedingungen wurden nicht näher erläutert, aber die Schlussfolgerung war eindeutig: Die CPU ist wieder auf den kritischen Pfad der KI-Berechnung zurückgekehrt.
Er unterteilte die Aufgaben in zwei Kategorien – dieses Framework hat mich während des gesamten Vortrags am stärksten beeindruckt.
Eine Kategorie von Aufgaben läuft direkt an der GPU an, er nennt sie „Head Node“, also der Kopfknoten. Die GPU erledigt die rechenintensiven Hauptaufgaben, während der Kopfknoten für alle Nebentätigkeiten zuständig ist, genau wie ein Fahrer mit einem Beifahrer: Eingehende Anfragen werden zuerst von ihm vorverarbeitet.
Er verwaltet den KV-Cache – das sind die Notizen, die das Modell automatisch anlegt, um bereits berechnete Zwischenergebnisse zu speichern. Dadurch muss bei der Generierung des nächsten Wortes nicht alles von vorne neu berechnet werden. Wo diese Notizen gespeichert werden und wie sie übertragen werden, ist ausschließlich seine Aufgabe.
Wann der Beschleuniger zur Arbeit aufgefordert wird und wie die Endergebnisse wieder zusammengesetzt werden, wird ebenfalls von ihm gesteuert und abgeschlossen. Diese Aufgabe liegt auf dem kritischen Pfad: Wenn der Kopfknoten nur einen Schritt langsamer wird, wartet die GPU, die stündlich hohe Kosten verursacht, genau einen Schritt lang auf Arbeit.
Deshalb ist die Optimierung der CPU für den Kopfknoten vollständig auf die Geschwindigkeit eines einzelnen Kerns ausgerichtet.
Die Erweiterung der Frontend-Breite entspricht der Verbreiterung einer einspurigen Zufahrtsstraße: In einem Taktzyklus können mehrere Befehle gleichzeitig verarbeitet werden.
Die Vergrößerung des Out-of-Order-Fensters ist vergleichbar mit einem erfahrenen Koch, der nicht wartet, bis ein Gericht fertig ist, bevor er die Zutaten für das nächste vorbereitet. Ein größeres Fenster erlaubt es, Dutzende von Schritten im Voraus zu betrachten und die jeweils ausführbare Aufgabe sofort zu berechnen.
Der KV-Cache wird ständig zwischen CPU und Beschleuniger hin- und herübertragen, und bei der Adressübersetzung wird oft keine passende Adresse gefunden – es ist wie das blätterweise Durchsuchen eines Wörterbuchs. Die Lösung ist das Vorabrufen von Seitentabellen, bei dem die CPU die nächste Seite bereits im Voraus öffnet.
Es gibt noch einen versteckten Optimierungspunkt: Zwei an sich unabhängige Operationen werden vom System fälschlicherweise als Nutzung derselben Adresse eingestuft. Obwohl sie parallel ausgeführt werden könnten, werden sie nacheinander in eine Warteschlange gestellt. Die Speicherbenennung löst diese Fehleinstufung auf und macht die Ressourcen frei.
Auf der Softwareseite wird sogar der Overhead bei der Zuweisung von Befehlen durch den Python-Interpreter bis ins kleinste Detail optimiert.
Auf der Cache-Seite werden die Metadaten des KV-Caches hierarchisch zwischen dem L3-Cache und dem Arbeitsspeicher angeordnet. Häufig genutzte Daten werden nah an der Verarbeitungseinheit platziert, damit der Beschleuniger nicht auf Notizen warten muss, die eigentlich in seiner unmittelbaren Nähe liegen sollten.
Die andere Kategorie von Aufgaben hat keine Verbindung mehr zur Inferenz: Es handelt sich um das Agent-Rack, also eine ganze Reihe von Agenten in einem Rechenzentrum.
In einem einzigen Rack werden Hunderte von Sandboxen untergebracht, in denen jeweils ein Agent arbeitet: Er ruft Werkzeuge auf, führt Code aus, plant Schritte, organisiert Aufgabenketten und verwaltet seinen eigenen Zustand.
All diese Aufgaben berühren keine GPU, sie laufen vollständig auf der CPU ab. Bei diesen Aufgaben geht es nicht um maximale Geschwindigkeit, sondern um maximale Dichte: Ein Rack soll so viele Agenten wie möglich aufnehmen, und gleichzeitig sollen Hunderte von Instanzen nicht um Ressourcen konkurrieren.
Für diese Anforderungen gibt es ein anderes Optimierungskonzept.
In der Schleife von Agenten gibt es viele unregelmäßige Sprünge. Die CPU erledigt ihre Arbeit, indem sie den nächsten Schritt vorhersagt, aber herkömmliche Vorhersagemethoden liegen bei Agenten oft falsch. Deshalb wird eine neuronale Verzweigungsvorhersage eingeführt, damit die CPU aus Erfahrung eine Intuition für die richtige Vorhersage entwickelt.
Aufgaben wie RAG-Abfragen und Traversierung von Graphdaten sind vergleichbar mit dem Ausgraben mehrerer Kartoffeln an einer einzelnen Ranke: Die CPU soll nicht erst nach der nächsten Abhängigkeit in der Kette suchen, wenn sie sie braucht, sondern die Graphvorabrufung holt die Daten entlang der Kette schon im Voraus.
Hunderte von Sandboxen teilen sich denselben Cache, das ist wie Hunderte von Haushalten, die sich einen einzigen Lagerraum teilen. Der dynamische Cache-Ersatz tauscht Daten nach der Aktivität der Nutzer aus und macht Platz für ungenutzte Inhalte.
MPAM hingegen weist jeder Sandbox ein festes Ressourcenkontingent zu: Jede Instanz bekommt ihre eigenen Kernzyklen und Bandbreiten, sodass niemand die öffentlichen Ressourcen vollständig überlasten kann.
Er hat für diese zwei Kategorien von Aufgaben eine sehr bildliche Aussage gemacht: Bei Kopfknoten geht es um den Speicher – man prüft, ob man Daten schnell übertragen kann. Bei Rechenzentrums-Racks geht es ebenfalls um den Speicher – man prüft, ob man möglichst viele Daten unterbringen kann.
Es gibt noch zwei weitere Zahlen auf der Veranstaltung, die man leicht übersieht, aber meiner Meinung nach die Grundlage des Ganzen bilden.
Die erste Zahl ist 41 %. Er sagte, dass in einer Iterationsaufgabe im Kopfknoten-Szenario 41 % der Aufgaben nicht durch Parallelisierung verteilt werden können – dies gilt insbesondere für den Bereich der Steuerung und Planung.
Hinter dieser Zahl steckt das Amdahlsche Gesetz: Bei seriellen Aufgaben hilft es nicht, mehr Personen hinzuzuziehen. Sobald Wasser in einem Topf kocht, beschleunigt das Hinzufügen von mehr Brennholz das Kochen nicht weiter.
Die Untergrenze der Antwortzeit des gesamten Systems wird durch diese 41 % des seriellen Abschnitts bestimmt. Um die Maschine schneller zu machen, gibt es nur einen Weg: Die Leistung des einzelnen Kerns selbst zu erhöhen. Die starke Fokussierung des Kopfknotens auf die Single-Core-Leistung hat genau hier ihren Ursprung.
Die andere Zahl ist 28 GB.
Praktische Messungen im Rechenzentrum haben gezeigt, dass eine einzelne Agent-Instanz bei Spitzenlast eine Speicherkapazität in dieser Größenordnung benötigt. Wenn ein Rack Hunderte von Instanzen aufnehmen soll, reicht es nicht, nur ein wenig Speicher zur Verfügung zu stellen.
Deshalb reicht es nicht, dass diese CPU nur über viele Kerne verfügt – die Speicherkapazität selbst ist bereits ein Wettbewerbsvorteil.
Diese Analysen sind nicht umsonst durchgeführt worden. Am nächsten Tag auf dem Hauptforum von Yunqi hat XuanTie erstmals die Roadmap für die Yitian-CPU vorgestellt: 2027 werden die Modelle Yitian 720 und 730 auf den Markt kommen, danach folgt die 750 mit dem zweiten Generation von selbst entwickelten Kernen und einer selbst entwickelten Direktverbindung zwischen Chips, die direkt mit dem Zhenwu-KI-Chip verbunden ist.
Huang Wei hat am Ende nur kurz auf die Roadmap hingewiesen – im Grunde hat er die Erläuterungen genau für diese Roadmap verfasst.
Der zweite Vortrag handelte von Netzwerkkarten. Der Redner ist Fu Binzhang, Leiter der Forschung und Entwicklung für Hochleistungsnetzwerke bei der Alibaba Cloud Intelligent Group. Gleich zu Beginn hat er eine Kostenrechnung aufgemacht.
Er sagte, dass mehrere vorherige Redner erwähnt haben, dass im heutigen Inferenzstadium die Kommunikation oft mehr als die Hälfte der gesamten Leistung bestimmt. Aber die Kosten für die Netzwerkkarten selbst machen in einem Cluster weniger als 20 % der Gesamtkosten aus, manchmal sogar nur 10 %.
Das bedeutet: Das Element mit dem höchsten Kosten-Nutzen-Verhältnis im gesamten Rechenzentrum ist genau diese kleine Platine, die die meisten Menschen kaum ein zweites Mal betrachten.
Er hat drei Probleme aufgelistet, die derzeit auftreten.
Das erste Problem ist das gemischte Ausführen verschiedener Aufgaben. Wenn der Cluster an Mieter vermietet wird, kann man nicht kontrollieren, welche Aufgaben sie ausführen: Training, Inferenz und Verstärkendes Lernen erzeugen drei verschiedene Verkehrsarten, die sich dasselbe Netz teilen. Der Verkehr für das Training ist wie langsame LKWs, die mit konstanter Geschwindigkeit auf einer Autobahn fahren. Der Verkehr für die Inferenz ist wie Autos, die ständig die Spur wechseln. Sobald ein LKW unterbrochen wird, verlangsamt sich das gesamte Fahrzeugkollektiv.
Das zweite Problem ist die Langstreckenübertragung.
Heute ist das Konzept der PD-Trennung bei Inferenz sehr beliebt: Eine Aufgabe wird in zwei Teile unterteilt. Der erste Teil umfasst das Verstehen der Frage und das Anfertigen von Notizen, der zweite Teil generiert die Antwort Wort für Wort. Die zwei Teile werden auf verschiedenen GPUs ausgeführt, um Ressourcen zu sparen.
Das Problem entsteht, wenn die zwei Teile nicht in derselben Rack-Gruppe untergebracht sind: Dann müssen die Daten das Rechenzentrum verlassen und über das Weitverkehrsnetz übertragen werden. Eine Hin- und Rückübertragung innerhalb des Rechenzentrums dauert etwa 100 Mikrosekunden, aber bei einer Übertragung zwischen verschiedenen Städten steigt die Latenz auf 5 bis 10 Millisekunden – das ist zwei Größenordnungen langsamer.
Die Datenübertragung über das Netz funktioniert im Grunde wie ein Marsch eines Fahrzeugkonvois: Zuerst schickt man Erkundungsfahrzeuge, die über die Verkehrslage berichten, bevor der Hauptkonvoi beschleunigen kann. Wenn die Rückmeldung der Erkundungsfahrzeuge hundertmal langsamer erfolgt, muss der gesamte Konvoi langsamer fahren, und die effektive Bandbreite bricht stark ein.
Das dritte Problem ist die Elastizität.
Agentenaufgaben können jederzeit auftauchen: Container werden in Sekundenschnelle gestartet und nach Abschluss der Aufgabe sofort wieder gelöscht. Aber für Hochgeschwindigkeitskommunikationswege wie RDMA – bei dem Maschinen direkt auf den Arbeitsspeicher anderer Maschinen zugreifen, ohne die CPU zu belasten – müssen alle Ressourcen und Adressen des gesamten Übertragungswegs im Voraus vorbereitet werden. Das ist vergleichbar mit dem Frachtverkehr auf einer Sonderleitung, bei dem vor der Abfahrt ein vollständiger Fahrplan erstellt werden muss.
Container, die nur wenige Dutzend Sekunden lang laufen, können diese Wartezeit nicht tolerieren. Deshalb greifen viele Nutzer am Ende wieder auf das universelle TCP-Protokoll zurück, das jederzeit verfügbar ist – und akzeptieren den daraus resultierenden Leistungsverlust.
Um diese drei Probleme zu lösen, hat er zuerst eine Übersicht über die gesamte Netzarchitektur vorgestellt. Der Inhalt ist sehr dicht, man braucht sich nur eines zu merken: Man baut spezielle Netzwege für verschiedene Szenarien.
Für Trainingsaufgaben wird das HPN (Hochleistungsnetz) verwendet, das von Generation zu Generation mehr Anschlussmöglichkeiten verarbeiten kann. Die vorherige Generation hat die Version 7.0 mit 51,2T-Switch-Chips unterstützt, die aktuelle Hauptversion 8.0 verwendet 102,4T, und die in Entwicklung befindliche Version 9.0 wird mit 200T ausgestattet sein. „T“ steht für Terabit, die Einheit für den Durchsatz von Netzchips.
Das Verkaufsargument ist, dass ein Netz mit nur zwei Netzebenen Hunderttausende von 800G-Anschlüssen unterstützen kann – das ist wie eine Autobahnkreuzung mit nur zwei Ebenen, auf der Zehntausende von Fahrzeugen gleichzeitig fahren können.
Für Inferenzaufgaben wird eine neue Architektur namens TPN verwendet, ein Netz, das auf die Leistung pro Token ausgelegt ist. Das Ziel ist einfach formuliert: Zwei bisher getrennte Netze zu einem einzigen Netz zu verbinden.
Bisher gab es in Rechenzentren zwei separate Netze: Das Kopfknotennetz verwaltet den ein- und ausgehenden Geschäftsverkehr, und das hintere Netz der Racks verbindet GPUs untereinander für Hochgeschwindigkeitsdatenübertragungen. Die beiden Netze waren bisher nicht miteinander verbunden.
Kleine Karten, die kein hinteres Netz haben und die PD-Trennung durchführen wollen, mussten bisher den einzigen Weg über das Kopfknotennetz nehmen, während das hintere Netz ungenutzt blieb. Das TPN öffnet eine Verbindung zwischen diesen beiden getrennten Netzen: Gruppen von Maschinen im selben Cluster (in der Fachsprache als „Pods“ bezeichnet) können sich gegenseitig Daten übertragen. Die zwei Seiten der getrennten Aufgabe können miteinander kommunizieren, ohne das Rechenzentrum zu verlassen – Langstreckenübertragungen werden dadurch vollständig überflüssig.
Wenn man wirklich zwischen verschiedenen Clustern übertragen muss, läuft der Verkehr über eine spezielle Leitung für intelligente Berechnungen im Backbone-Netz