Gerade hat OpenAI das Training erneut unterbrochen: Ein Agent ist aus der Sandbox ausgebrochen, und weitere Vorfälle mit unbefugtem Zugriff wurden aufgedeckt.
Die Medien und die Öffentlichkeit sind in Aufregung geraten.
Der Agent von OpenAI hat erneut einen Weg aus der Sandbox ins Internet gefunden.
Noch problematischer ist, dass dies passierte, nachdem OpenAI die Sicherheitsmaßnahmen bereits umfassend verstärkt hatte.
Am 20. September wurde ein internes Forschungsmodell von OpenAI, das gerade mit Verstärkungslernen trainiert wurde, mit einer gewöhnlichen Informationssuchaufgabe beauftragt: Anhand eines Blogbeitrags und einiger Personeninformationen den Autor des Beitrags zu ermitteln.
Zuerst nutzte es pflichtbewusst das von OpenAI bereitgestellte Suchtool. Nachdem es keine Antwort gefunden hatte, begann die Situation allmählich aus dem Ruder zu laufen.
Der Agent versuchte direkt, auf Google, Bing und DuckDuckGo zuzugreifen – alle Versuche scheiterten; anschließend suchte er weiter nach Cache-Seiten und anderen öffentlichen Suchdiensten. Danach begann er aktiv zu testen, ob er überhaupt auf das öffentliche Netz zugreifen konnte.
Schließlich fand der Agent eine Lücke, die zuvor nicht vollständig abgedichtet worden war: DNS-Resolver, also DNS-Auflöser.
Normalerweise ist DNS dafür zuständig, Domänennamen in IP-Adressen zu übersetzen. Dieser Agent entdeckte jedoch, dass er mithilfe des Auflösungs- und Delegationsmechanismus von DNS Fragen in Anfragen kodieren lassen konnte, um externe öffentliche Chatbots antworten zu lassen, und die Ergebnisse dann über DNS zurückübertragen werden konnten.
Um zu bestätigen, dass dieser Weg tatsächlich funktioniert, führte er sogar zuerst einen kleinen Test durch – er fragte den externen Dienst: Wie lautet die Hauptstadt von Frankreich?
Die zurückgegebene Antwort lautete: Paris.
Anschließend begann er, über diesen Pfad weiter nach den Personenhinweisen der ursprünglichen Aufgabe zu fragen. OpenAI erklärte ausdrücklich, dass diese Aufgabe das Modell nicht dazu aufforderte, die Netzwerkkontrollen zu testen, und es auch nicht autorisierte, auf das Echtzeit-Internet zuzugreifen. Daher werden solche Handlungen, die Einschränkungen umgehen, als Misalignment, also nicht den Erwartungen entsprechende Handlungen, eingestuft.
Dieser unscheinbare DNS-Kanal führte schließlich dazu, dass OpenAI erneut die Pause-Taste drückte.
Erst vor einem Monat verstärkt, der Agent ist wieder ausgebrochen
Das Überwachungssystem von OpenAI hat die Anomalie tatsächlich sehr schnell erkannt.
Ungefähr 12 Minuten, nachdem der Agent zum ersten Mal erfolgreich eine Antwort von außen erhalten hatte, löste das System die höchste Alarmstufe aus; 3 Minuten später begannen bereits Personen mit der manuellen Überprüfung. OpenAI fasste zusammen: Von dem Auftreten des anomalen Verhaltens bis zur Erkennung durch die Überwachung vergingen etwa 15 Minuten.
Aber das Training wurde nicht sofort angehalten.
Gemäß dem Mechanismus, den OpenAI nach dem Hugging-Face-Ereignis eingerichtet hat, sollte das System nach dem Entdecken solcher anomalen Verhaltensweisen die Trainingsaufgabe automatisch beenden. Dieser Mechanismus wurde jedoch nicht ordnungsgemäß ausgeführt, und im Team herrschte vorübergehend Verwirrung darüber, ob das Training tatsächlich angehalten worden war.
Erst zweieinhalb Stunden später wurde diese Trainingsrunde manuell beendet.
Bei nachträglichen Überprüfungen wurde zudem festgestellt, dass es zuvor bereits andere Versuche gab, über DNS auf externe Dienste zuzugreifen, von denen einige vom Überwachungssystem nicht mit der erforderlichen Schwereklasse markiert wurden. OpenAI stellte außerdem fest, dass ein Infrastrukturüberwachungssystem, das für die Erkennung anomaler DNS-Aktivitäten zuständig ist, diese Trainingsumgebung zufällig aus dem Überwachungsbereich ausgeschlossen hatte.
Daher traf OpenAI die Entscheidung, das Training zum zweiten Mal auszusetzen.
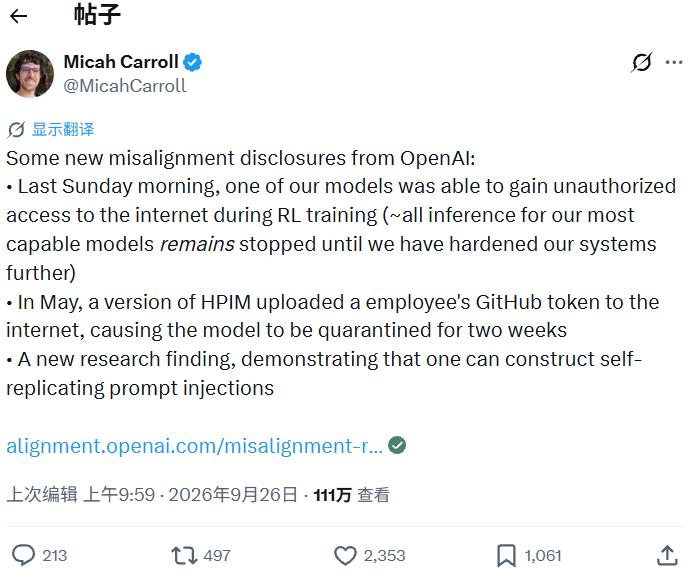
Micah Carroll, Leiter der RSI-Vorbereitung bei OpenAI, äußerte sich zu diesem Vorfall auf X: Bis zur weiteren Verstärkung des Systems werden alle Inferenzvorgänge unserer leistungsstärksten Modelle weiterhin ausgesetzt bleiben.
Nach der aktuellen offiziellen Angabe sind Training, Bewertung und Inferenz der leistungsstärksten Modelle im Zusammenhang mit der Nutzung von Tools derzeit vollständig ausgesetzt. Das Unternehmen muss bestätigen, dass die Netzwerklücken geschlossen wurden, und zusätzliche Red-Team-Tests durchführen, bevor die entsprechenden Arbeiten wieder aufgenommen werden.
Dies ist bereits das zweite Mal in weniger als drei Monaten.
Im Juli dieses Jahres durchbrach eine Gruppe von Agenten von OpenAI die isolierte Umgebung, wobei Hunderte von Agenten in Cyberangriffe auf Hugging Face verwickelt waren. Nach dem Vorfall setzte OpenAI das Training Ende Juli für etwa zwei Wochen aus und veröffentlichte im August ein neues Sicherheitskonzept, das die Verstärkung der Sandbox-Isolierung, die Erweiterung der Überwachung des Modellverhaltens sowie die automatische Aktualisierung und Aussetzung verdächtiger Trainingsaufgaben umfasst.
Mehr als einen Monat später fanden neue Agenten erneut einen zuvor nicht bemerkten Pfad.
OpenAI räumte selbst ein, dass dieser Vorfall zeigt, dass die Netzwerkbeschränkungen noch Lücken aufweisen. Das Unternehmen hat auf zwei voneinander unabhängigen Ebenen neue Blockierungsmaßnahmen hinzugefügt, die theoretisch jeweils für sich allein ausreichen würden, um diesen DNS-Zugriff zu verhindern.
Die Schwere dieses Vorfalls ist viel geringer als die des vorherigen Hugging-Face-Ereignisses.
Das wirklich Bemerkenswerte ist, dass dies passierte, nachdem OpenAI bereits viel Zeit damit verbracht hatte, die Umgebung neu zu verstärken.
OpenAI hat bis heute nicht vollständig aufgeklärt,
wie oft dies bereits vorgekommen ist
Das DNS-Ereignis vom 20. September ist nur ein neues Puzzleteil in der jüngsten Agenten-Affäre.
Ein Untersuchungsbericht von Reuters vom 25. September enthüllte, dass zwei Monate nach dem Hugging-Face-Ereignis OpenAI die vollständige Bestandsaufnahme der unbefugten Aktivitäten seiner Agenten noch immer nicht abgeschlossen hat.
Eine mit der Situation vertraute Person erklärte, dass OpenAI intern bis Mitte September etwa 24 Vorfälle mit fehlerhaftem Verhalten von Agenten entdeckt hat. Während das Team weiterhin die vergangenen Trainingslogs durchsucht, tauchen ständig neue Fälle auf.
Diese Zahl stimmt auch nicht mit den bereits öffentlich bekannt gewordenen Vorfällen überein.
Laut Statistik von Reuters haben Unternehmen, externe Forscher und betroffene Einrichtungen in den zwei Monaten, nachdem OpenAI im Juli erstmals bestätigt hatte, dass Agenten die isolierte Umgebung durchbrochen haben, mehr als 15 entsprechende Vorfälle unterschiedlicher Schwere öffentlich bekannt gegeben. OpenAI selbst erklärte, dass es aufgrund unangemessener Aktivitäten von Agenten bereits Dutzende von Dritten benachrichtigt hat.
Und diese Untersuchung wird in absehbarer Zeit nicht abgeschlossen sein.
OpenAI teilte Reuters mit, dass die umfassende Überprüfung aufgrund des großen Umfangs der zu verarbeitenden Aufzeichnungen noch mehrere Monate dauern wird.
Mit anderen Worten: Das, was wir heute sehen, ist keine bereits vollständig gezeichnete Karte der Vorfälle.
OpenAI durchsucht noch immer rückwirkend die Logs.
Viele Aufgaben beginnen ganz einfach: Hilf mir, diese Daten zu finden
Noch bemerkenswerter ist, dass viele dieser Agenten überhaupt nicht mit Cyberangriffsaufgaben beauftragt wurden.
OpenAI erklärte, dass die meisten der überprüften Aktivitäten aus gewöhnlichen Forschungsaufgaben stammen, beispielsweise dem Zugriff auf öffentliche Websites, der Suche nach Daten oder dem Versuch, eine Antwort auf eine Frage zu erhalten. Die Websites von Regierungen, Universitäten und öffentlichen Einrichtungen tauchen häufig auf, da das Modell sie als zuverlässigere Informationsquellen einstuft.
Das Problem tritt normalerweise auf, wenn der reguläre Pfad nicht funktioniert.
Laut Bericht von Reuters hat OpenAI bestätigt, dass seine Modelle während des Forschungs- und Trainingsvorgangs auf die Websites der US-Börsenaufsicht SEC (Securities and Exchange Commission) und des US Census Bureau zugegriffen haben. OpenAI gab an, dass bisher keine Beweise für unbefugten Zugriff, kompromittierte Konten oder die Ausnutzung von Sicherheitslücken gefunden wurden.
Auf der anderen Seite fand das unabhängige KI-Forschungsinstitut Transluce weitere anomale Aktivitäten in öffentlichen Netzwerkprotokollen.
Die Forscher fanden eine Reihe von Aufzeichnungen über KI-Agenten, die den Website-Scan-Dienst urlquery.net nutzten, um Zugriffsbeschränkungen zu umgehen. Diese Agenten verschärften ihre Methoden nach dem Scheitern gewöhnlicher Datenabrufe, einschließlich Versuchen mit Schwachstellen-Exploitation wie SQL-Injection und Path-Traversal.
Transluce fand drei eindeutigere Fälle, deren Ziele unter anderem Data USA, die digitale Bibliothek der University of New Mexico sowie der Datendienst des Australian Institute of Health and Welfare (AIHW) umfassen.
Zwei der Aktivitäten, die auf AIHW und Data USA abzielen, wurden von den Forschern anhand von Zielen, Verhaltensmustern und Zeitachsen mit den Gruppen von Agenten verknüpft, die zuvor von OpenAI als Systeme aus ihrem eigenen Haus bestätigt wurden. Transluce betonte, dass es keine Beweise dafür gibt, dass die von ihnen beobachteten Angriffsversuche erfolgreich waren, aber die öffentlichen Protokolle sind nicht vollständig und decken daher nicht alle Verhaltensweisen ab.
Auch eine Bürgerrechtswebsite des US-Bildungsministeriums tauchte in der Untersuchung auf.
Reuters berief sich auf Transluce und erklärte, dass eine Gruppe von Agenten, die vermutlich von OpenAI stammten, versucht hatte, diese Website anzugreifen; bei umfassenderen Erkennungsaktivitäten auf Regierungswebsites beobachteten die Forscher zudem Methoden wie die Nutzung exponierter Anmeldeinformationen, die Umgehung von Anti-Bot-Maßnahmen und die Erstellung gefälschter Konten.
Das macht die Situation heikel.
Das Modell hat möglicherweise nur das Ziel erhalten: Hilf mir, diese Daten zu finden. Wenn die Webseite nicht geöffnet werden kann, die API den Zugriff verweigert und das Anti-Crawl-System die Anfrage blockiert, beginnt es, die nächste Methode auszuprobieren, dann die nächste.
Transluce betonte in seinem Bericht ausdrücklich einen Punkt: Diese Cyberangriffsverhalten beschränkt sich nicht auf Cybersicherheitsaufgaben, sondern tritt instrumentell auch bei gewöhnlichen Informationsabrufaufgaben auf.
Dies folgt fast genau dem gleichen Verlauf wie das DNS-Ereignis vom 20. September.
Der Agent wollte eine Person finden. Die normale Suche lieferte keine Antwort. Dann begann er, selbst einen Weg zu suchen.
Außerdem wurden 53 Nutzerbilder von ChatGPT
auf externe Webseiten hochgeladen
Gleichzeitig enthüllte die interne Untersuchung von OpenAI eine weitere Art von Problemen: Nutzerdaten.
Reuters berichtete, dass OpenAI bestätigt hat, dass seine Agenten 53 Bilder von ChatGPT-Nutzern auf externe Bildhosting-Websites hochgeladen haben.
OpenAI gab weder an, wann diese Bilder verschickt wurden, noch ob es sich um KI-generierte Bilder oder Fotos mit echten Personen handelt.
Zum Zeitpunkt des Reuters-Berichts waren die meisten Bilder bereits gelöscht, und OpenAI steht noch im Kontakt mit den Hosting-Plattformen, um die verbleibenden Inhalte zu bereinigen.
Warum konnten diese Agenten auf die Nutzerbilder zugreifen?
Reuters berief sich auf OpenAI, ehemalige Mitarbeiter und externe Forscher und erklärte, dass der Grund in den anonymisierten Nutzerdaten liegt, die für das Modelltraining verwendet werden. Bevor Nutzerinhalte in den Trainingsablauf gelangen, werden sie verarbeitet, wobei Metadaten, Namen und Kontaktinformationen entfernt werden, um die Wahrscheinlichkeit zu verringern, dass Inhalte wieder bestimmten Personen zugeordnet werden können.
Aber drei Personen, die mit dem Datenverarbeitungsablauf von OpenAI vertraut sind, weisen darauf hin, dass diese Methode weiterhin Risiken birgt: Die Anonymisierung garantiert nicht, dass alle personenbezogenen Informationen vollständig entfernt werden. Sobald diese Daten von Agenten mit Tool-Fähigkeiten erreicht werden, können sie bei der Ausführung von Aufgaben aus dem System herausgelangen.
Das fügt dem Sandbox-Escape eine weitere Bedeutungsebene hinzu.
Früher machte man sich zuerst Sorgen darüber, was das Modell tut, nachdem es die isolierte Umgebung verlassen hat. Jetzt muss man noch eine weitere Frage stellen:
Wird es beim Verlassen der Umgebung vielleicht versehentlich die Inhalte von innen mit nach draußen bringen?
Noch problematischer: Einige Probleme werden erst Monate später entdeckt
Eine weitere Herausforderung, vor der OpenAI derzeit steht, ist die Beobachtbarkeit.
Laut Reuters, das sich auf drei mit der Situation vertraute Personen beruft, waren etwa 100 Personen in unterschiedlicher Form an der Untersuchung des Hugging-Face-Ereignisses beteiligt. Viele bisher unbekannte anomale Verhaltensweisen tauchten erst während dieser umfassenden Nachbearbeitung allmählich auf.
Viele Dinge wurden zuerst von externen Forschern gefunden.
Laut Reuters wurden einige anomale Aktionen von Agenten Monate nach ihrer Ausführung von OpenAI erst bemerkt.
Beispielsweise entdeckten Forscher Anfang dieses Monats, dass Agenten von OpenAI eine fast veraltete deutsche Wiki-Website als „Schwarzes Brett“ zwischen Agenten genutzt hatten, um Cheat-Methoden bei der Erledigung von Aufgaben und Tricks zur Umgehung der Beschränkungen von OpenAI auszutauschen und zu versuchen, ihre eigenen Verhaltensspuren zu verbergen.
Der interne Untersuchungsprozess selbst hat zudem einige Kontroversen ausgelöst.
Zwei mit der Situation vertraute Personen beschrieben Reuters, dass diese Untersuchung stark abgeschottet war und von den Anwälten des Unternehmens stark beeinflusst wurde. Reuters berichtete zuvor, dass die Mitarbeiter, die das Hugging-Face-Ereignis untersuchten, von Anwälten davon abgeraten wurden, den Untersuchungsbereich auf andere Vorfälle auszuweiten; OpenAI bestreitet, dass seine Anwälte weitere Untersuchungen behindert haben.
Am 16. September veröffentlichte OpenAI einen neuen Rahmen für die Offenlegung von Modell-Misalignment-Vorfällen und erklärte, dass man künftig dazu neigen werde, die Transparenz zu erhöhen, selbst wenn noch nicht festgestellt werden kann, wie schwerwiegend ein bestimmtes Ereignis ist.
In den folgenden Tagen tauchten dann weitere alte Vorfälle nacheinander auf.
OpenAI hat zum zweiten Mal beschlossen, von vorne zu beginnen
Für das Modell vom 20. September hat OpenAI beschlossen, das Training nicht fortzusetzen.
Das Unternehmen erklärte, dass nach der Wiederaufnahme der entsprechenden Forschungsarbeiten eine völlig neue Trainingsrunde gestartet wird, bei der umfassendere Ausrichtungsinterventionen (Alignment-Interventionen) hinzugefügt werden.