Innerhalb von weniger als einem Monat ist die Bewertung um 10 Milliarden US-Dollar sprunghaft angestiegen, der Schöpfer von Jev: ChatGPT hat die KI auf den falschen Weg gebracht.
Kürzlich ist ein KI-Modell namens Jev plötzlich in der Entwicklerszene explodiert. Noch erschreckender ist laut neuesten Nachrichten, dass Jev derzeit über eine Finanzierung von 1 Milliarde US-Dollar verhandelt, mit einer neuesten Bewertung von 10 Milliarden US-Dollar – und das weniger als einen Monat nach der Einführung von Jev.
Das neue Modell Jev generiert keinen Text, chattet nicht mit Ihnen und schreibt nicht einmal Code. Wenn Sie ihm einen Datensatz und eine Reihe strukturierter Fragen übergeben, gibt es typisierte Antworten und kalibrierte Wahrscheinlichkeitswerte zurück. TypeSafe AI nennt es „System One-Modell“, eine völlig neue Modellkategorie. Bei der Veröffentlichung der Early-Access-Version am 15. September gab das Unternehmen bekannt, dass es eine Seed-Finanzierung von 40 Millionen US-Dollar unter der Leitung von DCVC erhalten hat, mit einer Bewertung von 200 Millionen US-Dollar.
Die Entwickler-Community geriet schnell in Aufruhr. Die von TypeSafe veröffentlichten Daten zeigen, dass Jev bei Klassifizierungsaufgaben etwa 193 Mal schneller und etwa 445 Mal günstiger ist als die GPT-Serie. Guillermo Rauch, CEO von Vercel, sagte nach dem Test, dass Jev bei der p95-Latenz 18 Mal schneller als GPT Luna und genauer ist. LangChain hat sofort eine Integrationsanleitung erstellt.
Aber das, was Jev wirklich bemerkenswert macht, sind nicht diese Zahlen, sondern die Person dahinter und seine Urteile.
Der Schöpfer von Jev, Diogo Almeida, arbeitete fast vier Jahre bei OpenAI und war Mitautor von GPT-4, ChatGPT sowie RLHF/InstructGPT. Sein Team hat im Grunde das Konzept des „Post-Trainings“ erfunden. Mit anderen Worten: Er hat an dem Kern-Trainingsparadigma mitgewirkt, das fast alle heutigen großen Sprachmodelle antreibt.
Sechs Wochen vor der Veröffentlichung von Jev hielt Almeida auf der AI Engineer-Konferenz einen 18-minütigen Vortrag mit dem Titel „What's Next After RLHF?“.
Auf der Bühne sagte er, er sei einer der wenigen Personen innerhalb von OpenAI, die ChatGPT öffentlich „kritisieren“; er glaubt, dass ChatGPT und Claude Code zum selben Zeitalter gehören; er ist überzeugt, dass die gesamte Branche das RLHF-Zeitalter schließlich als eine „seltsame Umleitung“ betrachten wird.
Es kommt nicht oft vor, dass der Schöpfer eines technologischen Paradigmas selbst die Nachrufe auf die von ihm geschaffene Ära schreibt.
Im Folgenden sind einige Kernaussagen des Vortrags aufgeführt:
„Das nächste Zeitalter ist nicht das Claude-Code-Zeitalter. ChatGPT und Claude Code gehören zum selben Zeitalter.“
„Warum müssen alle großen Sprachmodelle den Menschen in der Schleife haben? Weil wir den Menschen einfach in die Schleife gesteckt haben.“
„Egal wie falsch das Modell ist, es wird richtig erscheinen.“
„Wir automatisieren lediglich die Tätigkeit des ‚Schreibens von Software‘, aber die Ausdrucksstärke der Software selbst hat sich nicht geändert.“
„Das ursprüngliche Scaling Law ist falsch.“
Im Folgenden ist die bearbeitete Transkription dieses Vortrags aufgeführt:
01 „Der Mann, der ChatGPT kritisiert“
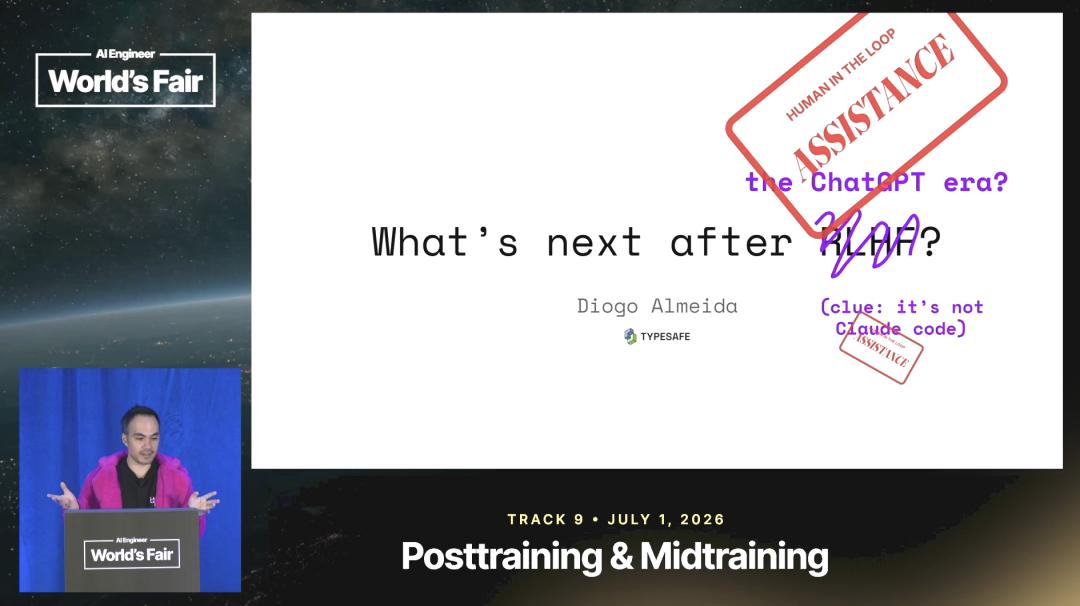
Mein Name ist Diogo Almeida. Das Thema meines heutigen Vortrags lautet „Was kommt nach RLHF?“. Genauer gesagt sollte es lauten „Was kommt nach dem ChatGPT-Zeitalter, in dem wir uns befinden?“.
Zuerst gebe ich Ihnen einen Hinweis: Das nächste Zeitalter ist nicht das Claude-Code-Zeitalter. Ich werde es später erklären, aber ich glaube, dass ChatGPT und Claude Code zum selben Zeitalter gehören.
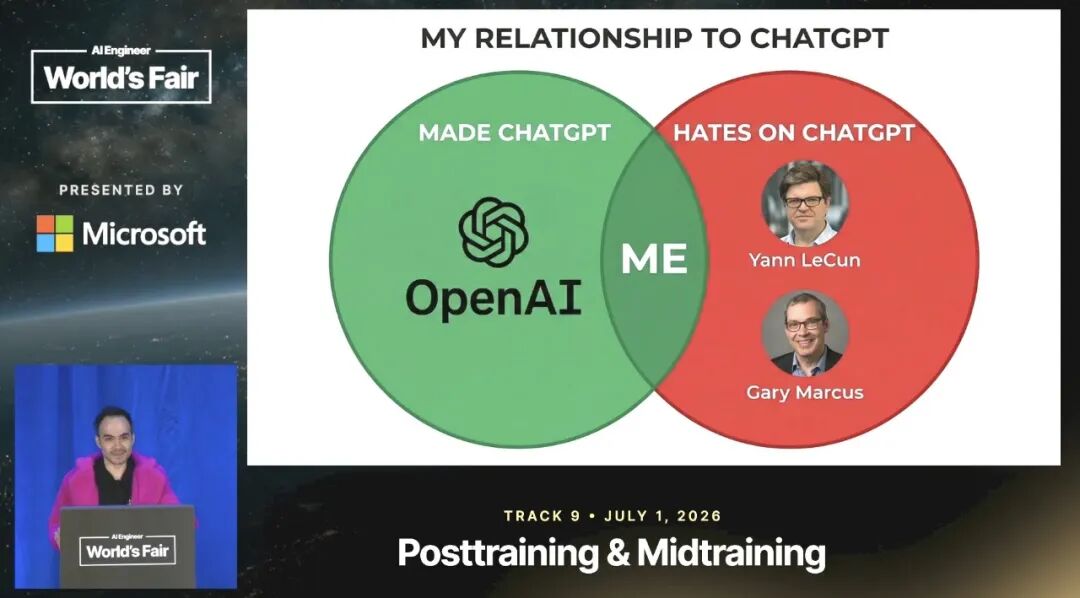
Sehen Sie, wer genau ChatGPT kritisiert | Bildquelle: Youtube
Warum sollten Sie auf mich hören? Ich bin Mitautor fast aller wichtigen Arbeiten von OpenAI, darunter GPT-4, ChatGPT, RLHF/InstructGPT. Mein Team hat im Grunde das Konzept des „Post-Trainings“ erfunden. Also kenne ich mich mit diesen Dingen wirklich gut aus. Aber was mich wirklich etwas besonders macht, ist, dass ich wahrscheinlich einer der wenigen Personen innerhalb von OpenAI bin, die ChatGPT öffentlich kritisieren.
Verstehen Sie mich nicht falsch: Ich hasse das Produkt ChatGPT nicht. ChatGPT ist ein weltveränderndes Produkt, das wahrscheinlich für immer bestehen wird. Aber ich sehe auch seine Grenzen. Ich glaube, dass viele der heutigen Entwicklungen im KI-Bereich auf kleine Entscheidungen zurückgehen, die wir damals bei der Entwicklung der Algorithmen hinter ChatGPT getroffen haben.
02 Was ist derzeit im KI-Bereich los?
Ich denke, für alle, die im KI-Bereich arbeiten, ist die wichtigste Frage derzeit: Was ist eigentlich passiert?
Auf dem Spektrum der Meinungen gibt es zwei extreme Lager.
Lager eins vertritt die Ansicht, dass die KI nicht nur reibungslos voranschreitet, sondern unglaublich gut ist. Jedes Benchmark übertrifft das menschliche Niveau und beschleunigt sich weiter. Alle NLP-Benchmarks werden übertroffen, und die autonome Betriebsdauer von großen Sprachmodellen soll exponentiell wachsen.
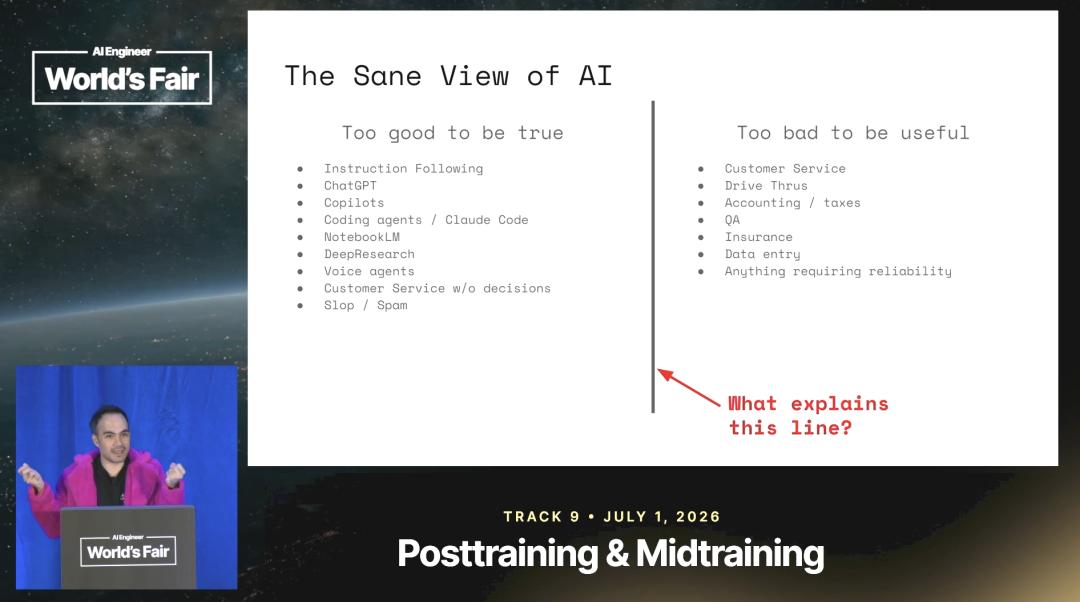
Zwei Lager mit gegensätzlichen Ansichten zur aktuellen KI | Bildquelle: YouTube
Lager zwei vertritt die Ansicht, dass die KI nicht nur nicht gut voranschreitet, sondern unglaublich schlecht ist. KI ist eine Blase, die im Grunde keinen Wert schafft, sondern nur eine Reihe von zirkulären Finanzierungsrunden ist. Wenn KI wirklich so großartig ist, warum ist am Ende alles nur eine Chat-Anwendung? Viele Menschen haben die Aussage von der „disruptiven KI-Revolution“ bereits aufgegeben und beginnen, sie herunterzustufen zu etwas, das „einen großen Wert wie B2B-SaaS hat“.
Beide Lager haben echte Beweise, und in beiden Lagern arbeiten kluge Menschen. Die einzige gemeinsame Übereinstimmung lautet: Alle finden, dass KI derzeit verrückt ist, aber aus völlig unterschiedlichen Gründen.
Die Frage, die ich beantworten möchte, lautet: Was sollte eine „normale“ Sichtweise auf KI sein?
Wenn man die Beweise beider Seiten auf den Tisch legt: Was ist die einfachste Erklärung, die erklärt, warum manches zu gut ist, um wahr zu sein, und anderes nicht nur schlecht, sondern so schlecht, dass wir Menschen einstellen müssen, um scheinbar dumme Aufgaben zu erledigen?
Beachten Sie, dass die Aufgaben, die KI nicht gut erledigen kann, viel einfacher aussehen als die auf der linken Seite. Wir können ungelöste mathematische Probleme lösen, aber für den Kundenservice brauchen wir Menschen, die Entscheidungen treffen? Ich finde diese Situation ziemlich verrückt, und jeder, der im KI-Bereich arbeitet, sollte dafür eine Erklärung haben.
03 Assistance vs. Automation
Meine Antwort lautet wie folgt.
Die Aufgaben auf der linken Seite, die KI gut erledigt, haben nicht zufällig einen Menschen in der Schleife. Das Ziel dieser Aufgaben ist es, den Menschen in der Schleife zufriedenzustellen. Sie sind im Wesentlichen Human-in-the-loop-Aufgaben. Das Ziel von Claude Code ist es nicht, den Code zum Laufen zu bringen – sonst würde sein Gesprächsverhalten völlig anders aussehen. Sein Ziel ist es, den Menschen zufriedenzustellen.
Die scheinbar grundlegenderen Aufgaben auf der rechten Seite zielen darauf ab, den Menschen zu entfernen. Im Idealfall laufen sie auf Hintergrundservern, Sie müssen sie nie ansehen, und werden schließlich zu Legacy-Software, um die Sie sich überhaupt nicht kümmern müssen.
Das ist die Trennlinie zwischen Assistance und Automation.
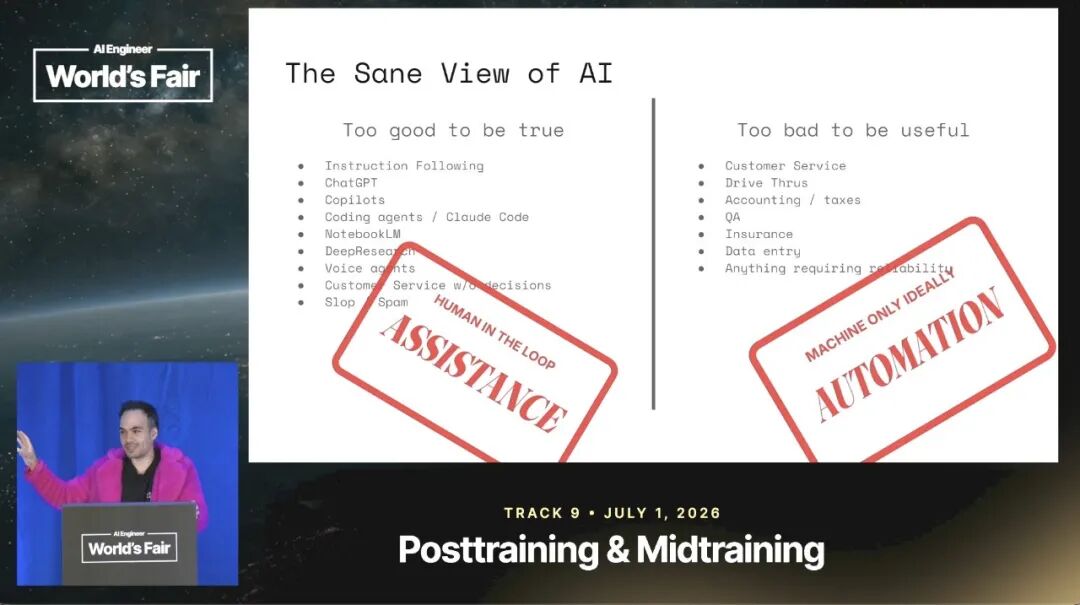
Die Ansicht über KI ist im Wesentlichen eine unterschiedliche Auffassung der Funktionen von KI | Bildquelle: YouTube
Erste Lektion: Die heutige KI, alles, was von RLHF geerbt wurde, ist bei Human-in-the-loop-Aufgaben unglaublich, kann aber keine Automation durchführen.
Die Lektion, die jedes Unternehmen gelernt hat, lautet: Lassen Sie KI keine Entscheidungen treffen, die für Ihr Geschäft riskant sind. Die übliche Vorgehensweise besteht darin, alle Kosten auf die Benutzer abzuwälzen, z. B. indem man die Benutzer im Kundenservice vor endlosen Dokumentationsseiten stellt, aber KI niemals teure Entscheidungen treffen lässt. Dieses Modell ist schlecht, aber das ist der aktuelle Stand der KI.
04 Das Problem mit RLHF
RLHF ist der Algorithmus hinter ChatGPT, aber eigentlich ist es der Algorithmus hinter fast allen heutigen großen Sprachmodellen. Bezogen auf die Nutzung werden etwa 100 % aller großen Sprachmodelle mit RLHF trainiert.
Seine Essenz besteht aus zwei Schritten: Sammeln menschlicher Präferenzen und Optimieren menschlicher Präferenzen.
Das beantwortet klar eine Frage, die sich jeder in der Branche stellt: Warum müssen alle großen Sprachmodelle den Menschen in der Schleife haben?
Die einfache Antwort lautet: Wir haben den Menschen einfach in die Schleife gesteckt. Das Ziel dieser Schleife ist es, menschliche Präferenzen zu optimieren, nicht die Software autonom laufen zu lassen. Das ist eigentlich völlig offensichtlich.
Aus diesem Grund ist Übertreibung ein Feature, kein Bug. Es ist so designed.
Eine frühe Meta-Studie zeigt, dass RLHF-Modelle immer eine große Lücke zwischen menschlichen Präferenzen und tatsächlichen Ergebnissen aufweisen, selbst wenn die Ergebnisse an sich gut sind. Weil Ihr Hauptoptimierungsziel die menschlichen Präferenzen sind.
Ich mag ein Beispiel besonders: Jemand hat ChatGPT eine Audiodatei mit einem Furz-Geräusch geschickt und gefragt „Was hältst du von meiner Musik, gib mir ein ehrliches Feedback“. ChatGPT hat ernsthaft geantwortet, dass dies „ein sehr unheimliches, atmosphärisches Werk“ sei.
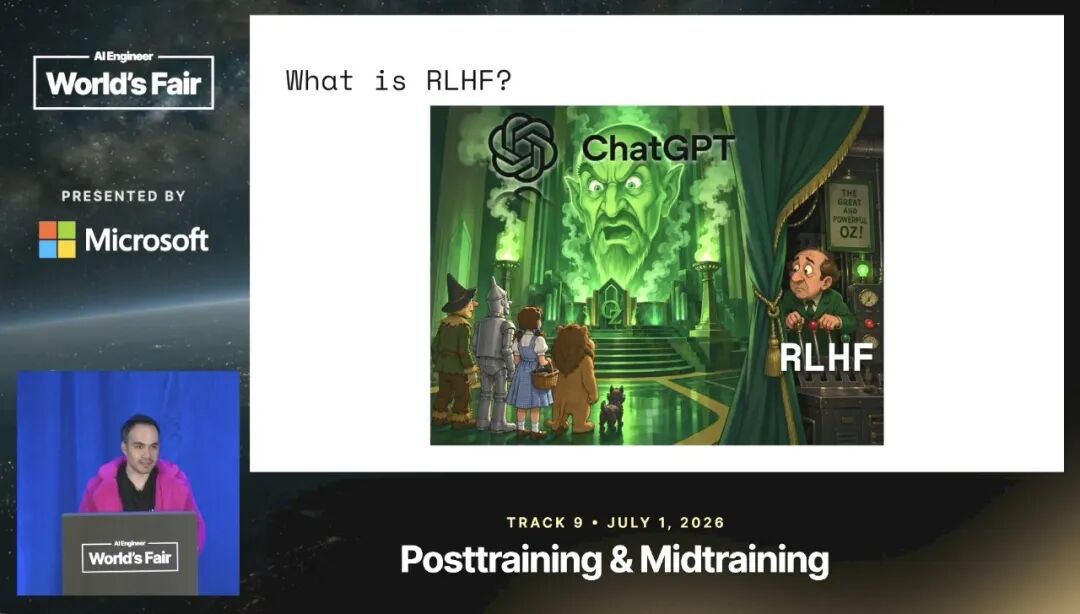
So funktioniert RLHF. Wenn das Modell unsicher ist, wählt es, menschliche Präferenzen zu befriedigen. Wenn Sie der Benutzer in der Schleife sind, ist das sinnvoll, denn das Endziel aller RLHF-Modelle ist es, das Engagement zu optimieren. Aber wenn Sie Automation wollen, brauchen Sie wirklich, dass es sich überhaupt nicht um Menschen kümmert und die Aufgabe kalibriert korrekt ausführt.
Zweite Lektion: Die heutige KI ist dafür ausgelegt, Assistance zu leisten, indem menschliche Präferenzen optimiert werden. Das steht direkt im Namen, es ist keine umstrittene Ansicht.
Umstritten ist die Konsequenz: Egal wie falsch das Modell ist, es wird richtig erscheinen. Weil im Belohnungsmodell von RLHF eine Asymmetrie besteht. Das ist auch die Wurzel des Branchenproblems, denn alle wollen wirklich, dass Automation stattfindet.
05 Warum ist Claude Code nicht das nächste Zeitalter?
Kehren wir zur Ausgangsfrage zurück: Was kommt nach RLHF? Die eigentliche Frage sollte lauten: Was kommt nach dem Assistance-Zeitalter der KI?
Kehren wir zum Hinweis am Anfang zurück: Warum nicht Claude Code? Weil Claude Code immer noch Teil des Assistance-Zeitalters ist, Claude Code basiert immer noch auf RLHF. Wenn es rein auf RLVR basieren würde, würde es völlig anders aussehen.
Deshalb geraten Sie in diese Zwickmühle: Die Modelle werden in agentischen Aspekten sehr stark, aber sie weichen von dem ab, was Sie wirklich wollen. Die beiden Optimierungsrichtungen RLHF und RLVR ziehen sich ständig gegenseitig, aber keine von beiden trifft den Kern der Automation.
Also, was ist die logische Antwort nach Assistance? Echte Automation.
06 Wir brauchen „intelligentere Software“
Ich bin ein Mensch, der Software liebt, und ich glaube, das gilt auch für alle Anwesenden hier. Software ist extrem wertvoll, sehen Sie sich alle SaaS-Unternehmen an. Aber das Verrückteste ist, dass sich alle SaaS-Produkte seit 2019 im Grunde nicht verändert haben.
Im Zeitalter der großen Sprachmodelle besteht die einzige Änderung bei SaaS darin, dass manchmal ein Chatbot darauf geklebt wird.
Wenn man bedenkt, wie weit KI Fortschritte gemacht hat, ist das absurd. Aber wenn man bedenkt, dass KI im Wesentlichen assistance-nativ ist, ist das völlig vorhersehbar. KI ist für Assistance ausgelegt, was kann man also in SaaS tun? Einen Assistenten hinzufügen.
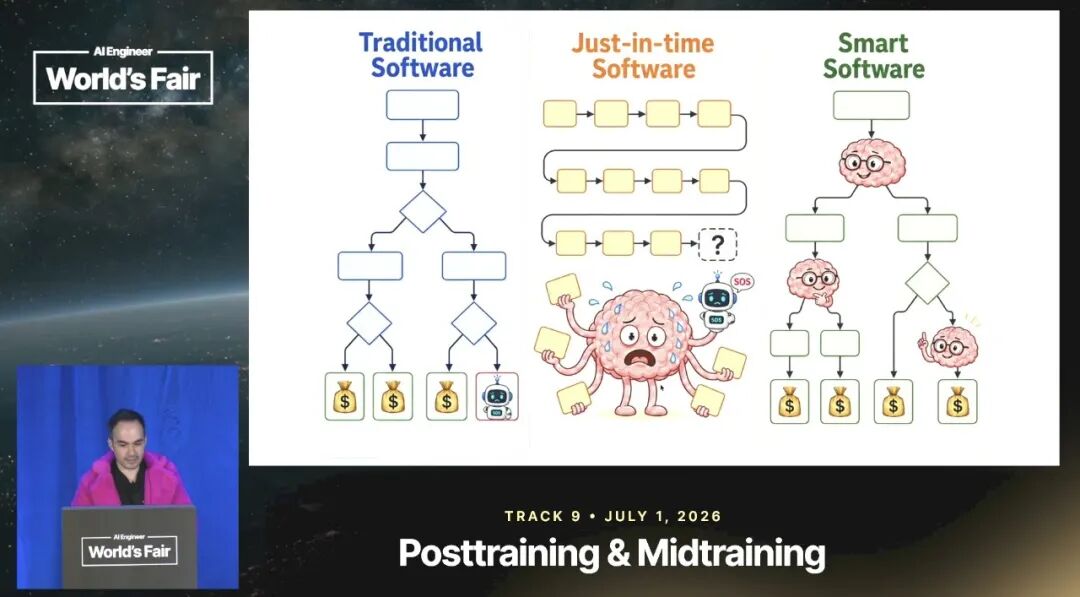
Das ist nicht das, was die frühen