KI-geschriebene wissenschaftliche Arbeit fliegt auf? Sobald der Chefredakteur einer Top-Fachzeitschrift nachfragt, kann der Autor überhaupt nichts beantworten.
Redaktion | Panda
Du hast eine wissenschaftliche Arbeit verfasst, und jetzt werden dir drei Fragen gestellt: Was ist die Problemstellung dieser Arbeit? Was bedeutet dieses Symbol? In welchem Teil des Haupttextes wird die im Abstract genannte Schlussfolgerung gestützt?
Wenn die Arbeit wirklich von dir geschrieben wurde, sind diese Fragen ganz einfach und du kannst sie sogar ohne Vorbereitung beantworten.
Aber in einem kürzlich durchgeführten kleinen Experiment der Zeitschrift für maschinelles Lernen TMLR (Transactions on Machine Learning Research) konnten die Autoren von drei Arbeiten diese grundlegenden Fragen nicht einmal beantworten.
Am 16. September veröffentlichte TMLR auf ihrem offiziellen Blog einen Artikel mit dem Titel «Fragen an Autoren zu ihren eigenen Arbeiten», verfasst von Nihar B. Shah, einem der Chefredakteure der Zeitschrift von der Carnegie Mellon University (CMU). Während seiner zweiwöchigen Amtszeit als vertretender Chefredakteur wählte er 10 Einreichungen aus, die ursprünglich direkt ohne Begutachtung abgelehnt werden sollten, lehnte sie nicht sofort ab, sondern vereinbarte nacheinander Gespräche mit den Autoren. Am Ende wurden alle 10 Arbeiten trotzdem abgelehnt.
https://medium.com/@TmlrOrg/asking-authors-about-their-own-papers-3d2e04e5dee0
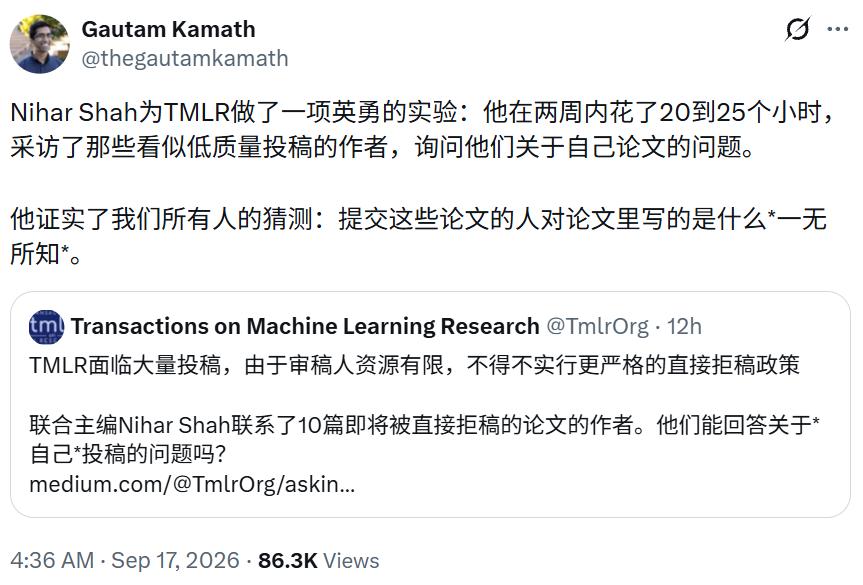
Gautam Kamath, ebenfalls Chefredakteur von TMLR, teilte den Beitrag auf 𝕏 und nannte ihn ein «mutiges Experiment». Er fügte hinzu, dass es die Vermutung bestätige, die viele Menschen schon lange haben: Ein Teil der Einreichenden weiß tatsächlich nicht, was in ihrer eigenen Arbeit steht.
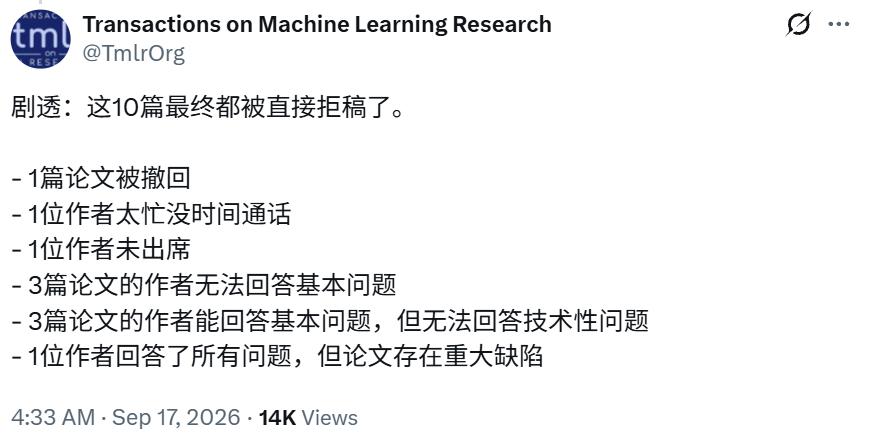
Stichprobenartige Prüfung von 10 zur Ablehnung vorgesehenen Arbeiten: alle wurden abgelehnt
Laut der Beschreibung von Shah fand das Experiment während seiner Amtszeit als vertretender Chefredakteur vom 14. bis 28. August 2026 statt. Er wählte informell 10 Arbeiten aus den zur direkten Ablehnung vorgesehenen Einreichungen aus und schickte den Autoren über die Begutachtungsplattform OpenReview eine kurze Nachricht: Ein Chefredakteur möchte vor der Weiterleitung zur Begutachtung mit Ihnen sprechen, um die Arbeit besser zu verstehen. Bitte teilen Sie uns per E-Mail mit, wann Sie Zeit für ein Gespräch haben.
Nach dem Versenden der Nachricht entwickelte sich die Situation schnell unterschiedlich: Der Autor einer Arbeit zog die Einreichung direkt zurück; ein Autor antwortete, dass er zu viele Aufgaben habe und keine Zeit für ein Gespräch habe; die übrigen 8 vereinbarten einen Termin, aber einer der Autoren erschien nicht zum vereinbarten Zeitpunkt.
Am Ende trafen sich 7 Autoren von Arbeiten mit Shah. Sie hatten unterschiedliche Hintergründe, darunter Bachelorstudenten, Masterstudenten, Doktoranden, Hochschullehrer und unabhängige Forscher. Die meisten dieser Arbeiten waren Ein-Personen-Arbeiten, aber nicht alle.
Die Fragen von Shah gliederten sich in zwei Kategorien: Die eine Kategorie umfasste grundlegende Fragen zur Problemstellung, zu Symbolen und zu den in der Arbeit behaupteten Ergebnissen, die andere Kategorie detaillierte Fragen zu spezifischen technischen Ausdrücken, theoretischen Ergebnissen und Entscheidungen bei der Gestaltung von Experimenten.
Bei den 7 Gesprächen konnte nur der Autor einer Arbeit alle Fragen beantworten. Weitere 3 Autoren konnten die übergeordnete Idee erläutern, gerieten aber bei Nachfragen zu technischen Details in Schwierigkeiten. Am schlimmsten war es bei den anderen 3 Arbeiten: Die Autoren konnten nicht einmal die grundlegenden Fragen beantworten, und alle 3 waren Ein-Personen-Arbeiten.
Shah schrieb, dass zwei dieser Autoren fast kein tatsächliches Verständnis für den Inhalt ihrer eigenen Arbeit zeigten, während der andere nicht finden konnte, in welchem Teil des Haupttextes die mehreren im Abstract genannten wichtigen Ergebnisse dargestellt oder gestützt wurden.
Die einzige Arbeit, bei der alle Fragen richtig beantwortet wurden, kam auch nicht durch die Prüfung. Shah fand bei der Durchsicht einen schwerwiegenden Fehler in einer der Hauptschlussfolgerungen der Arbeit, was der Autor später auch zugab. TMLR lehnte diese Arbeit direkt ab, erlaubte dem Autor aber, sie nach Korrektur des Fehlers oder Einschränkung der Schlussfolgerung erneut einzureichen. Die übrigen 9 Arbeiten wurden direkt abgelehnt, ohne die Möglichkeit einer erneuten Einreichung.
Zwei Zwischenfälle nach den Gesprächen
Shah dokumentierte in seinem Artikel noch zwei Vorfälle, die einen gewissen schwarzen Humor haben.
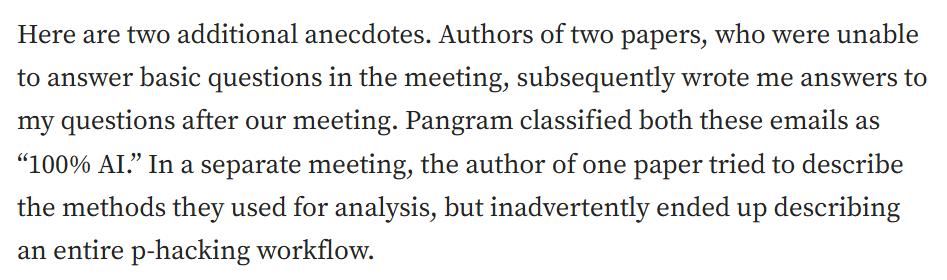
Der erste Vorfall: Die Autoren von zwei Arbeiten konnten die grundlegenden Fragen während des Gesprächs nicht beantworten, schickten Shah aber nach dem Gespräch schriftliche Antworten. Shah schickte diese beiden E-Mails an das KI-Texterkennungstool Pangram, und beide wurden als «100 % KI» eingestuft.
Der zweite Vorfall: Bei einem anderen Gespräch versuchte ein Autor, Shah die von ihm verwendete Analysemethode vorzustellen, und beschrieb dabei unbeabsichtigt den vollständigen Ablauf eines p-Hackings, also die Praxis, die Analysemethode wiederholt anzupassen, bis die Daten «signifikant» werden.
Es ist anzumerken, dass Shah selbst KI nicht ablehnt. Er gab in seinem Artikel offen zu, dass er zur Bewältigung der Lektüre von 8 Arbeiten innerhalb von zwei Wochen selbst LLM zur Unterstützung des Verständnisses nutzte und sogar einige bisher unbekannte Konzepte lernte. Ihm geht es nicht darum, ob Autoren KI verwenden, sondern darum, ob die Autoren für den Inhalt verantwortlich sein können, der ihren Namen trägt.
Warum wurde diese Maßnahme ergriffen?
TMLR wurde 2022 gegründet und wird vom Team hinter JMLR betrieben. Es ist bekannt für seinen Begutachtungsstandard, der «nur prüft, ob die Schlussfolgerungen durch Beweise gestützt werden, und Neuartigkeit sowie SOTA nicht als Grund für eine Ablehnung verwendet». Seine Gutachter, Action Editoren und Chefredakteure sind alle unentgeltliche Freiwillige, was es in diesem Jahr bei der Flut an Einreichungen besonders schwer macht.
Laut der Ankündigung von TMLR im Juni hat sich die Zahl der Einreichungen im vergangenen Jahr verdreifacht, wobei die Zahl der Ein-Personen-Einreichungen sogar auf das 13-fache angestiegen ist. Die Redaktion hat sogar Fälle gesehen, in denen jemand an einem einzigen Tag 5 Arbeiten einreichte. Eine weitere Zahl, die Shah in seinem neuesten Artikel nennt, ist noch anschaulicher: 2026 lag der Anteil der direkt abgelehnten Arbeiten bei TMLR bei etwa 6 %, heute ist er auf etwa 53 % gestiegen, was bedeutet, dass mehr als die Hälfte der Einreichungen nicht zur externen Begutachtung gelangt.
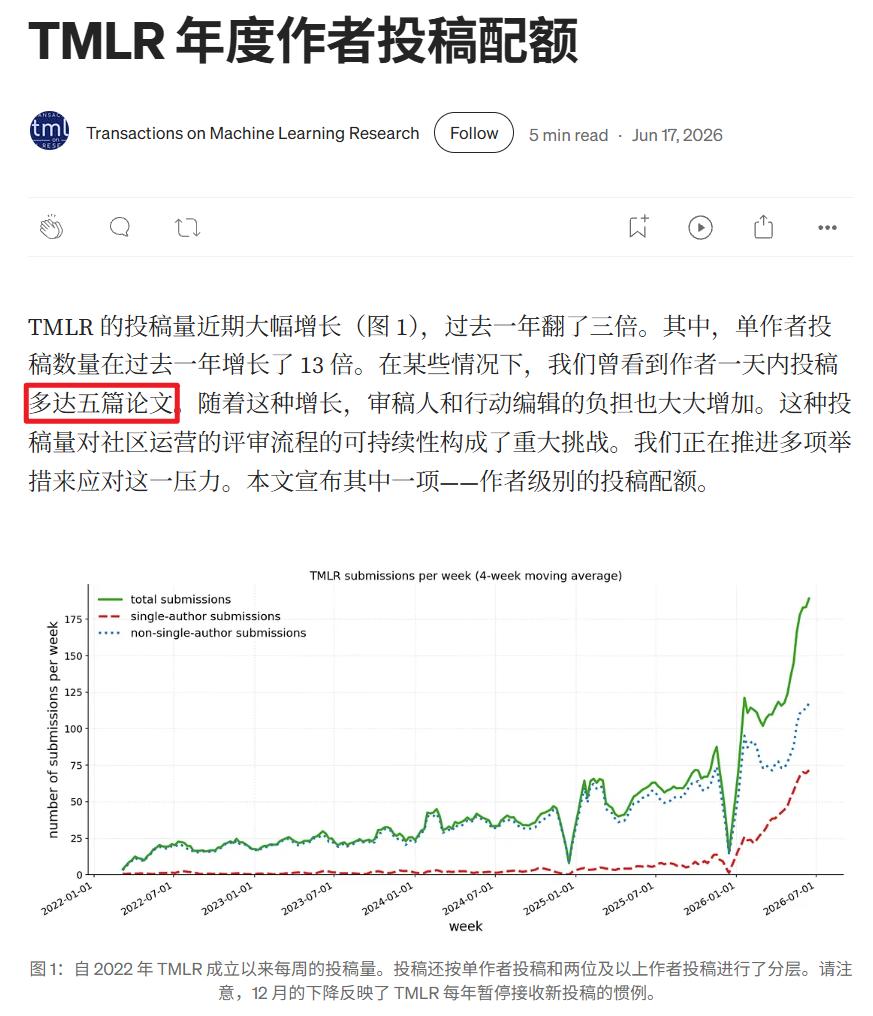
Angesichts dieser Situation hat TMLR in diesem Sommer eine Reihe von Maßnahmen eingeführt.
Die erste Maßnahme ist die Festlegung eines jährlichen Einreichungslimits pro Autor. Im Gegensatz zu vielen Konferenzen mit einer festen Obergrenze von maximal N Arbeiten pro Person verwendet TMLR eine «harmonisierte» Quotenregelung: Das Limit, das eine Arbeit pro Autor verbraucht, nimmt mit steigender Anzahl von Mitautoren ab. Die genauen Parameter lauten: Wer nur Ein-Personen-Arbeiten einreicht, darf maximal 2 Arbeiten pro Jahr einreichen; wenn alle Einreichungen von 9 gemeinsam verfassten Arbeiten stammen, sind maximal 9 Arbeiten pro Jahr erlaubt; aktive Gutachter und Action Editoren erhalten das Doppelte des Limits. Diese Regelung ist seit dem 1. Juli in Kraft. TMLR erläuterte in der Ankündigung, dass die Gründe für die nicht gleichmäßige Verteilung darin bestehen, zu verhindern, dass Personen durch das Hinzufügen von Scheinautoren mehr Einreichungslimit erhalten.
Die zweite Maßnahme ist die Einführung der KI-Begutachtung. TMLR gab im Juli bekannt, dass jede Einreichung neben der regulären menschlichen Begutachtung eine von KI generierte Begutachtung erhält, die nur die «Zuverlässigkeit» der Arbeit bewertet, also ob die Schlussfolgerungen durch genaue, klare und überzeugende Beweise gestützt werden. Sie trifft keine subjektiven Urteile und gibt keine Empfehlung für die Annahme ab, die endgültige Entscheidung liegt weiterhin beim Action Editor. Nach Tests wählte TMLR das KI-Begutachtungstool von CSPaper aus.
Die dritte Maßnahme ist die Aufnahme der «klaren Darstellung» in die Annahmekriterien. Am 28. August änderte TMLR das ursprüngliche Kriterium «Interesse des Publikums» und stellte klar fest, dass Arbeiten ihre Erkenntnisse den Lesern klar vermitteln müssen. Die Ankündigung weist direkt darauf hin, dass aktuelle KI-Texte oft umständlich formuliert, mit Fachbegriffen überladen und schwer verständlich sind; wenn eine Arbeit fast vollständig von KI erstellt wird und keine menschliche Beteiligung aufweist, wird sie nach dem aktuellen Stand der KI-Systeme dieses Kriterium höchstwahrscheinlich nicht erfüllen.
Shah fasste am Ende des Artikels zusammen, dass diese Gespräche die Redaktion mehr Vertrauen in den bestehenden Prozess der direkten Ablehnung von Einreichungen gegeben haben, und die Quotenregelung sowie die Betonung klarer Darstellung haben sich als sehr hilfreich erwiesen.
Nicht nur TMLR steht vor diesem Problem
Die Situation von TMLR ist kein Einzelfall. Seit diesem Jahr kämpfen mehrere wichtige Veröffentlichungsplattformen im Bereich KI mit demselben Problem.
Anfang Juni gab der offizielle Blog von NeurIPS bekannt, dass von den 971 Einreichungen im Bereich der Position Papers bei NeurIPS 2026 273 (28,2 %) von Pangram mit einem KI-Wert von 100 % eingestuft wurden.
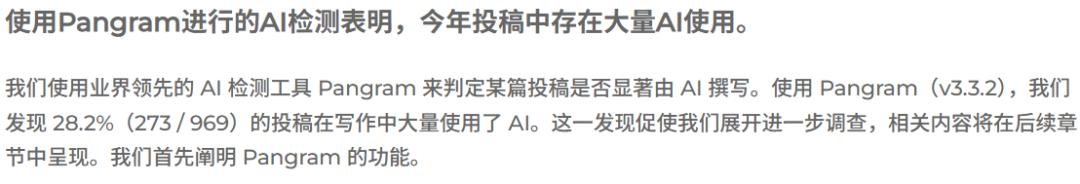
https://blog.neurips.cc/2026/06/02/ai-generated-papers-in-the-neurips-2026-position-paper-track/
Dieser Bereich verlangte in diesem Jahr ausdrücklich, dass Arbeiten «im Wesentlichen von Menschen verfasst» werden und KI nur für Randbearbeitungen wie die Verbesserung des Textes verwendet werden darf. NeurIPS wies gleichzeitig darauf hin, dass die Zunahme von KI-Texten umfassend ist: Im Bereich «Bewertung und Datensätze» hat sich die Zahl der Arbeiten mit einem Pangram-Wert von mindestens 90 % von 2025 bis 2026 mehr als verzehnfacht. NeurIPS räumte aber auch ein, dass die Erkennungsergebnisse empfindlich auf die Parameter reagieren: Bei Verwendung eines mittelgroßen Erkennungsfensters sinkt der Anteil der Arbeiten mit einem KI-Wert zwischen 90 % und 100 % von 42,7 % auf 12,7 %.
Schon Mitte Mai kündigte Thomas G. Dietterich, Leiter des Bereichs Informatik bei arXiv, in sozialen Medien eine klare Strafe an: Wenn es «schlüssige Beweise» dafür gibt, dass der Autor die Ausgabe des großen Sprachmodells nicht überprüft hat, wie z. B. halluzinierte Referenzen oder im Haupttext verbliebene Dialogsätze von Chatbots, werden alle Autoren für ein Jahr von der Einreichung bei arXiv ausgeschlossen. Nach Ablauf dieser Frist dürfen ihre Arbeiten nur dann auf arXiv veröffentlicht werden, wenn sie zuvor von einer regulären peer-reviewed Plattform angenommen wurden. Dietterich betonte, dass die Unterschrift unter einer Arbeit bedeutet, dass jeder Autor für den gesamten Inhalt verantwortlich ist, unabhängig davon, wie dieser Inhalt erstellt wurde.
