Nach zehn Jahren hat Ren Shaoqing eine neue Forschungsarbeit veröffentlicht.
Zehn Jahre später hat Shaoqing Ren, ein KI-Forscher von Weltrang und Autor von ResNet, erneut eine originelle Forschungsarbeit vorgelegt.
Dieses neueste Paper ermöglicht es dem autonomen Fahren, „einen Schritt zu machen und zehn Schritte vorauszudenken“ – es verhält sich immer mehr wie ein erfahrener Fahrer!
Vor kurzem haben Shaoqing Ren und seine Kollegen das Paper „MM-Future: Multi-Mode Joint World–Action Modeling for Autonomous Driving“ veröffentlicht, in dem ein neues multimodales gemeinsames Welt-Aktions-Modell vorgestellt wird.
In den öffentlichen akademischen Aufzeichnungen konzentrieren sich seine repräsentativen Forschungen hauptsächlich auf die Jahre 2014 bis 2016, darunter eine Reihe klassischer Arbeiten im Bereich Computer Vision wie Faster R-CNN und ResNet.
Diesmal tritt er erneut als korrespondierender Autor in einer Arbeit zum autonomen Fahren auf. Die erste Einrichtung des Papers ist NIO, mehrere Autoren stammen von NIO, und die Forschungsrichtung zielt direkt auf Weltmodelle und Planung ab.
Das Kernproblem, das diese Arbeit lösen soll, ist klar definiert: In derselben Fahrszene muss das System nicht nur eine einzige Trajektorie, sondern auch nicht nur eine einzige feststehende Zukunft verarbeiten.
Der Ansatz des Teams lautet: Das Modell soll mehrere Gruppen von Szenen-Aktions-Hypothesen auf einmal erzeugen, wobei sich die Fahrzeugtrajektorie und die entsprechende zukünftige Szene gemeinsam entwickeln, bevor eine Auswahl getroffen wird.
Einfach ausgedrückt kann das autonome Fahren nicht nur die Umgebung um sich herum klar erfassen, sondern auch mehrere mögliche Zukünfte durchspielen und schließlich den sichersten Weg zur Ausführung auswählen.
Von einer einzelnen Trajektorie zu mehreren Zukünften erweitern
Die grundlegende Logik des End-to-End-autonomen Fahrens besteht darin, die Beobachtungen der Sensoren direkt auf die Trajektorie des eigenen Fahrzeugs oder Steuerbefehle abzubilden.
Das World–Action Model fügt zusätzlich die Modellierung zukünftiger Szenen hinzu, sodass die Planung nicht nur auf der aktuellen Umgebung basiert, sondern auch die möglichen Folgen von Aktionen berücksichtigt.
Die vorhandenen World–Action Modelle lassen sich grob in zwei Kategorien einteilen:
Die erste Kategorie ist das kaskadenförmige Schema. Zum Beispiel werden zuerst mehrere Kandidatentrajektorien erzeugt, bevor die zugehörigen zukünftigen Szenen für jede Trajektorie vorhergesagt werden; oder es wird zuerst die zukünftige Szene vorhergesagt, bevor die Planung auf Basis der Szene abgeschlossen wird. Auf diese Weise können mehrere Ergebnis-Kandidaten erzeugt werden.
Das Problem dieses Verfahrens ist jedoch ebenfalls klar: Die Informationen werden einseitig übertragen, und später erzeugte Variablen können die vorherigen Entscheidungen nicht mehr rückgängig korrigieren.
Angenommen, das Modell hat bereits festgelegt, dass das eigene Fahrzeug vorwärts durch die Kreuzung fährt, und stellt erst später fest, dass das entgegenkommende Fahrzeug nicht bremst – dieses zukünftige Ergebnis kann kaum noch in den vorherigen Aktionsgenerierungsprozess einbezogen werden.
Die zweite Kategorie ist das gemeinsame Schema. Szene und Aktion werden in denselben Generierungsprozess eingebunden, sodass beide sich gegenseitig beeinflussen können.
Wenn sich die Aktion des Fahrzeugs ändert, passt sich die vorhergesagte Umgebung an; sobald sich die Umgebung ändert, wirkt sich dies wiederum auf die Trajektorie des Fahrzeugs aus. Die vorhandenen Verfahren dieser Art erzeugen normalerweise nur eine einzige Gruppe von Szenen-Aktions-Ergebnissen.
Das Paper weist auf die Lücke hin: Kaskadenmodelle können mehrere Fahrergebnisse abdecken, aber es fehlt eine bidirektionale Interaktion zwischen Szene und Aktion; gemeinsame Modelle verfügen über bidirektionale Interaktionsfähigkeit, erzeugen aber normalerweise nur eine einzige Ergebnisgruppe.
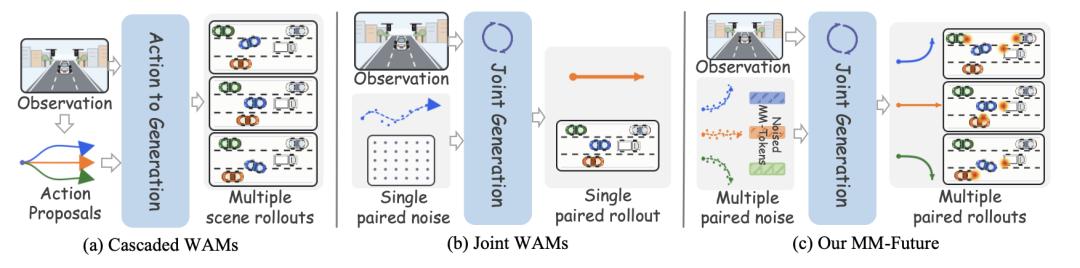
Auf realen Straßen müssen diese beiden Dinge jedoch häufig gleichzeitig verarbeitet werden.
Die von MM-Future vorgestellte Lösung lautet: Erzeuge auf einmal mehrere Gruppen von Szenen-Aktions-Hypothesen, wobei sich Szene und Aktion innerhalb jeder Gruppe weiter gemeinsam entwickeln.
Jede Ergebnisgruppe wird als paired scene–action hypothesis (gepaarte Szene-Aktions-Hypothese) bezeichnet.
Wenn das Modell gleichzeitig Dutzende von Kandidaten erzeugt, kann eine Gruppe davon darin bestehen, dass das eigene Fahrzeug beschleunigt und das entgegenkommende Fahrzeug weicht, eine andere Gruppe darin, dass das eigene Fahrzeug bremst und das entgegenkommende Fahrzeug zuerst fährt, daneben gibt es weitere unterschiedliche Bremsgrade, Durchfahrtsweisen und Szenenänderungen.
Diese Ergebnisse unterscheiden sich nicht nur in der Trajektorie, sondern auch in der zukünftigen Umgebung, die zu jeder Trajektorie gehört. Dadurch gelangen mehrere mögliche Zukünfte in den Planungsprozess.
Gleichzeitig Dutzende von Zukünften durchdenken – drei zu bewältigende Hürden
Das Paper teilt die Schwierigkeiten des multimodalen gemeinsamen Modellierens in drei Punkte auf:
* Woher die Vielfalt stammt, wie die Rechenkosten mehrerer Zukünfte gesteuert werden und wie mehrere Kandidaten nach ihrer Erzeugung ausgewählt werden. Das Kerndesign von MM-Future dreht sich ebenfalls um diese drei Probleme.
Zuerst das Problem der Vielfalt.
Reale Fahrdaten weisen natürliche Einschränkungen auf: Eine einzelne Aufzeichnung dokumentiert nur ein einziges bereits eingetretenes Ergebnis. Wenn der Fahrer am Ende bremst, enthalten die Daten keine echte Szene, die zum selben Zeitpunkt bei einer Entscheidung zum Beschleunigen eingetreten wäre. Das Modell muss unter Aufsicht mit nur einem einzigen Ergebnis mehrere plausible Ergebnisse erlernen.
MM-Future erstellt auf der Aktionsseite basierend auf der Verteilung der Trainingstrajektorien ein Gaussian Mixture Noise, das von unterschiedlichen Aktionsprioritäten ausgeht; auf der Szenenseite wird unabhängiges Rauschen verwendet.
Die Anfangszustände von Aktion und Szene werden paarweise kombiniert, um unabhängige Ausgangspunkte für unterschiedliche Fahrergebnisse zu bilden.
Während des Trainings wird zusätzlich die Best-of-Many-Aufsicht hinzugefügt. Das Modell erzeugt auf einmal mehrere Gruppen von Kandidaten, findet zuerst die Gruppe, die der echten Trajektorie am nächsten kommt, und überwacht dann den Aktionsstrom und den Szenenstrom mit demselben Siegerindex.
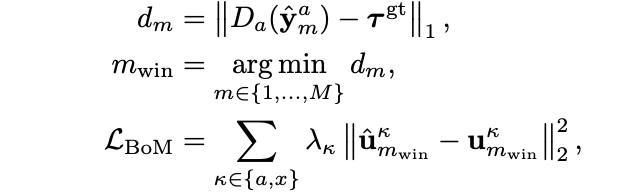
Dadurch wird vermieden, dass alle Kandidaten von derselben Ground-Truth-Trajektorie zu ähnlichen Ergebnissen gezogen werden, und es bleibt zudem sichergestellt, dass eine Trajektorie immer mit ihrer zugehörigen zukünftigen Szene gepaart ist.
Als Nächstes die Rechenkosten. Wenn Mehrwinkel-Videos für jeden Kandidaten vollständig entfaltet werden, steigt der Rechenaufwand schnell an, sobald die Anzahl der Modi und die Vorhersagezeit zunehmen.
Die Autoren schlagen MM-Tokens vor, um die visuellen Merkmale von mehreren Kameras und mehreren Zeitrahmen zu einer kompakten, auf die Planung ausgerichteten Darstellung zu komprimieren.
MM-Tokens übernehmen keine Rekonstruktion von RGB-Bildern und müssen auch kein vollständiges BEV wiederherstellen. Das begrenzte Token-Budget behält hauptsächlich Informationen bei, die für die zukünftige Entwicklung und die Fahrplanung relevant sind.
Aus der vom Paper gezeigten Aufmerksamkeitsvisualisierung geht hervor, dass sich die von MM-Tokens berücksichtigten Informationen hauptsächlich auf Bereiche wie Straßenstrukturen, Kreuzungen, vorausfahrende Fahrzeuge und andere Verkehrsteilnehmer in der Umgebung konzentrieren.
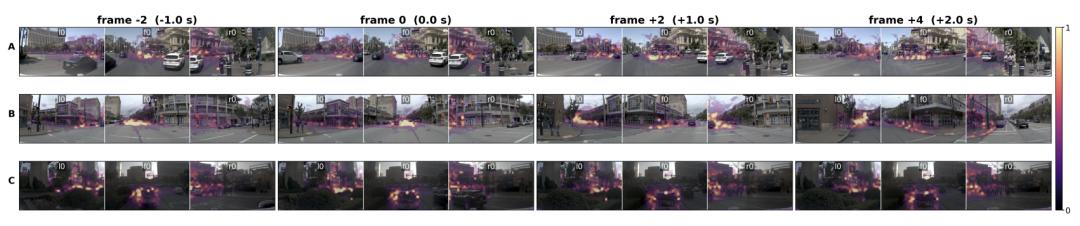
Das Modell muss daher nicht für Dutzende von Kandidaten jeweils vollständige hochauflösende zukünftige Videos erzeugen, sondern behält intern eine Gruppe von kompakten, auf die Planung ausgerichteten Darstellungen zukünftiger Szenen bei.
Der dritte Punkt lautet wie Szene und Aktion sich gemeinsam entwickeln und wie mehrere Kandidaten ausgewählt werden. MM-Future verwendet ein modality-aware Transformer, um Aktionsstrom und Szenenstrom gleichzeitig zu verarbeiten.
Die gemeinsame Aufmerksamkeit ist für die Interaktion der beiden Informationstypen zuständig, während modusspezifische Zweige die jeweiligen statistischen Merkmale der beiden Datentypen beibehalten.
Jede Kandidatengruppe teilt sich die Modellparameter, aber zwischen verschiedenen Modi werden keine Tokens ausgetauscht.
Daher wird die Aktionstrajektorie im Zuge der Änderung der gepaarten Szene weiter aktualisiert, und die Szenenvorhersage wird ebenfalls an die Aktionen des eigenen Fahrzeugs angepasst. Dadurch wird die bidirektionale Kopplung von Aktion und Umgebung in die Mehrtrajektorienplanung eingebracht.
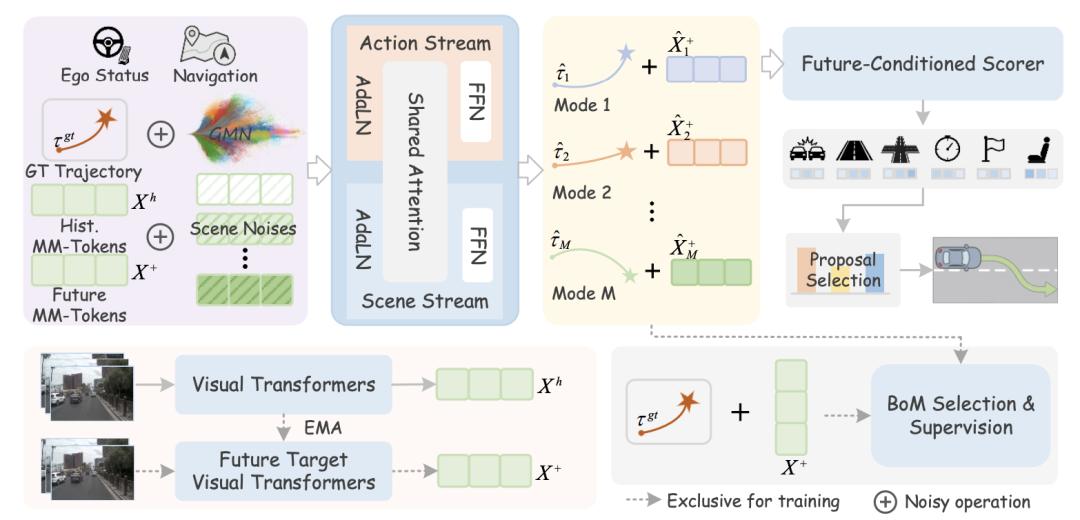
Nach Abschluss der Generierung übernimmt der Future-Conditioned Proposal Scorer die endgültige Auswahl.
Bei der Bewertung einer Kandidatentrajektorie liest er gleichzeitig historische Informationen und die zur jeweiligen Trajektorie gehörende vorhergesagte Zukunft ein, bevor er eine Punktzahl vergibt. Jeder Kandidat kann nur die Zukunft einlesen, mit der er selbst gepaart ist, und darf keine Szenenergebnisse anderer Modi nutzen.
Das Paper wendet zudem Stop-Gradient auf Trajektorien und zukünftige Tokens an, um zu verhindern, dass der Generator die Ausgabeverteilung zur Erhöhung der Bewertungspunkte verändert.
Der endgültige Inferenzprozess kann in vier Schritte unterteilt werden: Kodierung der historischen Beobachtungen, Erzeugung mehrerer Gruppen von Szenen-Aktions-Ergebnissen, Bewertung der Kandidaten anhand der historischen Informationen und der gepaarten Zukunft sowie Ausgabe der Trajektorie mit der höchsten Punktzahl.
Weltmodelle dringen zunehmend tiefer in die Planung ein
Welche Verbesserungen bringt MM-Future letztendlich?
Das Paper wurde mit zwei Benchmarks getestet: NAVSIM und HUGSIM:
Auf NAVSIM-v1 navtest erzielt MM-Future, das mit Trainval-Daten trainiert wurde, einen PDMS-Wert von 94,0. In derselben Ergebnistabelle erreicht das WAM-Schema DriveFuture 90,7 und das E2E-Schema DrivoR trainval 93,7.
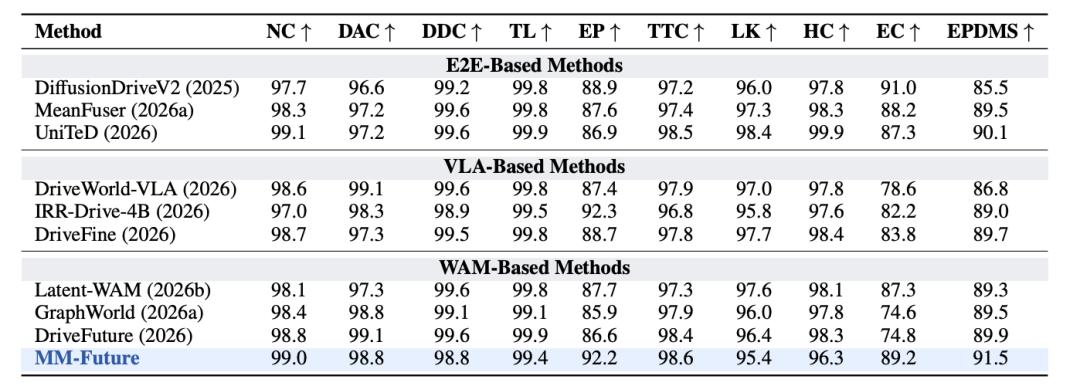
Auf NAVSIM-v2 erreicht MM-Future einen EPDMS-Wert von 91,5 und liegt damit über den in der Arbeit aufgeführten Werten von UniTeD mit 90,1 und DriveFuture mit 89,9.
Noch aufschlussreicher für die Wirksamkeit des Verfahrens ist das Ablationsexperiment.
Wenn nur Aktionen erzeugt und nur ein einziger Modus beibehalten wird, beträgt der PDMS-Wert 84,1; nach Erhöhung der Anzahl der Aktionskandidaten auf 32 steigt er auf 92,3.
Nach Hinzufügen der gemeinsamen Erzeugung von Szene und Aktion erreicht der Einzelmodus-Wert 85,1 und der 32-Modi-Wert 92,9. Wenn schließlich der Bewerter die zu jeder Trajektorie gehörende vorhergesagte Zukunft einlesen darf, steigt der PDMS-Wert weiter auf 93,3.
Mehrere Vergleichsgruppen bestätigen die Wirkung der drei Glieder: Die Erhöhung der Moduszahl bringt den Hauptzuwachs; die gemeinsame Erzeugung von Szene und Aktion kann das Ergebnis weiter verbessern; nachdem die gepaarte Zukunft in die Bewertung der Kandidaten einbezogen wird, verbessern sich die Planungsindikatoren erneut.
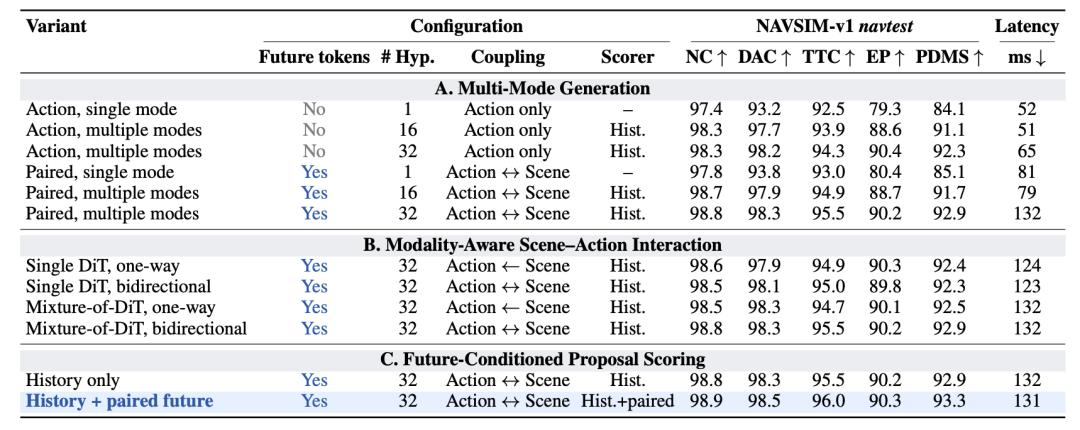
Der durch den Bewerter erzielte Zuwachs ist beim TTC-Indikator am deutlichsten. Daraus schließt das Paper, dass die kandidatenspezifische Zukunft dem Modell hauptsächlich hilft, Trajektorien mit hohem Interaktionsrisiko auszuschließen.
Das multimodale Training zeigt zudem eine schnellere Konvergenzgeschwindigkeit. 16 Modi und 32 Modi benötigen etwa 3,8k Schritte, um einen Validierungs-PDM-Wert von 0,80 zu erreichen, während der Einzelmodus 17,5k Schritte braucht.
