Von TOPS zu realen Lasten verändern sich die Bewertungsstandards für KI-Chips.
Wenn Agenten von Demonstrationsprototypen zum produktiven Einsatz gelangen, steht die Branche vor einer Reihe scharfer realer Widersprüche: Die Iterationszyklen der übergeordneten Modelle und Agentenalgorithmen sind auf ein halbes Jahr verkürzt worden, während die Entwicklung eines KI-Chips von der Anforderungsdefinition und Architekturdesign bis zur Tapeout-Massenproduktion oft mehrere Jahre dauert. In der Vergangenheit war die Branche gewohnt, die auf dem Papier stehende Spitzenrechenleistung einzelner Chips zu verfolgen, aber Rückmeldungen aus dem operativen Geschäft erinnern die Branche ständig daran, dass die Eigenschaften von Agenten mit langfristigem Betrieb, mehrstufiger Interaktion und häufigen Tool-Aufrufen verschiedene verborgene Engpässe in Speicherung, Planung und heterogener Zusammenarbeit aufdecken werden. Der Maßstab für die Bewertung der Rechenleistung verändert sich schleichend: Die End-to-End-Ausführungseffizienz und die Stabilität des Systems bei langfristigem Betrieb werden allmählich zu harten Einschränkungen für die kommerzielle Umsetzung.
Agenten verändern die Merkmale der KI-Arbeitslast grundlegend, und die Überlegungen der Branche richten sich entsprechend neu aus. Am 21. September endete die AICC2026 Konferenz für künstliche Intelligenz und Rechnen im Internationalen Innovationszentrum von Zhongguancun in Peking. Vor Ort spürt man unmittelbar, dass die Branche neu danach sucht, welche Hardware und Systemarchitektur die neuen Geschäftsanforderungen erfüllen können, die durch Agenten entstehen.
Vollständige Verlagerung des Arbeitslastparadigmas: Agenten verändern die Bewertungslogik von Hardware
Die durch Agenten ausgelöste Veränderung ist nicht einfach ein sprunghafter Anstieg des Bedarfs an Rechenleistung, sondern eine grundlegende Verlagerung des gesamten Arbeitslastparadigmas.
Zhou Zhengang, Vizepräsident von IDC, stellte auf der Konferenz den „Bericht zur Bewertung der Entwicklung der chinesischen KI-Rechenleistung 2026“ vor. Er zerlegte den Ausbruch des Rechenleistungsbedarfs in drei Multiplikatoren: Die Häufigkeit der Aufgabenausführung, der Token-Verbrauch pro Aufgabe und der Synergieeffekt der Zusammenarbeit mehrerer Agenten überlagern sich und treiben gemeinsam den Rechenleistungsverbrauch der gesamten Gesellschaft an. Im Gegensatz zum herkömmlichen einmaligen fragenbasierten Schließen großer Modelle gehören Agenten in der Produktionsumgebung zu Aufgabenformen mit langem Zyklus, die das Lesen riesiger Wissensdatenbanken, mehrstufige Schlussfolgerungsgenerierung, Aufrufe externer Tools, Speicherung von Sitzungsstatus und Rollback-Wiederholung bei Fehlern umfassen und gleichzeitig den gleichzeitigen Betrieb einer großen Anzahl von Instanzen unterstützen müssen.
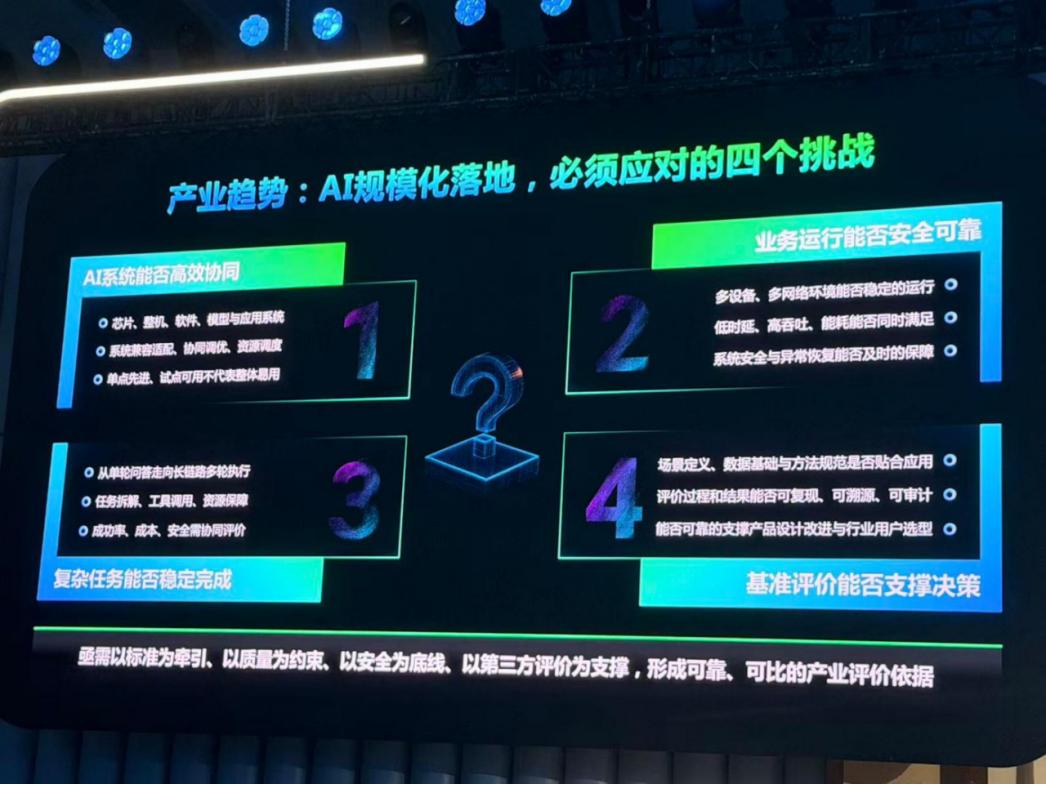
Die Veränderung der Arbeitslastform gestaltet auch direkt die Arbeitsteilung auf der Ebene von Hardware und Systemzusammenarbeit neu. Liu Jun, Chief AI Strategy Officer von Inspur Information, äußerte sich im Gespräch: Nach dem Eintritt in die Agentenphase führt KI nicht mehr nur einen einzigen Modellaufruf durch, sondern erfordert kontinuierliche Aufgabenplanung, Tool-Aufrufe, Statusverwaltung, Ergebnisprüfung und mehrstufige Iterationen. Dadurch werden die Rechenlasten länger, komplexer und dynamischer, was neue Anforderungen an die Zusammenarbeit von CPU, Beschleunigern, Arbeitsspeicher, Speichermedien, Vernetzung und Systemsoftware stellt. Seiner Einschätzung nach ist Intelligenz nicht mehr nur eine seltene, ausschließlich dem Menschen eigene Fähigkeit. Die KI-Rechenentwicklung weist zwei wichtige Richtungen auf: Die eine geht nach oben und nähert sich ständig der Obergrenze der Intelligenz, die andere geht in die Breite und erreicht eine ausreichende Versorgung. Diese branchenweite Veränderung wird sich auf alle Aspekte des Systemarchitekturdesigns von oben nach unten auswirken.
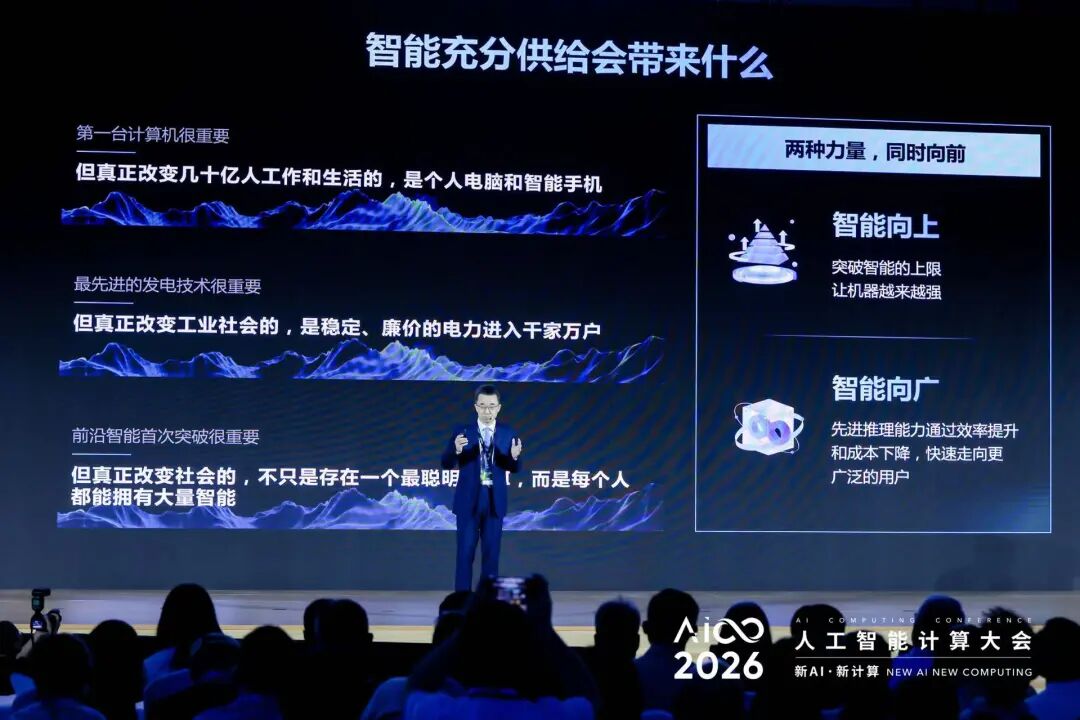
Viele praktische Umsetzungen von Unternehmen werfen auch reale Probleme auf, die zur Vorsicht mahnen. Jiang Peihang, Senior Vizepräsident des Instituts für Software und Systemforschung des Fünften Elektronik-Instituts des Ministeriums für Industrie und Informationstechnologie, beobachtete, dass viele Chips bei standardisierten Einzelpunkt-Benchmark-Tests hervorragende Ergebnisse erzielen, aber wenn sie in der echten Produktionsumgebung für Agenten eingesetzt werden und mit komplexen Aufgaben mit mehreren Schritten und hoher Parallelität konfrontiert sind, leicht zu Aufgabenunterbrechungen und abweichenden Ausgaben führen. Die auf dem Papier stehenden Leistungsindikatoren der Hardware entsprechen nicht der tatsächlichen Einsatzfähigkeit in realen Geschäftsszenarien. Die Stabilität der gesamten Kette ist bereits zu einem unvermeidlichen harten Schwellenwert für die skalierte Umsetzung von Agenten geworden, was in den praktischen Erfahrungen vieler Unternehmen vor Ort immer wieder bestätigt wurde.
In Agentenszenarien führt der lange Kontext zu einem enormen Druck. Die ständige Ausweitung des KV-Cache-Volumens löst eine ganze Kette von Problemen wie Speicherüberlauf, Verschlechterung der Latenzzeit des ersten Zeichens und Jitter der Token-Intervalle aus. Aufgaben sind keine festen Rechenabläufe mehr, sondern enthalten viele unvorhersehbare Verzweigungen und Wiederholungslogiken. Arbeitsspeicherkapazität, Bandbreite, Vernetzung zwischen Chips, Ressourcenisolation und globale Aufgabenplanung können alle zu Systemengpässen werden. Daraus ergibt sich das Kernproblem, das die Branche beantworten muss: Angesichts der dynamischen und vielfältigen neuen Arbeitslasten, welche Probleme kann die Hardware lösen und welche Anforderungen müssen von System und Software erfüllt werden.
Der Speicherwand direkt gegenüberstehen: Mehrere technische Wege parallel mit jeweils eigenen Fähigkeitsgrenzen
Die Effizienz von Speicherung und Speicherzugriff ist eines der Themen, die auf der Konferenz häufig diskutiert wurden.
In den letzten zehn Jahren hat sich die KI-Rechenleistung um ein Hundertfaches erhöht, aber die Verbesserung der Speicherbandbreite kann mit der Expansion der Rechenleistung bei weitem nicht Schritt halten. Agenten-Geschäftsvorgänge müssen ständig eine große Menge an KV-Cache und Aufgabenstatus generieren, aktualisieren und speichern, was den Druck auf den Speicherzugriff weiter erhöht. Das bedeutet, dass die Zusammenarbeit zwischen Speichersystem und Rechensystem noch wichtiger wird. Für den heimischen Markt erforscht die Branche vor dem Hintergrund der zunehmenden Vielfalt von Chiparchitekturen, Speichertechnologien und Lieferkettenbedingungen parallel Lösungen in mehreren technischen Richtungen.
Wu Huaqiang, Vizepräsident der Tsinghua-Universität, gab anhand der langjährigen Forschungspraxis seines Teams eine nüchterne Einschätzung zur vielversprechenden Technologie des Speicher-Rechen-Integrationsansatzes: Man darf die Hoffnung nicht vollständig auf einzelne Durchbrüche bei Bauelementen setzen. Die vollständige Zusammenarbeit des gesamten Stapels von Bauelementen, Verfahren, Schaltkreisen und Architekturen bis hin zu Compilern und Inferenzframeworks ist unverzichtbar. Durch den Aufbau von Kreuzgittern mit nichtflüchtigen Speicherbauelementen und die Nähe der Berechnung zu den Speicherzellen kann die Speicher-Rechen-Integration in Szenarien mit hohem Speicherzugriffsanteil wie der RAG-Suche und Vektordatenbanken einen herausragenden Energieeffizienzvorteil erzielen. Aber die analoge Berechnung selbst hat inhärente praktische Probleme wie Bauelementeschwankungen und Gitterabbildung, die auch ihre Fähigkeitsgrenzen festlegen: Sie eignet sich eher für spezifische speicherzugriffsintensive Szenarien und kann kaum alle Szenarien abdecken, wenn es um die vollständige Geschäftsablaufkette von Agenten mit vielen Verzweigungssprüngen und komplexer allgemeiner Berechnung geht.
Ein einzelner Chip ist durch die physikalischen Obergrenzen von Fläche, Leistungsaufnahme und Verfahren eingeschränkt, daher werden Chiplet und 3D-Hybrid-Stapelung zu einem weiteren wichtigen Lösungsansatz. Ma Kaisheng, Gründer und Chefwissenschaftler von ArcticCore, prognostiziert anhand seiner Produktforschungserfahrungen: In den nächsten ein bis zwei Jahren wird die Branche Agentensysteme mit großen Parameter-Modellen, hohem Token-Durchsatz, Zusammenarbeit von Tausenden von Containern und ununterbrochenem Betrieb von Tausenden von Stunden erleben. Ein einzelner Chip kann kaum alle Geschäftsanforderungen erfüllen. Der Wert von Chiplet und 3D-Stapelung besteht nicht nur darin, die gesamte Rechenleistung durch das Zusammensetzen von Dies zu erhöhen, sondern der Kernvorteil liegt in der durch Aufteilung und Kombination entstandenen Architekturelastizität, um den realen Widerspruch zwischen der schnellen Iteration von Modellen und dem langen Entwicklungszyklus von Hardware zu mildern.
Aber fortschrittliches Packaging ist keine universelle Lösung. Lou Jianguang, Chief AI Scientist von Suanmiao Technology, gestand in seinem Vortrag: 3D-Stapelung kann die Verbindungsdistanz auf Mikrometer-Ebene reduzieren, die Bandbreite erheblich erhöhen und den Stromverbrauch für den Datentransport senken. Aber die Steuerung der Ausbeute, das Wärmemanagement und das zugehörige Software-Ökosystem sind unumgängliche praktische Hindernisse bei der Umsetzung. Man kann die vorhandene GPU/NPU-Architektur nicht einfach direkt übernehmen, sondern muss eine speicherzentrierte native Architekturentwicklung für Transformer durchführen.
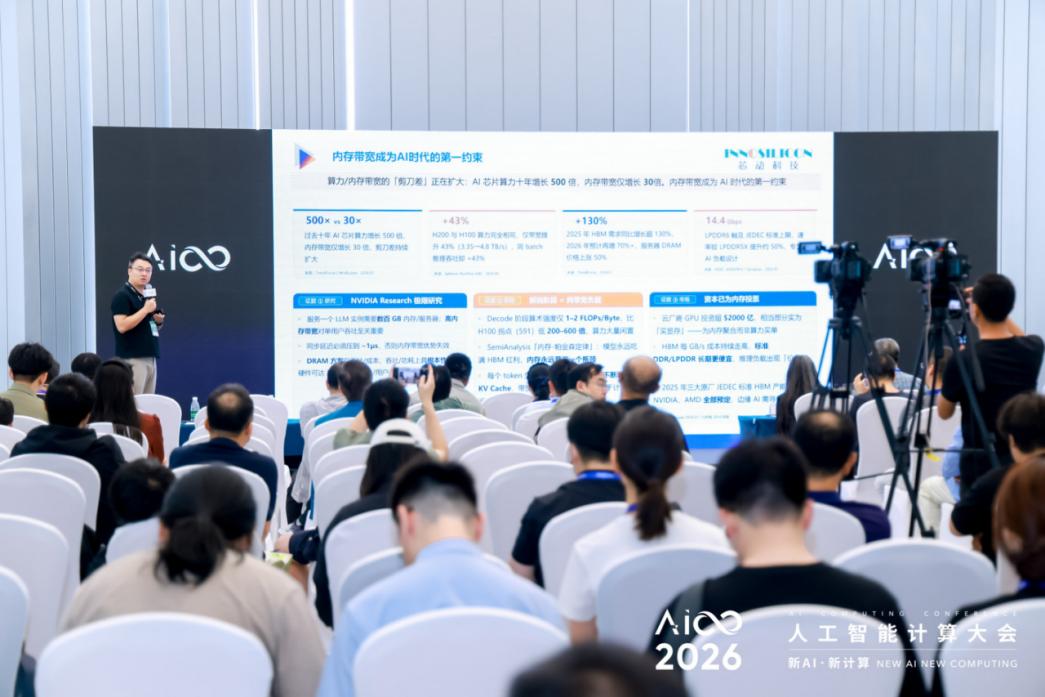
Selbst wenn fortschrittliche Architekturen wie 3D-Stapelung und Chiplet eingesetzt werden, können die Engpässe auf der Arbeitsspeicherebene nicht vollständig beseitigt werden. Zhang Jie, Direktor der DDR-Produktlinie von Core-Logic, erläutert die realen Risiken aus der Perspektive der praktischen Umsetzung in der IP-Industrie: Agentenaufgaben dauern oft mehr als zehn Minuten oder sogar länger. Sobald ein kritischer Datenfehler im Arbeitsspeicher auftritt, wird die gesamte bereits abgeschlossene Aufgabe ungültig, was zu echten Geschäftsverlusten führt. Aus diesem Grund ist die Stabilität des Arbeitsspeicherbetriebs für Agenten-Geschäfte inzwischen genauso wichtig wie die Leistung. Neue Schutzmechanismen wie der zusätzliche Meta-Bereich in LPDDR6 und die zukünftig integrierte PIM-Fähigkeit zur Berechnung im Speicher können einen Teil einfacher Berechnungen innerhalb des Speicherchips durchführen und den Druck auf den Hauptchip mindern, aber sie können nur einen Teil des Drucks des Datentransports lindern und die Speicherwand nicht vollständig beseitigen. HBM, 3D-DRAM und die neue DDR-Generation haben jeweils ihre eigenen Anwendungsbereiche, zwischen Bandbreite, Kapazität, Zuverlässigkeit und Kosten muss immer eine praktische Abwägung getroffen werden.
Daher kann Hardware Engpässe wie Bauelementegrenzen, Rechenleistungsskalen und physischen Datentransport überwinden. Aber die dynamische Aufgabenplanung, Wartung des Instanzenstatus, Wiederherstellung nach Fehlern und Zusammenarbeit heterogener mehrerer Chips bei Agentenaufgaben liegen außerhalb des Lösungsbereichs reiner Hardware und müssen letztendlich vom Systemsoftware-Stack implementiert werden. Egal wie fortschrittlich die Hardwarearchitektur ist, wenn die Anpassung der übergeordneten Software nicht Schritt hält, lassen sich die beeindruckenden Hardware-Parameter kaum in tatsächlich nutzbare Geschäftsfähigkeiten umwandeln.
Die neue Herausforderung für RISC-V: Hardwarefähigkeiten werden letztendlich durch ein vollständiges Software-Ökosystem realisiert
Der Aufstieg gemischter KI-Arbeitslasten erweitert die Anwendungsgrenzen von RISC-V und führt es von den herkömmlichen MCU- und Niedrigleistungs-Eingebetteten Szenarien weiter in den Bereich von Servern und KI-Berechnungen. Sowohl in Forenbeiträgen als auch in Unternehmensinterviews erwähnen viele Praktiker dasselbe Realitätsproblem: Die Ausarbeitung guter Hardware-IP ist nur der Ausgangspunkt. Die Stabilität, Kompatibilität und Reife des gesamten grundlegenden Software-Basissystems sind oft das größte Hindernis für die skalierte Umsetzung.
Zhu Weidong, Produktleiter von JinDiel Space-Time Technology Co., Ltd., äußerte sich anhand der praktischen Erfahrungen aus der Entwicklung von RISC-V-Chips: In der Vergangenheit war der Eindruck der Branche von RISC-V meist auf Endgeräte und MCU-Bereiche beschränkt. Aber im Agenten-Zeitalter bringen die Geschäftsanforderungen von langem Kontext, großem KV-Cache und ununterbrochenem Betrieb 7 Tage die Woche 24 Stunden am Tag die Anforderungen an die Zuverlässigkeit auf Serverebene in den Vordergrund. Der Erfolg eines Serverchips hängt nicht nur von den Testergebnissen des CPU-Kerns selbst ab, sondern die Vollständigkeit des gesamten Basissystems aus RDMA-Netzwerk, Virtualisierung, Betriebssystemanpassung und KI-Inferenzframework ist von entscheidender Bedeutung. In vielen Szenarien übersteigt der Arbeitsaufwand für den Aufbau des Software-Ökosystems sogar der der Hardware-IP-Entwicklung selbst.
Seiner Meinung nach liegt der durch den langen Kontext verursachte Druck nicht nur auf der Ebene der Rechenleistung, sondern ein größerer Druck lastet auf dem Arbeitsspeichersubsystem. Die Ausweitung des KV-Cache-Volumens löst eine Kette von Problemen wie Speicherüberlauf, Verschlechterung der Latenz des ersten Zeichens und Jitter der Intervalle zwischen Tokens aus. Die Branche setzt allgemein auf den kooperativen Ansatz von Schichtspeicherung durch Hardware- und Softwarezusammenarbeit: Häufig zugegriffener heißer Cache wird im Hochgeschwindigkeitsarbeitsspeicher abgelegt, kalter historischer Kontext wird in niedriggeschwindige Speichermedien verschoben, und in Kombination mit Softwarealgorithmen wie PageAttention wird der Druck auf die Hardwareseite gesenkt. In der Phase der Produktauswahl hat die Stabilität und RAS-Zuverlässigkeit im Server-Szenario sogar eine höhere Priorität als die ursprünglichen Leistungsindikatoren.
Für gemischte KI-Arbeitslasten muss RISC-V Erweiterungen für KI-Vektor- und Matrixbefehle einführen, und solche Erweiterungen gehen naturgemäß mit dem Risiko einer Fragmentierung des Ökosystems einher. Die