Verkörperte Intelligenz rekrutiert derzeit „Daten-Reiter“
Am 23. September veröffentlichte Mifeng Technology offiziell die Crowdsourcing-Datenplattform „Mifeng Pai“, mit der die Datenerfassung für verkörperte Intelligenz in großem Umfang der breiten Öffentlichkeit zugänglich gemacht wird.
Mifeng Technology wurde im Februar 2026 gegründet. Ihr Geschäft umfasst die Erfassung und Verarbeitung von Daten aus echten Geräten, Daten ohne eigenes Gerät und Simulationsdaten, und positioniert sich als branchenweite Drittanbieter-Datenplattform.
Mithilfe der Plattform „Mifeng Pai“ können gewöhnliche Nutzer MEgo-Geräte beantragen, über die App Erfassungsaufgaben annehmen, und die Plattform vergütet die Arbeit auf Basis der geprüften gültigen Datendauer.
Mifeng startet gleichzeitig die Rekrutierung von „Robotertrainern“ und hat gemeinsam mit mehr als 50 Unternehmen und Einrichtungen aus Bereichen wie Hotellerie, Supermärkten und Fertigung eine Szenariodatenallianz gegründet. Das Unternehmen möchte die Datenproduktion, die ursprünglich in Datenerfassungsfabriken konzentriert war, auf mehr echte Arbeits- und Lebensszenarien verteilen.
In den vergangenen zwölf Monaten hat sich die Antwort der Branche für verkörperte Intelligenz auf die Frage „Woher kommen die Daten“ rasant verändert. Die direkteste Methode in der Anfangsphase bestand darin, Roboter in Datenerfassungszentren zu konzentrieren, wo Menschen die echten Geräte ferngesteuert wiederholt Aufgaben wie Greifen, Transportieren und Ordnen ausführen lassen.
Aber echte Geräte sind teuer, die Erfassungseffizienz ist begrenzt, und es ist kaum möglich, durch lineare Erhöhung der Anzahl von Robotern und Erfassungspersonal das Datenvolumen von Millionen Stunden auf Zehnmillionen oder sogar Milliarden Stunden zu steigern.
Daher beginnt die Branche, einen größeren Teil der Datenproduktion von dem Robotergerät selbst zu trennen.
Mifeng entscheidet sich dafür, die Produktionsseite weiter zu öffnen: Mehr Menschen bringen leichte Geräte in reale Szenarien, und die Plattform verarbeitet diese dezentral erzeugten Daten einheitlich zu Trainingsdaten, die das Modell verwenden kann.
Wenn die verkörperte Datenerfassung auf Crowdsourcing-Produktion umstellt, handelt es sich dann um ein schnell erweiterbares Datennetz oder um ein komplexeres Dienstleistungsgeschäft?
Daten-Version von Meituan – wie rechnet sich das Geschäft?
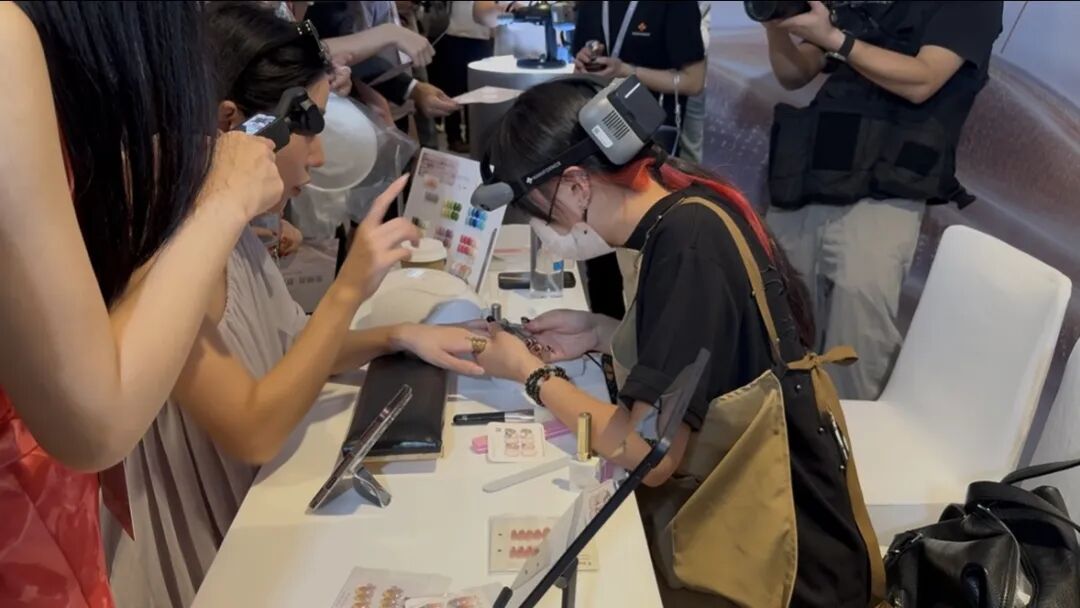
Für gewöhnliche Nutzer umfasst die Teilnahme an Mifeng Pai grob mehrere Schritte: Herunterladen der App, Mieten des MEgo-Geräts, Annehmen von Aufgaben, Ausführen der festgelegten Vorgänge im Lebens- oder Arbeitsumfeld, Hochladen der Daten, Erhalten der Provision basierend auf der gültigen Datendauer und Auszahlung des Betrags.
Nutzer können Aufgaben in der Aufgabenhalle auswählen, laufende Aufgaben unterliegen einem Zeitquotensystem. Die Miete für das MEgo-Gerät beträgt 39 Yuan pro Tag, der Rabattpreis in der Einführungsphase liegt bei 19 Yuan pro Tag, und die grundlegende Aufgabenvergütung, die in der App angezeigt wird, beträgt etwa 20 Yuan pro gültiger Stunde.
Dies ist nicht der einheitliche Endstundenlohn, den die Erfassenden letztendlich erhalten.
Nach Aussage des Unternehmens setzt sich die Vergütung aus der grundlegenden Preisgestaltung pro Stadt und dynamischen Zuschüssen zusammen: Ersteres orientiert sich am Einkommensniveau verschiedener Regionen, Letzteres hängt von der Aufgabenerledigungseffizienz und der Datenqualität ab.
Die Aufgaben dauern zwischen wenigen Minuten und mehr als einer Stunde, die Abrechnung erfolgt letztendlich nach der geprüften gültigen Dauer.
Wenn eine bestimmte Art von Daten ausreichend erfasst ist, kann die Plattform die Verteilung einstellen; für seltene Szenarien oder Szenarien, die schwer zugänglich sind, wird die Attraktivität durch zusätzliche Zuschüsse erhöht.
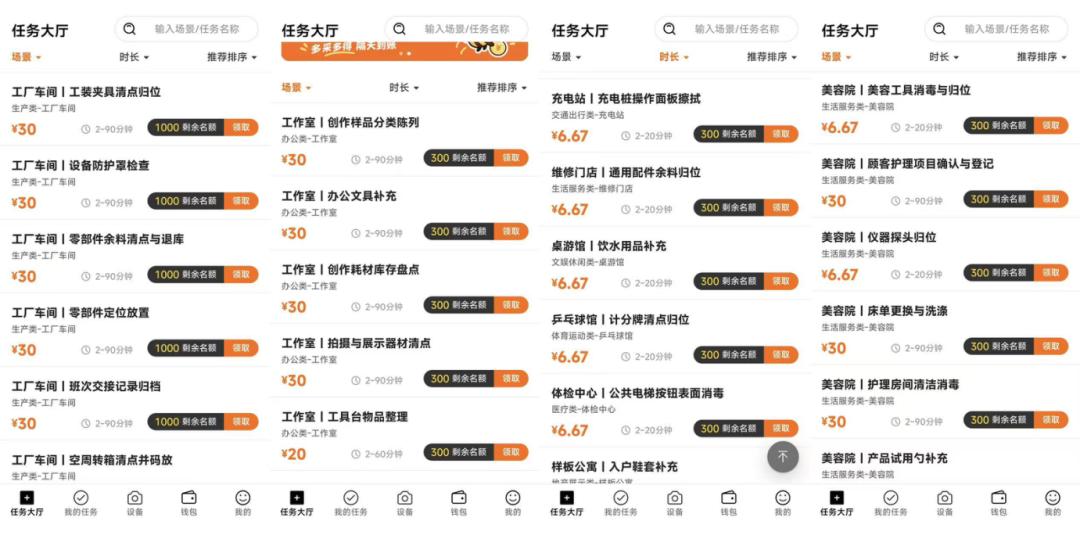
Die derzeit verfügbaren Erfassungsaufgaben decken mehr als 20 Bereiche ab, darunter Produktion und Wartung, Gastronomiedienstleistungen, Logistiktransport, Altenpflege und Haushaltsordnung. Sogar alltägliche Vorgänge wie das Aufräumen von Ballbehältern in Badmintonhallen oder das Auffüllen von Trinkbechern in öffentlichen Servicestationen werden in den Erfassungsbereich aufgenommen.
„Crowdsourcing“ erinnert leicht an eine Variante des Modells für Lieferfahrer: Die Plattform verbindet Nachfrage mit verteilten Arbeitnehmern und steuert diese über Aufgabenregeln und Preise.
Aber der Schwierigkeitsgrad der Erfüllung unterscheidet sich bei beiden Modellen stark.
Bei der Essenslieferung muss die Ware nur an einen festgelegten Ort gebracht werden, während verkörperte Daten die spezifischen Anforderungen des Modells an Szenario, Aktion und Qualität erfüllen müssen – und die verteilten Erfassenden weisen große Unterschiede in Arbeitsgewohnheiten, beruflichen Fähigkeiten und Arbeitsumgebungen auf.
Aus Sicht des Geschäftsmodells ist Mifeng der Ansicht, dass Crowdsourcing zunächst die Personalkosten auf der Erfassungsseite senken kann.
Bei der traditionellen zentralisierten Datenerfassung müssen speziell Erfassende eingestellt werden, die an festen Orten wiederholt Aufgaben ausführen.
Das Crowdsourcing-Modell zielt darauf ab, die Datenerfassung in das ursprüngliche Leben und die Arbeit der Teilnehmer einzubetten. Die Plattform zahlt nur für den zusätzlichen Datenbeitrag, nicht für die vollen Kosten der Einstellung eines vollzeitbeschäftigten Erfassers.
Dementsprechend steigt auch die Komplexität des Hintergrundbetriebs.
Zuerst müssen die Anforderungen der Modellunternehmen in Aufgaben zerlegt werden, die gewöhnliche Menschen verstehen können, wobei Aktionsschritte, Gerätepositionen, Erfüllungsstandards und Abnahmeregeln klar definiert werden müssen.
Die Plattform muss zudem über lokale Servicestationen grundlegende Schulungen, die Abholung und den Umlauf von Geräten durchführen, um Abweichungen bei der Bedienung durch verschiedene Erfassende so weit wie möglich zu reduzieren.
Einheitliche Geräte lösen einen Teil der Eingangsunterschiede. Daten, die die Erstprüfung bestehen, müssen anschließend durch Aktionssegmentierung, Annotation, Trajektorieextraktion und manuelle Stichprüfungen verarbeitet werden, bevor sie als nutzbare Daten für das Modell dienen können.
Mifeng teilt die Daten nicht einfach in „verwendbar“ und „unverwendbar“ ein, sondern stuft sie nach Qualität und Nutzungs Wert ein.
Daten mit offensichtlichen Aufnahmefehlern werden ausgeschlossen, die übrigen Daten können jeweils für Vortraining, Training spezifischer Aufgaben, Modellbewertung oder das Lernen von langschwänzigen Szenarien verwendet werden.
YAO Maoqing, Vorsitzender und CEO von Mifeng Technology, erklärt, dass mehr als 95 % der Daten, die die Erstprüfung der Abrechnung bestehen, nach der Nachverarbeitung letztendlich noch verwendet werden können.
Nach den von Mifeng veröffentlichten Daten erreichte die Anzahl der registrierten Nutzer innerhalb eines Monats der internen Testphase von Mifeng Pai 20.000, es wurden insgesamt 13.000 Aufgaben eingereicht, und der Teilnehmer mit dem höchsten Einkommen erzielte einen Monatsumsatz von über 5000 Yuan.
Je verteilter die Szenarien, desto komplexer der Betrieb
Dass Mifeng zu diesem Zeitpunkt eine Crowdsourcing-Plattform einführt, geht auf zwei gleichzeitige Veränderungen der nachgelagerten Datennachfrage zurück: Die Kunden benötigen immer größere Datenmengen, und die nachgefragten Szenarien werden immer detaillierter.
YAO Maoqing erklärt, dass das Ziel von einer Million Stunden nicht mehr ein Branchenversorgungsziel ist, sondern zu einer individuellen Trainingsanforderung einzelner Kunden geworden ist. Einige Kunden haben bereits Anforderungen im Umfang von Zehnmillionen Stunden gestellt, und einige führende Kunden verlangen sogar von Anbietern die Lieferung von 50.000 bis 100.000 Stunden pro Woche.
Aber wenn nur dieselbe Datenart zehnmal häufiger produziert wird, ist der Wert von Crowdsourcing immer noch begrenzt.
In der Vergangenheit konzentrierte sich die Erfassung von verkörperten Daten auf Haushaltszenarien, zahlreiche Teams erfassten wiederholt Aufgaben wie das Falten von Kleidung, diese Daten sind bereits nahezu gesättigt. Was immer knapper wird, sind neue Fähigkeiten, neue Umgebungen und neue Abläufe, die das Modell noch nie gesehen hat.
Mifeng erschließt tatsächlich Szenarien sowohl auf der Nachfrage- als auch auf der Angebotsseite.
Mifeng Technology gibt an, dass das Unternehmen regelmäßig Bewertungssitzungen für Produktionspläne abhält, um Marktaufträge zusammenzufassen, zunächst zu prüfen, welche Anforderungen durch vorhandene Datenbestände erfüllt werden können, und die fehlenden Teile dann nach Auftragswert und Ressourcenbedingungen auf verschiedene Erfassungswege zu verteilen.
YAO Maoqing erwähnt zudem, dass führende Kunden bereits gemeinsame Anforderungen an reale Szenarien, räumliche Genauigkeit und semantische Aktionsannotationen formuliert haben, die spezifischen Anforderungen werden aber weiterhin auf verschiedene Arbeitsschritte und Aktionen heruntergebrochen.
Zentralisierte Datenerfassungszentren können Standardumgebungen wie Küchen, Wohnzimmer und Schreibtische nachbilden, aber es ist kaum möglich, Szenarien wie Autoreparatur, Hoteldienstleistungen, landwirtschaftliche Produktion oder spezifische Fabrikproduktionslinien an einem festen Ort nachzubilden.
Wenn ein spezialisiertes Team diese Szenarien einzeln suchen muss, ist das kostspielig und langsam. Durch Crowdsourcing wird die Szenariosuche und Datenerfassung auf Menschen verteilt, die bereits in verschiedenen Branchen arbeiten – dadurch lassen sich langschwänzige berufliche Szenarien und ihre Bedienfähigkeiten leichter erreichen.
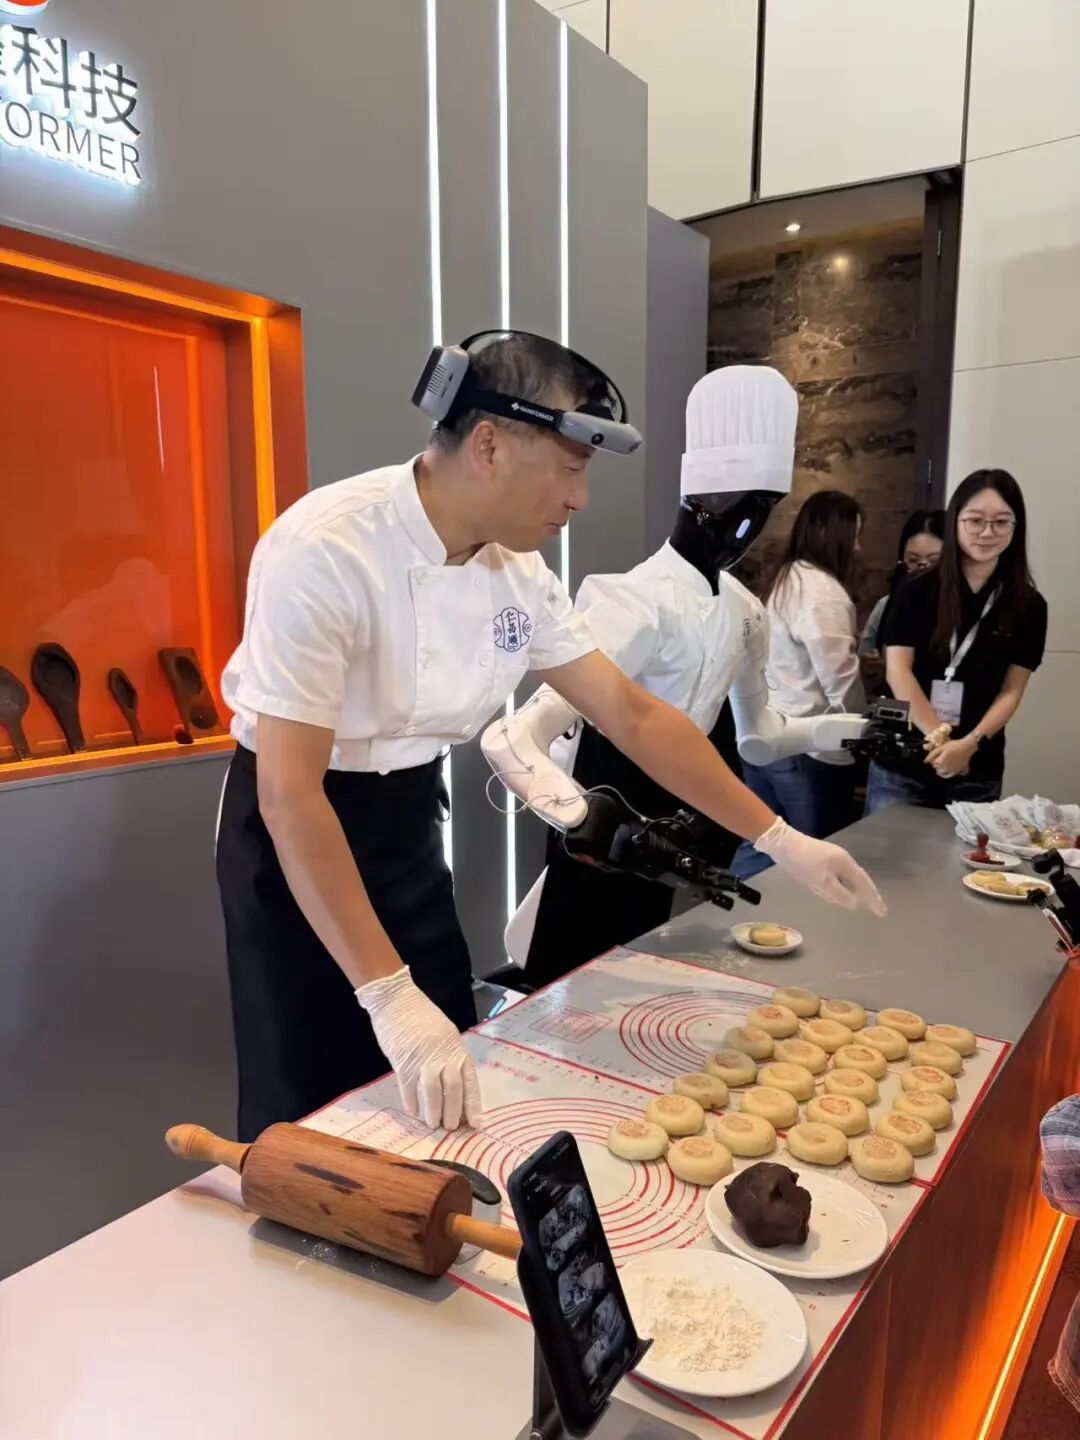
Gleichzeitig möchte Mifeng Technology mithilfe der „Szenariodatenallianz“ Szenarioanbieter wie Fabriken, Gemeinden, Hotels, Geschäfte und Logistikzentren im Voraus verbinden, um Fragen zu Sicherheit, Genehmigungen und Kooperationsbeziehungen zu lösen, bevor Kundenanforderungen eintreffen.
ZHANG Zhifu, Vice President für das Geschäft von Mifeng Pai, erwähnt zudem, dass die Plattform in Zukunft Erfassende möglicherweise nach ihrem Beruf und historischen Aufgaben zuordnet und die selbstständige Anmeldung von Szenarien ermöglicht, wobei die Plattform nach der Prüfung entscheidet, ob dies zu den nachgelagerten Anforderungen passt.
Nach seiner Erklärung ist es kaum möglich, allein mit dem internen Team der Plattform Tausende von Aufgaben aufzulisten, die sich zu erfassen lohnen. Menschen, die direkt in der Landwirtschaft, der Wartung oder der Produktion tätig sind, wissen am besten, welche Szenarien und Fähigkeiten sie zur Verfügung haben.
Was Mifeng letztendlich anstrebt, ist keine größere Datenerfassungsfabrik, sondern ein Szenarionetzwerk, das nach Aufträgen gesteuert werden kann.
Das macht den Betrieb auch zu einer der Kernkompetenzen von Unternehmen für verkörperte Daten.
YAO Maoqing geht davon aus, dass die Branche „Betriebsfähigkeiten sehr hoch bewerten wird“, wenn sie wirklich in die Phase der Skalierung und Rentabilität eintritt:
Es gilt einerseits die Datenlücken der Modellunternehmen in Aufgaben umzuwandeln, passende Personen und Szenarien zu finden, und andererseits die stark heterogenen Daten zu einheitlichen Spezifikationen zu verarbeiten, um die Liefertermine einzuhalten und gleichzeitig Kostenvorteile zu wahren.
Noch wichtiger ist, dass mit steigendem Einkaufsvolumen die Anforderungen der Kunden an Größe, Qualität und Lieferfähigkeit der Anbieter steigen. YAO Maoqing geht davon aus, dass sich die Anbieter von verkörperten Daten weiter konzentrieren und sogar eine Tendenz zur Oligopolisierung entstehen kann.
Mifeng gibt an, dass zur Unterstützung der Datenproduktion im Umfang von Zehnmillionen Stunden Anlagevermögen in Höhe von mehreren hundert Millionen Yuan in Erfassungsgeräte, Personalabrechnung, Datenspeicherung und Recheninfrastruktur investiert werden muss.
In der Industriekette könnte es in Zukunft zu einer weiteren Aufteilung der Arbeit in die Bereiche Hardware, Betrieb und Datennachverarbeitung kommen – aber die Abdeckung der gesamten End-to-End-Kette ist kein Geschäft, das gewöhnliche Startup-Teams leicht bewältigen können.
Zudem bedeutet die gleichzeitige Verwaltung von Dutzenden von Anbietern für Modellunternehmen, die Daten im Umfang von Millionen oder sogar Zehnmillionen Stunden benötigen, dass sie selbst die Unterschiede bewältigen müssen, die durch verschiedene Hardware, Formate und Qualitätssysteme entstehen.
Je mehr Anbieter es gibt, desto höher sind die Kosten für Datenbereinigung, Konvertierung und Trainingsvalidierung.
Mit anderen Worten: Die Szenarien können verteilt sein, aber die Schnittstelle zur Lieferung sollte idealerweise zentralisiert sein.
Ob es darum geht, das Datenvolumen zu vergrößern oder Szenarien zu verbinden – letztendlich wird nicht nur um aktuelle Aufträge gekämpft, sondern darum, vor der anhaltenden Veränderung der Nachfrage die ökologische Nische für Datenproduktion und Szenariozugänge zu besetzen.
Wer zahlt für die nächste hundert Millionen Stunden?
Die von Mifeng Pai vertretene Ego-Datenerfassung ohne eigenes Gerät dient derzeit hauptsächlich dem Vortraining von Unternehmen für verkörperte Intelligenz, Weltmodellunternehmen und allgemeinen großen Modellunternehmen.
Das Modell lernt aus menschlichen Handlungen die Beziehungen zwischen Objekten, Aktionen und Umgebungen, um die Abdeckung verschiedener Szenarien und Fähigkeiten zu erweitern.
Einfach ausgedrückt: Die Erfassung ohne eigenes Gerät löst die Frage, ob das Modell „genug gesehen hat“, die Erfassung mit echten Geräten löst die Frage, ob der Roboter die Aufgabe „konkret ausführen kann“.
YAO Maoqing erklärt, dass wenn nur ein Demo für eine bestimmte Aufgabe erstellt werden soll, die Erfassung von Daten mit dem Zielroboter direktere Ergebnisse liefert; Bei geringer Stichprobengröße verbessern Ego-Daten die Leistung bei einzelnen Aufgaben nicht wesentlich – ihr Wert zeigt sich erst bei steigendem Umfang in der Zero-Shot-Fähigkeit zur Generalisierung auf neue Aufgaben und neue Umgebungen.