Zweiter Platz der Tagesrangliste, Open-Source der Peking-Universität, einfachere Anbindung von Datenstrategien für verstärkendes Lernen und fairere Vergleichbarkeit
Welche Daten sollten in jeder Runde des Reinforcement Learning tatsächlich an das Modell übergeben werden?
Diese Frage wird mit der Weiterentwicklung von Inferenzmodellen und RLVR immer wichtiger. Da die Rolle des Reinforcement Learning im Nachtraining großer Modelle stetig zunimmt, muss auch sorgfältiger geplant werden, was das Modell trainiert und wie es trainiert wird. Eine Aufgabe kann anfangs sehr schwierig sein, aber nach einer gewissen Trainingszeit stabil richtig beantwortet werden. Welche Daten weiter beibehalten werden sollen und wie die Lerngewichte und die Verteilung der Domänen angepasst werden müssen, erfordern eine erneute Betrachtung in Abhängigkeit vom Trainingszustand des Modells.
Es gibt jedoch oft mehr als einen Ansatz für Datenstrategiemethoden, und es gibt noch einige praktische Probleme, um verschiedene Methoden klar zu vergleichen. Verschiedene Methoden haben jeweils eigene Implementierungen, und ein Wechsel der Filterregel kann die Änderung des Trainers erfordern. Beim Vergleich der Effekte sind Modell, Belohnungsfunktion und Trainingsbudget nicht unbedingt konsistent. Selbst wenn die Punktzahl steigt, ist es schwer zu beurteilen, ob der Nutzen tatsächlich aus der Datenstrategie oder aus anderen Trainingseinstellungen stammt.
Um die Probleme bei der Integration von Datenstrategien und dem Vergleich ihrer Effekte zu lösen, hat das DCAI-Team der Peking Universität gemeinsam mit der UCAS, dem Shanghaier Forschungsinstitut für Algorithmusinnovation und dem Zhongguancun-Institut kürzlich DataFlex-RL veröffentlicht.
GitHub Open-Source-Repository: https://github.com/haolpku/DataFlex-RL
Adresse des Papiers: https://huggingface.co/papers/2609.06107
Weniger Zeit mit wiederholten Änderungen am Trainer verbringen und mehr Energie darauf verwenden, zu überprüfen, ob die Datenstrategie wirksam ist – das ist der direkteste Wert von DataFlex-RL.
DataFlex-RL nutzt den Trainingsablauf von verl wieder und macht die Datenauswahl, die Neugewichtung von Stichproben und die Anpassung der Domänenverteilung zu konfigurierbaren Komponenten, sodass Entwickler drei Arten von Aktionen im selben RLVR/GRPO-Ablauf konfigurieren können:
- Auswählen, welche Rollouts an der aktuellen Aktualisierung teilnehmen;
- Bestimmen, welches Lerngewicht Stichproben oder Tokens zugewiesen wird;
- Entscheiden, aus welchen Domänen die nächste Datencharge entnommen wird.
Diese Strategien nutzen direkt Signale wie Belohnungen, Vorteile, Token-Wahrscheinlichkeiten und Prompt-Gruppierungen, die bereits im RL-Zyklus erzeugt wurden, während der Code für Rollout, Validierung und Strategieaktualisierung weitgehend unverändert bleibt.
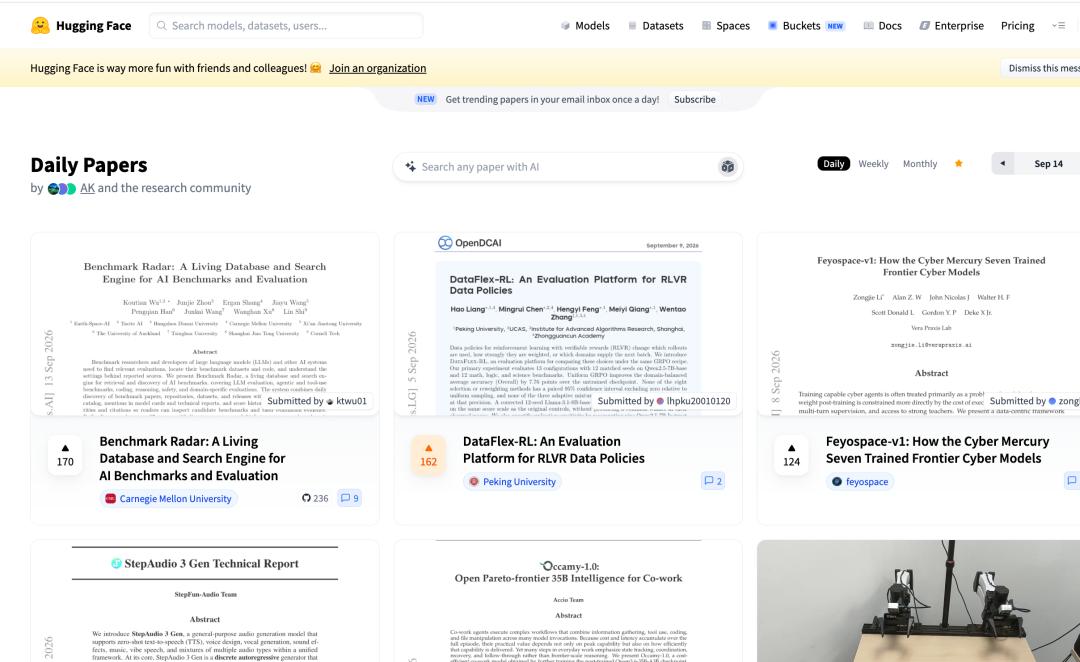
Nach der Veröffentlichung des Papiers erhielt es Aufmerksamkeit in der Gemeinschaft und wurde zu HuggingFace #2 Paper of the day. Im Papier wurden 591 Experimente durchgeführt, um Datenstrategien an verschiedenen Modellen sowie bei mathematischen, logischen und wissenschaftlichen Aufgaben zu prüfen.
Drei Dimensionen dynamischer Datenstrategien: Auswahl, Gewichtung, Mischung
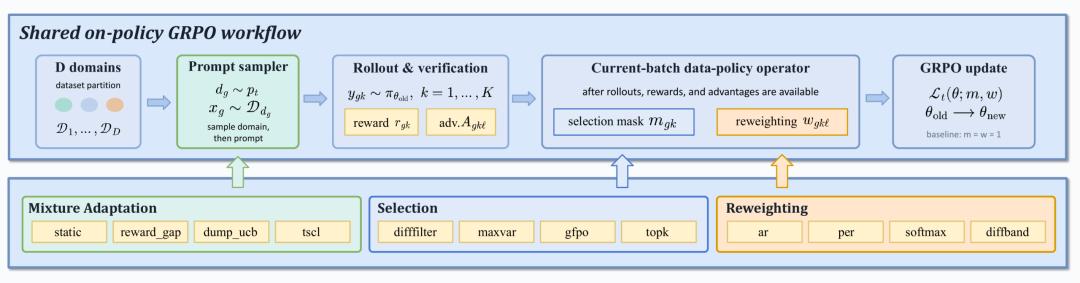
Beim GRPO-Training generiert das Modell mehrere Antworten für dieselbe Aufgabe, der Validator gibt Belohnungen aus und aktualisiert dann das Modell anhand der Unterschiede der Belohnungen innerhalb der Gruppe. DataFlex-RL unterteilt Datenstrategien in drei Kategorien: Die Auswahl bestimmt, welche Antworten an der aktuellen Aktualisierung teilnehmen, die Gewichtung passt ihren Beitrag zur Aktualisierung an, und die Mischung ändert die Domänenstruktur nachfolgender Chargen basierend auf historischen Rückmeldungen.
Datenauswahl: Steuern, welche Antworten an der Strategieaktualisierung teilnehmen
Die Lernsignale, die von Antworten generiert werden, die für dieselbe Aufgabe erstellt wurden, können sehr unterschiedlich sein. Bei GRPO, das auf Unterschieden der Belohnungen innerhalb der Gruppe basiert, kann eine Gruppe von Antworten, die alle richtig oder alle falsch sind, normalerweise kein unterscheidbares Advantage bilden.
DataFlex-RL unterstützt das Filtern nach der Lösungsrate innerhalb der Gruppe, dem Advantage-Ranking, der Belohnungsvarianz und der Antworteffizienz.
difffilter ist ein konkretes Beispiel: Für jede Aufgabe werden fünf Antworten generiert, und nur Gruppen mit einer Lösungsrate, die streng zwischen 0,2 und 0,8 liegt – also zwei oder drei richtige Antworten – werden beibehalten, sodass die Aktualisierung auf Aufgaben mittlerer Schwierigkeit konzentriert wird. maxvar behält die Teilmenge mit der größten Belohnungsvarianz innerhalb der Gruppe bei, gfpo wählt nach dem Verhältnis von Belohnung zu Antwortlänge aus, und topk behält die Antworten mit den höchsten Advantage-Amplituden bei.
Hier werden die bereits generierten Antworten gefiltert. Die aktuelle Implementierung steuert den Strategieverlust über 0/1-Gewichte, sodass die bereits angefallenen Generierungskosten nicht reduziert werden. Bei der Bewertung der Effizienz muss auch auf die tatsächliche Datenmenge geachtet werden, die an der Aktualisierung teilnimmt.
Dynamische Neugewichtung: Anpassen der Lernintensität verschiedener Stichproben
Manchmal möchten Forscher alle Antworten in der aktuellen Charge beibehalten und gleichzeitig einigen Stichproben ein größeres Aktualisierungsgewicht zuweisen – dafür wird die Neugewichtung verwendet.
DataFlex-RL unterstützt Gewichte auf Antwortebene und Token-Ebene: softmax und per passen den Beitrag der Antworten anhand der Advantage-Amplitude an, diffband gewichtet Stichproben, deren Belohnungen in einem festgelegten Quantilbereich liegen, und ar nutzt vorhandene Token-Wahrscheinlichkeiten, um niedrigen Wahrscheinlichkeitstokens relativ niedrige Gewichte zuzuweisen.
Diese Methoden normalisieren den Mittelwert der Gewichte auf 1, um Änderungen des gesamten Verlustmaßstabs so weit wie möglich zu kontrollieren.
Dynamische Domänenmischung: Anpassen der Verteilung basierend auf der historischen Leistung
Der Lernfortschritt bei mathematischen, logischen und wissenschaftlichen Aufgaben kann unterschiedlich sein, und ein festes Verhältnis ist nicht unbedingt für jede Phase geeignet. DataFlex-RL sammelt die Trainingsrückmeldungen jeder Domäne in einem gleitenden Fenster, und der Mischer aktualisiert dann das Zielverhältnis nachfolgender Chargen.
Die Mischstrategie sammelt zuerst Rückmeldungen in der Warmup-Phase und aktualisiert dann das Verhältnis in festgelegten Abständen. Das aktuelle Plugin wählt Stichproben aus den verfügbaren Proben nach Domänen über einen benutzerdefinierten Replay-Puffer aus. Die tatsächlich für das Training verwendeten Daten unterliegen zudem der Anzahl der Kandidaten in jeder Domäne, sodass sowohl das Zielverhältnis als auch die tatsächliche Datenverteilung beobachtet werden müssen.
Einheitliche technische Architektur: Flexible Integration von Datenstrategien in das Training
Die drei Arten von Strategien wirken an unterschiedlichen Stellen, müssen alle in den Trainingsablauf integriert werden, Rückmeldungen lesen und dann die Urteile in konkrete Aktionen umwandeln. DataFlex-RL wird über ein verl-Plugin in das Training integriert, nutzt vorhandene Signale wieder und trennt die Bewertung von der Ausführung, sodass Strategiekomponenten unabhängig voneinander ausgetauscht werden können.
Plugin-basierte Integration: Nutzung des verl-Trainingsablaufs
Um verschiedene Datenstrategien vergleichen zu können, müssen sie zuerst im selben Trainingsablauf ausgeführt werden. DataFlex-RL wird als Plugin in verl integriert und stellt seinen eigenen Trainer über einen Registrierungsmechanismus bereit.
Für Auswahl und Gewichtung liest das Plugin die Signale nach Abschluss der ursprünglichen Advantage-Berechnung aus, führt die Datenstrategie aus und schreibt die Ergebnisse dann in das vorhandene Feld rollout_is_weights von verl. Auswahl-Ergebnisse werden in 0/1-Gewichte umgewandelt, und Gewichtungsstrategien geben kontinuierliche Gewichte zurück – beide werden von der vorhandenen Schnittstelle für den Strategieverlust verarbeitet. Die Domänenmischung verwendet einen separaten Trainer und einen benutzerdefinierten Replay-Puffer, sammelt Rückmeldungen und wählt verfügbare Stichproben nach dem aktualisierten Domänenverhältnis aus.
Verschiedene Strategien teilen sich den Ablauf für Modellgenerierung, Belohnungsvalidierung und Modellaktualisierung, und Änderungen konzentrieren sich auf die Integrationsstelle der Datenstrategie. Wenn Entwickler neue Methoden hinzufügen, können sie diese Trainingsfunktionen weiterverwenden und ihre Hauptarbeit auf die Strategiekomponente konzentrieren. Das aktuelle Plugin ist auf die Trainer-Schnittstelle von verl v1 ausgerichtet. Vor der Verwendung muss überprüft werden, ob die Host-Version kompatibel ist und das Plugin ordnungsgemäß registriert werden kann.
Gemeinsame Nutzung von Trainingssignalen: Reduzierung doppelter Bewertungen
Nach der Integration in das Training benötigen die Strategien noch eine Grundlage für ihre Urteile. Belohnungen spiegeln die Leistung der Antworten wider, Advantage liefert Signale für die Strategieaktualisierung, und Token-Log-Protokolle zeichnen die Token-Wahrscheinlichkeiten auf. Diese Daten werden bereits während des Trainings erzeugt, sodass der Scorer sie direkt lesen und die erforderlichen Punktzahlen berechnen kann.
Die Strategien müssen keine zusätzliche Vorwärtsberechnung des Modells durchführen, um Bewertungen zu erstellen, und können denselben Code für die Signalverarbeitung wiederverwenden. Die gemeinsame Nutzung bezieht sich auf die Signalquelle und die Berechnungslogik – es ist nicht erforderlich, dass alle Strategien dieselbe Punktzahl verwenden. Für die Domänenmischung müssen die Rückmeldungen zudem nach Domänen zu historischen Statistiken summiert werden.
Während des Trainings werden zudem das Beibehaltungsverhältnis, die Gewichtungsstatistik, das Domänenzielverhältnis und die Rückmeldungen aufgezeichnet, um zu überprüfen, ob die Strategie wie erwartet funktioniert.
Trennung von Bewertung und Ausführung: Austausch von Strategien über Komponenten
Mit den Punktzahlen wird erst entschieden, wie diese verwendet werden. DataFlex-RL überträgt diese beiden Schritte an Scorer und Actuator. Der Scorer berechnet die Punktzahl anhand der Eingabesignale, und der Actuator wandelt die Punktzahl in Beibehaltungsindizes, kontinuierliche Gewichte oder Domänenverhältnisse um.
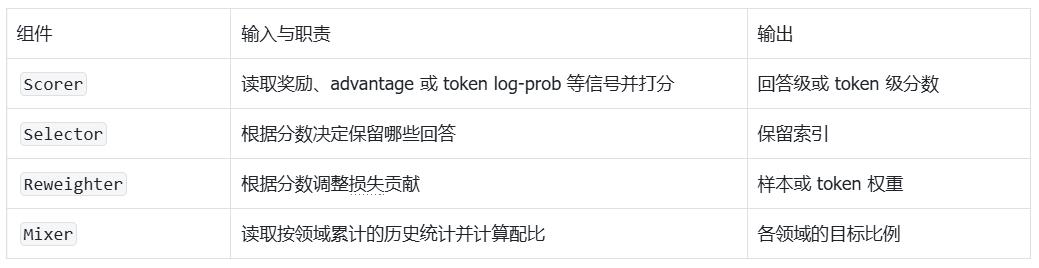
Mit den Punktzahlen wird erst entschieden, wie diese verwendet werden. Dieselbe Punktzahl der Advantage-Amplitude kann an topk zum Filtern übergeben werden oder an softmax, um kontinuierliche Verlustgewichte zu erzeugen.
Komponenten werden unter ihrem Namen registriert und dann über Konfiguration kombiniert: Wenn eine neue Filtermethode basierend auf vorhandenen Signalen hinzugefügt wird, muss normalerweise nur die Ausführungsregel implementiert werden; wenn eine neue Grundlage für Urteile benötigt wird, wird der Scorer erweitert.
Experimentelle Ergebnisse: Von grundlegenden Trainingsgewinnen bis zur dynamischen Datenscheduling
Insgesamt wurden 591 Experimente im Papier durchgeführt, die verschiedene Basismodelle sowie mathematische, logische und wissenschaftliche Aufgaben abdecken. Die Kernversuche wurden auf Qwen2.5-7B-base durchgeführt, umfassten 13 Konfigurationen mit jeweils 12 gepaarten Zufallsseeds und ergaben insgesamt 156 Läufe. Die Experimente bestätigten zuerst, dass GRPO das Modell effektiv trainieren kann, und beobachteten dann, wie die drei Arten von Datenstrategien am nachfolgenden Training teilnehmen.
Auf Qwen2.5-7B-base betrug die durchschnittliche Punktzahl des untrainierten Modells 42,01, die nach dem Training mit dem standardmäßigen GRPO-Baseline mit gleichmäßiger Stichprobenauswahl auf 49,77 anstieg – ein durchschnittlicher Anstieg von 7,76 Prozentpunkten. Auf Llama-3.1-8B-base stieg die Punktzahl des Modells ebenfalls von 10,87 auf 21,12, was einem durchschnittlichen Anstieg von 10,25 Prozentpunkten entspricht.
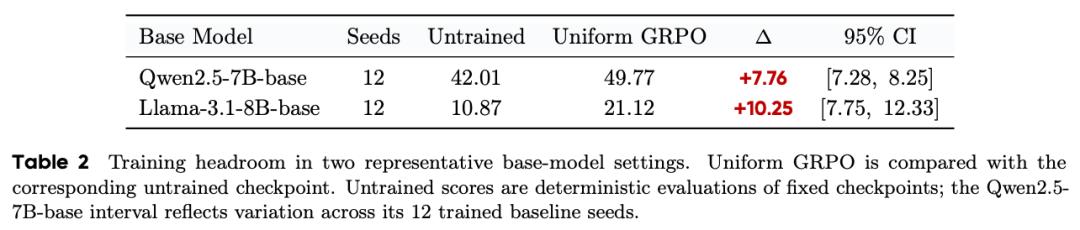
Diese Ergebnisse bilden den Bezugsrahmen für nachfolgende Experimente: GRPO bringt grundlegende Trainingsgewinne, und Datenstrategien planen weiter die Antworten, die Lerngewichte und die Domänenverteilung.
Die Experimente zur Auswahl und Neugewichtung umfassten difffilter, maxvar, gfpo, topk, ar, per, softmax und diffband. Sie passen die Trainingssignale aus Perspektiven wie Antwortfilterung, Stichprobengewichten und Token-Gewichten an und werden unter denselben Bedingungen für Modell, Daten und Trainingsbudget verglichen.
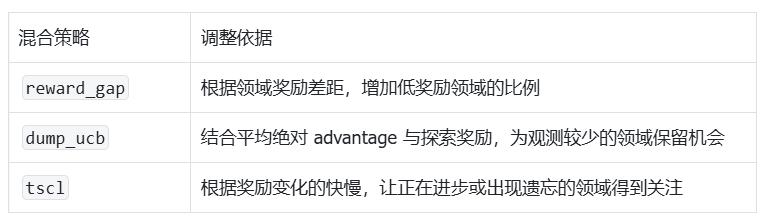
In den Experimenten zur Domänenmischung aktualisieren reward_gap, dump_ucb und tscl das Stichprobenverhältnis nachfolgender Chargen basierend auf dem Belohnungsunterschied der Domänen, den Explorationsrückmeldungen und der Geschwindigkeit der Trainingsänderungen. Im Vergleich zur festen gleichmäßigen Mischung betrugen die durchschnittlichen Anstiege der drei Methoden 0,45, 0,61 und 0