MiMo-V2.6 wurde gerade veröffentlicht, Luo Fuli von Xiaomi hat die neue MiMo-V3-Architektur vorgestellt, die mehrere Errungenschaften von DeepSeek referenziert.
Bericht von Zhidongxi am 24. September: Gestern Abend veröffentlichte Luo Fuli, der Leiter des großen Modells MiMo von Xiaomi, einen Artikel, in dem sie die neue Architektur von MiMo-V3 vorab offenlegte, deren Kernkomponente HySparse2 erstmals vorgestellt wurde, und die zugehörige technische Abhandlung wurde gleichzeitig veröffentlicht.
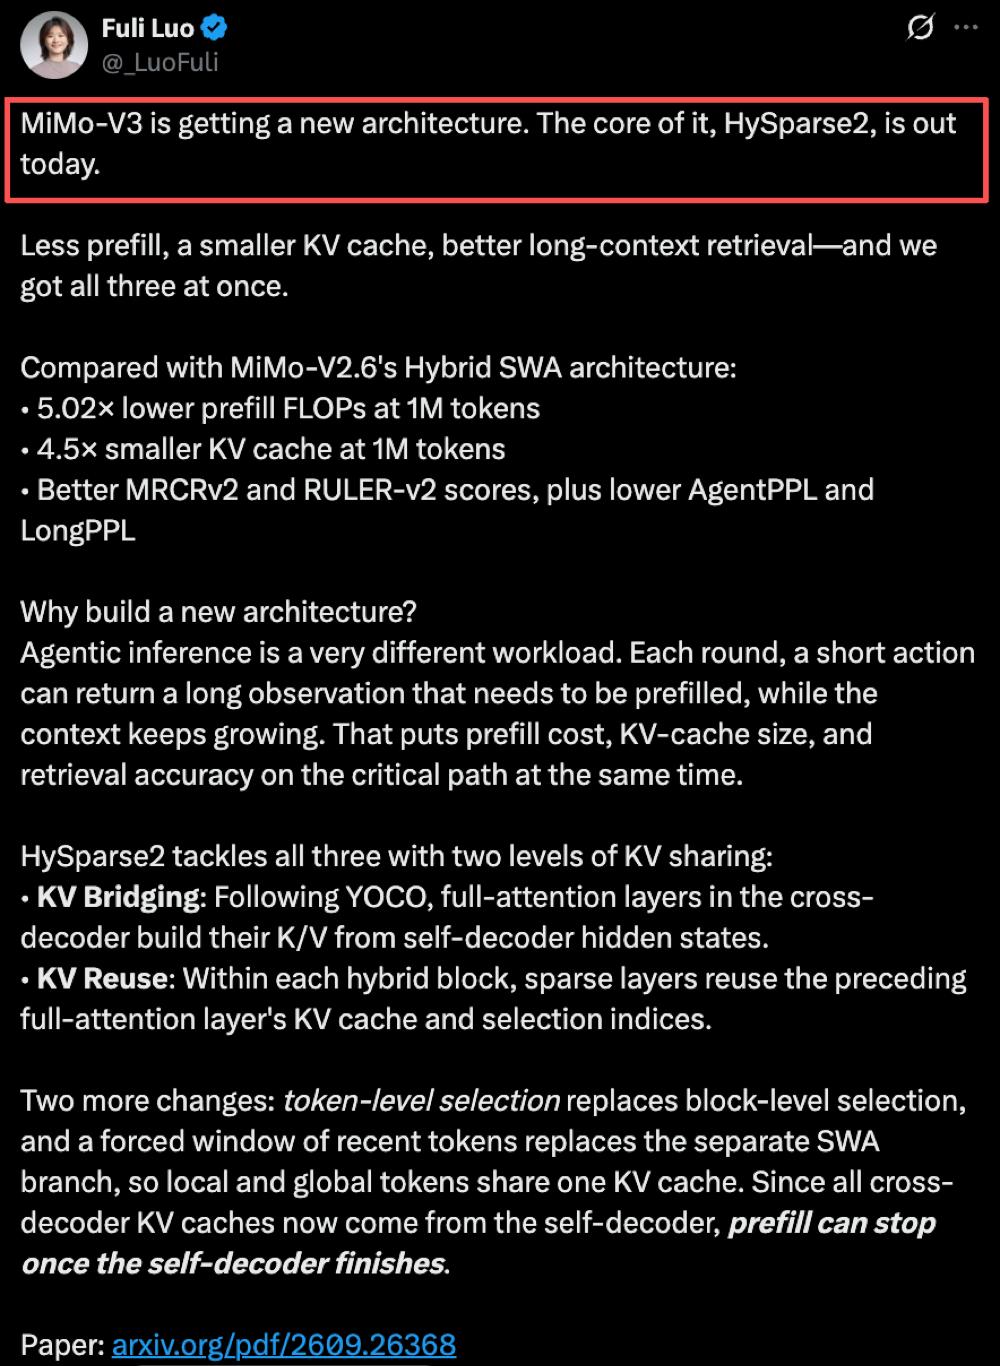
▲ Luo Fulis veröffentlichter Artikel
Im Einfachen gelöst diese neue Architektur hauptsächlich drei Probleme, die auftreten, wenn Agenten immer mehr Runden durchlaufen: Zu viele Berechnungen bei langen Eingaben, zu hoher Cache-Bedarf und die Frage, wie benötigte Informationen aus einem immer längeren Kontext präzise gefunden werden können.
Luo Fuli legte direkt eine Gruppe von Daten vor: Im Vergleich zur Hybrid-SWA-Architektur, die von MiMo-V2.6 verwendet wird, sinkt der für die Vorauffüllung (Prefill) bei der Verarbeitung langer Eingaben erforderliche Rechenaufwand von HySparse2 bei einem Kontext von 1 Million Token auf etwa 1/5, und der KV-Cache-Bedarf sinkt auf etwa 1/4,5; gleichzeitig verbessert sich die Leistung bei der Abfrage langer Kontexte weiter, und auch AgentPPL und LongPPL nehmen ab.
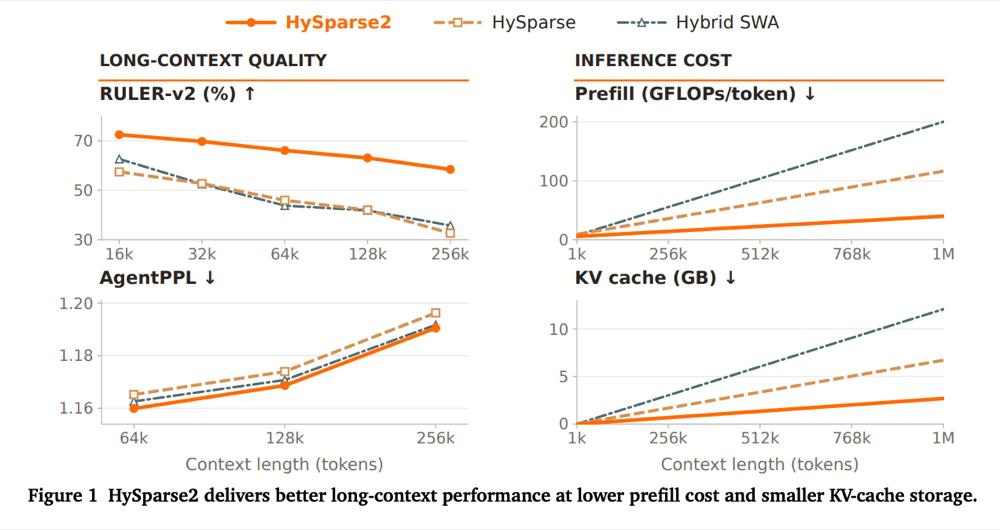
▲ Vergleich von HySparse2 bei der Leistung langer Kontexte, dem Prefill-Rechenaufwand und dem KV-Cache-Bedarf
Die Abhandlung zu HySparse2 wurde vom LLM-Core-Team von Xiaomi erstellt, es gibt insgesamt 15 Autoren, Luo Fuli ist die korrespondierende Autorin und wird als Team Lead gekennzeichnet. In den Literaturverweisen der Abhandlung tauchen auch viele in der Branche bekannte Ergebnisse auf.
Unter ihnen gibt es insgesamt 4 Ergebnisse im Zusammenhang mit DeepSeek, darunter DeepSeek-V2, DeepSeek-V3.2, DeepSeek-V4 und DeepSeek-V4.1-Flash; außerdem sind die gpt-oss-Modellkarte von OpenAI und die zugehörigen Bewertungsarbeiten zu GPT-4.1 in den Zitaten enthalten.
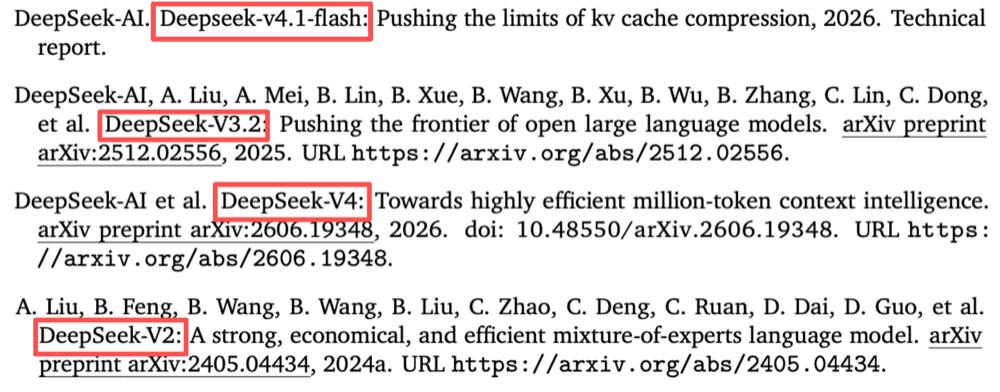
▲ 4 DeepSeek-bezogene Ergebnisse, die in der HySparse2-Abhandlung zitiert werden
Es ist bemerkenswert, dass seit der letzten Modellaktualisierung von Xiaomi erst zwei Tage vergangen sind.
Am 22. September veröffentlichte das große Modellteam von Xiaomi gerade die neue Generation der Serie Xiaomi MiMo-V2.6 und machte sie quelloffen, und kündigte an, dass MiMo-V2.6-Pro-UltraSpeed schrittweise freigegeben wird. Im Vergleich zu MiMo-V2.6-Pro erhöht das letztere die Ausgabegeschwindigkeit bei gleichem Intelligenzniveau um das 20-fache.
Xiaomi machte außerdem gleichzeitig die RL-Umgebung, das Framework und den technischen Bericht zum Modell für das Training des neuen Modells quelloffen. Luo Fuli erklärte damals, dass MiMo-V2.6 auf die groß angelegte RL-Erweiterung setzt und das bisher größte einzelne RL-Training eines quelloffenen Modells durchgeführt hat, das Team betrachtet es als einen neuen Schritt zur Erkundung von RSI (rekursive Selbstverbesserung) auf dem Weg zu AGI.
Gerade hat MiMo-V2.6 das groß angelegte RL in den Vordergrund gerückt, diesmal richtet Xiaomi den Fokus auf die unterste Architektur des Modells.
01.
Mehrrunden-Aufgaben von Agenten
führen zu höheren Kosten für lange Eingaben
Das Problem, das HySparse2 löst, hängt mit einem immer typischeren Arbeitsmodus von Agenten zusammen: Die vom Modell generierten Aktionen sind sehr kurz, aber die von Tools zurückgegebenen Inhalte können sehr lang sein.
Zum Beispiel kann ein Agent nur eine Suchanweisung oder einen einzigen Tool-Aufruf generieren, danach gibt die Suchmaschine ein langes Dokument zurück, und das Codetool gibt eine große Anzahl von Laufprotokollen zurück. Bevor das Modell die nächste Runde der Schlussfolgerung durchführt, muss es diese neu hinzugefügten Inhalte zuerst verarbeiten.
Dieser Prozess ist Prefill, also die Vorauffüllung.
Wenn der Agent nacheinander Tools wie Suche, Codeausführung und Dateilesen aufruft, gelangen Dokumente, Webseiten und Laufaufzeichnungen ständig in den Kontext. Das Modell muss diese neu hinzugefügten Eingaben wiederholt verarbeiten, einen immer größeren KV-Cache speichern und aus Hunderttausenden oder sogar Millionen von Token an historischen Informationen den Inhalt finden, der derzeit wirklich benötigt wird.
Daher fasst die Abhandlung die Probleme zusammen, denen die langfristige Agent-Schlussfolgerung gegenübersteht, in drei Aspekten zusammen: Verringerung des Prefill-Rechenaufwands, Verringerung des KV-Cache-Bedarfs und Erhöhung der Genauigkeit bei der Abfrage langer Kontexte.
Die vorherige Generation von HySparse hat bereits eine Runde Optimierung durchgeführt. Sie ordnet volle Aufmerksamkeitsebenen und spärliche Aufmerksamkeitsebenen abwechselnd an, die nachfolgenden spärlichen Ebenen können den KV-Cache und die Auswahlindizes wiederverwenden, die von der vorherigen vollen Aufmerksamkeitsebene generiert wurden, wodurch Aufmerksamkeitsberechnungen und Cache-Bedarf reduziert werden. Allerdings muss HySparse in der Prefill-Phase noch alle Netzwerkebenen nacheinander ausführen.
Bei HySparse2 verkürzt Xiaomi weiter den Ausführungspfad von Prefill: Bei der Verarbeitung langer Eingaben kann das Modell nach dem Durchlaufen der ersten Hälfte die Erstellung des KV-Caches abschließen, der für die nachfolgende Schlussfolgerung erforderlich ist.
02.
Zweistufige KV-Freigabe
lässt das Modell die Hälfte der Schritte überspringen
Der Kern zur Umsetzung dieses Punkts ist die zweistufige KV-Freigabe, die von HySparse2 verwendet wird.
Die erste Ebene heißt KV Bridging.
HySparse2 teilt den Hauptteil des Modells in zwei Teile: Self-Decoder und Cross-Decoder. Ersterer besteht aus voller Aufmerksamkeit und gleitender Fensteraufmerksamkeit, Letzterer besteht aus voller Aufmerksamkeit und spärlicher Aufmerksamkeit.
Im Cross-Decoder können die vollständigen Aufmerksamkeitsebenen beim Generieren von K und V direkt die versteckten Zustände verwenden, die von den entsprechenden vollen Aufmerksamkeitsebenen im Self-Decoder erzeugt wurden. Dadurch muss die zweite Hälfte nicht mehr alle Token der vorherigen Eingabe vollständig verarbeiten.
Die zweite Ebene ist KV Reuse.
Nach dem Eintritt in den Cross-Decoder werden das KV-Cache und die Token-Auswahl, die von einer vollen Aufmerksamkeitsebene generiert wurden, weiterhin für mehrere nachfolgende spärliche Aufmerksamkeitsebenen zur Wiederverwendung bereitgestellt. Nach der Überlagerung der zweistufigen Freigabe kann der gesamte für den Cross-Decoder erforderliche KV-Cache basierend auf den versteckten Zuständen des Self-Decoders erstellt werden.
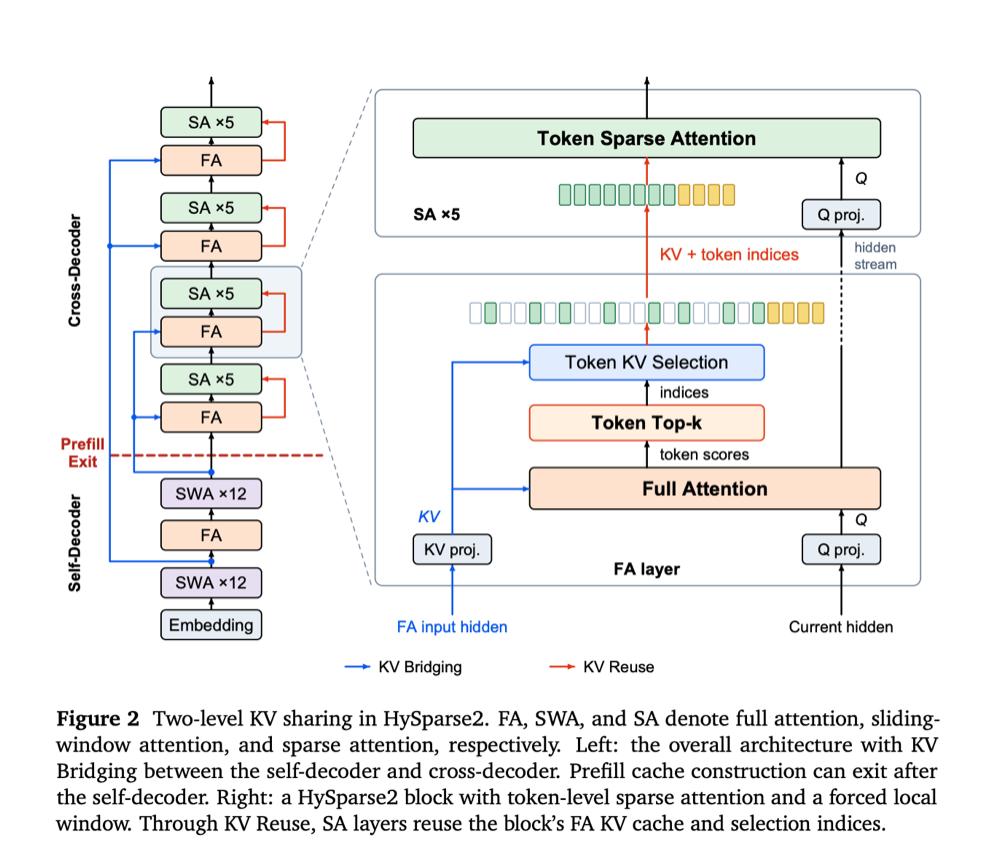
▲ Die zweistufige KV-Freigabearchitektur von HySparse2
Nach Abschluss der Ausführung des Self-Decoders kann Prefill beendet werden, ohne dass die zweite Hälfte einmal vollständig eine lange Eingabe durchlaufen muss.
HySparse2 passt auch die Methode zum Suchen von Informationen in langen Kontexten an.
Die vorherige Generation von HySparse verwendet die Auswahl auf Blockebene, d.h. es wird jeweils ein ganzer zusammenhängender Block von Token ausgewählt. HySparse2 ändert dies in die Auswahl auf Tokenebene, sodass relevante Token direkt aus verschiedenen Positionen im Kontext gesucht werden können.
Diese Änderung eignet sich besser für Mehrrunden-Aufgaben von Agenten. Zum Beispiel kann eine wirklich nützliche Information in einer sehr frühen Rückgabe eines Tools verborgen sein; bei der Lösung auf Blockebene muss man zur Extraktion eines einzelnen Tokens auch den gesamten umliegenden Block verarbeiten; die Lösung auf Tokenebene kann direkt die benötigte Position auswählen.
Die Ablationsversuche der Abhandlung zeigen, dass unter dem gleichen Aufmerksamkeitsbudget die Lösung auf Tokenebene höhere Werte bei Tests zur Abfrage langer Kontexte und Graphschlussfolgerung wie RULER-v2, MRCR-v2 und GraphWalks erzielt.
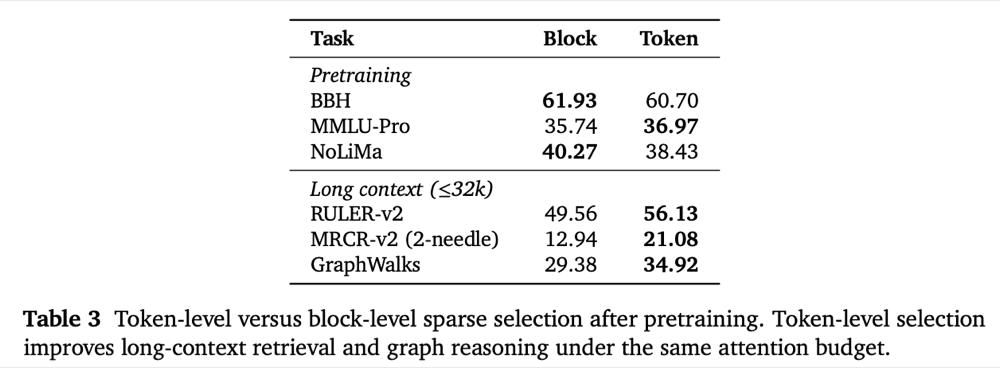
▲ Vergleich der Effekte der spärlichen Auswahl auf Tokenebene und Blockebene
HySparse2 entfernt gleichzeitig den separaten SWA-Zweig im Cross-Decoder und ändert ihn zu einem erzwungenen Beibehalten des jüngsten Kontextabschnitts.
In den Versuchen der Abhandlung werden jeweils fest die jüngsten 128 Token beibehalten, und dann werden 1024 Token aus dem früheren Kontext ausgewählt. Auf diese Weise können aktuelle Informationen und weit entfernte Informationen denselben KV-Cache gemeinsam nutzen, was zusätzlichen Cache reduziert.
Am Beispiel des 49-schichtigen Modells, das in der Abhandlung gezeigt wird: Bei der getrennten Bereitstellung von Prefill und Decode müssen im Prefill-Knoten nur die ersten 25 Schichten bereitgestellt werden, das erforderliche Modellgewicht ist fast halbiert; in dieser Phase muss nur eine volle Aufmerksamkeitsebene ausgeführt werden.
03.
Bei langen Kontexten und Agent-Aufgaben ist die Leistungssteigerung deutlicher
Um HySparse2 zu validieren, trainierte das Team von Xiaomi eine Gruppe von 80B-A3B-MoE-Modellen und verglich sie mit der vorherigen Generation von HySparse sowie der Hybrid-SWA, die von der MiMo-V2-Serie verwendet wird.
Die drei Gruppen von Modellen verwenden dieselben Daten und Trainingspläne, nur die Aufmerksamkeitsarchitektur ist unterschiedlich. Zuerst wird das Modell mit etwa 500 Milliarden Token vortrainiert, die Kontextlänge beträgt 32K; danach wird es mit etwa 100 Milliarden Token leicht nachtrainiert, und die Kontextlänge wird auf 256K erweitert.
Die Testergebnisse zeigen, dass die deutlicheren Verbesserungen von HySparse2 sich auf die Abfrage langer Kontexte und Agent-Aufgaben konzentrieren.
Nach dem Nachtraining verbessern sich die durchschnittlichen Werte von HySparse2 bei MRCR-v2 und RULER-v2 im Vergleich zu HySparse um 11,30 bzw. 19,81 Prozentpunkte; im Vergleich zu Hybrid-SWA verbessern sie sich um 6,44 bzw. 18,65 Prozentpunkte.
Bei einem Kontext von 256K erreicht der RULER-v2-Wert von HySparse2 58,45, der von HySparse beträgt 32,61 und der von Hybrid-SWA 35,74.
Gleichzeitig liegen AgentPPL und LongPPL von HySparse2 bei allen in der Abhandlung getesteten Kontextlängen unter denen der beiden anderen Architekturen.
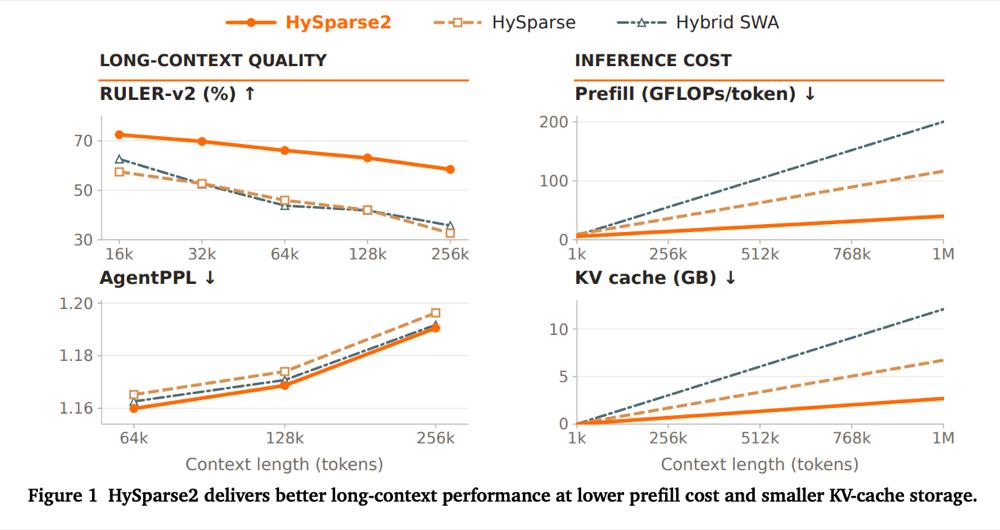
▲ Die Leistung von HySparse2 bei langen Kontexten und Agent-Aufgaben
Der Unterschied bei Berechnung und Cache ist noch direkter.
Bei einem Kontext von 1 Million Token sinken die Prefill-FLOPs von HySparse2 im Vergleich zu HySparse auf etwa 34 % und im Vergleich zur Hybrid-SWA, die von der MiMo-V2-Serie verwendet wird, auf etwa 20 %.
Unter denselben Bedingungen beträgt der KV-Cache-Bedarf von HySparse2 2,69 GB, der von HySparse beträgt 6,72 GB und der von Hybrid-SWA erreicht 12,09 GB. Umgerechnet sinkt der Cache-Bedarf von HySparse2 im Vergleich zu Hybrid-SWA auf etwa 1/4,5.
