Mindestens 0,54 US-Dollar pro Stunde, Google beginnt, Ton zu „photoshopen“.
Nach der Erweiterung der Echtzeit-Sprachinteraktion und der Sprachtranskription hat Google seine Produktpalette nun auch auf den Bereich der Klangerzeugung ausgeweitet.
Am 23. September Ortszeit in den USA hat Google offiziell die beiden Text-to-Speech-Modelle Gemini 3.8 Flash TTS und Gemini 3.8 Flash-Lite TTS vorgestellt. Google definiert sie als ausdrucksstarke Audiosynthesemodelle, die darauf abzielen, die Sprachgenerierung von statischen voreingestellten Klangfarben hin zu einem Klangdesign mit tiefgreifenden Steuerungsmöglichkeiten weiterzuentwickeln.
Derzeit sind beide Modelle in der Gemini API und im Google AI Studio verfügbar, in Gemini Notebook und Google Vids integriert, und der unternehmensweite API-Zugang wurde gleichzeitig gestartet.
In dem für diese Veröffentlichung verantwortlichen Team taucht der Name Alan Cowen auf.
Cowen war zuvor Gründer von Hume AI, einem Technologie-Startup, das sich auf „Empathic AI“ spezialisiert, und trat in diesem Jahr als Direktor für Forschungswissenschaften bei Google DeepMind ein. Zusammen mit Leland Rechis, Produktmanager des Konzerns, leitete er die Entwicklung und Veröffentlichung dieses Sprachprojekts.
Vor dem Hintergrund, dass Sprachunternehmen wie ElevenLabs ihren kommerziellen Markt ständig ausweiten, verbessert Google mit dieser Veröffentlichung die Steuerungsfähigkeit von Sprachmodellen und versucht, die Sprachgenerierungsfunktionen über die API und das bestehende Produktökosystem in mehr Anwendungsbereiche zu bringen.
01 Von „Auswahl eines Klangs“ zu „Gestaltung eines Klangs“
Im Vergleich zu früheren TTS-Modellen, bei denen Klangstil und -rhythmus hauptsächlich über Text-Prompts und Audiotags gesteuert wurden, konzentriert sich die Gemini 3.8-Serie auf die Gestaltung der Klangidentität und die zeilenweise Ausführung.
Die beiden vorgestellten Modelle haben unterschiedliche Schwerpunkte: Das Flaggschiffmodell Gemini 3.8 Flash TTS richtet sich vor allem an anspruchsvolle Kreativ- und Charakterdesignaufgaben und deckt Anwendungsbereiche wie Spiele, immersive Hörbücher und Podcasts ab. Die leichtgewichtige Version Gemini 3.8 Flash-Lite TTS ist auf Anforderungen mit hoher Parallelverarbeitung und Stapelverarbeitung ausgelegt und eignet sich vor allem für die Synchronisation von Langvideos, die Erstellung von Audioinhalten und sprachgesteuerte KI-Agenten im Kundenservice.
Auf Fähigkeitsebene zeigt Flash TTS folgende Veränderungen:
· Zuerst die Generierung von Stimmen in natürlicher Sprache (Generative Voice Design). Ohne vorherige Aufnahmen können Nutzer die Merkmale, das Alter, den Akzent und die Klangfarbe einer Figur in natürlicher Sprache beschreiben (z. B. „ein erschöpfter Berliner um 2 Uhr nachts, der Englisch mit starkem deutschem Akzent spricht“), woraufhin das Modell die entsprechende Klangfarbe generiert.
· Zweitens die Stimmreproduktion (Voice Replication). Laut offiziellen Angaben unterstützt das Modell die Stimmreproduktion anhand einer Referenzaufnahme von etwa 30 Sekunden, um die Stimmmerkmale zu extrahieren.
Gleichzeitig unterstützt das Modell die zeilenweise Steuerung von Drehbüchern und nichtsprachliche Ausdrücke. Nutzer können in das Textskript Regieanweisungen (Stage Directions) einfügen und Ausdrücke wie <laughs> (Lachen), <sigh> (Seufzen), <gasp> (Keuchen) sowie Füllwörter wie |mhm| einfügen, um Pausen und Tonhöhenschwankungen im menschlichen Gespräch zu simulieren.
Schließlich die Konsistenz der Stimmfarbe bei Zweierdialogen und langen Audiodateien. Nutzer können anhand eines Skripts abwechselnde Dialoge zwischen zwei Personen generieren und Tonfall sowie Rhythmus beider Seiten steuern. Für die Generierung langer Audiodateien hat Google die Konsistenz der Stimmfarbe optimiert, um Abweichungen der Klangfarbe während der fortlaufenden Generierung zu reduzieren.
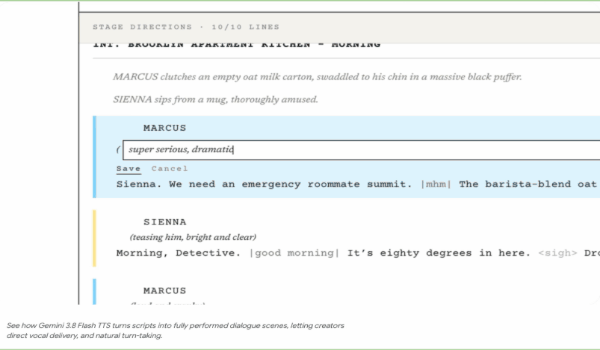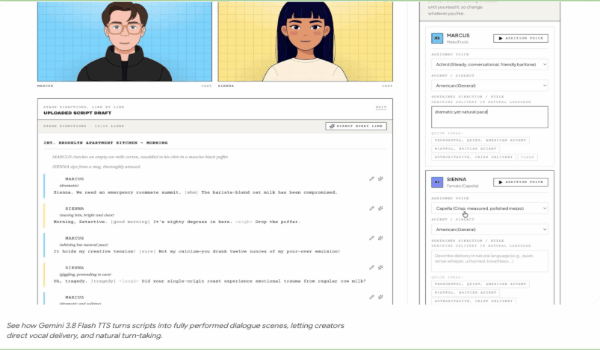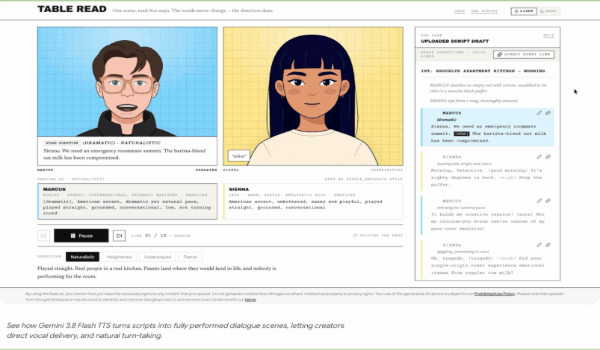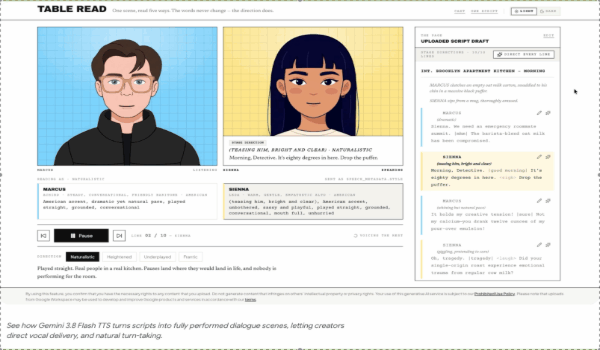
Gemini 3.8 Flash TTS wandelt hochgeladene Drehbücher in Stimmen verschiedener Charaktere um
02 Hohe Benchmark-Werte, aber die praktische Nutzung unterliegt noch Grenzen
Aus den von Google veröffentlichten Testergebnissen geht hervor, dass Gemini 3.8 Flash TTS bei zahlreichen Bewertungen zur Sprachgenerierung hohe Werte erzielt hat.
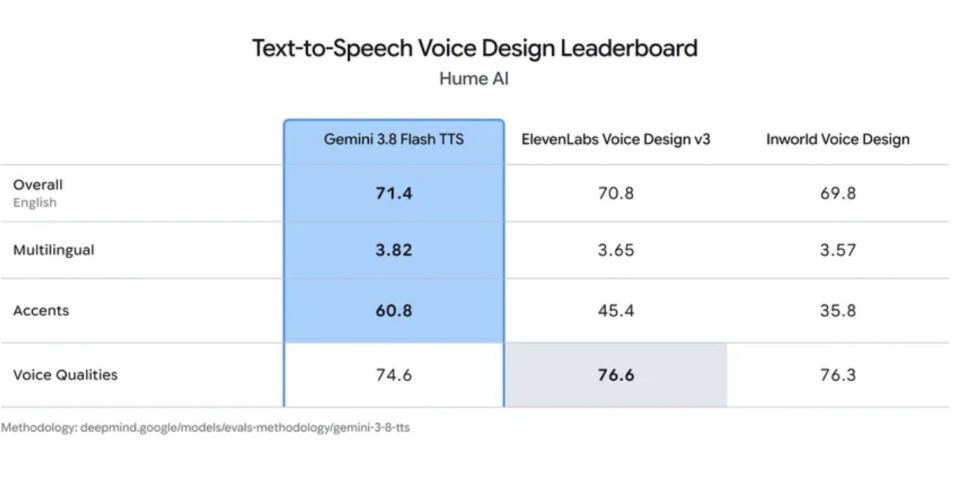
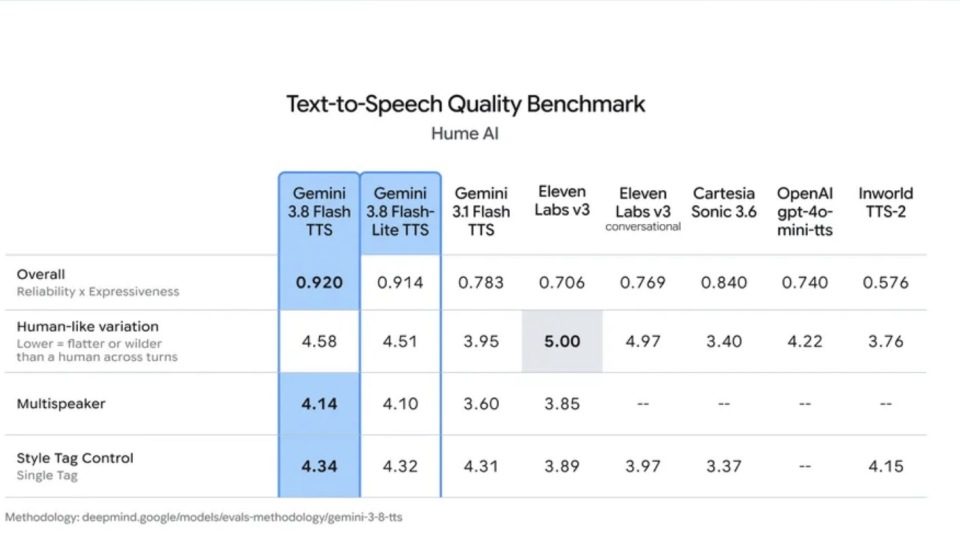
Im Test des Hume AI Voice Design Benchmarks erzielte Flash TTS einen Gesamtwert von 71,4 Punkten und 60,8 Punkte in der Dimension der Akzentmodellierung; im Hume AI Overall Quality Index belegen Flash TTS und Flash-Lite TTS die ersten beiden Plätze.
Darüber hinaus erzielten die beiden Modelle in den doppelblinden Präferenztests von Voice Arena hohe Gewinnquoten bei der Bewertung in mehreren Sprachen wie Japanisch, modernes Standardarabisch, Mexikanisches Spanisch und Hindi.
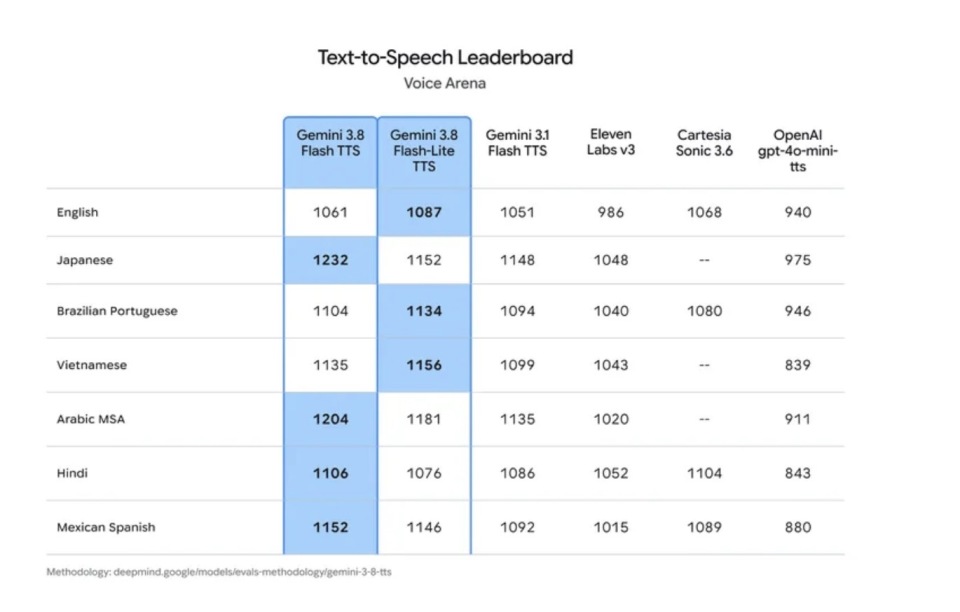
Die Ergebnisse der Benchmark-Tests stellen jedoch nicht vollständig die praktische Erfahrung in der Produktion dar.
Das Technologiemedium Unfiltered AI und die zugehörige Plattform für Branchenanalysen weisen in ihrer Bewertung darauf hin, dass die neuen Modelle zwar bei bestimmten komplexen Akzenten und der Steuerung dynamischer Emotionen hervorragende Leistungen erbringen, in einigen hochfrequenten Audiobereichen jedoch noch geringe synthetische Störgeräusche beobachtet werden können; in der späten Phase der fortlaufenden Wiedergabe extrem langer Texte traten bei wenigen Beispielen auch leichte Abweichungen der Stimmfarbe auf.
Zugleich zeigt das von Google veröffentlichte Model Card, dass die neuen Modelle noch Probleme aufweisen können, die bei generativen Audiomodellen häufig auftreten, wie Abweichungen vom Ausgangstext oder ungewöhnliche Aussprache, und bei hoher Auslastung auch Verzögerungen bei der Antwort oder Zeitüberschreitungen auftreten können.
03 Google beginnt mit einer Preisoffensive
Neben der Verbesserung der Modellsteuerung ist der Preis einer der weiteren Schwerpunkte von Google bei dieser Veröffentlichung.
Bei der Preisgestaltung können Entwickler bis Ende 2026 folgende Preise für API-Aufrufe in Anspruch nehmen: Der Preis für die Texteingabe von Flash TTS beträgt 0,50 USD pro Million Token, der Preis für die Audioausgabe 9,00 USD pro Million Token; die Texteingabe von Flash-Lite TTS kostet ebenfalls 0,50 USD pro Million Token, während der Preis für die Audioausgabe auf 6,00 USD pro Million Token gesenkt wird.
Gemäß der von Google angegebenen Umrechnungsmethode zwischen Token und Audiodauer (eine Sekunde generiertes Audio entspricht etwa 25 Audio-Token) betragen die reinen Ausgabekosten für die fortlaufende Generierung einer Stunde Audio bei Flash TTS etwa 0,81 USD und bei Flash-Lite TTS etwa 0,54 USD (umgerechnet etwa 3,8 Yuan).
Selbst bei Umrechnung nach den ab 2027 geltenden Standardpreisen (Flash TTS steigt wieder auf 18 USD pro Million Token, Flash-Lite TTS auf 12 USD pro Million Token) liegen die entsprechenden Ausgabekosten für eine Stunde Audio auf einem relativ niedrigen Niveau.
Die genannten Kosten stellen jedoch nur die theoretische Umrechnung der Audio-Ausgabe-Token dar und beinhalten keine zusätzlichen Aufwendungen wie für wiederholte Aufrufe zur Qualitätsverbesserung.
04 Die Logik hinter Googles „Audio-PS“
Für Entwickler und Unternehmen können die Modelle über die Gemini API und Google AI Studio aufgerufen und bereitgestellt werden. Für Endanwendungen und den Bürobereich ist Flash TTS in Gemini Notebook (ein Tool für Notizen und Wissensdatenbankanalysen) integriert, während Flash-Lite TTS direkt in Google Vids (ein KI-Videoproduktionstool) eingebettet ist.
Auf diese Weise beschränkt sich der Wettbewerb um TTS nicht mehr nur auf Modellparameter und punktuelle Klangqualität, sondern erstreckt sich auf APIs, Büroanwendungen und das gesamte Ökosystem von KI-Produkten.
Da die erforderliche Dauer der Probenaufnahmen für die Stimmreproduktion auf etwa 30 Sekunden gesunken ist, ist die Einrichtung eines umfassenderen Systems für Genehmigungsverfahren, Verantwortlichkeitszuweisung und Urheberrechtsschiedsgerichtsbarkeit eine Aufgabe, der sich die gesamte Branche langfristig stellen muss.
Google hat bei der Veröffentlichung auch Schutzmaßnahmen vorgesehen.
Bei dem Mechanismus der informierten Einwilligung verlangt Google, dass die Person, deren Stimme reproduziert werden soll, vor der Durchführung der Stimmreproduktion zunächst eine mündliche Genehmigungserklärung aufnimmt. Das System vergleicht die Aufnahme der Genehmigung mit der Referenzaufnahme anhand von Stimmmerkmalen und bestätigt die Übereinstimmung, bevor die Generierung durchgeführt wird.
Im Hinblick auf digitales Wasserzeichen und Rückverfolgbarkeit sind alle von Gemini Audio generierten Audiodateien mit einem für das menschliche Auge und Ohr nicht wahrnehmbaren SynthID-Audiowasserzeichen versehen und mit einem C2PA-Digitalzertifikat ausgestattet, um Rückverfolgungsinformationen zu den generierten Inhalten bereitzustellen.
Darüber hinaus hat Google derzeit Einschränkungen für die Verfügbarkeit der Stimmreproduktionsfunktion in bestimmten Regionen festgelegt: Sie ist vorübergehend nicht verfügbar in den US-Bundesstaaten Illinois und Texas, im Europäischen Wirtschaftsraum (EWR), im Vereinigten Königreich, in der Schweiz und in Indien.
Der freie Übersetzer Wuji hat ebenfalls zu diesem Artikel beigetragen
Dieser Artikel stammt von „Tencent Tech“, Autor: Su Yang, Redakteur: Xu Qingyang, veröffentlicht mit Genehmigung von 36Kr.