GPT-6 erreicht bis zu 90 % Kosteneinsparung bei gecachten Eingaben – wieso bekommen Sie keinen 90 % Rabatt auf Ihre Rechnung?
Sind Sie jemals in einer solchen Situation gewesen:
Übergeben Sie einen Stapel von Materialien an die KI, lassen Sie sie Berichte schreiben, Quellen überprüfen und anschließend eine PPT erstellen.
Nachdem die erste Version fertig ist, finden Sie die Struktur unpassend und tippen ein paar Worte in das Dialogfeld: „Stellen Sie die Schlussfolgerungen ganz vorne an“;
Nachdem die zweite Version herauskommt, fällt Ihnen eine weitere Idee ein und Sie fügen hinzu: „Fügen Sie noch eine Seite mit dem Wettbewerbsvergleich hinzu“.
Auf Ihrer Oberfläche haben Sie lediglich zwei Sätze mehr eingegeben.
Aber im Hintergrund übergibt die Anwendung bei jeder zusätzlichen Anfrage möglicherweise die ursprünglichen Materialien, die Aufgabenbeschreibung und den Chatverlauf erneut an das Modell. Wenn diese alten Inhalte nicht im Cache getroffen werden, müssen sie neu verarbeitet werden.
Sie haben nur zwei Sätze geändert, aber im Hintergrund werden die bereits gelesenen Materialien möglicherweise erneut berechnet. Jedes erneute Lesen verbraucht Ihre Rechenkosten und Ihre Wartezeit.
Diese im Hintergrund verborgenen wiederkehrenden Ausgaben sind genau das Problem, auf das das jüngste Upgrade von OpenAI abzielt.
Am 22. September hat OpenAI das schwerwiegende Upgrade des GPT-6-Prompt-Caching veröffentlicht, das die Standard-Cache-Trefferquote verbessert und detailliertere Überwachungs-, Diagnose- und Steuerungsmöglichkeiten bietet.
Wie viel kann man sparen?
Berechnet nach den offiziell veröffentlichten Tarifen: Wenn dasselbe Material 10 Mal nacheinander verwendet wird und nach dem ersten Schreiben alle 9 nachfolgenden Zugriffe den Cache treffen, lassen sich theoretisch 78,5 % der Kosten für diese wiederholte Eingabe einsparen.
Dabei beträgt der Lesepreis für Eingaben, die den Cache treffen, nur ein Zehntel des Preises für normale Eingaben.
Wenn die KI beginnt, komplexe Aufgaben zu übernehmen, die mehrere Stunden in Anspruch nehmen, kommt ein weiterer Faktor bei der Auswahl des Tools hinzu: Neben der Frage „Kann die Aufgabe erledigt werden?“ muss auch berücksichtigt werden, „wie lange man warten muss“ und „wie viel es kostet“.
Aber wenn der Cache-Eingabepreis auf ein Zehntel reduziert wird, kann dann auch unsere Gesamtrechnung um das Zehnfache sinken?
Was wird eigentlich im Cache gespeichert?
Die bereits berechneten Entwürfe behalten
Um zu verstehen, wie man damit Geld spart, muss man zuerst verstehen, wie die KI „liest“.
Wenn das Modell lange Textabschnitte liest, sieht es diese nicht wie ein Mensch rein mit den Augen, sondern berechnet intern eine Gruppe komplexer Zwischenzustände, die in der Fachwelt als KV-Zustände bezeichnet werden.
Bei der Generierung der nachfolgenden Antwort muss das Modell diese Zustände ständig überprüfen, um die logische Konsistenz zwischen vorher und nachher zu wahren.
Das sogenannte Prompt-Caching speichert genau diese bereits berechneten Zwischenergebnisse.
Sie können es sich bildhaft vorstellen als die „Berechnungsentwürfe“, die bei der letzten Problemlösung hinterlassen wurden.
Bei der nächsten Gesprächsrunde muss die KI, solange der Anfang der Aufgabe unverändert bleibt, die Berechnung nicht noch einmal auf dem Entwurfsblatt durchführen, sondern kann direkt den vorhandenen Entwurf nehmen und damit fortfahren.
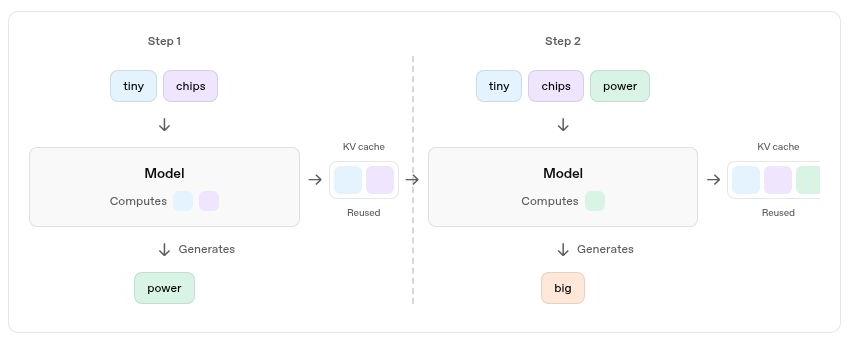
Die offizielle Dokumentation zeigt die Wiederverwendung von KV-Zuständen: Die bereits berechneten Inhalte können für nachfolgende Schritte verwendet werden.
Hier gibt es zwei sehr entscheidende Voraussetzungen:
Erstens ist der Cache kein Gedächtnis.
Es handelt sich nicht darum, der KI ein permanentes Gedächtnisarchiv hinzuzufügen, noch darum, die Antwort der letzten Zeit direkt zu kopieren und an Sie weiterzugeben.
Auf Ihre neue Frage hin muss die KI immer noch gründlich nachdenken und eine neue Antwort generieren, sie erspart sich nur die wiederholte Arbeit des „erneuten Lesens alter Materialien“.
Zweitens muss die Wiederverwendung eine exakte Übereinstimmung erfüllen.
Der vordere Teil der beiden Anfragen muss vollkommen identisch sein, und dieser vollständig übereinstimmende Inhalt wird als „gemeinsames Präfix“ bezeichnet.
Dieses Präfix umfasst nicht nur den von Ihnen eingegebenen Chat-Text, sondern auch implizite Anweisungen des Systems, Tooldefinitionen sowie Kontext wie Bilder, Dokumente und Audiodateien.
Für Modelle ab GPT-5.6 muss das gemeinsame Präfix, das den Cache auslösen kann, mindestens 1024 sichtbare Eingabe-Token umfassen.
Außerdem hat der Cache eine Gültigkeitsdauer: Nach dem letzten Schreib- oder Nutzungsvorgang wird er mindestens 30 Minuten lang auf dem Server gespeichert.
Solange er innerhalb dieses Zeitraums erneut aufgerufen wird, wird die Gültigkeitsdauer neu zurückgesetzt, ohne dass eine erneute Schreibgebühr anfällt.
Aber wenn Sie sich im selben Chatfenster befinden, bedeutet das nicht, dass der Cache zu 100 % getroffen wird.
Wenn die Anfrage verschiedenen Servermaschinen zugewiesen wird oder verschiedene Regionen überschreitet, kann der Cache trotzdem ungültig werden.
Lesen zum Zehntel des Preises
Warum kann die Gesamtrechnung nicht einfach durch 10 geteilt werden?
OpenAI gibt an, dass Eingaben, die den Cache treffen, maximal auf ein Zehntel des Preises reduziert werden. Warum kann dann die Gesamtrechnung nicht in diesem Verhältnis gekürzt werden?
Denn es gibt kein kostenloses Essen auf der Welt: Um die Materialien zum ersten Mal in den Cache zu schreiben, muss man selbst zuerst eine Art „Raummietgebühr“ zahlen.
Gemäß der neuesten Entwicklungsdokumentation beträgt der Preis für das erste Schreiben von Materialien in den Cache bei Modellen ab GPT-5.6 das 1,25-fache des normalen Eingabepreises; bei nachfolgendem erfolgreichem Treffen des Caches beträgt der Lesepreis nur ein Zehntel des normalen Eingabepreises.
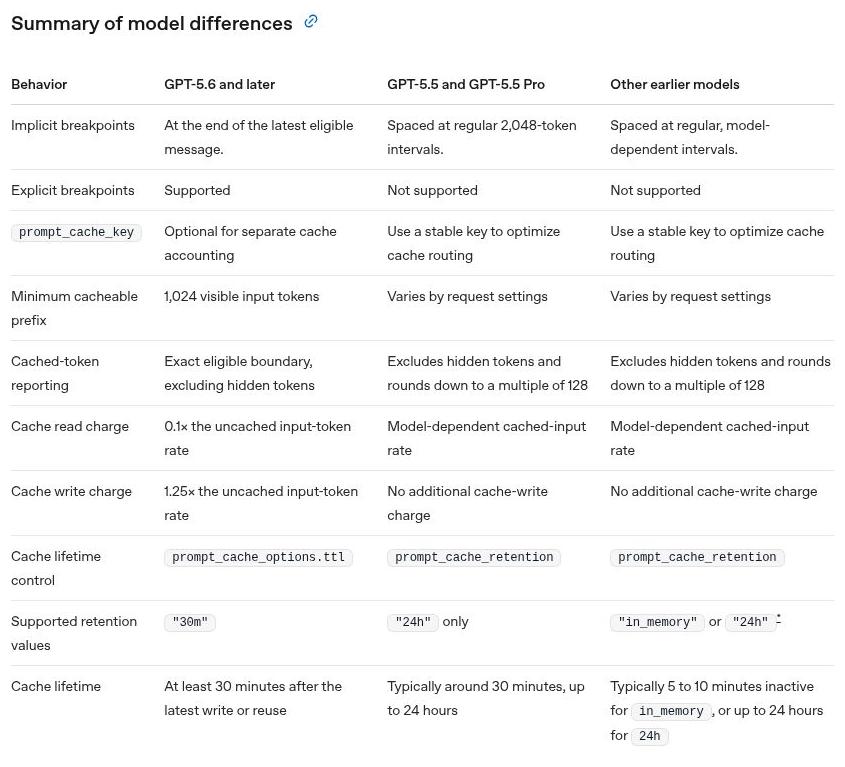
Offizielle Tariftabelle: Bei Modellen ab GPT-5.6 beträgt der Cache-Lesepreis das 0,1-fache und der Schreibpreis das 1,25-fache des Normalpreises.
Rechnen wir ein sehr anschauliches Beispiel:
Angenommen, Sie haben einen umfangreichen Materialbestand, für dessen Verarbeitung als normale Eingabe 1 Einheit Kosten anfallen. Wenn Sie ihn 10 Mal nacheinander verwenden, müssten Sie ursprünglich insgesamt 10 Einheiten zahlen.
Mit dem Cache-Mechanismus zahlen Sie beim ersten Schreiben 1,25 Einheiten; bei den nachfolgenden 9 Malen, die alle den Cache treffen, zahlen Sie jeweils 0,1 Einheiten, also insgesamt 0,9 Einheiten für 9 Mal.
Zusammen ergibt das: 1,25 + 0,9 = 2,15 Einheiten.
Im Vergleich zu den ursprünglichen 10 Einheiten sinken die Kosten direkt von 10 auf 2,15 Einheiten, womit ganze 78,5 % eingespart werden.
Das ist der Ursprung der erstaunlichen Zahl von 78,5 % Einsparung, die zu Beginn des Artikels genannt wurde.
Aber beachten Sie: Diese Einsparung von bis zu 78,5 % deckt nur die „alten, wiederverwendeten Materialien“ ab.
In der tatsächlichen Nutzung werden Ihre neuen Fragen, die von der KI generierten Ausgaben sowie weitere zusätzliche Berechnungen weiterhin zum normalen Preis berechnet.
Der realistischere Fall ist: Wenn Sie Materialien nach dem teuren Schreiben in den Cache nur einmal verwenden und sie danach nie wieder nutzen, müssen Sie sogar die höheren Kosten für das erste Schreiben tragen.
Deshalb gilt: Rabatte beziehen sich auf den Stückpreis, ob man wirklich Geld sparen kann, hängt vollständig davon ab, wie hoch die Wiederverwendungsrate ist.
Warum bricht der Rabatt plötzlich ein, wenn man nur wenig ändert?
Warum bricht der Rabatt plötzlich „weg“?
Wie bereits erwähnt, basiert der Cache auf „exakter Übereinstimmung“.
Die KI ist sehr starr: Sie kann nicht verstehen, dass „diese beiden Sätze ungefähr das Gleiche bedeuten“. Sobald der Anfang auch nur die geringste Änderung aufweist, wird der Cache sofort ungültig.
Zum Beispiel schreiben einige Anwendungen zur Aufzeichnung der Zeit jedes Mal die genaue aktuelle Zeit ganz vorne in den Prompt. Das führt dazu, dass die nachfolgenden Referenzmaterialien zwar wortwörtlich unverändert sind, aber aufgrund der Änderung am Anfang das gesamte Präfix nicht mehr mit dem alten Cache übereinstimmt.
Um zu verhindern, dass der Rabatt abbricht, haben Entwickler eine goldene Regel zusammengefasst: Unveränderliche Inhalte werden immer vorne platziert, häufig wechselnde Inhalte werden einheitlich am Ende angefügt.
Bei diesem Upgrade hat OpenAI außerdem mehrere sehr praktische Steuerungstools und -methoden eingeführt:
Eines davon ist der explizite Haltepunkt.
Er funktioniert wie ein Lesezeichen, das in den Text eingefügt wird, und teilt der KI klar mit: „Der Anfang bis hierher ist festgelegt, bitte behalten Sie ihn zur Wiederverwendung auf.“
Er markiert die Grenze des Caches, anstatt die KI zum Anhalten des Denkens zu veranlassen.
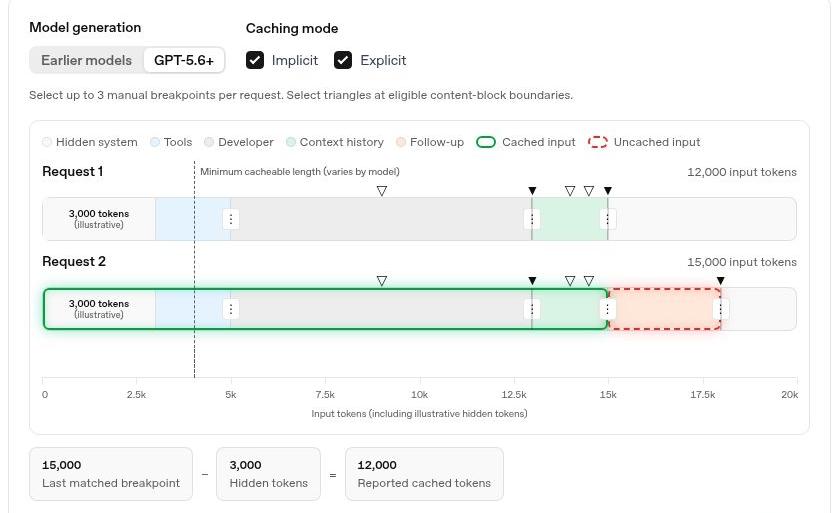
Offizielles Interaktionsbeispiel: Der grüne Bereich nutzt das alte Präfix wieder, der rote Bereich wird separat verarbeitet.
Ein weiteres Element sind stabile Tooldefinitionen.
Das Ändern des Toolnamens oder das Anpassen der Reihenfolge der Parameter kann den Cache zerstören.
OpenAI empfiehlt, die Definition und Reihenfolge der Toolbibliothek stabil zu halten. Wenn ein bestimmtes Tool in einer Gesprächsrunde nicht benötigt wird, können Sie es vorübergehend über Steuerparameter ausblenden, anstatt die Tooldefinition direkt zu löschen.
Der dritte Punkt ist die vorsichtige Anpassung der Denkintensität.
Nehmen wir GPT-6 als Beispiel: Wenn Sie den globalen Parameter für die Inferenzintensität direkt ändern, wird ebenfalls die Wiederverwendung des Präfixes zerstört.
Wenn Sie aber die Denkintensität innerhalb des Gesprächs durch inkrementelle Aktualisierung anpassen, können Sie den Detailgrad des Denkens der KI verändern und gleichzeitig den Cache vollständig behalten.
Natürlich werden die meisten dieser Details von den Entwicklern auf Anwendungsebene im Hintergrund stillschweigend verarbeitet, normale Nutzer müssen keine komplexen Parameter auswendig lernen.
Aber die Qualität des Anwendungscodes bestimmt direkt die Wartezeit und die Kosten, die Sie an der Vordergrundoberfläche erleben.
Wenn die Verluste sichtbar werden, kann die KI wirklich schneller und günstiger werden
Wenn die Verluste sichtbar werden, kann die KI wirklich schneller und günstiger werden
Viele Nutzer hatten bei der Verwendung von KI schon ähnliche Verwirrungen:
Man hat kaum ein paar Worte gewechselt, warum verbrauchen die Token so schnell? Wo liegt das Problem eigentlich?
Bei diesem Upgrade hat OpenAI die Überwachungs- und Diagnosefunktionen ergänzt.
Auf dem brandneuen Cache-Dashboard werden die Eingabedaten klar aufgeschlüsselt: Wie viele Zeichen aus dem Cache stammen, wie viele Zeichen neu verarbeitet werden müssen und zu welchem Zeitpunkt die Trefferquote sinkt – alles ist auf einen Blick ersichtlich.
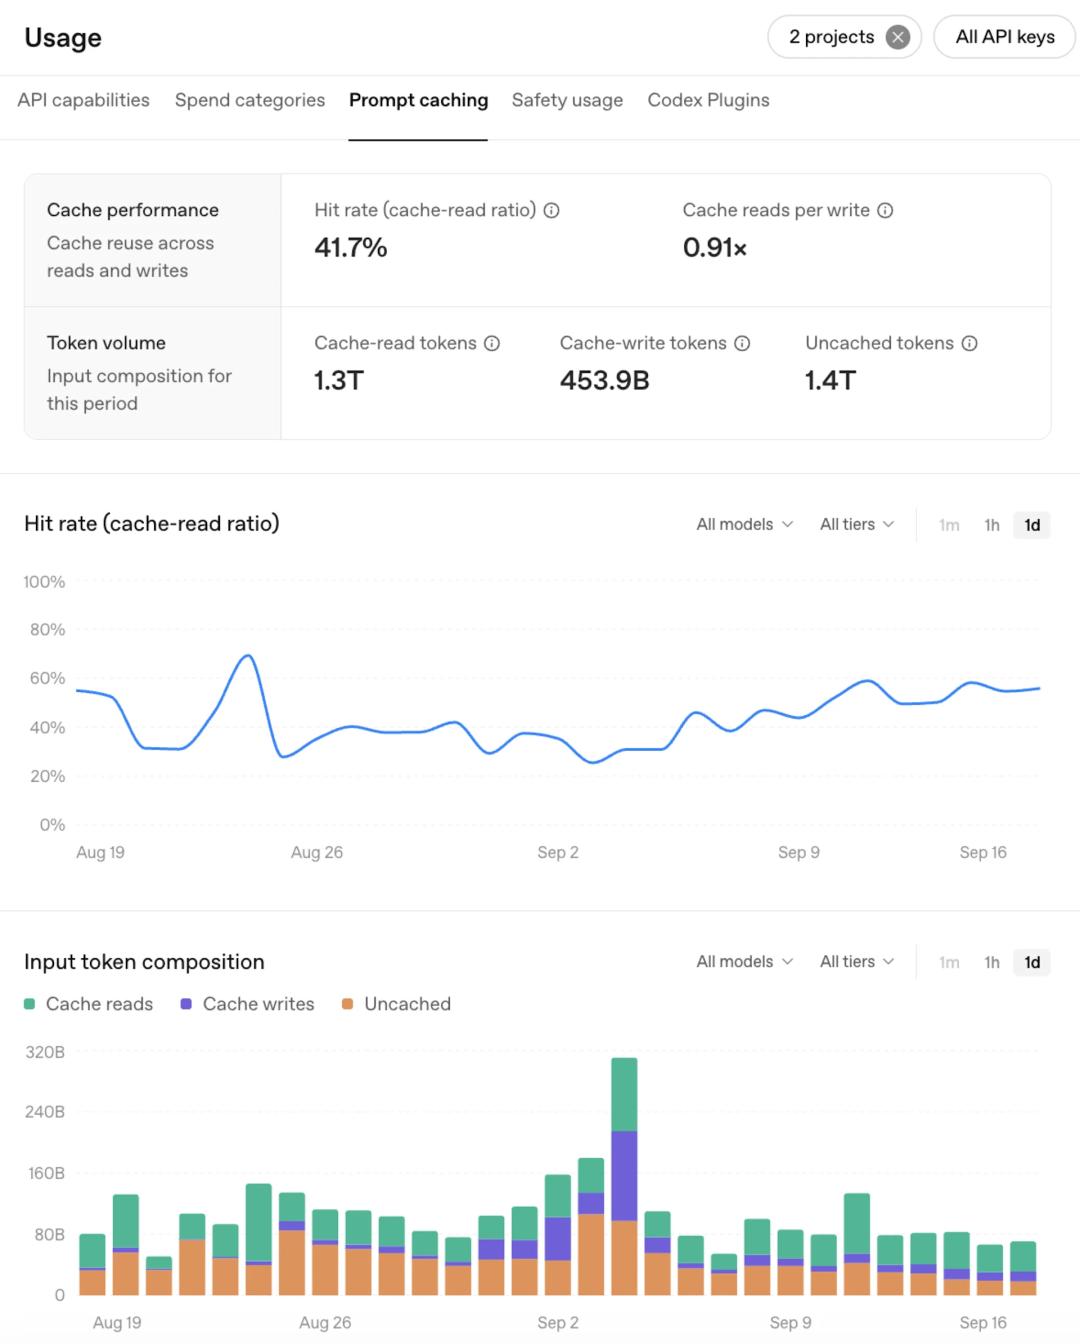
Beispiel für das am 22. September veröffentlichte Cache-Dashboard, das die Trefferquote und die Zusammensetzung der Eingaben zeigt.
Das Diagnosetool funktioniert dagegen eher wie ein Fehlerbehebungsexperte: Es kann die aktuelle Anfrage automatisch mit historischen Antworten vergleichen, genau feststellen, welches Tool den Namen geändert hat oder welche Einstellung verändert wurde, und sogar genau abschätzen, wie viele wiederverwendbare Token dadurch verloren gegangen sind.
Offizielle Beispiele zeigen, dass allein durch eine geringfügige Änderung eines Toolnamens 5629 Token nicht mehr den Cache treffen konnten.
Neben der Diagnose gibt es eine weitere Verbesserung, die von Nutzern leichter wahrgenommen wird, namens „Warmup“ (Aufwärmen).
Wenn die Anwendung gestartet wird, kann das System bekannte Systemanweisungen, Toolbeschreibungen oder Hintergrundmaterialien bereits vorverarbeiten und in den Cache schreiben, bevor Sie überhaupt etwas eingeben.
Wenn Sie dann tatsächlich Ihre Frage senden, sind alle Vorbereitungen bereits abgeschlossen, sodass die Antwortgeschwindigkeit für das erste Wort natürlich stark ansteigt.
Das Warmup macht die Berechnung nicht kostenlos (das Schreiben wird weiterhin mit dem 1,25-fachen Preis berechnet), aber es verlagert die Berechnung geschickt vor die Wartezeit und reduziert Ihr wahrgenommenes Warteerlebnis erheblich.
Derzeit hat beispielsweise die KI-Agent-Anwendung Manus die Cache-Trefferquote für ihr OpenAI-Modell von etwa 85 % auf über 90 % angehoben und stabilisiert; bei GitHub Copilot ist der Anteil der Prompt-Token