Alibaba hat auf einen Schlag fünf neue Qwen-Modelle veröffentlicht, wobei der Preis um bis zu 95 % gesenkt wurde.
Bericht von Zhidong am 23. September: Qwen hat heute offiziell die Sprach-Großmodellreihe Qwen-Audio-3.1 veröffentlicht, insgesamt 5 Modelle auf einmal herausgebracht, die drei Kernmodelle für Spracherkennung (ASR), Sprachsynthese (TTS) und Echtzeit-Sprachinteraktion (Realtime) aktualisiert. Darüber hinaus wurden das Audio-Verständnismodell ASR-Next und das Audio-Kreationsmodell TTS-Next auf Basis der nächsten Generation von Architektur veröffentlicht.
Unter ihnen wurde das neue Spracherkennungs-Großmodell Qwen-Audio-3.1-ASR mit den öffentlichen Dialekt-Testdatensätzen KeSpeech und WSYue getestet. Bei 6 von 11 Teildatensätzen erzielte es bessere Ergebnisse als die beiden Open-Source-Modelle Doubao-ASR und Tencent Hy-ASR-3.0-preview, die durchschnittliche Zeichenfehlerrate (CER) beträgt nur 4,55 %.
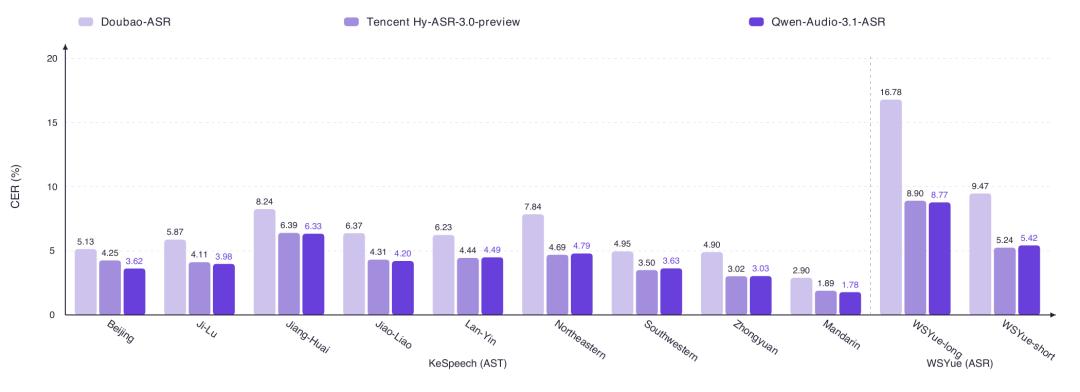
▲ Öffentliche Dialekt-Testergebnisse (Quelle: Qwen Großmodell)
Darüber hinaus wurden die Preise für die gesamte Sprachmodellreihe von Qwen-Audio gesenkt, wobei TTS um ca. 70 %, Realtime um ca. 85 % und ASR um bis zu 95 % reduziert wurden.
Bezüglich der Preise: Für Qwen-Audio-3.1-ASR-Flash beträgt der Eingabepreis 0,8 Yuan und der Ausgabepreis 2,7 Yuan pro Million Tokens; für Qwen-Audio-3.1-TTS-Flash 1,5 Yuan bei der Eingabe und 12 Yuan bei der Ausgabe pro Million Tokens; für Qwen-Audio-3.1-TTS-Next 6 Yuan bei der Eingabe und 12 Yuan bei der Ausgabe pro Million Tokens; für Qwen-Audio-3.1-Realtime-Plus liegen die Eingabepreise je nach Stufe zwischen 5 und 40 Yuan und die Ausgabepreise zwischen 40 und 150 Yuan pro Million Tokens.
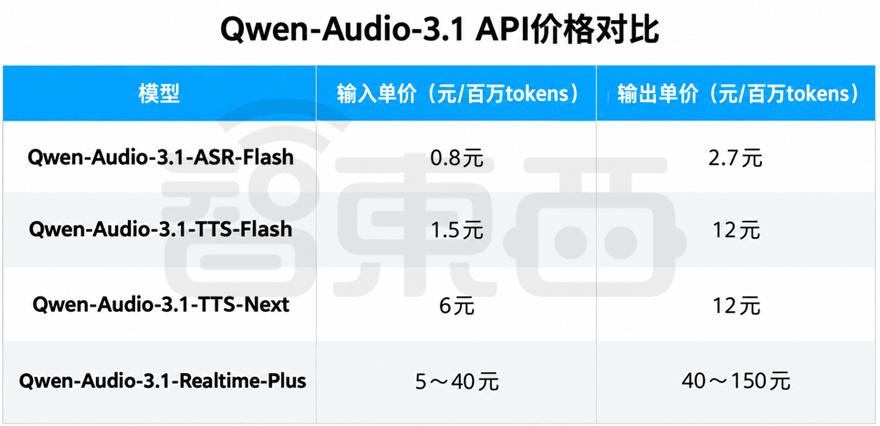
▲ Preisübersicht der Qwen-Audio-3.1 Sprachmodellreihe (Quelle: Zhidong Grafik)
Der Großteil der APIs dieser Modellreihe ist bereits auf der Qwen AI-Plattform verfügbar, die API von ASR-Next ist noch nicht online. Auf der am 22. September eröffneten 2026 Yunqi-Konferenz hat Alibaba diese Modelle bereits angekündigt, das erstmals vorgestellte Simultandolmetschmodell Qwen3.8-LiveTranslate ist nicht in dieser Veröffentlichungsliste enthalten.
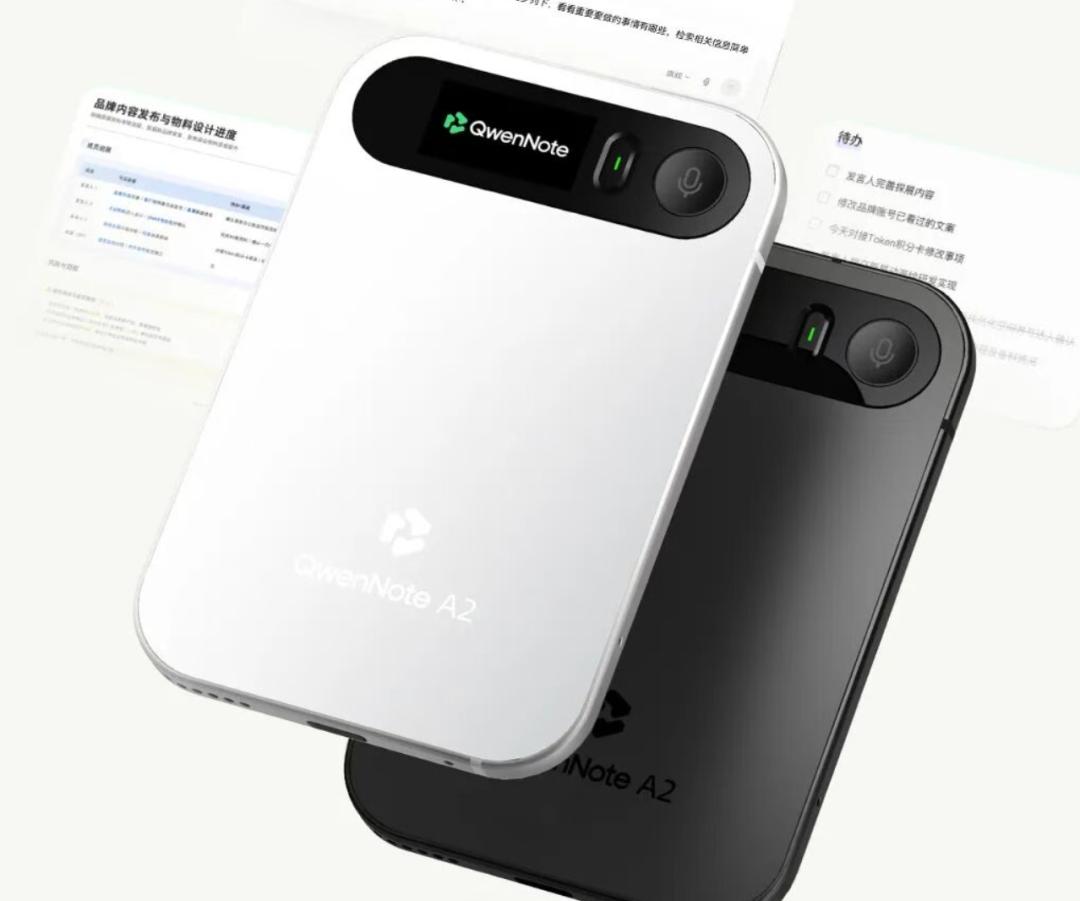
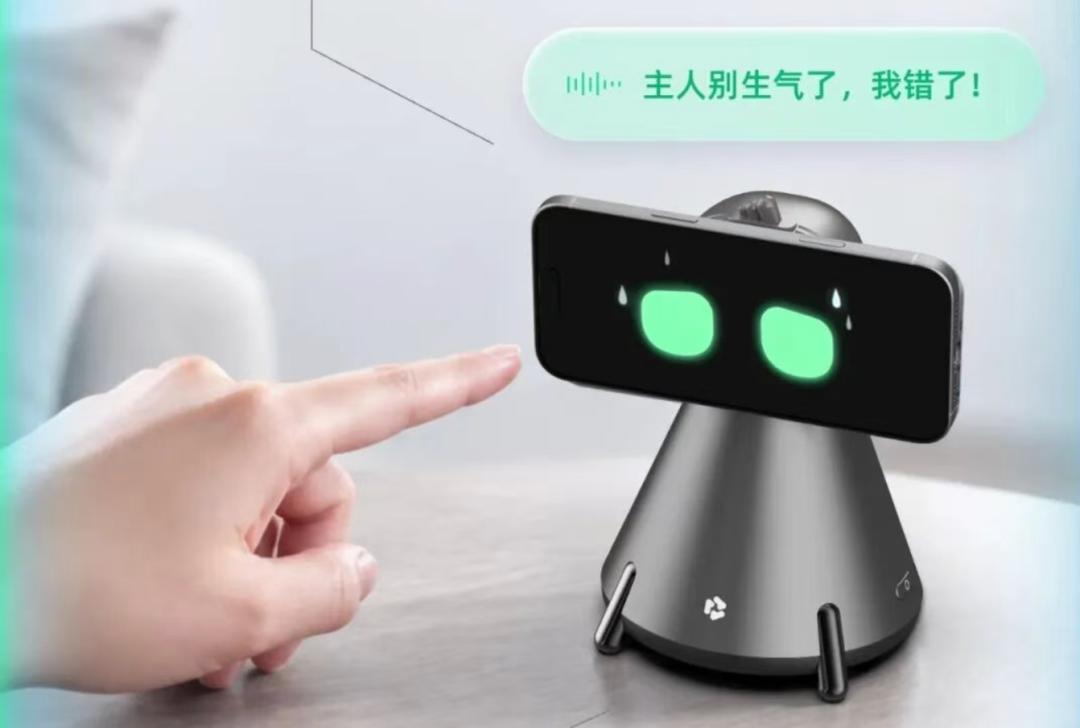
Darüber hinaus hat Qwen Office heute zwei intelligente Hardwareprodukte veröffentlicht, nämlich das erste Agent-Hardwaregerät QwenNote A2 und den Desktop-Roboter Eva. Qwen-Audio-3.1-Realtime wird schrittweise in diese Geräte integriert.
QwenNote A2 ist ein KI-Assistentgerät, das magnetisch auf der Rückseite des Mobiltelefons befestigt wird, über ein integriertes 4G-Netz verfügt, unabhängig vom Mobiltelefon Tonaufnahmen und Transkriptionen durchführen, übersetzen und KI-Dialoge unterstützen, Besprechungen zusammenfassen und Konzepte erstellen kann.
Der Desktop-Roboter Eva ist mit Qwen Office ausgestattet, kann mit Benutzern in Echtzeit sprachlich interagieren, die von Benutzern gestellten Aufgaben erledigen und die Zusammenarbeit über mehrere Endgeräte hinweg unterstützen.
Adresse zum Ausprobieren:
Qwen-Audio-3.1-ASR:
https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:
https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:
https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:
https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
01.
Aktualisierung der drei Kernmodelle:
16 Dialekte, sprachübergreifende Synthese, Vollduplex
Qwen-Audio-3.1-ASR verfügt über fünf Kernfähigkeiten: Strukturierung, breite Erkennungsbereich, hohe Genauigkeit, schnelle Verarbeitung und klare Erkennung.
Dabei verwendet Qwen-Audio-3.1-ASR ein End-to-End-Verfahren, das Sprecheretiketten, Zeitstempel und Text gemeinsam ausgibt. Es kann sowohl abwechselnde Redebeiträge verarbeiten als auch kurze Zwischenbemerkungen und überlappende Sprachanteile behalten, wodurch es rückverfolgbare strukturierte Aufzeichnungen für Besprechungen, Interviews und Dialoganalysen liefern kann.
Bei der Sprachabdeckung unterstützt ein einziges Modell 30 Sprachen und 16 chinesische Dialekte. Bei der Vokabularabdeckung erkennt das Modell Branchenbegriffe, fachliche Entitäten und hierarchische Schlagwörter, kann sich auf den historischen Kontext langer Audios beziehen und die Konsistenz von Namen, Abkürzungen und Fachbegriffen gewährleisten.
Bei der Latenz erreicht das Modell bei der stromlinienförmigen Erkennung mit niedriger Latenz eine Antwortzeit des ersten Zeichens von etwa 160 Millisekunden. Gleichzeitig verfügt Qwen-Audio-3.1-ASR über eine integrierte Polierfunktion nach Abschluss der Transkription: Es kann Füllwörter und wiederholte Ausdrücke automatisch entfernen und nur die Semantik neu organisieren, verschiedene Sprecher automatisch unterscheiden und die Konsistenz der Rollen bei langen Audios, die Zeitausrichtung sowie die strukturierte Ausgabe realisieren.
Neben öffentlichen Tests erzielte Qwen-Audio-3.1-ASR bei der Bewertung im selbst erstellten chinesischen Dialekt-Testdatensatz von Alibaba für ASR bei der Transkription von 16 chinesischen Dialekten eine durchschnittliche CER von 10,38 %, wobei die Erkennungsleistung für die Dialekte von Wenzhou und Suzhou weit vor allen anderen Modellen liegt.
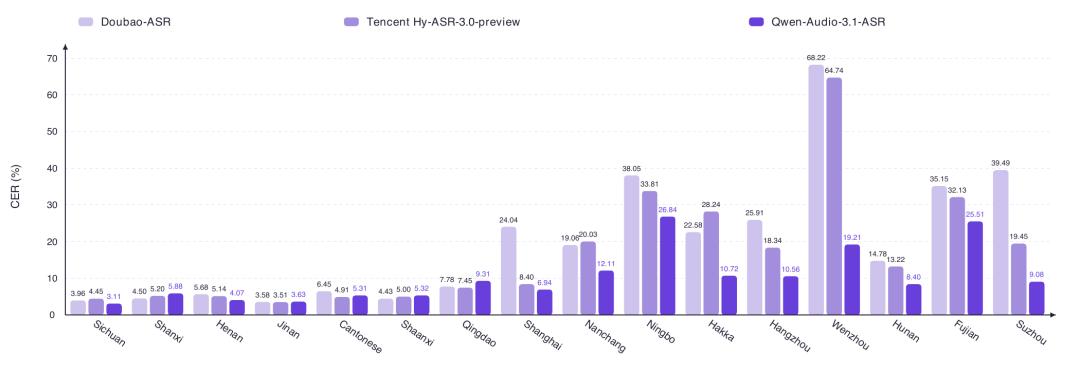
▲ ASR-Bewertungsergebnisse im selbst erstellten chinesischen Dialekt-Testdatensatz von Alibaba (Quelle: Qwen Großmodell)
Der intern erstellte chinesische Dialekt-Testdatensatz für die AST-Bewertung dient zur Bewertung der Fähigkeit, Dialektsprache in Mandarin zu übersetzen und die ursprüngliche Bedeutung genau zu behalten. Qwen-Audio-3.1-ASR zeigte bei 11 von 10 Dialekt-Teildatensätzen die beste Leistung, die durchschnittliche semantische Satzgenauigkeit erreicht 82,10 %.
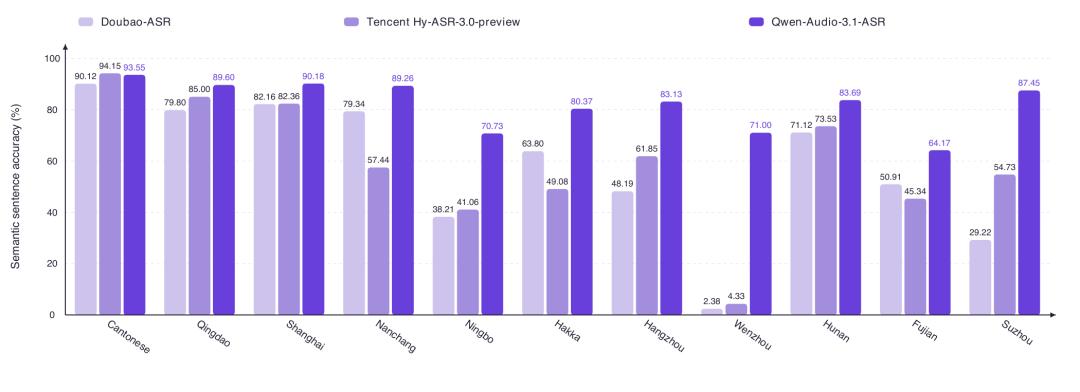
▲ AST-Bewertungsergebnisse im selbst erstellten chinesischen Dialekt-Testdatensatz von Alibaba (Quelle: Qwen Großmodell)
Der Schwerpunkt der Aktualisierung von Qwen-Audio-3.1-TTS liegt auf der Fähigkeit zur sprachübergreifenden Klangsynthese. Ein und derselbe Klang kann natürlich zwischen verschiedenen Sprachen übertragen werden. In der offiziellen Demonstration kann Qwen-Audio-3.1-TTS mit einem einzigen Klang jeweils Mandarin, Kantonesisch, Henan-Dialekt, Englisch und Japanisch sprechen.
Darüber hinaus können Stimmung, Sprechgeschwindigkeit und Ausdrucksweise des synthetisierten Sprachsignals durch Anweisungen gesteuert werden. Derselbe Satz kann verschiedene Zustände wie Freude und Trauer ausdrücken, wobei der Fokus auf einer natürlichen Ausdrucksweise liegt, sodass der Klang dem spezifischen Inhalt und dem Nutzungsszenario entspricht.
Das Echtzeit-Sprachinteraktionsmodell Qwen-Audio-3.1-Realtime hat das Verständnis von Stimmungen, Kommunikationsabsichten und Kontext weiter verbessert, unterstützt gleichzeitig das Echtzeitwechseln zwischen mehreren Sprachen und den Aufruf von Tools und hat die Sicherheit sowie die Faktenzuverlässigkeit gestärkt.
In praktischen Szenen mit Gesprächen zwischen mehreren Personen ermöglicht die vollduplex-Echtzeitinteraktion von Qwen-Audio-3.1-Realtime, je nach Gesprächsverlauf angemessen zu warten, sich einzubringen und zu antworten. Bei fortlaufender Kommunikation zwischen mehreren Personen kann es anhand des Kontexts beurteilen, wann es am Gespräch teilnehmen soll und wann es weiter warten soll.
Qwen-Audio-3.1-Realtime kann die Antwortweise je nach Tonfall und Stimmung des Benutzers anpassen und nach dem Wechsel der Sprache im Gespräch den Kontext sowie den Kommunikationsrhythmus beibehalten. Wenn der Benutzer Anfragen wie Abfragen oder Suchen stellt, kann Qwen-Audio-3.1-Realtime auch externe Tools wie APIs und Wissensdatenbanken aufrufen, um die Aufgabe zu erledigen und dann das Ergebnis zurück in das Gespräch zu bringen.
Laut dem veröffentlichten technischen Bericht ist die Gesamterfolgsrate von Qwen-Audio-3.1-Realtime bei der angepassten Version des τ-Voice-Halbduplex-Sprache-zu-Text-Modells von 78,4 % auf 82,0 % gestiegen; bei Full-Duplex-Bench v1.5 ist die Antwortrate auf Hintergrundsprache von 73,0 % auf 13,0 % gesunken, was bedeutet, dass das Modell weniger durch irrelevante Hintergrundsprache gestört wird.
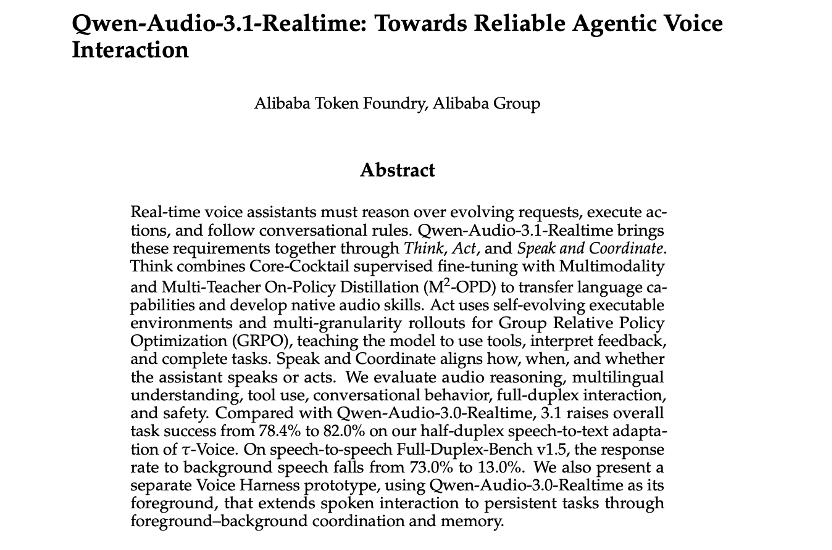
▲ Technischer Bericht zu Qwen-Audio-3.1-Realtime (Quelle: arXiv)
Darüber hinaus wird Qwen-Audio-3.1-Realtime derzeit mit Agenten wie Qoder und Qwen Office sowie intelligenten Hardwareprodukten wie QwenNote, A2, Eva, Qwen AI-Brille und Leqi AI-Brille kombiniert.
Laut offiziellen Angaben müssen Benutzer in diesen Szenen nicht ständig ihren Computer oder ihr Mobiltelefon öffnen, sondern können Aufgaben direkt per Sprache initiieren und im laufenden Gespräch weiterhin Bedingungen hinzufügen, Anforderungen ändern oder den Ausführungsstatus abfragen.
02.
Zwei neue Next-Modelle:
Eines erweitert das Audio-Verständnis, das andere erschließt den Bereich der Audio-Kreation
Alibaba hat bei dieser Veröffentlichung auch zwei neue Modelle im Audiobereich vorgestellt: Qwen-Audio-3.1-ASR-Next und Qwen-Audio-3.1-TTS-Next, die jeweils die Lücken im Audio-Verständnis außerhalb der Sprache für ASR und TTS schließen sollen.
Qwen-Audio-3.1-ASR-Next erweitert den Verarbeitungsbereich von Audiosignalen von Text in Sprache auf vollständige Audioinformationen. Es kann die Stimmung von Personen, Umgebungsgeräusche und mechanische Geräusche verstehen und Aufgaben wie die Beschreibung von Geräuschen, die Lokalisierung von Ereignissen, Fragen und Antworten zu Audios sowie Schlussfolgerungen erledigen.
Als Beispiel der offiziellen Angabe: Bei einem Audio, das gleichzeitig Gespräche von Personen, Hintergrundmusik und Umgebungsgeräusche enthält, gibt das Modell nicht nur den Text des Gesprächs aus, sondern beschreibt auch, welche Geräusche darin vorkommen, wann relevante Ereignisse stattfinden, und beantwortet Fragen zum gesamten Inhalt.
Bei der Bewertung von rollenspezifischem ASR erzielten die Versionen Qwen-Audio-3.1-ASR-Flash-Next und Qwen-Audio-3.1-ASR-Flash fünf bzw. drei der besten Ergebnisse, die beide besser als das vorherige kaskadierende System Fun-ASR sind.
