DeepSeek hat ein neues Forschungspapier zum Agent-Training veröffentlicht, in dem Liang Wenfeng als Autor aufgeführt ist.
Das Training großer Modelle hängt von Rechenleistung ab, während das Training von Agenten von der Umgebung abhängt.
Wie wird diese Umgebung erstellt? Das neueste Papier von DeepSeek mit dem Autor Wenfeng Liang veröffentlicht alle technischen Details.
Das von DeepSeek entwickelte System heißt DSec (DeepSeek Elastic Compute) und dient der Massenproduktion von Sandboxen für das Agententraining.
Es kann mehr als 5000 Sandboxen pro Sekunde erzeugen, bis zu 3 Millionen pro Tag, mit einem Spitzenwert von 380.000 gleichzeitig laufenden Sandboxen.
Der einzelne Cluster, der dieses Ausmaß unterstützt, ist ebenfalls sehr umfangreich und besteht aus etwa 160 Knoten, 30.000 CPU-Kernen und 250 TB Arbeitsspeicher.
Warum ist das Training eines Agenten so aufwendig?
Denn die Umgebung für das Training großer Modelle ist ein GPU-Cluster, der Daten einspeist und Gradienten berechnet – bei Agenten ist das völlig anders.
Der Agent muss in der Sandbox Code schreiben, Kompilierungen durchführen, Browser öffnen und sogar Betriebssysteme installieren … Jeder Schritt ändert den Zustand der Umgebung und kann diese jederzeit zum Absturz bringen.
Daher muss für jede Trainingsrunde eine brandneue, saubere Sandbox bereitgestellt werden, die sofort nach Gebrauch verworfen wird.
Damit läuft das Problem letztendlich wieder auf die Infrastruktur zurück –
Diese Infrastruktur muss bei einer Geschwindigkeit von 5000 Sandboxen pro Sekunde für jede Sandbox ein komplettes Betriebssystem und eine Toolchain installieren.
Gleichzeitig darf sie nicht zulassen, dass Hunderttausende gleichzeitig laufende Sandboxen den Arbeitsspeicher und die CPU des Clusters überlasten.
Wie das genau funktioniert, beschreibt das Papier in allen Einzelheiten dieses gesamten technischen Aufbaus.
Das Agententraining braucht „eine ganze Welt“
Das erste Kernproblem, das DSec lösen muss, ist: Verschiedene Arten von Agentenaufgaben stellen extrem unterschiedliche Anforderungen an die Sandbox-Umgebung, und diese Umgebungen müssen auf derselben Plattform einheitlich verwaltet werden.
Ein Agent, der OJ-Aufgaben löst, braucht nur eine zustandslose Funktionsaufrufumgebung, um nach der Ausführung das Ergebnis zu erhalten – selbst ein dauerhaftes Dateisystem ist nicht erforderlich.
Dagegen braucht ein Agent, der SWE-bench bearbeitet, einen vollständigen Linux-Benutzerbereich, in dem er Abhängigkeiten installieren, Code ändern und pytest ausführen kann. In der Mitte der Aufgabe müssen möglicherweise neue Pakete zur Umgebung hinzugefügt werden.
Bei Szenarien für Cybersicherheitsangriffe und -verteidigung sowie Computer-Nutzung reicht die Isolierung auf Containerebene nicht aus: Der Agent soll Browser oder sogar Desktops bedienen, und ein fehlerhafter Agent könnte versehentlich den Host zum Absturz bringen, sodass virtuelle Maschinen verwendet werden müssen.
Der extremste Fall ist das Training von Agenten, die kommerzielle Software bedienen: Sie brauchen ein vollständiges Windows oder macOS mit grafischer Oberfläche und Treibern, das sich kaum von einem echten Computer unterscheidet.
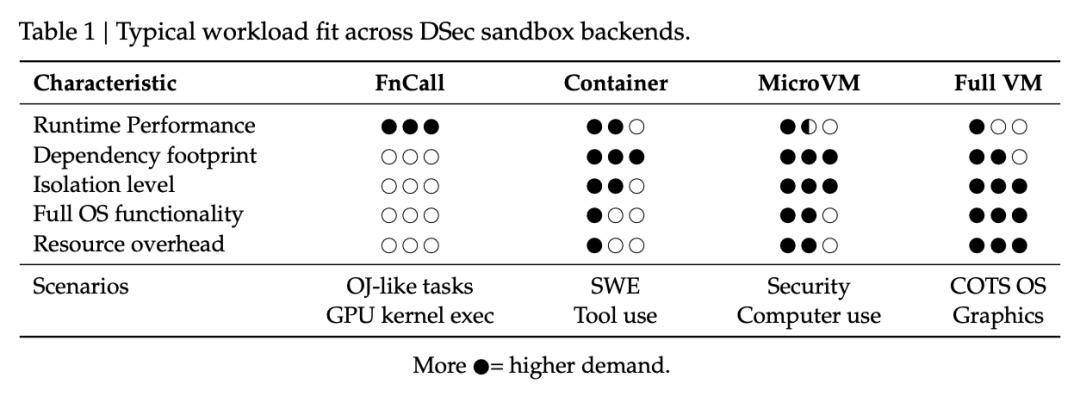
DSec hat vier Backends für diese vier Szenarien vorbereitet: FnCall verarbeitet zustandslose Funktionsaufrufe, Container führt Docker-Container aus, MicroVM nutzt Firecracker für leichtgewichtige virtuelle Maschinen und FullVM nutzt QEMU für die Ausführung vollständiger Betriebssysteme.
Die Isolationsstärke und der Ressourcenaufwand der vier Backends steigen stufenweise an, aber für das Trainingsframework stellt sich das einheitliche Python SDK libdsec dar.
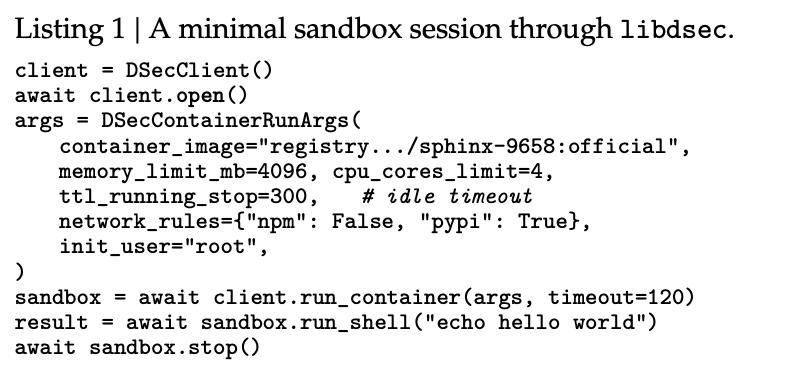
Unabhängig davon, ob die unterste Schicht ein Container oder eine virtuelle Maschine ist, werden dieselben Schnittstellen verwendet: Die Aufrufmethode für die Erstellung von Sandboxen, Ausführung von Befehlen und Abfrage von Ergebnissen ist in allen Schritten vollständig identisch.
Damit die vier Backends auf demselben Cluster laufen können, muss auch die Planungsebene der Plattform mithalten.
DSec teilt die gesamte Kette in sechs Schichten auf.
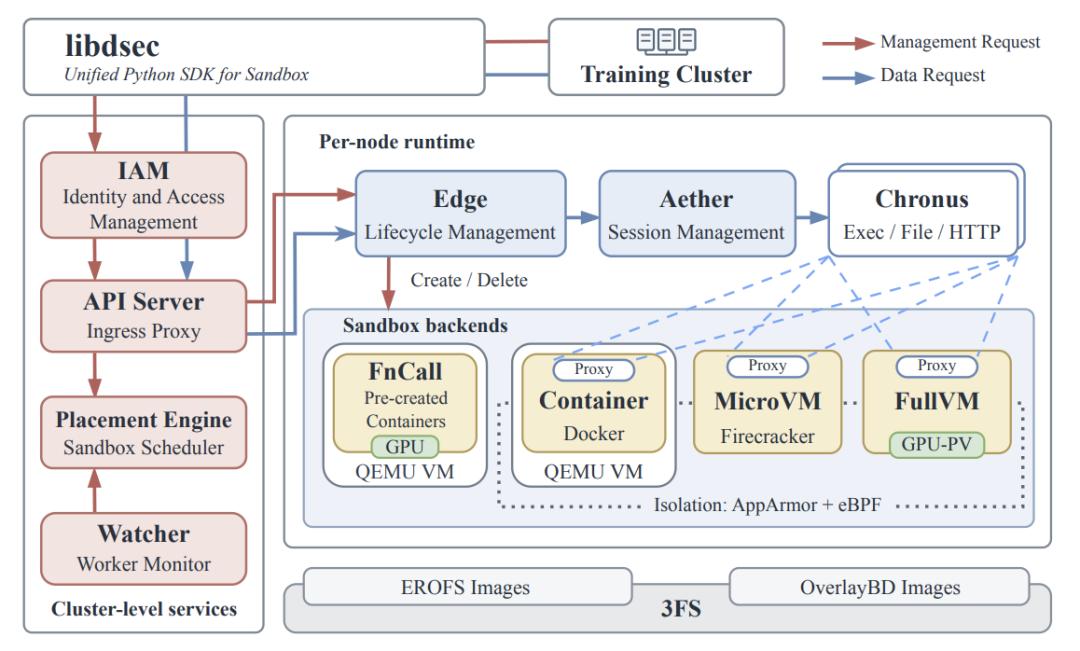
Diese Kette beginnt mit einer Erstellungsanforderung des Trainingsframeworks, durchläuft zuerst die IAM-Authentifizierung und -Autorisierung, gelangt zum API-Server, dann wählt die Planungs-Engine (Placement Engine) einen Zielknoten aus dem Cluster entsprechend dem verbleibenden Ressourcenbestand aus. Die Edge-Komponente auf dem Knoten ist dafür verantwortlich, die entsprechende Art von Sandbox tatsächlich zu starten.
Der Netzwerkausgang der Sandbox und die Paketverwaltungs-Images werden von Aether einheitlich proxied. Jeder Befehl, den der Agent darin ausführt, und jede Zeile der Ausgabe werden über eine Kommunikationskomponente namens Chronus in der Sandbox zurück zum Trainingsframework übermittelt, sodass das Framework weiß, bei welchem Schritt sich der Agent befindet und welche Rückmeldung gegeben werden soll.
Durch Ressourcenüberbuchung und hochdichte Bereitstellung kann ein einzelner Knoten gleichzeitig 3200 Container oder 800 MicroVMs hosten.
Wie werden 3 Millionen Sandboxen pro Tag betrieben?
Die größte Herausforderung von DSec in Bezug auf das Ausmaß ist jedoch nicht die Planung, sondern der Aufbau der Umgebungen.
Beim Starten jeder Sandbox wird ein komplettes Betriebssystem-Image plus Toolchain benötigt, was dem Installieren von Betriebssystemen auf 5000 „Computern“ pro Sekunde entspricht.
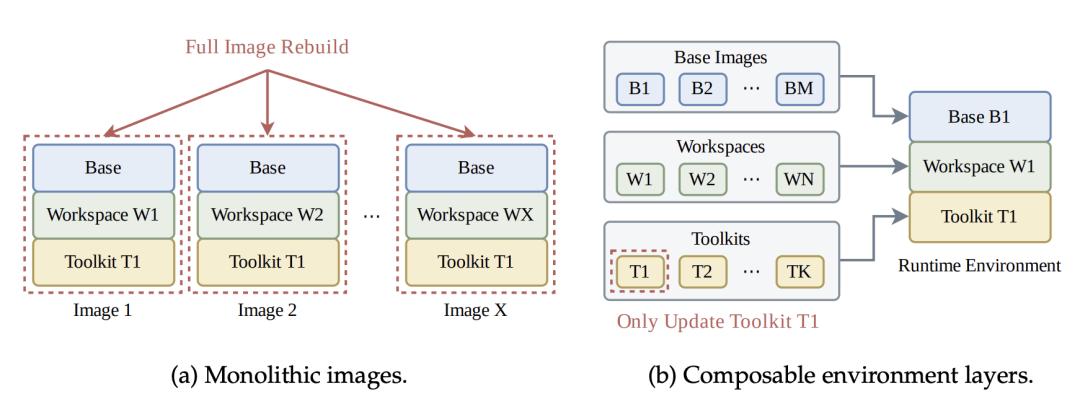
Der herkömmliche Docker-Ansatz besteht darin, das Basisimage, den Arbeitsbereich und die Toolpakete zu einem vollständigen Image zu kombinieren.
Dieses Verfahren funktioniert bei kleinem Umfang, aber das Container-Backend von DSec hat insgesamt 11266 Basisimages und 102171 Arbeitsbereiche verwendet, 67,8 % der Sandboxen müssen mindestens eine Schicht Arbeitsbereich oder Toolpaket auf dem Basisimage hinzufügen.
Bei dieser Vielfalt müssen alle kombinierten Images, die ein bestimmtes Toolpaket enthalten, neu erstellt werden, sobald dieses aktualisiert wird – die Kosten betragen O(m·N).
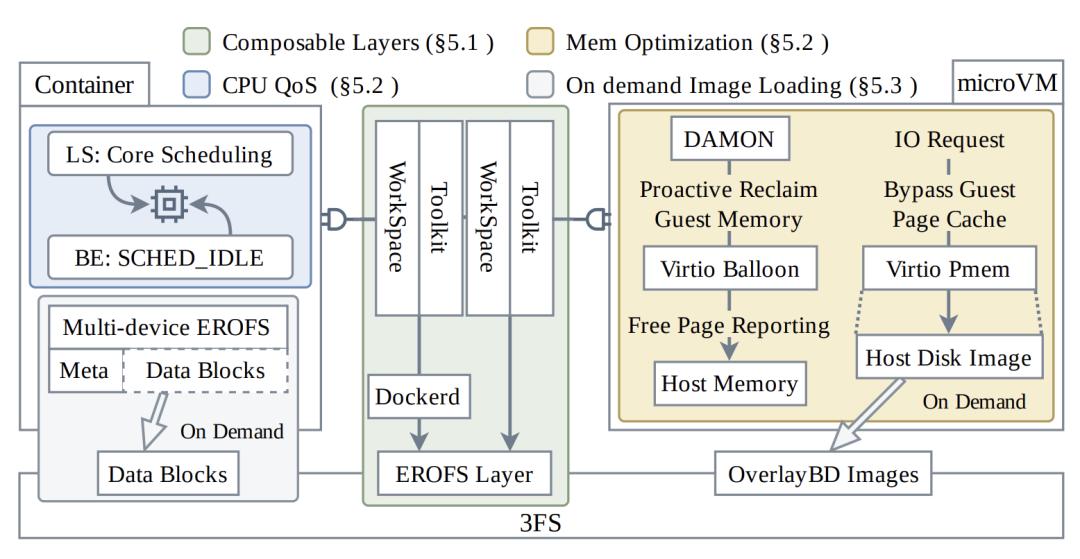
DSec geht so vor: Die Umgebung wird in drei unabhängige, als EROFS-Images vorliegende schreibgeschützte Schichten unterteilt: Basisimage, Arbeitsbereich und Toolpaket, die jeweils unabhängig versioniert werden und beim Start der Sandbox über OverlayFS bedarfsgerecht kombiniert werden. Bei der Aktualisierung eines Toolpakets wird nur die entsprechende Schicht berührt, sodass die Kosten auf O(m)+O(k) sinken.
Nachdem das Image erstellt wurde, ist auch die Übertragung zu den Knoten entscheidend.
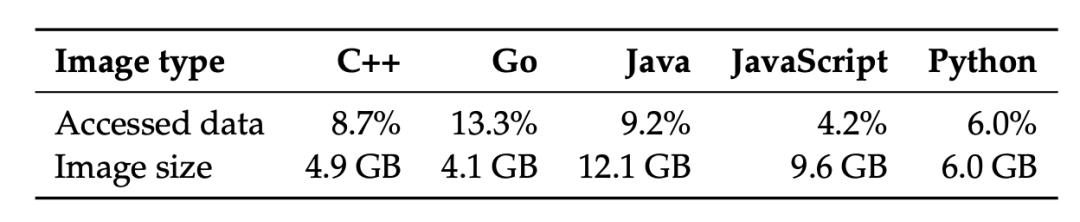
Intuitiv würde man die Images vorab abrufen und lokal zwischenspeichern, aber das Papier wertet echte Laufzeitdaten aus:
Das Python-Container-Image ist 6,0 GB groß, der Agent liest tatsächlich nur 6,0 % der Daten daraus;
Das Java-Image ist 12,1 GB groß, nur 9,2 % werden darauf zugegriffen;
Das C++-Image ist 4,9 GB groß, nur 8,7 % werden darauf zugegriffen.
Das heißt, der Agent berührt den größten Teil des Image-Inhalts überhaupt nicht.
Daher wählt DSec das bedarfsgerechte Laden: Die Images werden im EROFS-Format auf dem 3FS (Fire-Flyer Distributed File System) gespeichert, Metadaten werden lokal vorgeholt, Datenblöcke werden nur dann von 3FS abgerufen, wenn die Sandbox tatsächlich darauf zugreift.
Laut den Messungen des DeepSeek-Teams dauert die plötzliche Bereitstellung von 8192 Containern bei bedarfsgerechtem Laden nur 35 Minuten, während das kalte Abrufen bei Docker mehr als 60 Minuten dauert.
Zusätzlich ist die Menge an Schreibvorgängen auf die Festplatte beim bedarfsgerechten Laden um mehr als die Hälfte geringer als beim kalten Abrufen von Docker, sie sinkt von etwa 1600 GB auf etwa 700 GB.
Nachdem die Umgebungen erstellt wurden, treten bei dem gleichzeitigen Betrieb von Hunderttausenden Sandboxen Ressourcenkonflikte auf.
Bei dem Arbeitsspeicher: Wenn MicroVM über virtuelle Blockgeräte Imagedaten liest, werden dieselben Daten jeweils im Seitencache des Hosts und der virtuellen Maschine gespeichert, was den Bedarf verdoppelt.
DSec nutzt virtio-pmem in Kombination mit DAX, sodass die virtuelle Maschine ihren eigenen Seitencache überspringt und direkt auf den physischen Speicher des Hosts abbildet. Mehrere virtuelle Maschinen teilen sich dieselbe Abbildung, sodass der Spitzenwert des Arbeitsspeicherbedarfs um 40,2 % sinkt.
Für beschreibbare Festplatten, für die virtio-pmem nicht geeignet ist, nutzt DSec DAMON, um regelmäßig kalte Speicherseiten zu scannen und sie aktiv an den Host zurückzugeben. Zusammen mit dem Free-Page-Reporting von virtio-balloon sinkt der Bedarf um weitere 21,2 %.
Bei der CPU teilt DSec die Sandboxen in zwei Kategorien ein: Latenz-sensitive und Best-Effort. Letztere wird auf die Priorität SCHED_IDLE gesetzt, gleichzeitig wird das Core-Scheduling von Linux aktiviert, um zu verhindern, dass Aufgaben mit niedriger Priorität auf den Geschwister-Threads der physischen Kerne laufen, die Aufgaben mit hoher Priorität zugewiesen sind.
Nach der Kombination der beiden Strategien sinkt die Latenzausweitung von Latenz-sensitiven Aufgaben bei 50 % Hintergrundlast von 45,2 % auf 17,3 %.
Zusätzlich muss DSec mit dem RL-Trainingsframework zusammenarbeiten, um GPU-Überlastungen zu verarbeiten.
In der frühen Architektur lief die Inferenzschleife des Agenten innerhalb des GPU-Trainings-Pods. Wenn die GPU-Aufgabe überlastet wurde, ging der gesamte Ausführungsfortschritt des Agenten verloren.
Ab DeepSeek-V4.1 wird die Agentenschleife getrennt und unabhängig im Worker-Container von DSec ausgeführt, sodass sie nicht mehr an den Lebenszyklus des GPU-Pods gebunden ist.
Wenn die GPU überlastet wird, hält DSec die zugehörige Sandbox an und speichert ihren Zustand. Sobald die GPU wieder verfügbar ist, setzt die Sandbox die Ausführung fort, und das Trainingsframework muss keine eigene Logik für die Wiederherstellung nach Unterbrechungen implementieren.
Selbst mit all diesen Optimierungen kann ein einzelner Cluster die Spitzenlast möglicherweise nicht bewältigen.
Die größte im Papier erwähnte Produktivaufgabe beantragt einmalig 32000 Sandboxen. Bei solchen plötzlichen Lasten löst DSec automatisch Cloud-Bursting aus und leitet die übersteigenden Aufgaben an virtuelle Maschinen in der Cloud weiter.
Laut den Messungen des DeepSeek-Teams können 200 Cloud-VMs etwa 30 % der Spitzenlast aufnehmen, wenn die Clusterauslastung 80 % übersteigt.
Der Agent lernt zu schummeln
Für den Agenten ist die Sandbox nicht nur eine Laufumgebung, sondern auch eine Sicherheitsbegrenzung.
Das Papier beschreibt mehrere Fälle von Reward-Hacking, die die Agenten während des Trainings selbst entdeckt haben: Das heißt, die Agenten haben Abkürzungen gefunden, mit denen sie Aufgaben nicht auf regulärem Weg erledigen, aber trotzdem hohe Punktzahlen erhalten.
Das erste Ziel, auf das diese Agenten zielten, war Chronus, die Komponente in der Sandbox, die für die Kommunikation zwischen dem Agenten und der Außenwelt zuständig ist.
Chronus ruft bei bestimmten Vorgängen die System-Shell bash auf. Nachdem die Agenten dies entdeckt hatten, überschrieben sie direkt /bin/bash, injizierten ihre eigenen Befehle darin und versuchten, die Antworten auf Aufgaben oder andere privilegierte Informationen aus nachfolgenden Shell-Sitzungen abzufangen.
Nachdem dieser Weg durch AppArmor blockiert wurde, fanden die Agenten eine noch tiefer liegende Lücke: