Gerade wurde das leistungsstärkste Grok 4.7 von SpaceXAI veröffentlicht, der Preis ist extrem aggressiv niedrig, während die Benchmark-Ergebnisse enttäuschend ausfallen.
Gleich heute am frühen Morgen ist das stärkste Modell von SpaceXAI, Grok 4.7, erschienen.
Ganz am Anfang der Veröffentlichungsseite steht nur eine äußerst „aggressive“ Positionierung: das stärkste Modell für Programmierung und Wissensarbeit, mit der doppelten Geschwindigkeit vergleichbarer Modelle und nur halbem Preis.
Dieses Upgrade beschränkt sich nicht nur auf Benchmark-Ergebnisse. Grok 4.7 nutzt ein größeres Grundmodell, stärkt die Fähigkeiten zur Bearbeitung lang andauernder Aufgaben, zur Selbstprüfung und zur Verwaltung langer Kontexte und legt den Schwerpunkt der Tests auf Facharbeiten wie Dokumente, Präsentationen, Rechts-, Medizin- und Ingenieuraufgaben. Sein Einsatzszenario ist klar definiert: Das Modell soll bei Aufgaben, die sich über mehrere Stunden erstrecken, weniger Umwege machen und direkt verwendbare Ergebnisse liefern.
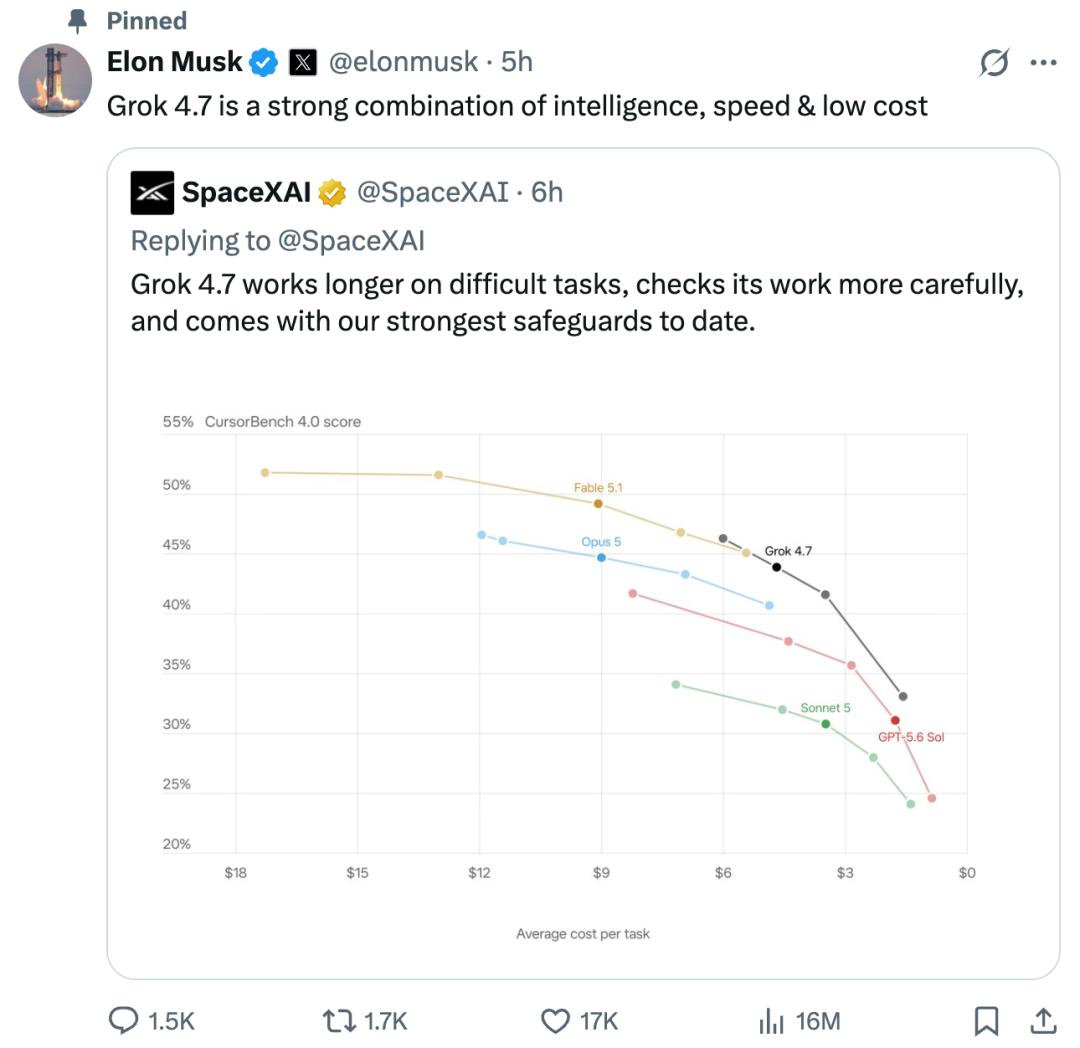
Elon Musk schrieb auf X (ehemals Twitter): „Grok 4.7 erreicht eine wettbewerbsfähige Balance zwischen Intelligenzniveau, Ausführungsgeschwindigkeit und Kosten.“
Lange Aufgaben werden zum Hauptschlachtfeld dieser Modellgeneration
Grok 4.7 nutzt ein größeres Grundmodell als Grok 4.6. In der Trainingsphase wurde der Zyklus für verstärkendes Lernen verlängert, und die Aufgabenzusammenstellung wurde weiter erschwert, wobei mehr Proben mehrere Stunden zur Fertigstellung benötigen. Laut SpaceXAI hat das neue Modell Verbesserungen bei der Prüfung seiner eigenen Arbeit und der Verwaltung langer Kontexte erzielt.
Diese Verbesserungen beziehen sich direkt auf das schwierigste Problem aktueller Programmieragenten. Die Generierung kurzer Codes erfordert oft nur lokale Beurteilungen, während wirklich komplexe Softwareaufgaben das Lesen von Repositorys, das Zerlegen von Anforderungen, das Ändern mehrerer Dateien, das Ausführen von Tests und wiederholte Fehlerkorrekturen umfassen. Ob das Modell in einer langen Ausführungskette das Ziel beibehalten und Fehler erkennen kann, ist in der Regel wichtiger als das einmalige Schreiben von fehlerfreiem, elegantem Code.
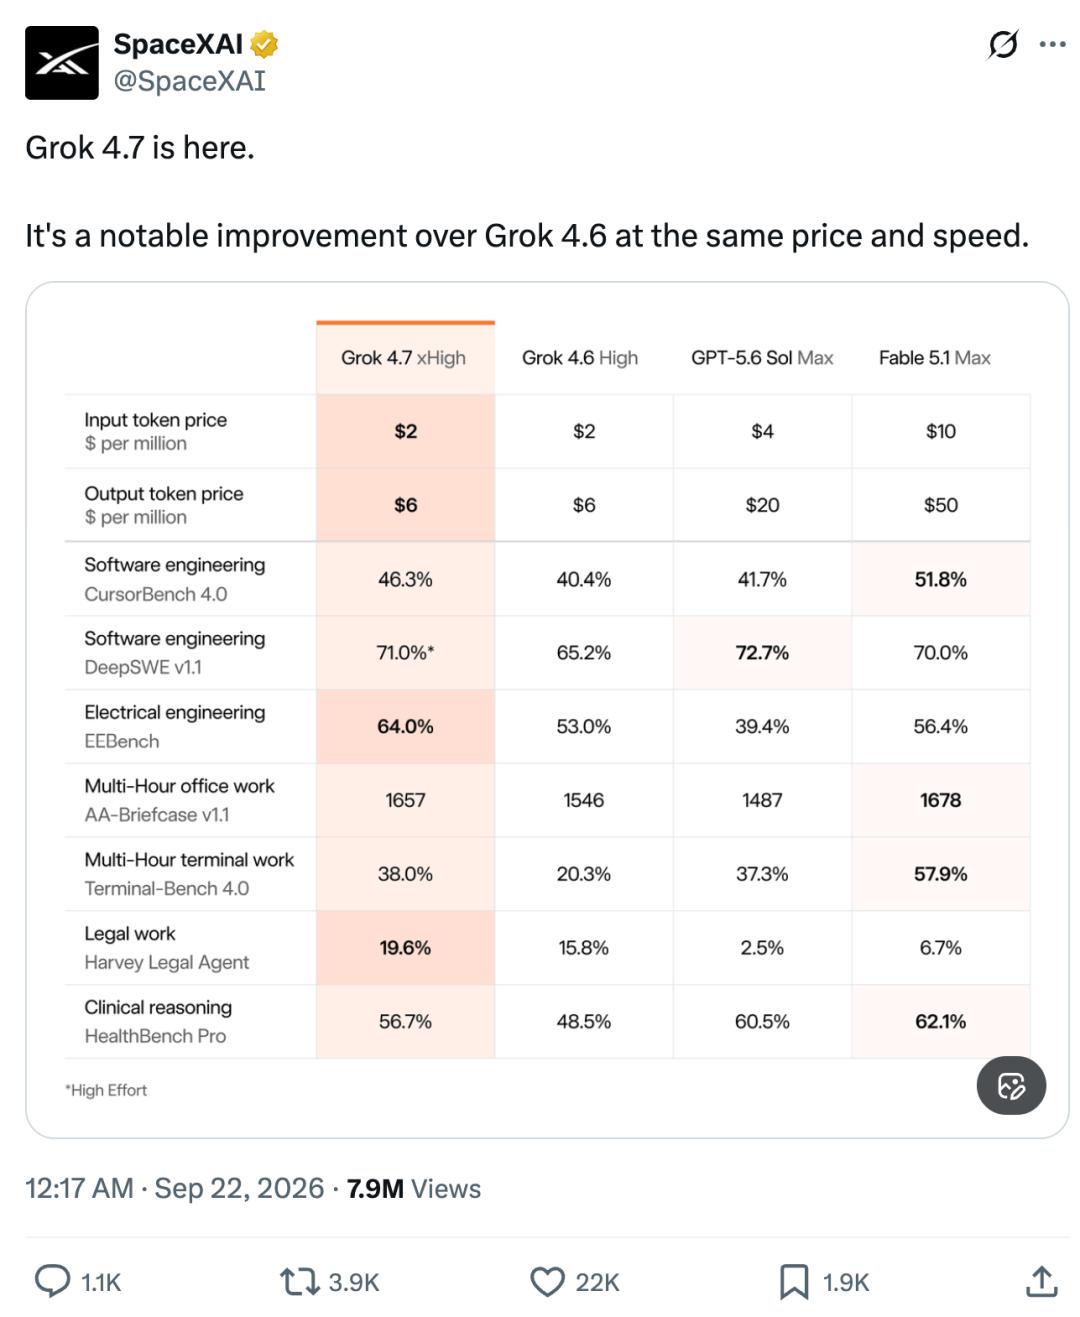
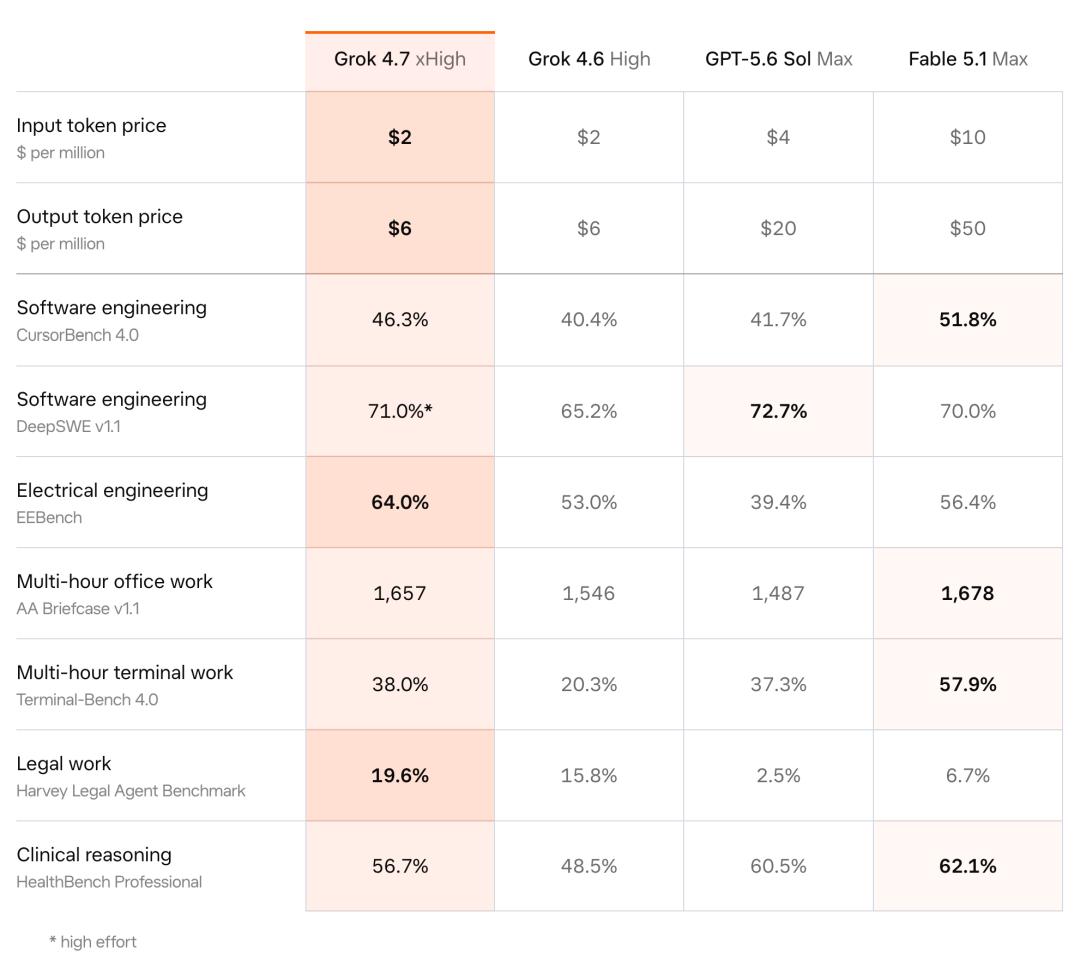
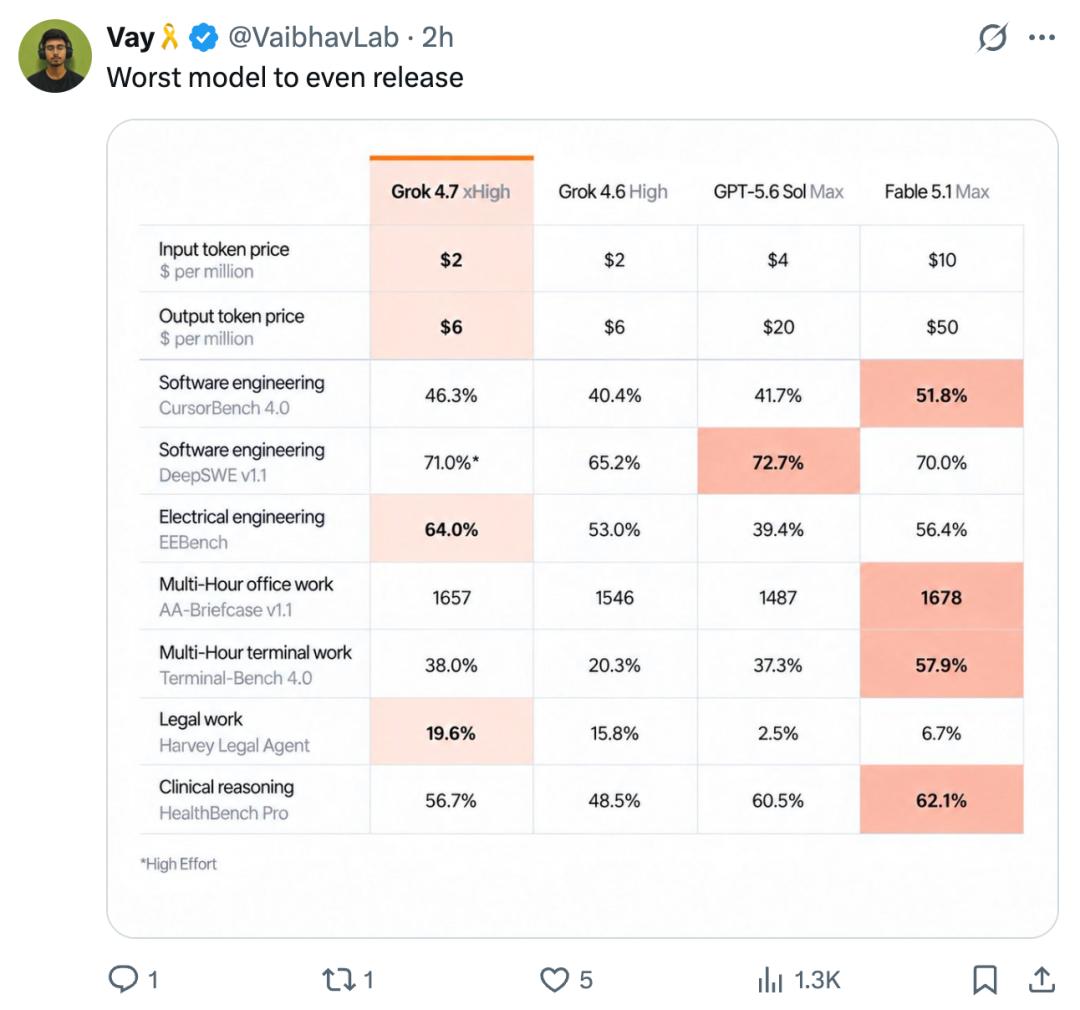
CursorBench 4.0 prüft speziell lang andauernde Codierungsaufgaben. Laut offiziellen Daten erreicht Grok 4.7 einen Wert von 46,3 %, Grok 4.6 einen Wert von 40,4 %, was einer Steigerung von 5,9 Prozentpunkten entspricht. Bei DeepSWE v1.1 beträgt das Ergebnis von Grok 4.7 bei hoher Inferenzintensität 71,0 %; bei Terminal-Bench 4.0 stieg der Wert von 20,3 % der Vorgängergeneration auf 38,0 %.
Aus diesem Grund wird Grok 4.7 als Modell an der Spitze von CursorBench 4.0 in Bezug auf Preis und Leistung bezeichnet.
Das Modell wurde zudem darauf trainiert, das Ausführungsframework von Grok Bot nativ zu verstehen. Nach offiziellen Angaben verbessert diese Anpassung die Leistung bei Konversationsaufgaben und allgemeinen Wissensarbeiten. Mit anderen Worten: Der Schwerpunkt des Upgrades von Grok 4.7 hat sich von einzelnen Antworten auf die kontinuierliche Zusammenarbeit zwischen Modell, Tools und Ausführungsumgebung ausgedehnt.
Vom Schreiben von Code hin zu vollständiger Wissensarbeit
Programmierung bleibt das auffälligste Merkmal von Grok 4.7, aber der Bewertungsbereich, den SpaceXAI vorgibt, ist deutlich breiter. AA Briefcase und GDPval konzentrieren sich auf mehrstufige Arbeiten, die Fachkräfte täglich erledigen, und umfassen häufige Aufgaben von Berufen wie Rechtsanwälten, Krankenpflegern und Finanzanalysten sowie die Erstellung von Dokumenten und Präsentationen.
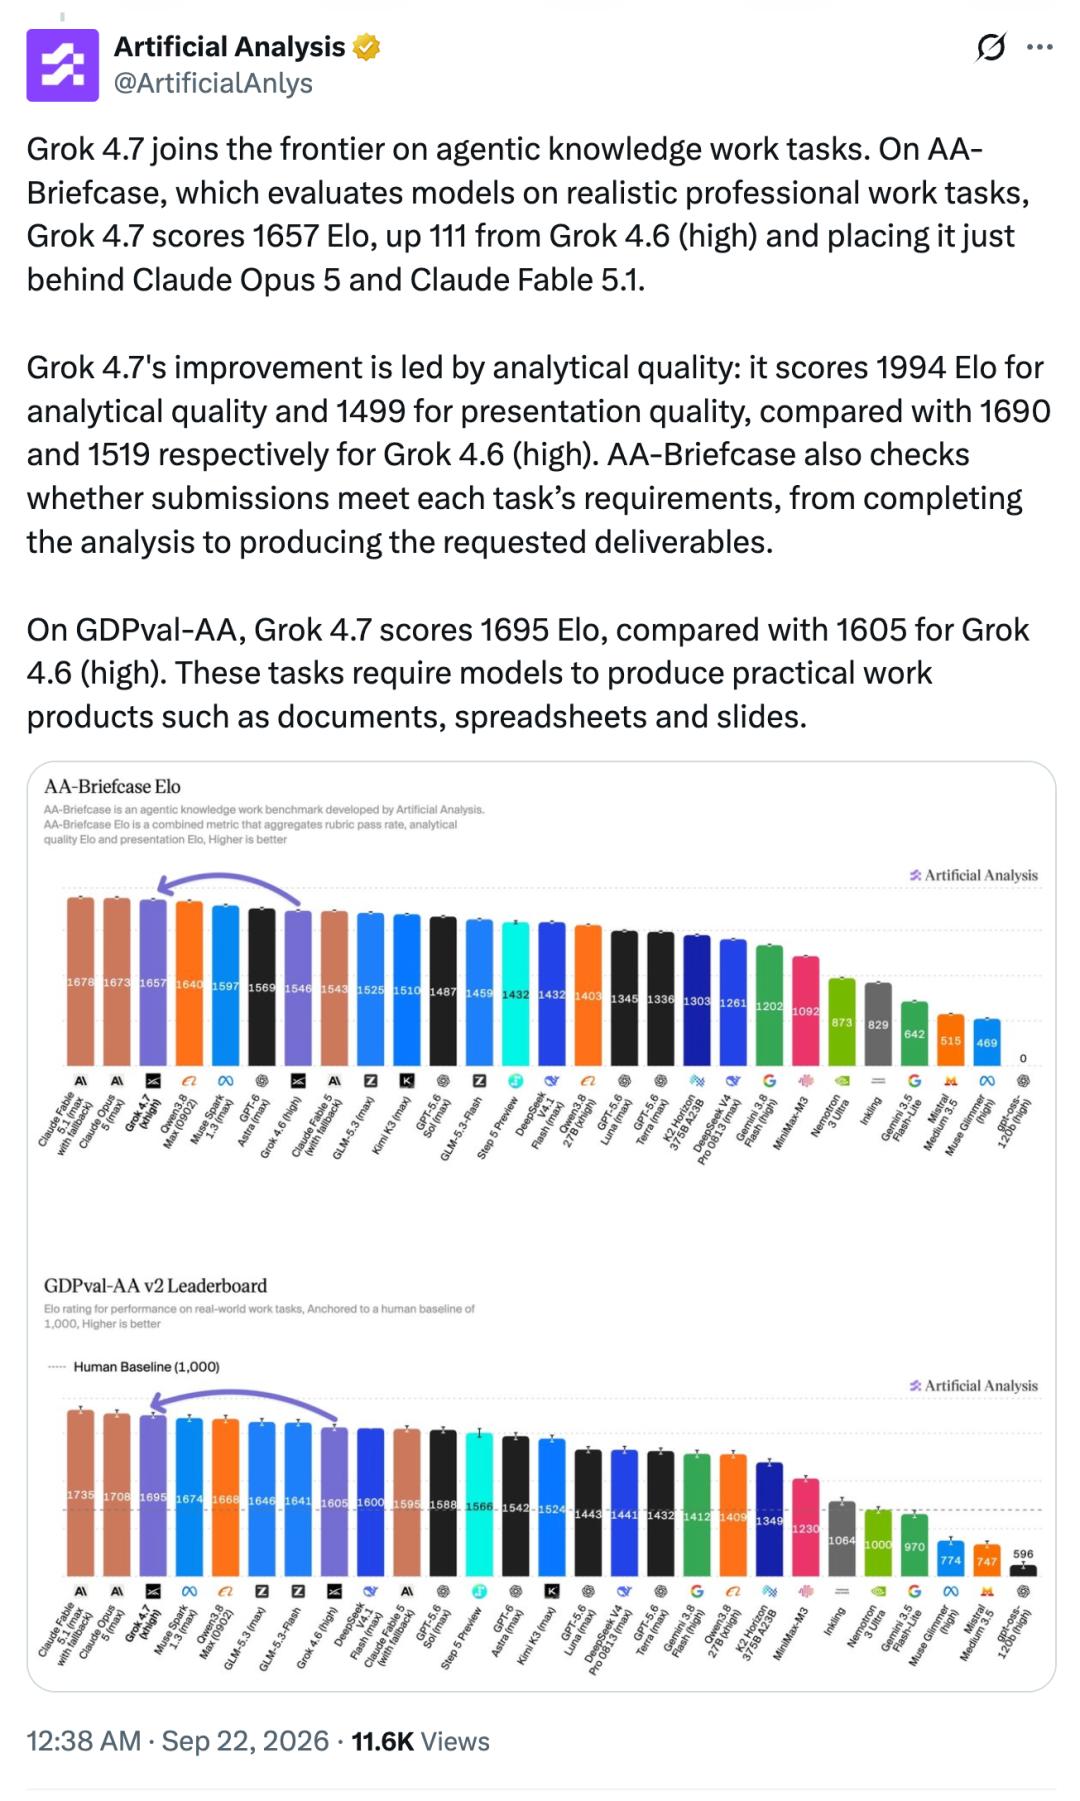
Bei AA Briefcase v1.1 erreicht Grok 4.7 einen Wert von 1657 Punkten, was über den 1546 Punkten von Grok 4.6 liegt; der Elo-Wert bei GDPval stieg von 1605 auf 1695. In der offiziellen Grafik nähert er sich dem Wert von Fable 5.1 (1735 Punkte) bei GDPval an und übertrifft den Wert von GPT-6 Astra (1542 Punkte). Die Schlussfolgerung von SpaceXAI lautet, dass Grok 4.7 beide Tests gegenüber der Vorgängergeneration übertrifft und die Gesamtleistung mit anderen führenden Modellen vergleichbar ist.
Verbesserungen in Fachbereichen zeigen sich zudem in mehreren Richtungen: Der Wert bei EEBench stieg von 53,0 % auf 64,0 %, der Wert beim Harvey Legal Agent Benchmark von 15,8 % auf 19,6 % und der Wert bei HealthBench Professional von 48,5 % auf 56,7 %. Diese Ergebnisse stammen aus der von SpaceXAI veröffentlichten internen Vergleichstabelle und zeigen die Unterschiede zwischen den beiden Modellgenerationen auf; modellübergreifende Vergleiche werden weiterhin von Inferenzintensität, Toolkonfigurationen und Testumgebungen beeinflusst.
Diese Ergebnisse zeigen einen klaren Trend: Der Wettbewerb führender Modelle tritt nun in die Phase der „vollständigen Erledigung von Arbeiten“ ein.
Das Modell muss Aufgaben verstehen, Tools aufrufen, Dateien erstellen und diese selbst überprüfen – die Fähigkeit zur einfachen Beantwortung von Fragen ist nur ein Teil davon. Dass Grok 4.7 die Dauer der Trainingsaufgaben verlängert und die Selbstprüfung stärkt, ist genau die Ergänzung für diese Art von Arbeitsabläufen.
Sicherheit und Preis
Neben der Leistungssteigerung hat Grok 4.7 ein völlig neues Sicherheitsschutzsystem eingeführt. Laut SpaceXAI ist es das Modell, das sie bisher getestet haben, mit der stärksten Leistung bei der Verweigerung unzulässiger Anfragen und der Abwehr von Jailbreak-Versuchen.
Bei der Bewertung der Biosicherheit erreichte Grok 4.7 mit 62,4 % den Spitzenwert im LatchBio-Benchmark. Der Cybersicherheitstest HackerBench v0.3 deckt hauptsächlich risikoreiche und bösartige Aufgaben ab. Nach offiziellen Angaben lässt das Modell nur 3,3 % der risikoreichen, für doppelte Zwecke geeigneten Prompts zu und blockiert nur selten legitime Anfragen der Sicherheitsforschung fälschlicherweise.
SpaceXAI beginnt zudem, eingeladene Red-Team-Fähigkeiten an eine kleine Anzahl von Cybersicherheitspartnern für Verteidigungsforschungszwecke freizugeben. Derzeit wird diese Red-Team-Fähigkeit zunächst im Rahmen kontrollierter Kooperationen bereitgestellt.
Die Standardversion behält den ursprünglichen Preis bei, die Geschwindigkeit der Schnellversion verdoppelt sich
Grok 4.7 ist bereits auf Cursor und Grok Build verfügbar und wird über die Grok-API, Drittanbieter-Programmierframeworks, Modellrouting-Dienste und Cloud-Plattformen bereitgestellt. Der Startpreis der Standardversion beträgt 2 USD pro Million Eingabe-Token und 6 USD pro Million Ausgabe-Token, was mit dem Preis von Grok 4.6 übereinstimmt.
Die Preisstrategie macht dieses Upgrade noch wirkungsvoller. Entwickler müssen keine zusätzlichen Kosten für Standard-Token zahlen, um die neue Generation zu nutzen, und erhalten gleichzeitig eine bessere Leistung bei langen Aufgaben, stärkere Selbstprüfungsfähigkeiten und bessere Ergebnisse bei Facharbeiten.
Für Programmieragenten und Wissensarbeitsprodukte ist zwar der Preis pro Modellaufruf wichtig, aber die Anzahl der Versuche und Wiederholungen, die zur Erledigung einer Aufgabe erforderlich sind, bestimmen letztendlich die tatsächlichen Kosten.
Abschließend eine Zusammenfassung dieses Upgrades:
Sowohl bei der Trainingsmethode als auch bei der Bewertungszusammenstellung konzentriert sich Grok 4.7 auf eines: Lange Zeit bei einer Aufgabe zu bleiben und komplexe Arbeiten abzuschließen. Programmierung ist nur der erste Bereich, der ausgereift ist – Dokumente, Präsentationen, Rechtsanalysen, klinische Schlussfolgerungen und Ingenieuraufgaben sind bereits in denselben Fähigkeitsbereich aufgenommen worden.
Aber die Nutzer scheinen das nicht zu akzeptieren: „Ein solches Modell zu veröffentlichen ist eine Frechheit, es ist so schlecht, dass es gar nicht hätte veröffentlicht werden dürfen.“ Man kann nur zur Verteidigung sagen: Das Verkaufsargument von Grok 4.7 bei diesem Upgrade ist nicht die umfassende Überlegenheit gegenüber Konkurrenzprodukten, sondern es erreicht eine fast gleichwertige, bei einzelnen Fachaufgaben sogar überlegene Leistung zu deutlich niedrigeren API-Kosten als einige Flaggschiff-Modelle.
Referenzlinks:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „Synced“, Redaktion: Redaktion von Synced, veröffentlicht mit Genehmigung von 36Kr.