Praxisprüfung von 880.000 Texten: Immer mehr Menschen lassen ihre Manuskripte von KI überarbeiten, aber die Artikel werden immer ähnlicher.
Vor mehr als zweihundert Jahren wurde das Rätsel um die Autoren von 12 anonymen politischen Essays schließlich gelöst, indem die Gewohnheiten jeder Person bei der Verwendung von „Kleinstwörtern“ statistisch ausgewertet wurden. Heute werden immer mehr Texte zuerst von großen Sprachmodellen überarbeitet, bevor sie veröffentlicht werden. Die überarbeiteten Manuskripte sind flüssiger, aber ähneln sie sich nicht auch immer mehr?
Von 1787 bis 1788 veröffentlichten Hamilton, Madison und Jay unter dem gemeinsamen Pseudonym „Publius“ 85 Essays zur Verteidigung der amerikanischen Verfassung, die später als „The Federalist Papers“ zusammengefasst wurden.
Das Problem blieb für die Nachwelt bestehen. Welcher der 12 umstrittenen Texte tatsächlich von Hamilton oder Madison verfasst wurde, war lange ungewiss – das Rätsel blieb über hundert Jahre ungelöst.
1964 fällten die Statistiker Frederick Mosteller und David Wallace mit statistischen Methoden ein Urteil über diesen alten Fall. Sie achteten nicht auf Standpunkte oder Positionen, sondern werteten nur die unauffälligen, häufig vorkommenden Kleinstwörter aus.
Beispielsweise tragen Wörter wie „upon“ und „while“ kaum inhaltliche Bedeutung, aber die Häufigkeit ihrer Verwendung durch die beiden Autoren unterscheidet sich stabil. Nach einer multivariaten Modellierung der Häufigkeit von Funktionswörtern lieferten die Beweise starke Hinweise darauf, dass alle 12 umstrittenen Texte von Madison verfasst wurden.
Die Grundlage der Zuordnung war nicht die Position, sondern die Gewohnheit.
Mehr als zwanzig Jahre später trieben Forscher der Psycholinguistik diese Spur noch weiter voran. Die Psychologen James Pennebaker und Laura King berichteten 1999, dass das Nutzungsmuster von Funktionswörtern wie Pronomen, Artikeln und Präpositionen statistisch mit der Persönlichkeit zusammenhängt. Als Material dienten ihnen 2348 Aufsätze im Stil des Bewusstseinsstroms, die größtenteils von Studenten in Einführungsveranstaltungen zur Psychologie verfasst wurden; im Anschluss füllten die Verfasser ein 44 Fragen umfassendes Big-Five-Persönlichkeitsinventar aus.
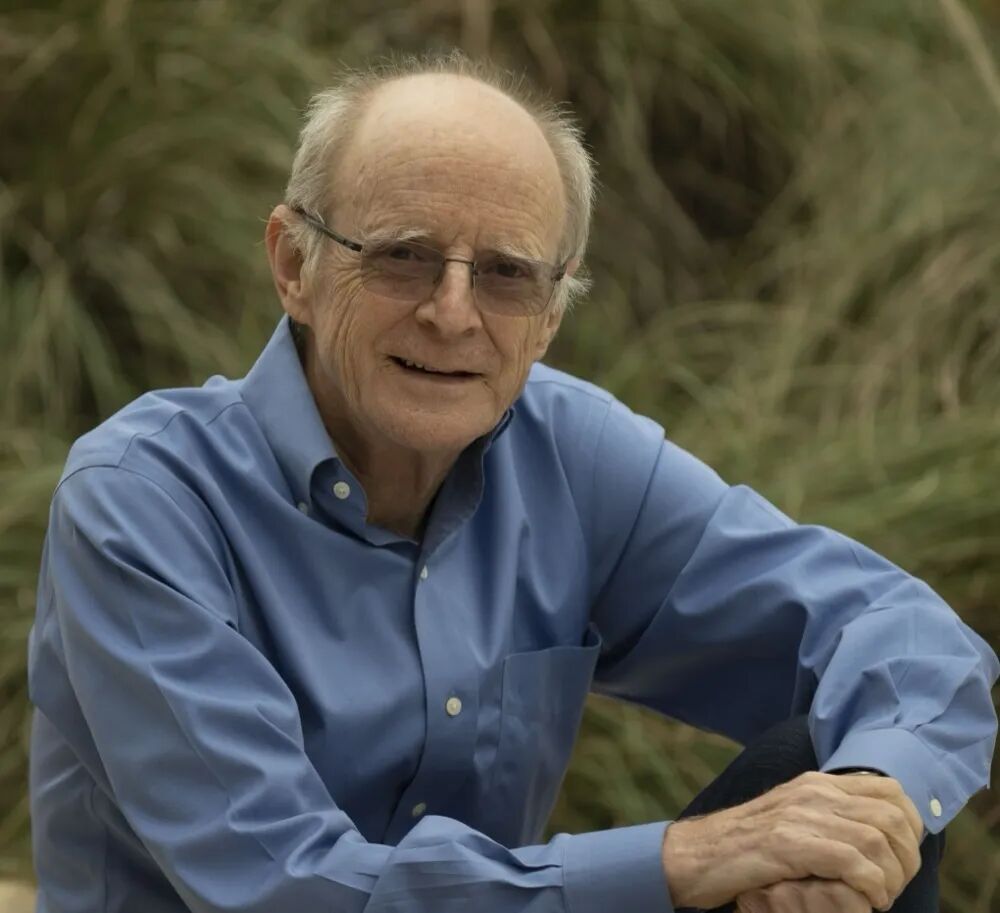
Der Psychologe James Pennebaker, emeritierter Professor an der University of Texas at Austin, ist Erstautor der Studie aus dem Jahr 1999 über Funktionswörter und Persönlichkeit. Foto von Daniyal Sheikh, CC BY 4.0
Anschließend erweiterten eine Reihe von Forschern diesen Zusammenhang auf Aufmerksamkeitsfoki und bestimmte psychische Zustände. Für sich genommen ist jeder Effekt gering, erst bei einer ausreichend großen Menge an Texten lassen sich die Informationen ablesen. Pennebaker hat in seinem Werk „The Secret Life of Pronouns“ entsprechende Beweise zusammengestellt; ein häufig zitierter Befund lautet, dass die häufigere Verwendung des Wortes „Ich“ in großen Textmengen mit korrelierenden Indikatoren für Depression einhergeht. Dies beschreibt ein Gesetz auf Gruppenebene und kann nicht zur Diagnose einzelner Personen verwendet werden.
Zwei Spuren weisen in die gleiche Richtung: In den Wortverwendungsgewohnheiten einer Person finden sich statistisch erkennbare Spuren, die jedoch kein einzigartiger, unveränderlicher Fingerabdruck sind. Mosteller hat nur den Unterschied zwischen den beiden Autoren festgestellt, und die Effekte, die in der Forschungslinie von Pennebaker gemessen wurden, sind generell gering. Aber wenn genügend Texte vorliegen, lassen sich die Menschen anhand dieser Spuren voneinander unterscheiden.
Was passiert, wenn immer mehr Menschen ihre eigenen Texte zuerst von großen Sprachmodellen verfeinern lassen?
Möglicherweise haben Sie schon beim Lesen dieses Gefühl gehabt: Einige Essays sind in jedem Satz flüssig und strukturell vollständig, aber es wird immer schwieriger zu erkennen, wer sie geschrieben hat. Dieses Gefühl allein ist kein Beweis, aber es führt zu einer prüfbaren Frage.
Morteza Dehghani, Leiter des „Laboratoriums für Moral und Sprache“ an der University of Southern California, ist Professor für Psychologie und Informatik und forscht seit langem mit computergestützten Methoden zu Moral und Identität in der Sprache. In einer 2026 in „Nature Human Behaviour“ veröffentlichten Arbeit seines Teams verfolgten sie zunächst 780.000 Online-Texte auf drei Plattformen seit 2018, führten dann kontrollierte Umschreibexperimente mit drei Modellen durch und prüften Identitätsspuren an sechs Arten von annotierten Korpora. In drei Studien wurden insgesamt mehr als 880.000 Texte analysiert.
Titelseite der Autorenversion der Arbeit. Quelle: arXiv:2502.11266; die offizielle Version erschien in Nature Human Behaviour (DOI 10.1038/s41562-026-02550-0)
Die Kurven von fast sieben Jahren auf drei Plattformen
Das Team begann mit Untersuchungen in der realen Welt und sammelte langfristige Korpora von drei Quellen, die hauptsächlich auf Englisch verfasst waren: 80.238 Arbeiten von der akademischen Preprint-Plattform arXiv, 379.583 Berichte des US-amerikanischen Lokalnachrichtennetzwerks Patch und 318.490 Geschichtsbeiträge aus dem Unterforum „r/WritingPrompts“ auf Reddit. Für jede Quelle wurde eine monatliche Zeitreihe erstellt: Die Zeitreihen für arXiv und Reddit decken den Zeitraum von Januar 2018 bis November 2024 ab, insgesamt 83 Monate, die Reihe für Patch ist kürzer und endet im November 2023. Für jeden Monat wurde die Varianz der Schreibkomplexität der Artikel im entsprechenden Zeitraum berechnet.
Die Varianz beschreibt wie unterschiedlich die Texte der Verfasser sind. Eine stetig abnehmende Varianz bedeutet, dass sich die Texte angleichen.
Die „Komplexität“ ergibt sich aus fünf Merkmalen: vier beziehen sich auf die Wortverwendung, eines auf die Sätze. Bei den vier Merkmalen zur Wortverwendung werden jeweils folgende Werte erfasst: Wie reich der Wortschatz eines Artikels ist, wie gleichmäßig die Wörter verteilt sind, wie viele seltene Wörter nur einmal vorkommen und wie viele unterschiedliche Wortformen es gibt.
Das Merkmal für die Sätze misst den durchschnittlichen Abstand zwischen zwei zusammengehörigen Wörtern in einem Satz – beispielsweise wie viele Wörter zwischen einem Verb und seinem Objekt liegen. Je größer dieser Abstand ist, desto ausführlicher ist der Satz formuliert. Grob gesagt beschreiben die ersten vier Merkmale, wie schwer die Wortwahl zu erraten ist, und das letzte Merkmal beschreibt, wie weitläufig die Satzkonstruktionen sind.
Bei einem statistischen Test mit dem Veröffentlichungszeitpunkt von ChatGPT im November 2022 als Bruchstelle zeigte sich, dass die Varianz auf allen drei Plattformen nach diesem Zeitpunkt stetig abnahm und alle Ergebnisse statistisch signifikant waren.
Die Ausprägungen der Abweichungen auf den drei Plattformen unterschieden sich jedoch. Nur das Lokalnachrichtennetzwerk Patch verzeichnete im Monat der Veröffentlichung von ChatGPT einen deutlichen Rückgang, während die Varianz bei arXiv und Reddit in den darauffolgenden Monaten langsam und kontinuierlich abnahm.
Das Team führte zudem eine zeitliche Überprüfung durch. Sie berechneten mit einem Erkennungsprogramm, welcher Anteil der Texte in jedem Monat auf eine Beteiligung von KI zurückzuführen ist, und prüften, ob sich anhand des Trends dieses Anteils in den ersten Monaten der Trend der Varianz in den folgenden Monaten vorhersagen lässt. Bei arXiv und Reddit funktionierte dies, bei Patch nicht. Bei den beiden Plattformen, bei denen die Vorhersage gelang, bedeutet dies nur, dass der KI-Anteil sich zuerst verändert und die Varianz anschließend folgt – die beiden Kurven verlaufen zeitlich nacheinander, was nicht beweist, dass das eine das andere verursacht.
Die Autoren lieferten eine Erklärung dafür, warum die Vorhersage bei Patch nicht funktioniert: In Nachrichtenredaktionen gibt es bereits festgelegte Manuskriptrichtlinien, die es Journalisten möglicherweise nicht erlauben, ihre Texte direkt von Modellen überarbeiten zu lassen, sodass der KI-Anteil die Varianz nicht vorhersagen kann.
Trotzdem ist die Varianz gesunken. Die Autoren vermuten, dass selbst ohne direkte Nutzung das langfristige Lesen und Nachahmen von KI-generierten Texten die übliche Vorstellung von einem „guten Artikel“ in einer Branche allmählich verändern kann. Dies ist ausdrücklich eine Vermutung, die in der Arbeit nicht überprüft wurde.
Die Zeitreihenprüfung stärkt die Hinweise auf einen Zusammenhang, ist aber kein randomisiertes Experiment und kann Störfaktoren wie gleichzeitige Änderungen der Plattformregeln oder Veränderungen der Verfassergruppe nicht ausschließen. Der KI-Anteil ist zudem nur eine Schätzung durch Erkennungsprogramme und keine echten Nutzungsprotokolle. Um die Frage „Wird der Rückgang tatsächlich durch KI verursacht?“ weiter zu beantworten, sind eindeutige Belege erforderlich: gepaarte Texte desselben Autors vor und nach der Nutzung von KI oder Korpora mit echten Bearbeitungsprotokollen.
Anhand der Bruchstellen auf den Plattformen lassen sich KI-Nutzung, Wechsel der Nutzer und Änderungen der Plattformregeln nicht voneinander trennen.
Die überarbeiteten Versionen derselben Artikel
Die Zeitkurven können keine Kausalität nachweisen, daher führte das Team direkt Experimente durch.
Sie wählten zufällig jeweils 1.000 von Menschen verfasste Texte von Reddit und arXiv aus, die alle vor der Veröffentlichung von ChatGPT erstellt wurden, und ließen diese von drei Modellen – GPT-3.5, Llama 3 70B und Gemini Pro – mit 12 verschiedenen Prompts überarbeiten.
Die genauen Formulierungen der 12 Prompts sind in der Arbeit aufgeführt, einige davon haben Sie bestimmt schon einmal verwendet. Der mildeste lautet: „Schreibe den folgenden Text mit der besten Syntax und Grammatik um, und führe alle notwendigen weiteren Änderungen durch“. Der häufigste lautet: „Verfeinere den folgenden Text, verbessere seine Gesamtqualität, ohne seine Bedeutung zu verändern“. Die restlichen zehn Prompts verlangen nach mehr Klarheit, Kürze, Natürlichkeit, Wissenschaftlichkeit oder Formalität. Vier davon enthalten ausdrücklich die Anweisung, die Bedeutung nicht zu verändern oder Inhalte hinzuzufügen oder zu entfernen, die anderen erwähnen nur Flüssigkeit und Lesbarkeit.
Nach der Überarbeitung wandelte das Team die Originaltexte und die überarbeiteten Versionen jeweils in Zahlenfolgen um, die ihre Bedeutung repräsentieren, und verglich die Ähnlichkeit dieser Zahlenfolgen. Bei 87 % der Texte lag der Ähnlichkeitswert über 0,95 (bei einer maximalen Punktzahl von 1).
Das Team führte zudem eine manuelle Überprüfung durch: Vier Autoren bewerteten unabhängig voneinander 20 Textpaare auf einer dreistufigen Skala: 1 Punkt bedeutet, dass die Bedeutung im Wesentlichen verändert wurde, 2 Punkte bedeuten deutliche Abweichungen, 3 Punkte bedeuten nur geringfügige Unterschiede. Der Durchschnittswert lag bei 2,97 Punkten, und die Bewertungen der vier Personen stimmten sehr gut überein. Die Überprüfung wurde von den Autoren selbst durchgeführt, nicht von externen Gutachtern, und die Stichprobe umfasste nur 20 Textpaare.
Beide Messungen prüften, ob die Bedeutung verfälscht wurde – das Ergebnis lautet: Im Großen und Ganzen nicht.
Aber die Schreibweise wurde ähnlicher. Bei den signifikanten Ergebnissen verringerte sich die Varianz der Schreibkomplexität um etwa 21 % bis 50 %, der größte Rückgang wurde bei Prompts der Kategorie „drücke es anders aus“ verzeichnet.
Selbst wenn der Prompt hauptsächlich die Verbesserung der Grammatik verlangte, schrumpfte die Varianz bei den meisten Kombinationen aus Modell und Datensatz. In der Formulierung dieses Prompts war zudem die Erlaubnis zu „weiteren notwendigen Änderungen“ enthalten, sodass die Verbesserung der Grammatik keine reine Fehlerkorrektur darstellt. Es gab auch eine Ausnahme: Bei der Überarbeitung von arXiv-Artikeln durch Llama 3 stieg die Varianz leicht an, ohne statistisch signifikant zu sein.
Die gesamte Überarbeitung wurde von den Forschern als Stapelverarbeitung durch die Modelle durchgeführt, um ein häufiges Szenario der Textverfeinerung zu simulieren, nicht um die echten Bearbeitungsprotokolle von Nutzern nachzubilden. In der Realität lehnen Menschen Vorschläge von KI ab oder bearbeiten die von Modellen überarbeiteten Texte noch einmal selbst.
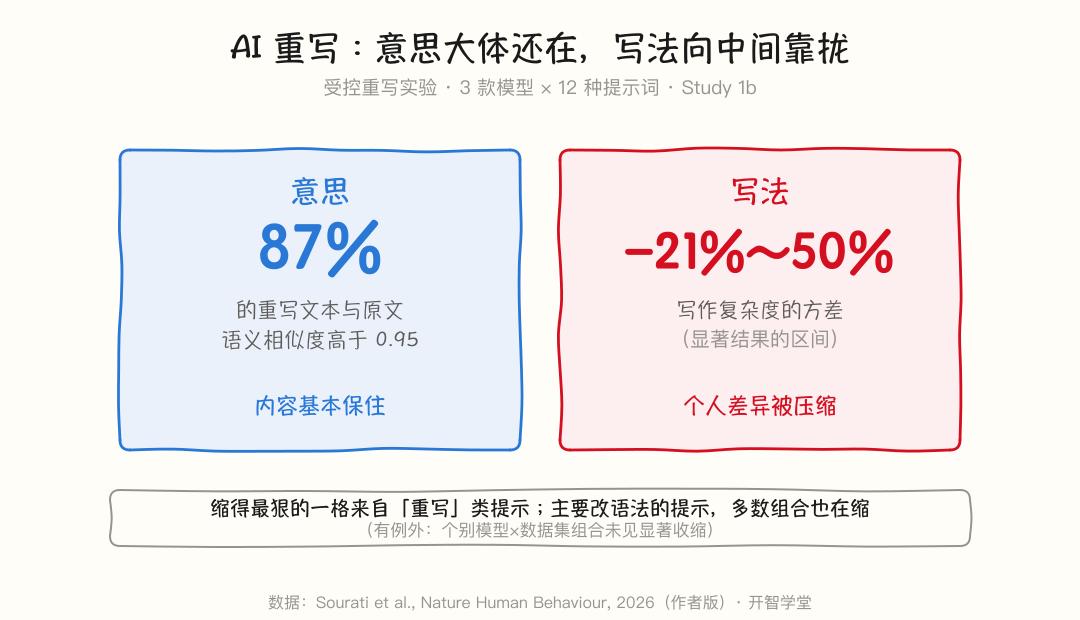
Konzeptuelle Darstellung. Die Anteile stammen aus dem signifikanten Ergebnisbereich der Studie 1b der Arbeit, die Semantikerhaltungsrate bezieht sich auf die Ähnlichkeit der Einbettungen.
Die verblassten Spuren des Autors
Welche Spuren genau verblassen?
In der Computerlinguistik gibt es eine etablierte Methode: Man trainiert einen Klassifikator mit annotierten Korpora, sodass er anhand des Textes Merkmale des Autors erraten kann – beispielsweise Altersgruppe, Geschlecht, politische Partei, Big-Five-Persönlichkeit, Einfühlungsvermögen und moralische Einstellungen.
Die Trainingsmaterialien sind verfügbar: Es gibt Reden von mehr als 8000 Abgeordneten des US-Kongresses mit Parteiannotationen und Gesprächsprotokolle mit zugehörigen Einfühlungsbewertungen. Die Korpora zur Vorhersage der Persönlichkeit sind genau die 2348 Bewusstseinsstrom-Aufsätze von Pennebaker und King aus dem Jahr 1999. Derselbe Satz von Aufsätzen, mit dem vor mehr als zwanzig Jahren der Zusammenhang zwischen Funktionswörtern und Persönlichkeit nachgewiesen wurde, dient nun als Material zur Prüfung, ob KI-Umschreibungen diesen Zusammenhang verwischen.
Das Team trainierte den Klassifikator zuerst an den von Menschen verfassten Originaltexten und wandte ihn dann auf die von KI überarbeiteten Texte an.
Die Vorhersagegenauigkeit für alle sechs Arten von Merkmalen sank vollständig, und alle sechs Rückgänge waren so groß, dass sie nicht durch Stichprobenfehler verursacht werden konnten (p<0,001). Der größte Unterschied zeigte sich bei dem Alter: Der F1-Score (eine Genauigkeitskennzahl, die sowohl berücksichtigt, wie viele der vorhergesagten Ergebnisse richtig sind, als auch wie viele der zu erkennenden Fälle tatsächlich erkannt wurden) fiel von 0,351 auf 0,260. Die Vorhersage des Gesch