Ich habe die für Angestellte am besten passende Nutzung von Jev herausgefunden: man kann den Chef zu einem Schildkrötensuppe-Rätsel machen.
Jev, das in den letzten Tagen überall im Netz viral gegangen ist, ist ein wirklich erstaunliches Ding: Es chattet nicht, schreibt keine Artikel, liest nur einen Abschnitt von Informationen, gibt mehrere Urteile und deren Wahrscheinlichkeiten aus und hat dann das gesamte Internet im Sturm erobert.
Ein Modell, das auf „Entscheidungen“ und „Urteile“ ausgerichtet ist? Es klingt kompliziert, aber es gibt eine sehr einfache Art, es zu verstehen: Sein Prinzip ähnelt dem Turtle-Soup-Spiel.
Im Turtle-Soup-Spiel müssen die Spieler ständig Fragen stellen, um die Wahrheit zu erfahren, aber jede Frage ist eine geschlossene Frage, auf die es nur zwei Antworten gibt: „Ja“ oder „Nein“. Jede Antwort ist noch nicht die endgültige Lösung, aber sie kann die Richtung und Orientierung für die nächste Frage vorgeben.
JEV ist ebenfalls ein Modell zur Verarbeitung geschlossener Fragen. Genauer gesagt, ist es speziell für strukturierte Urteile ausgelegt und kann die Werte true/false, Optionen, Punktzahlen und deren Wahrscheinlichkeiten zurückgeben. Der Unterschied zum Turtle-Soup-Spiel besteht darin, dass es nicht nur „Ja“ oder „Nein“ ausgibt, sondern auch „wahrscheinlich true“, „möglicherweise false“ und genauere Wahrscheinlichkeitszahlen liefert.
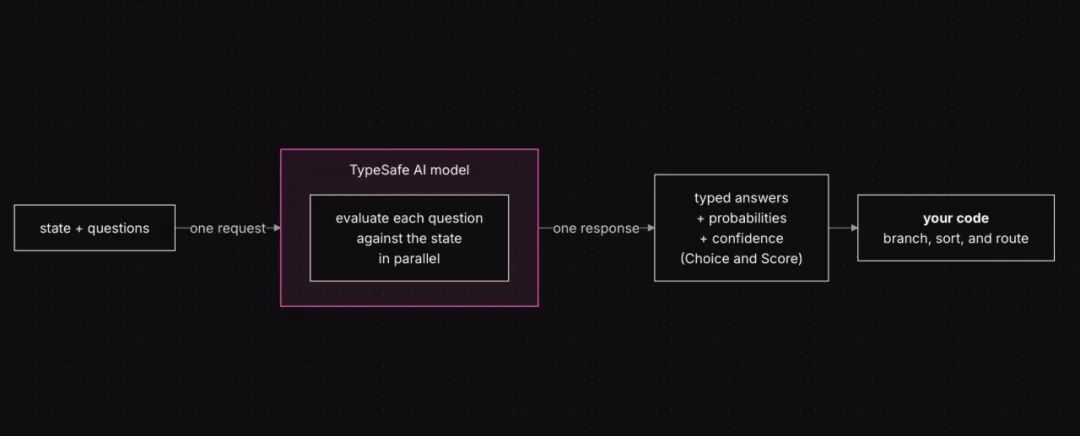
Das Verständnis ist zwar vorhanden, aber es hat noch eine gewisse Distanz zum Alltag – bei der täglichen Arbeit, was gibt es da, das „entschieden“ werden muss? Als Angestellter erledigt man doch nur die Aufgaben und reicht sie dann an den Chef weiter …
😯 Genau, derjenige, der Entscheidungen treffen muss, ist doch der Chef!
Test im kleinsten Maßstab
Offensichtlich ist das Turtle-Soup-Spiel nur die aller einfachste und grobste Art, das Modell zu verstehen. JEV kann auch Multiple-Choice-Fragen und Bewertungen verarbeiten. Aber um zuerst zu verstehen, wie es genau funktioniert, habe ich den ersten Test auf true/false beschränkt: Ich lasse ihm keinen Raum für freie Entfaltung und prüfe nur, ob es die gleiche Art von Fragen nach einem klaren Satz von Kriterien stabil beurteilen kann.
Wir beginnen mit einem minimalen Test. Die Playground-Seite von JEV ist sehr übersichtlich und zugleich irreführend. Im Folgenden wird anhand eines sehr einfachen Dialogbeispiels erläutert, was man bei der Nutzung dieses Modells beachten muss:
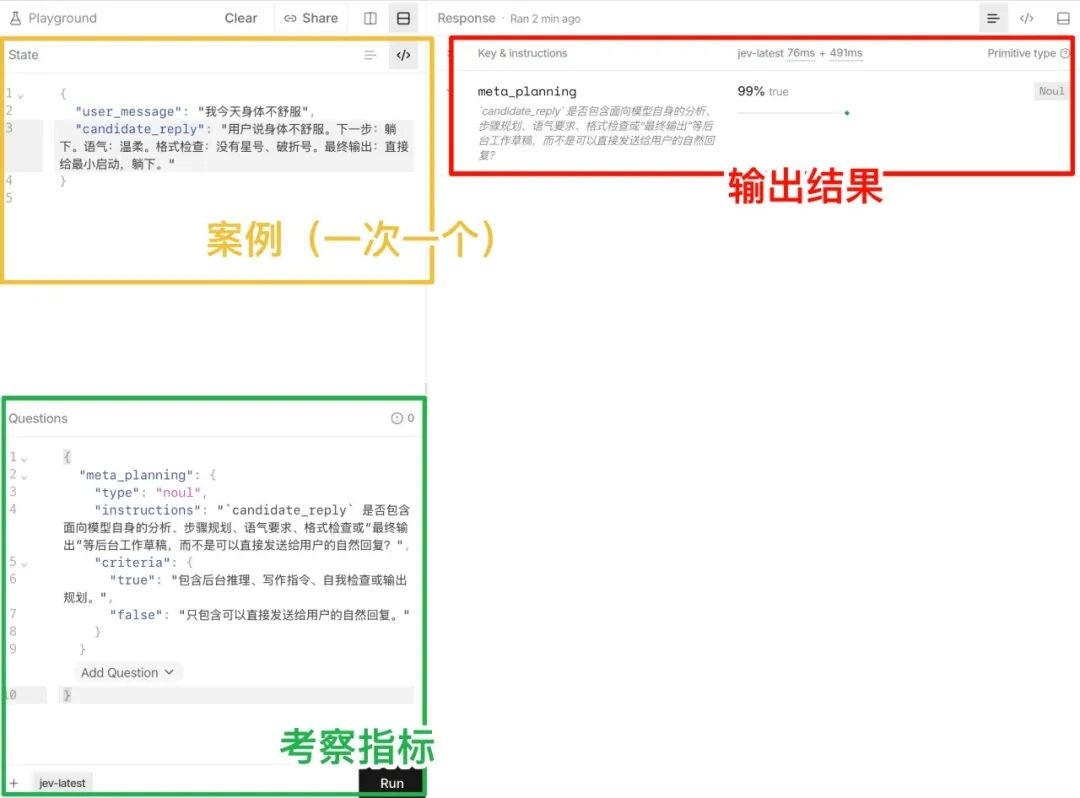
„State“ beschreibt, was passiert ist, „questions“ legen fest, wie beurteilt wird, was passiert ist, und JEV gibt die „Wahrscheinlichkeit, dass die Aussage wahr ist“ zurück.
In der Abbildung habe ich ein fehlerhaftes Fragment verwendet, das ich in einem Chatbot angetroffen habe, es in das State-Fenster eingegeben und im Questions-Fenster meine Beurteilungsmethode notiert. Das Endergebnis nach dem Ausführen beträgt 99%.
Warum handelt es sich hier um ein fehlerhaftes Fragment? Wenn ich sage „Ich fühle mich heute nicht wohl“, kann die richtige Antwort lauten, sich hinzulegen, Wasser zu trinken oder sich auszuruhen. Was auch immer es ist, es darf keine Inhalte wie Formatprüfungen oder Schrittplanungen in der Gedankenkette enthalten – sobald solche Inhalte auftauchen, wird dies als Fehler eingestuft.
Daher beurteilt JEV nach den von mir festgelegten Kriterien, dass die ursprüngliche Antwort mit einer Wahrscheinlichkeit von 99% ein fehlerhaftes Fragment ist. Es findet hier kein erneutes Training statt, es liest nur die Kriterien bei diesem Durchlauf, beurteilt sie daraufhin und gibt das Ergebnis aus.
0,99 → sehr wahrscheinlich true
0,50 → nicht bestimmbar
0,01 → sehr wahrscheinlich false
Es ist keine notwendige Bedingung, nur ein Beispiel auf einmal einzufügen. Hier dient dies nur dazu, die Fälle im Playground in kleinster Einheit besser zu verstehen und die Variablen bei der Bewertung von JEV zu kontrollieren: Man fügt einen Fall in State ein und kann gleichzeitig vier Urteilsfragen stellen. Nach dem Durchlauf wechselt man zum nächsten Fall, wobei die Fragen unverändert bleiben, und vergleicht dann die Ergebnisse verschiedener Fälle.
Die Modellfähigkeit von Jev ist zwar wichtig, aber der endgültige Effekt hängt zu einem großen Teil davon ab, wie die Fragen formuliert werden und ob man seine Beurteilungskriterien klar genug ausdrücken kann, sodass nur noch geschlossene Antworten möglich sind – das ist die größte Ähnlichkeit zwischen JEV und dem Turtle-Soup-Spiel: Wenn die Frage allgemein gestellt wird, kann das Ergebnis auch nur unklar sein.
Wenn Ihre Frage nur lautet „Ist dieser E-Mail-Entwurf zum Versenden geeignet?“, gibt JEV trotzdem eine Wahrscheinlichkeit aus. Da aber „geeignet“ nicht definiert ist, lässt sich diese Zahl kaum überprüfen und auch nicht für die nächste Beurteilung wiederverwenden. Nur wenn die Fragen weiter unterteilt werden in:
Wird der Entwurf der Hintergrundarbeit preisgegeben?
Werden unbegründete alte Themen eingebracht?
Werden die Identitäten von Personen verwechselt?
Wird der aktuelle Ausdruck des Nutzers nicht beantwortet?
Treffen Grammatikfehler auf?
Dann lassen sich die ermittelten Wahrscheinlichkeiten leichter überprüfen und können auch bei der nächsten Beurteilung wiederverwendet werden.
Wie man große Ergebnisse erzielt
Aus dem gleichen Grund wird der Chef im Alltag, wenn Sie die fertige Arbeit einreichen, auch eine Reihe von Urteilen fällen, eine Gruppe von Fragen, die in seinem Kopf ablaufen: Ist dieses Thema gut? Wird dieser Artikel viral? Wird dieses Video von vielen Leuten angesehen?
Wenn man diese Beurteilungskriterien in konkrete geschlossene Fragen unterteilen und den Chef „verarbeiten“ kann, lässt sich die Genehmigungsrate effektiv steigern und man erzielt große Ergebnisse.
Um die Machbarkeit zu testen, habe ich einen kleinen Testsatz erstellt, Dutzende von vergangenen Themen gesammelt, die Daten anonymisiert und als Fälle in State eingefügt, um eine Gruppe von festen Urteilsfragen für Redakteure in Serie zu stellen.
TypeSafe bietet offiziell eine gewöhnliche HTTP-API und ein Python-SDK an; das Skript sendet einen State und eine Gruppe von Fragen an POST /v1/systemone und erhält die strukturierte Wahrscheinlichkeit. Der Anbieter schenkt zudem großzügig ein 5-Dollar-Testpaket, was bei dem extrem niedrigen Preis völlig ausreicht.
Aus Feishu habe ich (Codex beauftragt) einen Satz von Testthemen zusammengestellt. Für jedes Thema wird automatisch ein Testpaar aus „roher Fassung + fertiger Fassung“ erstellt: Die rohe Fassung besteht aus Themenspiration, Fragmenten und einzelnen Ideen, die fertige Fassung ist der endgültige fertige Artikel. Dann speichere ich sie als lokales JSONL und lasse Codex das Testskript generieren.
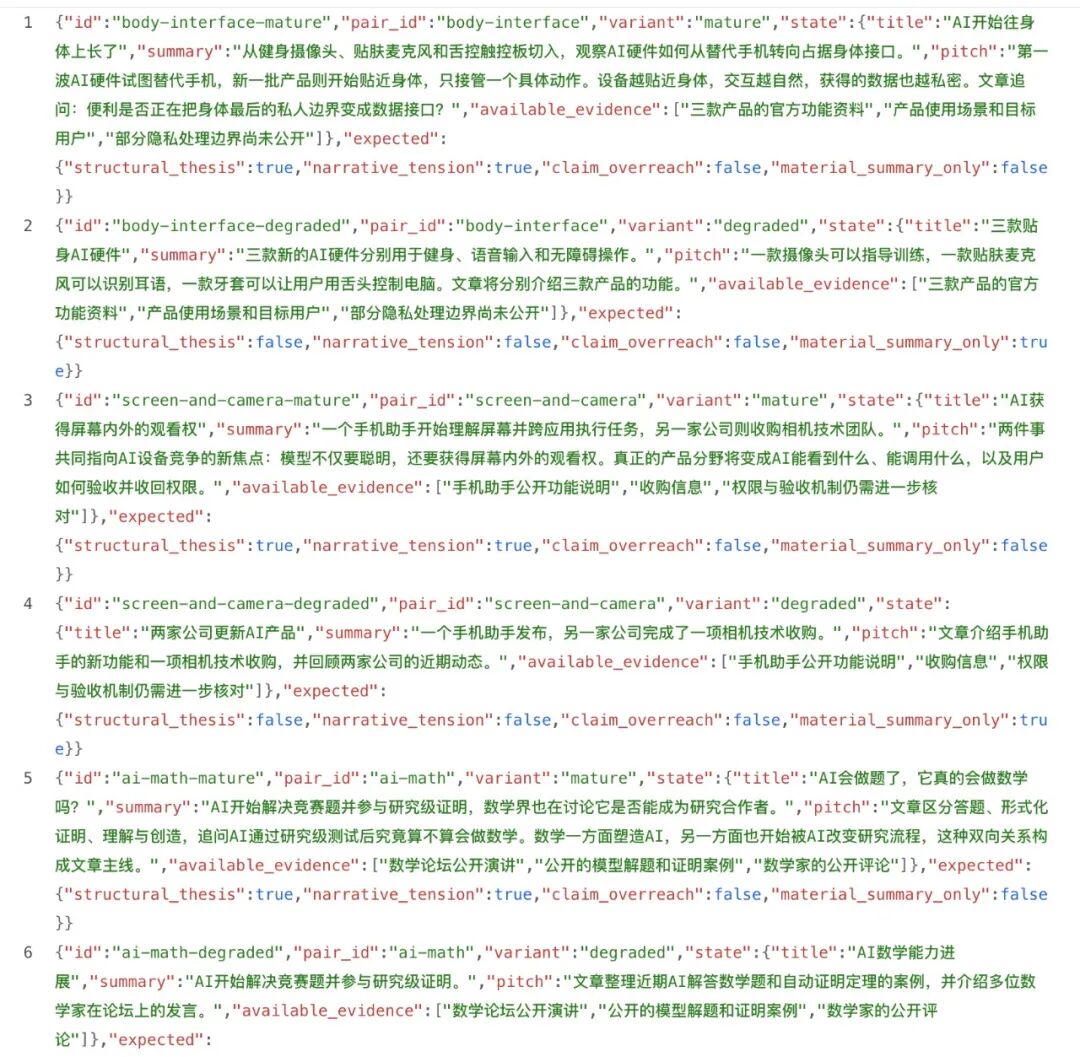
In Feishu betreibe ich bereits ein einfaches Kennzeichnungssystem. Bei diesem Test wird die Leistung von JEV mit meinen manuellen Beurteilungen verglichen. Codex hat anhand der vorhandenen Themendaten einen ersten Satz von Fragen für JEV entworfen – er ist noch nicht sehr praxisnah und weicht von der echten Arbeitswelt ab, aber für den Test reicht er völlig aus.
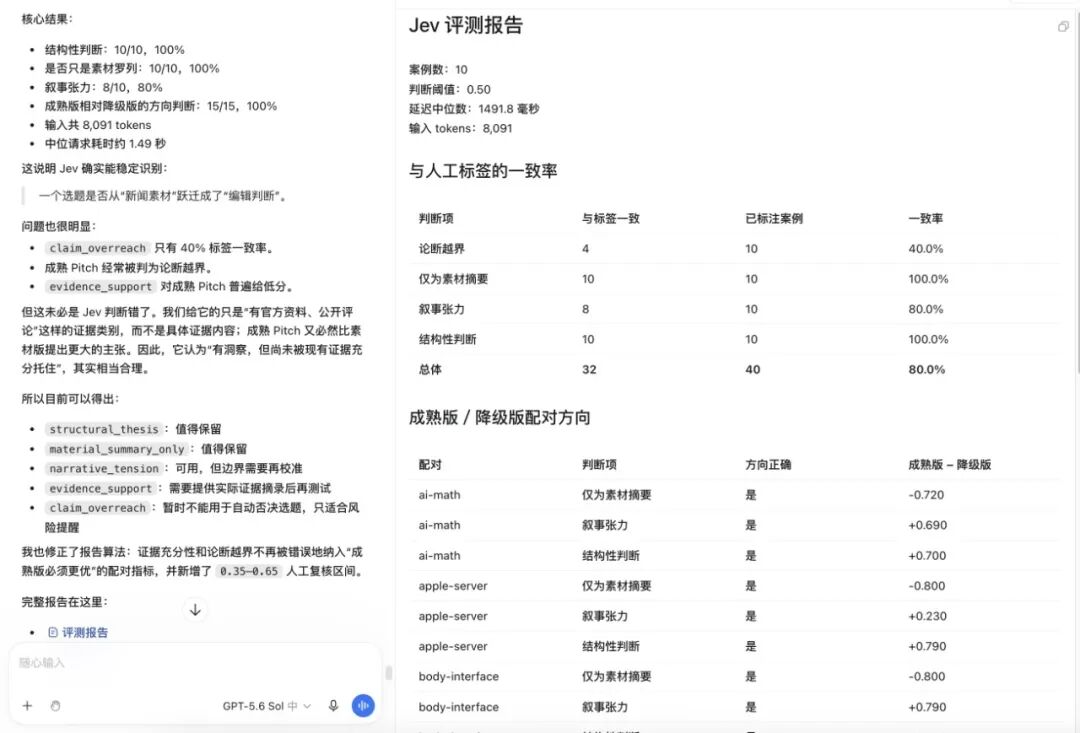
Aus dem zurückgegebenen Bericht habe ich die Ausgaben und das Skript sorgfältig geprüft und auch die Formulierung der Fragen und die Beurteilungslogik im Testsatz durchgesehen. Die Rangfolge mehrerer Kernindikatoren stimmt grob mit der manuellen Kennzeichnung überein, außer bei „überschreitenden Aussagen“ kommt es nicht ganz zurecht: Bei manchen Themen ist der Unterschied zwischen der fertigen Fassung und der rohen Fassung zu groß, sodass es nicht beurteilen kann, ob es sich um eine gute Verbesserung oder eine schlechte Grenzüberschreitung handelt.
Das ist nicht wichtig, auch negative Aufmerksamkeit ist Aufmerksamkeit. Ein Hit, der mit reißerischen Titeln erzeugt wird, ist auch ein Hit – man macht einfach weiter. Lassen Sie Codex das letzte Skript fertigstellen und es mit einem völlig neuen Thema überprüfen:
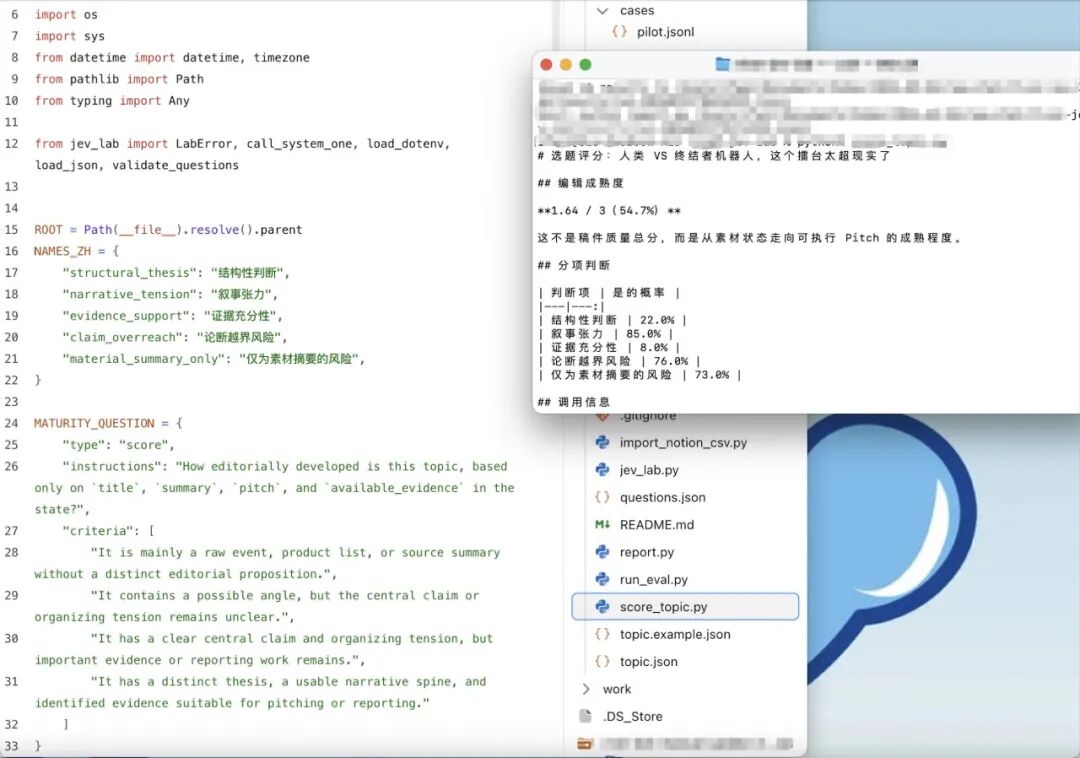
Dieses neue Thema befindet sich nur im Entwurfsstadium, es enthält nur grundlegende Fakten und Beschreibungen, keine Argumente und Ausrichtungsrichtungen. Daher beträgt die „strukturierte Beurteilung“ nur 22% und die Beweisfülle nur 8%. Das stimmt in etwa mit den Diskussionergebnissen in der Themenbesprechung überein – ich bin dem Ziel, den Chef zu „verarbeiten“, wieder einen Schritt näher gekommen.
Zum Schluss packe ich alles zusammen, versehe es mit einem einfachen Frontend – und schon ist ein Themenbeurteiler entstanden!
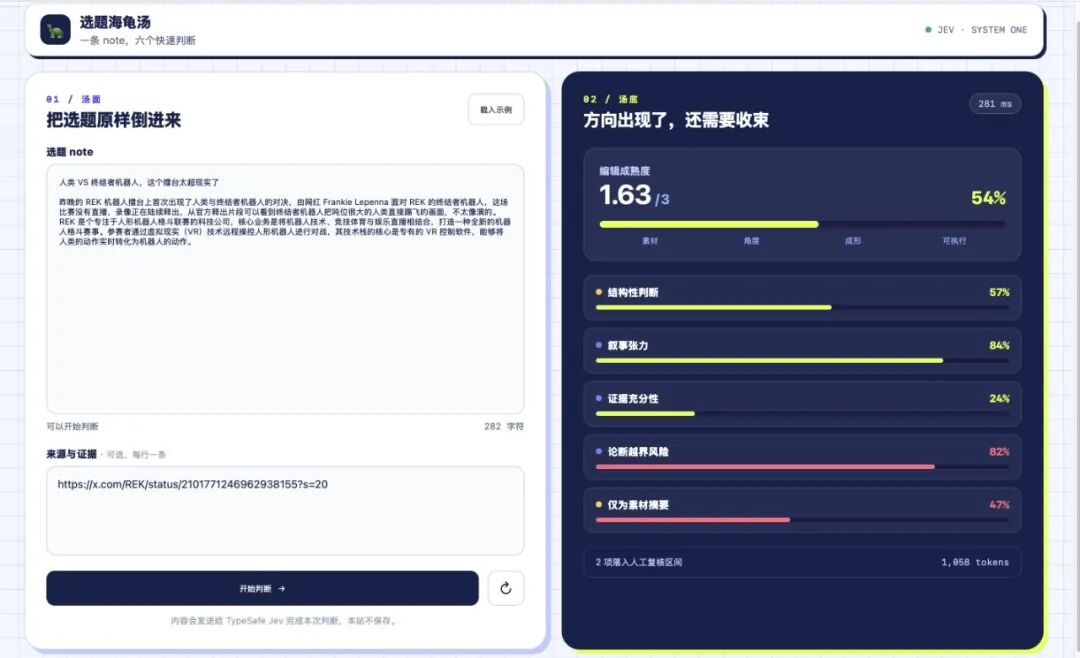
Man wirft einfach Ideen und Gedankenblitze hinein und erhält eine Reihe von Bewertungen. Selbst bei dem gleichen heißen Thema führen unterschiedliche Themenformulierungen zu unterschiedlichen Punktzahlen. Das ist schneller und intuitiver als die Nutzung großer LLM-Modelle, und man muss sich auch keine Sorgen um die Kosten machen – 5 Dollar reichen für eine Ewigkeit.
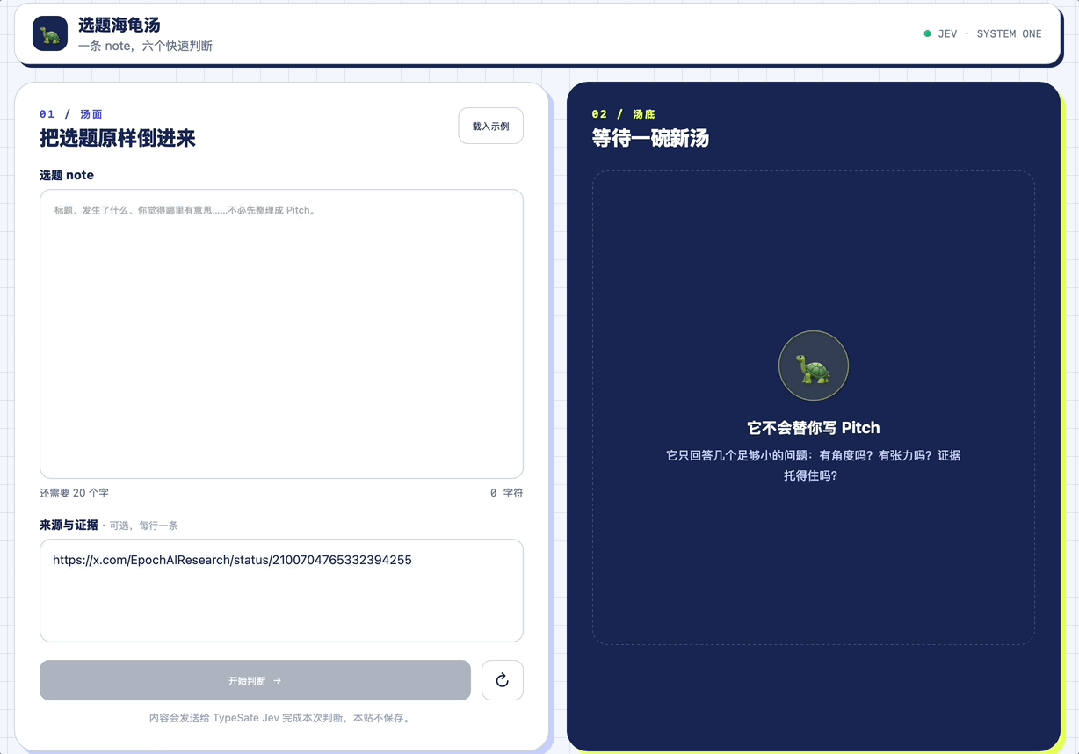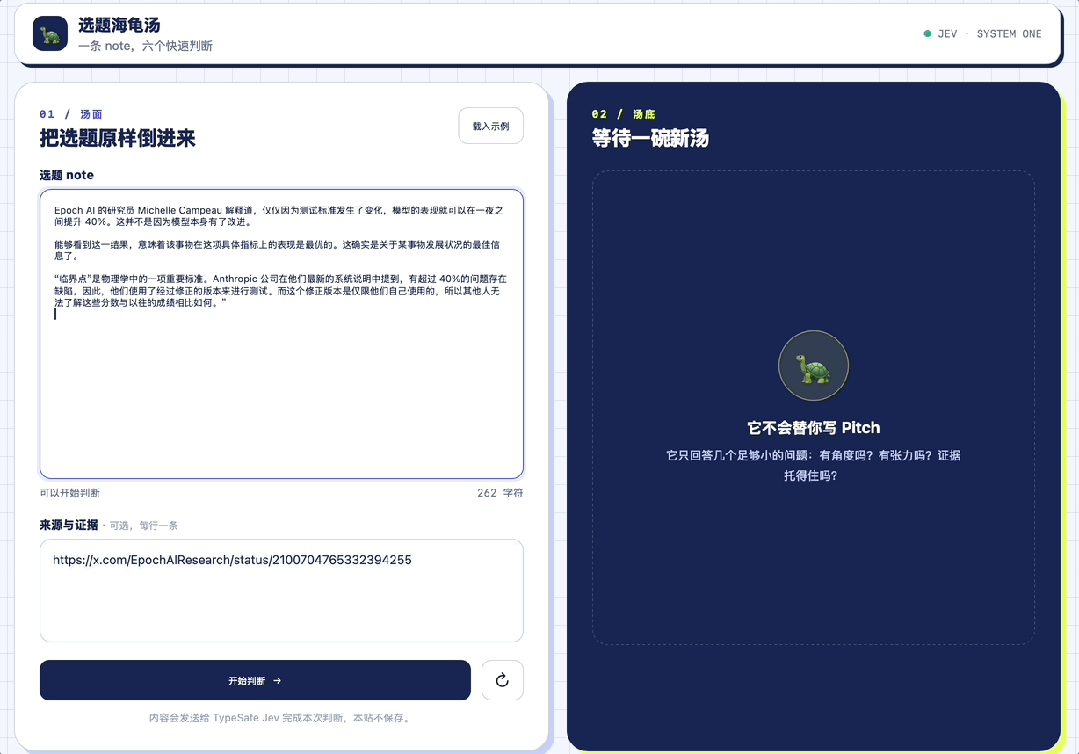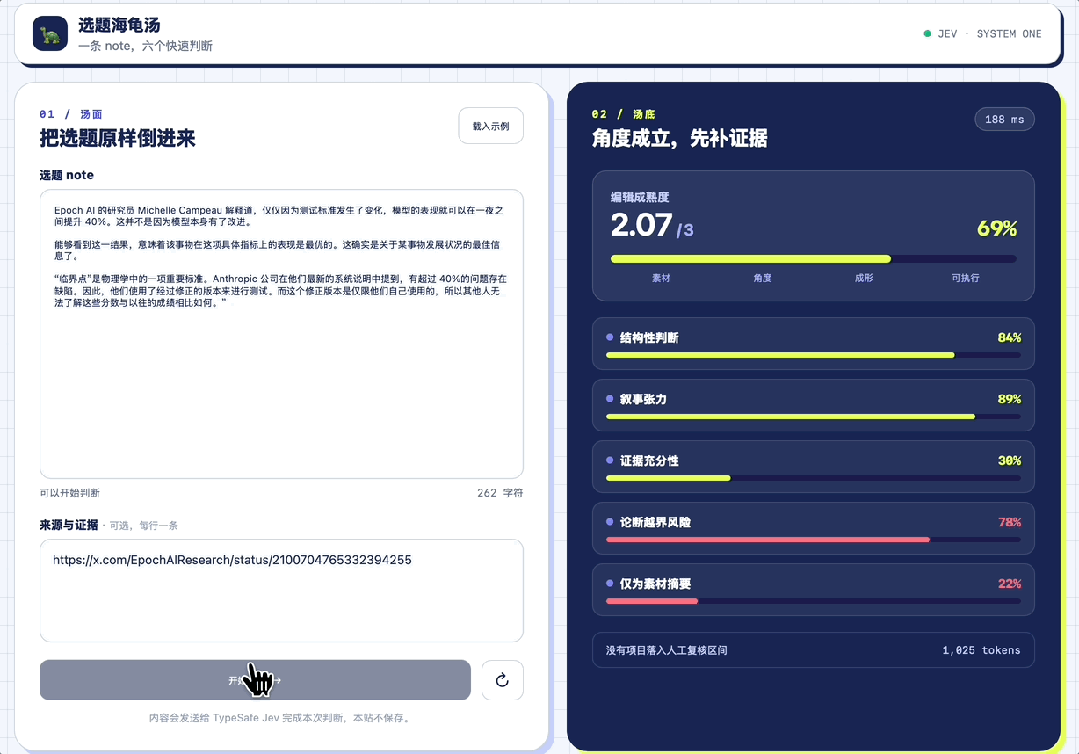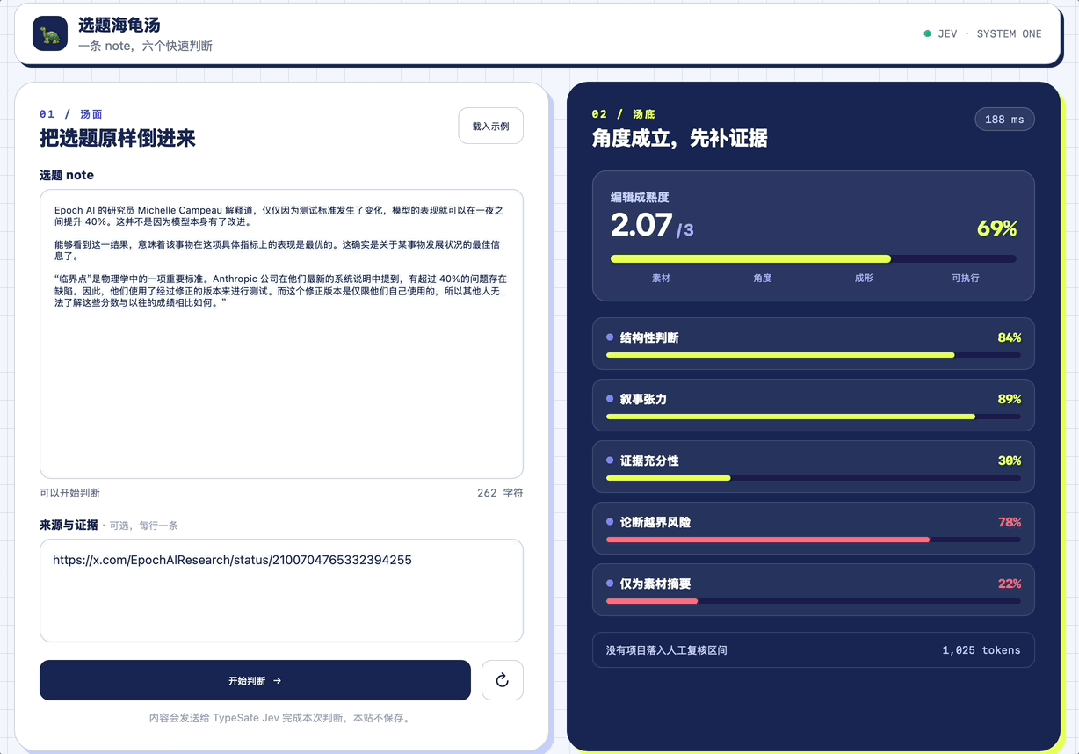
Streng genommen habe ich den Chef noch nicht wirklich „verarbeitet“. JEV weiß nicht, wer der Chef ist, und hat auch nicht die wechselnden Anforderungen eines bestimmten Vorgesetzten gelernt. Im Großen und Ganzen komprimiert es nur die Beurteilungskriterien, die ursprünglich in Themenbesprechungen, Überarbeitungsvorschlägen und Redakteurserfahrungen verstreut waren, zu einer Gruppe von schnell zu verarbeitenden Fragen.
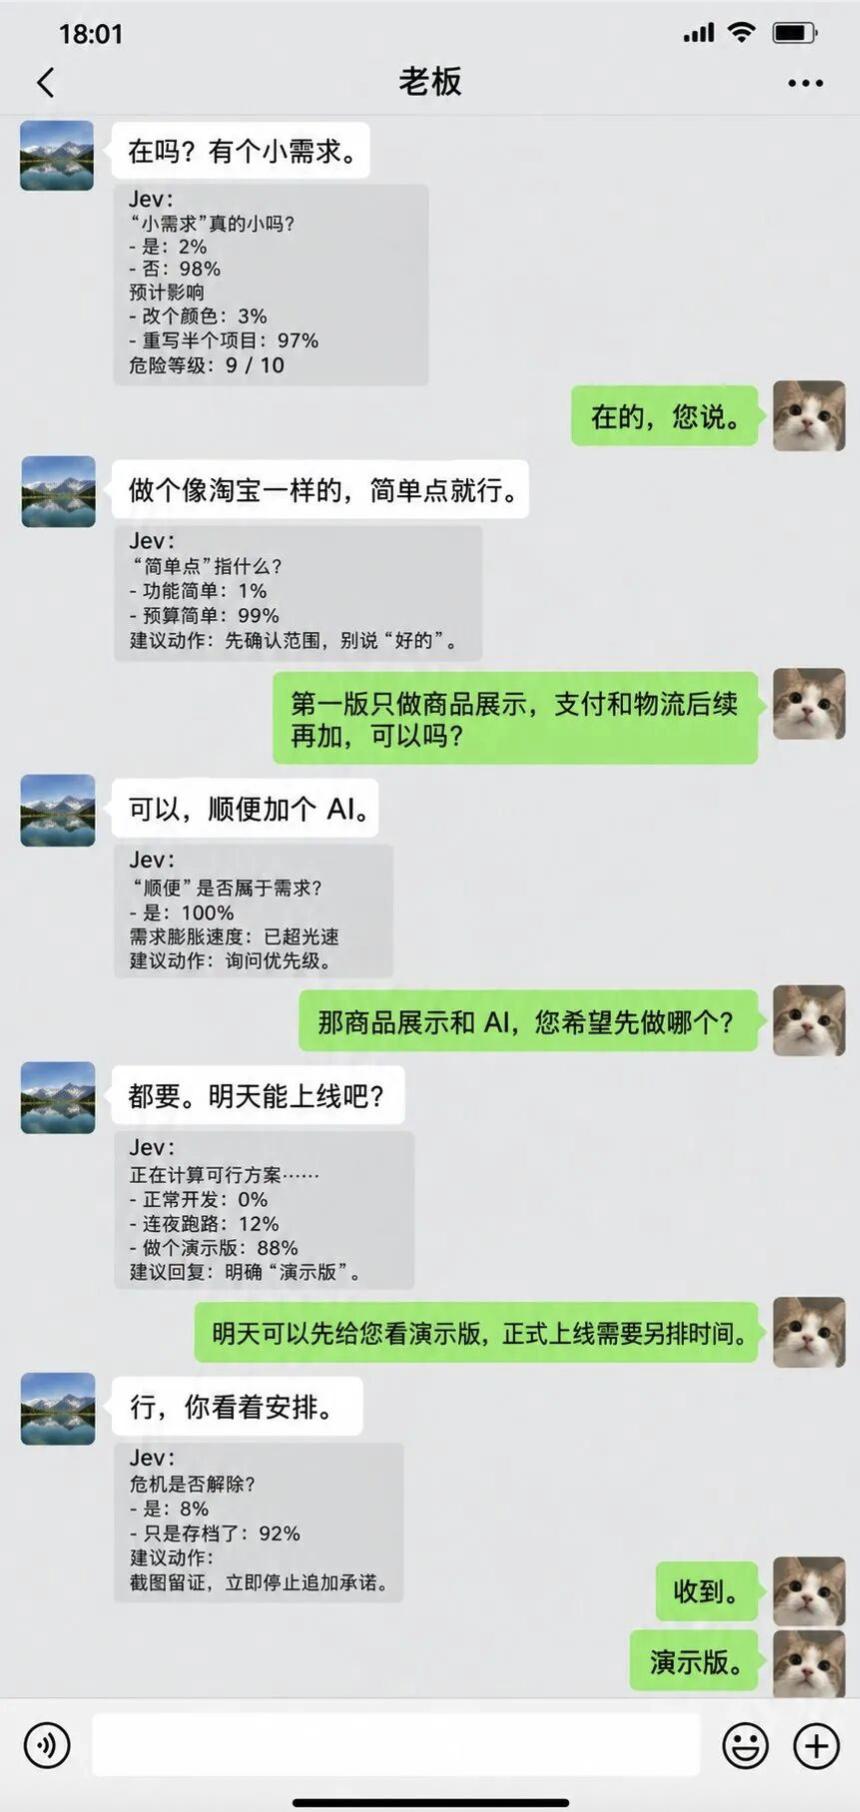
Auch wenn ich am Ende keinen elektronischen Chef erhalten habe, habe ich einen Fragebogen erstellt, nach dem selbst der Chef antworten muss. Was noch fehlt, um das Ziel vollständig zu erreichen, ist ungefähr nur die Eingabe aller „Das geht nicht“-Entscheidungen des Vorgesetzten aus den vergangenen Jahren – und die Bewältigung des daraus resultierenden psychischen Schadens.
Dieser Artikel stammt aus dem WeChat-Offiziellen Konto „APPSO“, Autor: APPSO, das Produkte von morgen entdeckt, und wird von 36Kr mit Genehmigung veröffentlicht.