Gerade hat Elon Musk seine "Prüfungsarbeit" Grok 4.7 eingereicht, aber diesmal hat er es mit seinen Prahlereien viel zu weit getrieben.
In der KI-Branche gibt es keine Feiertage.
Von OpenAI und Anthropic bis hin zu xAI scheinen alle Großkonzerne sich abgesprochen zu haben, um überstürzt neue Produkte zu veröffentlichen und sich die Marktpositionen zu sichern. Bevor die Feiertage offiziell beginnen, ist die Atmosphäre des Wettbewerbs um die Grundmodelle bereits voll entfacht.
Gerade eben hat SpaceXAI offiziell Grok 4.7 veröffentlicht.
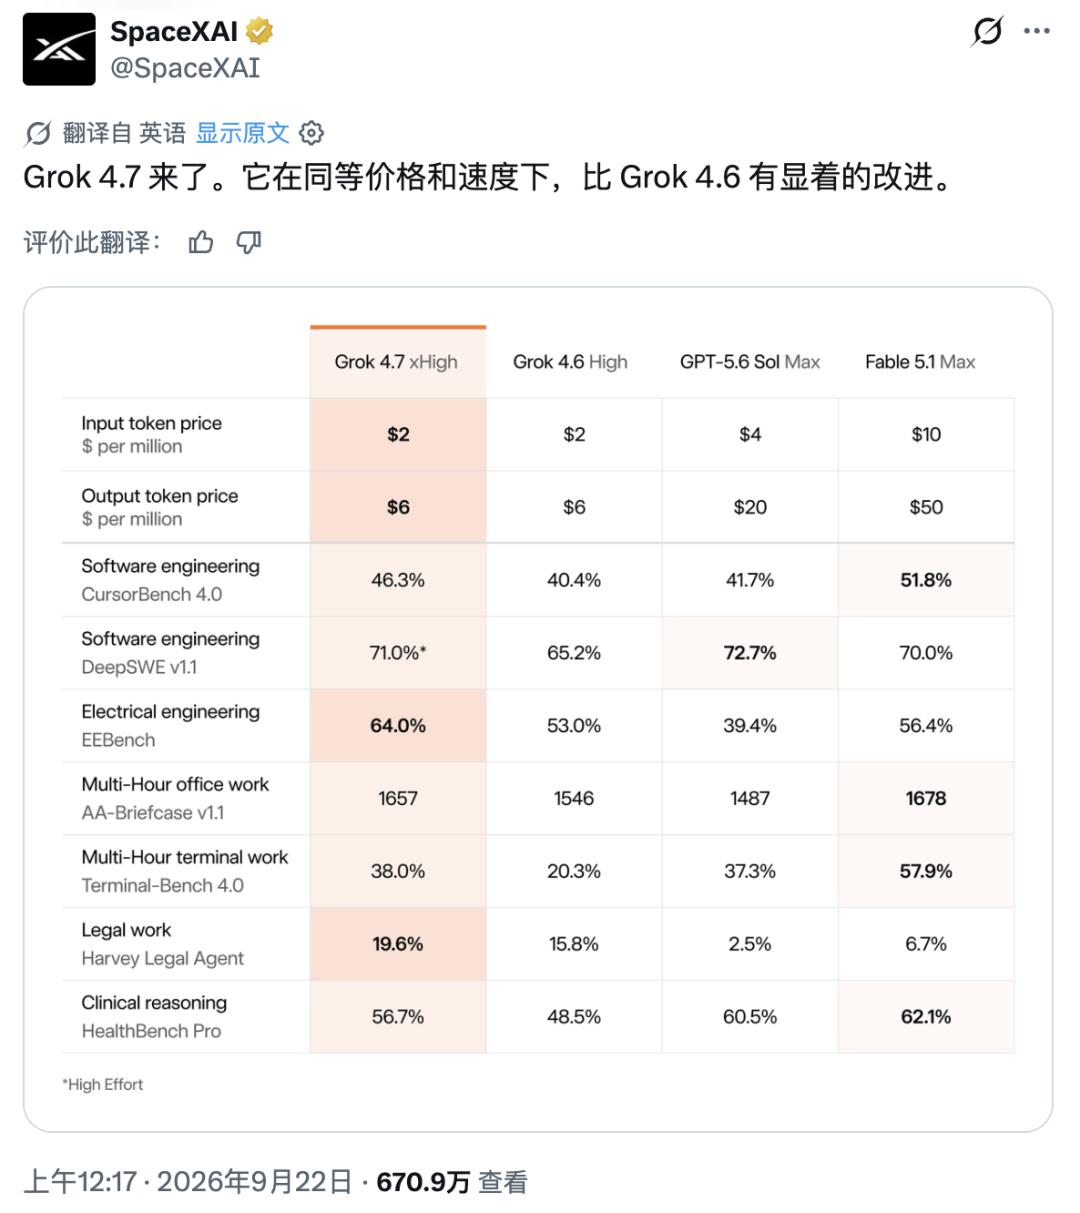
Offizieller Blog🔗https://x.ai/news/grok-4-7
Der Hersteller positioniert es als das derzeit leistungsstärkste Modell für Programmierung und Wissensarbeit. Das neue Modell ist bereits in Cursor, Grok Build und der Grok API integriert und wird zudem über Drittanbieter-Programmiertools, Modell-Routing-Plattformen und Cloud-Dienste bereitgestellt.
Die Veröffentlichung von Grok 4.7 erfolgte deutlich später als von Elon Musk ursprünglich angekündigt. Ende Juli begann die erste Ankündigungsphase, dann wurde die Frist auf „noch einige Wochen“ verschoben, anschließend auf „innerhalb von zehn Tagen“ verkürzt, bis zuletzt die Aussage folgte, „das Modell muss noch einmal nachjustiert werden“…
Nach wiederholten Verschiebungen ist der Schwerpunkt der Veröffentlichung von Grok 4.7 daher sehr klar definiert. SpaceXAI widmet den Hauptteil nicht der Chat-Erfahrung oder der Multimodal-Präsentation, sondern betont ausdrücklich die langfristige Ausführung von Aufgaben, die Selbstprüfung, die fachliche Wissensarbeit sowie ein wettbewerbsfähigeres Preis-Leistungs-Verhältnis.
Grok 4.7: Lange Aufgaben im Fokus
Laut offizieller Angabe nutzt Grok 4.7 ein neues, größeres Grundmodell als Grok 4.6, hat eine längere Phase des verstärkenden Lernens durchlaufen und wurde mit schwierigeren Aufgaben trainiert, von denen ein erheblicher Teil mehrere Stunden zur Ausführung benötigt.
Gleichzeitig hat das Modell die Fähigkeit zur Verwaltung langer Kontexte und zur Überprüfung von Ergebnissen verbessert und wurde nativ für die Ausführungsumgebung von Grok Bot trainiert, um die Leistung bei Dialogaufgaben und allgemeiner Wissensarbeit zu steigern.
Mehrere von dem Hersteller veröffentlichte Leistungswerte zeigen, dass Grok 4.7 im Vergleich zur Vorgängergeneration deutliche Fortschritte aufweist.
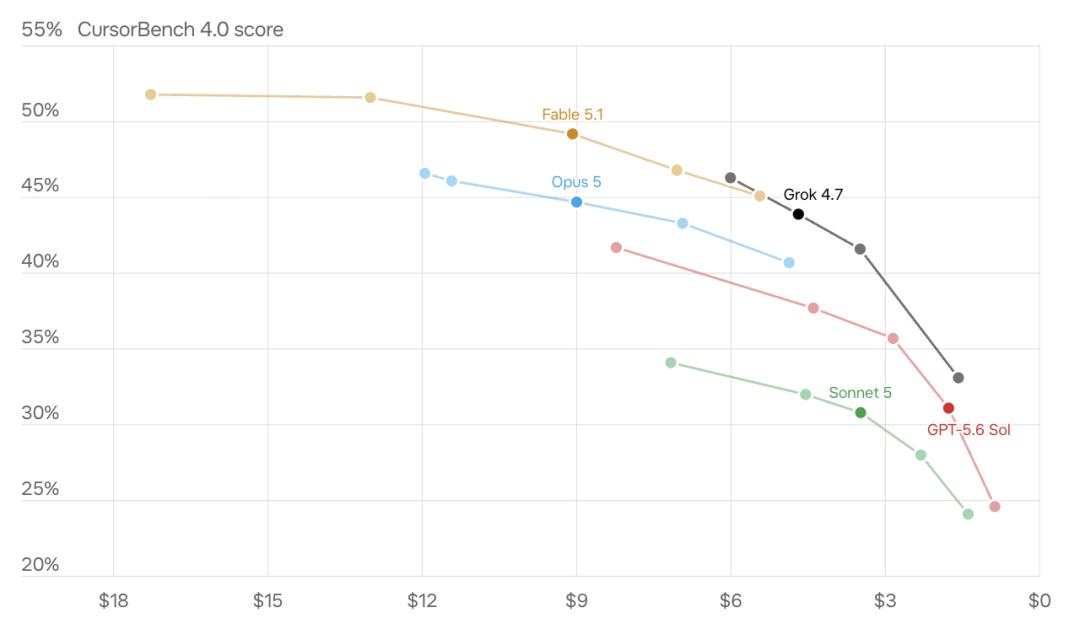
Bei CursorBench 4.0 erreicht Grok 4.7 xHigh einen Wert von 46,3 % und liegt damit über dem Wert von 40,4 % von Grok 4.6 High; der Wert bei DeepSWE v1.1 stieg von 65,2 % auf 71,0 %;
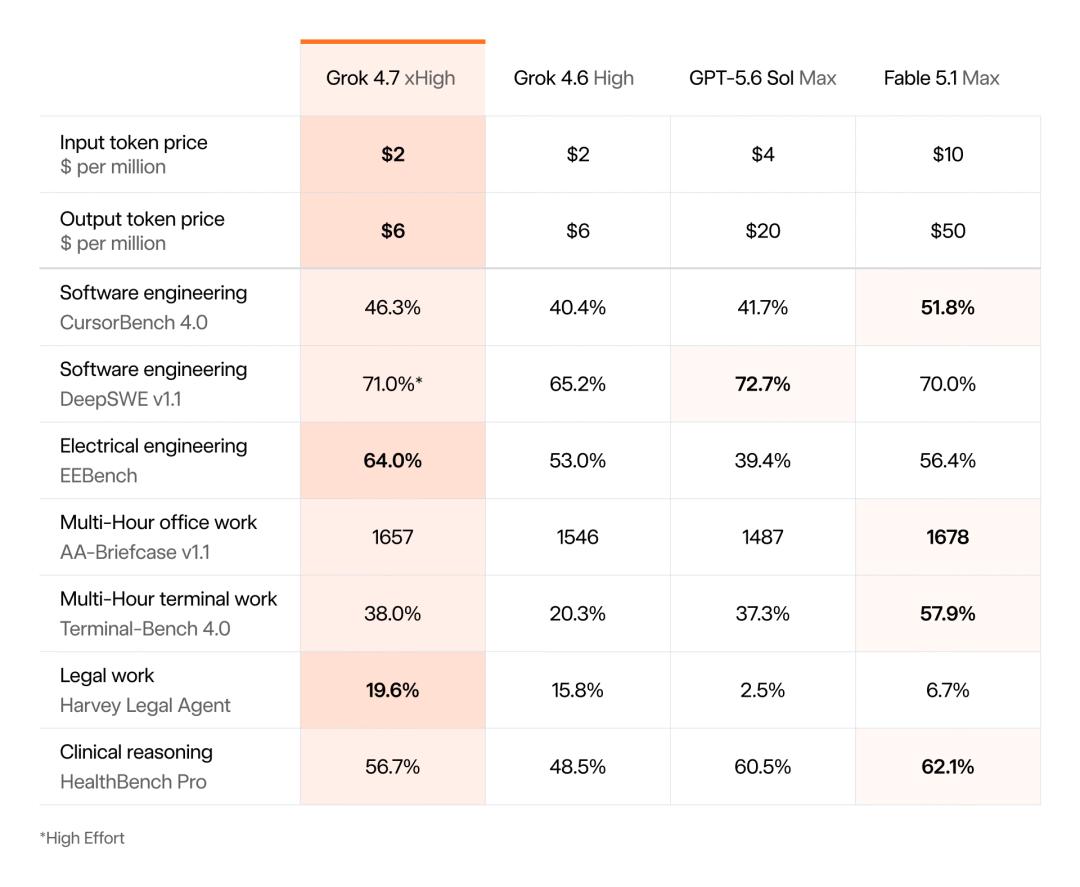
Bei Terminal Bench 4.0 stieg der Wert von 20,3 % auf 38,0 %. Das Ergebnis des Elektrotechnik-Benchmarks EEBench verbesserte sich von 53,0 % auf 64,0 %, und der Wert von AA Briefcase v1.1 für langfristige Büroaufgaben stieg von 1546 auf 1657 Punkte.
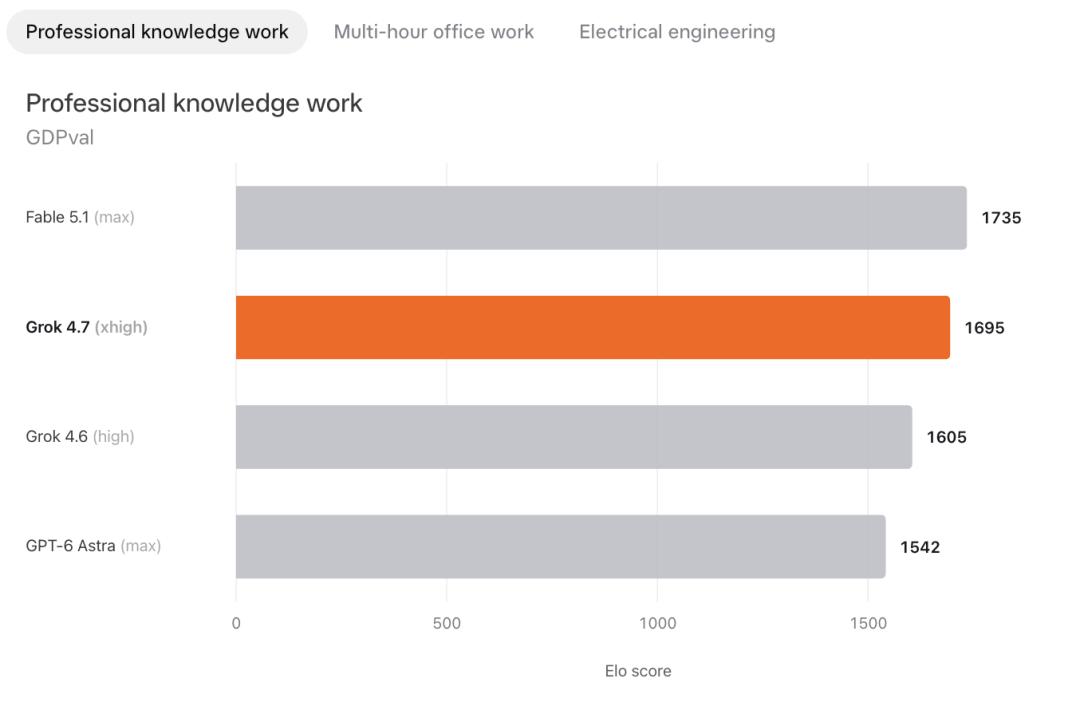
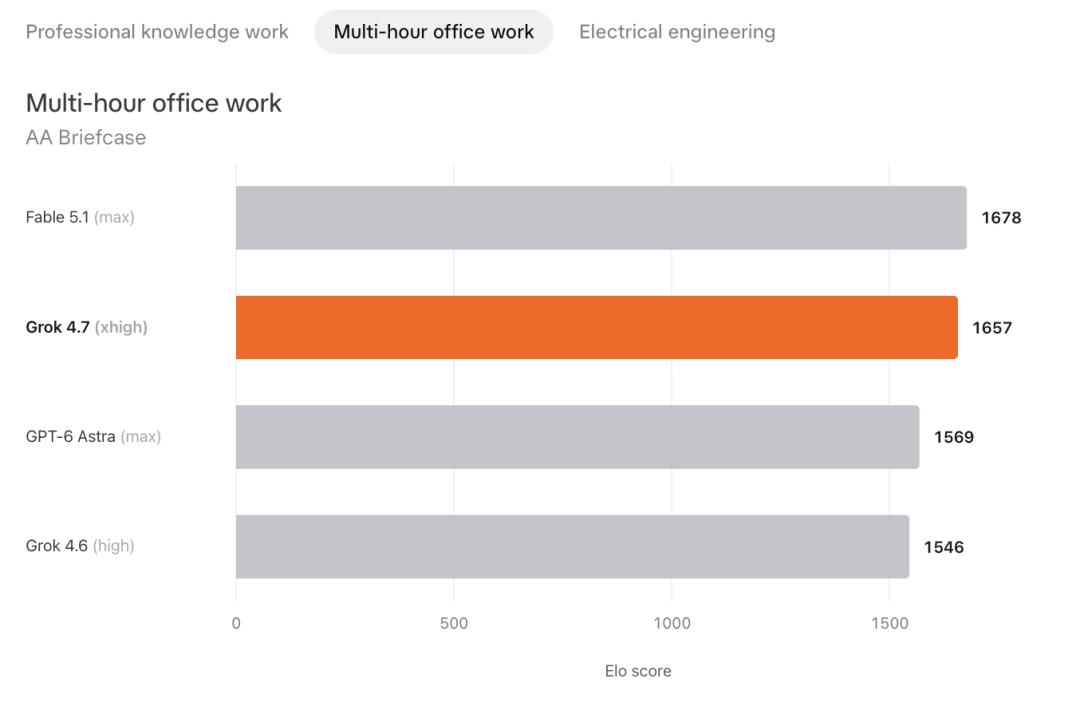
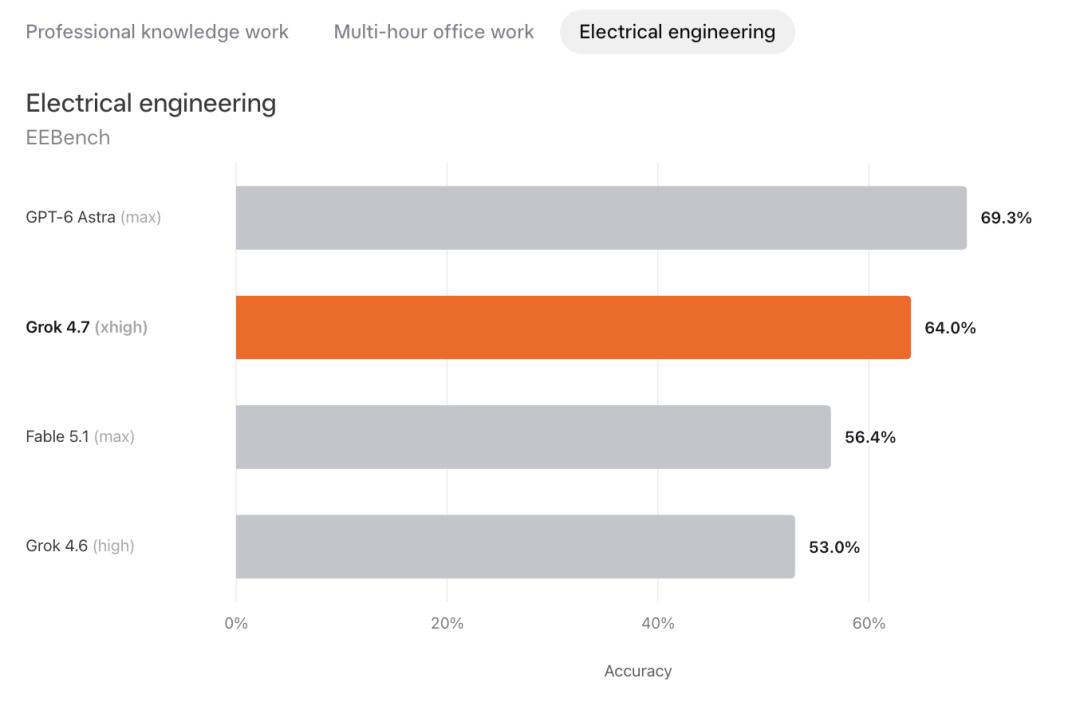
Im Quer Vergleich liegen die Vorteile von Grok 4.7 hauptsächlich im Preis und bei einigen spezialisierten Aufgaben, die Gesamtleistung liegt noch nicht in allen Bereichen an der Spitze.
Bei CursorBench 4.0 und Terminal Bench 4.0 liegt der Wert unter dem von Fable 5.1 Max; bei DeepSWE v1.1 liegt er geringfügig unter dem von GPT 5.6 Sol Max;
Aber im Harvey Legal Agent Benchmark erreicht es einen Wert von 19,6 % und liegt damit deutlich über mehreren Vergleichsmodellen in der offiziellen Tabelle.
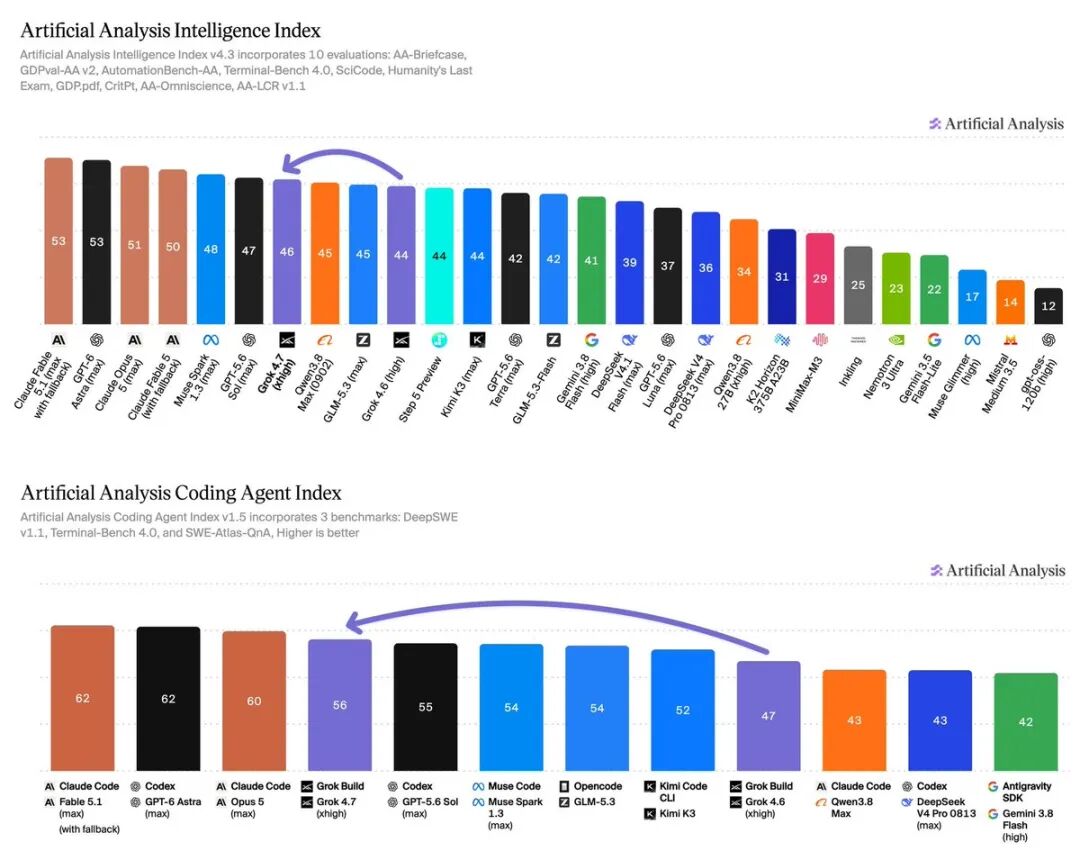
Anschließend veröffentlichte Artificial Analysis einen Intelligence-Index-Wert von 46 Punkten und stellte fest, dass Grok 4.7 SpaceXAI zu einem der vier weltweit führenden KI-Labore macht, und seine Leistung im Coding Agent Index übertrifft die von GPT 5.6 Sol.
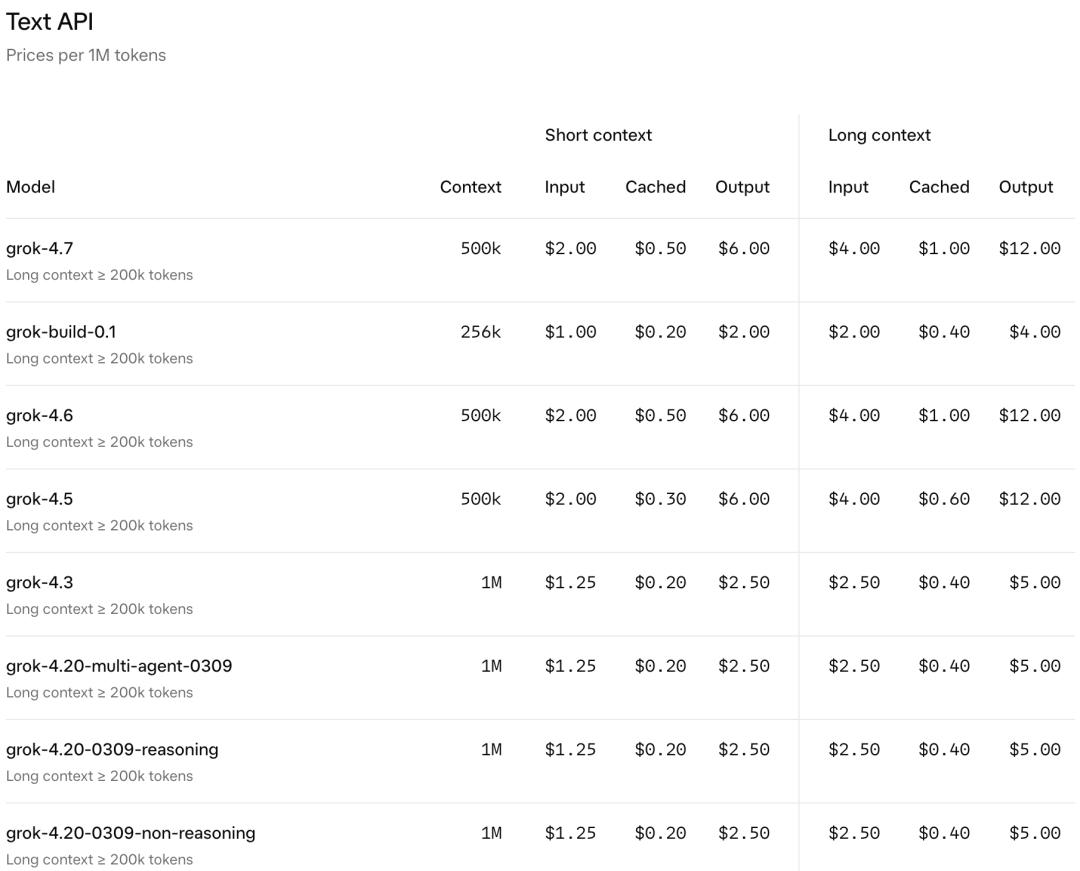
Der Preis wird zum direktesten Wettbewerbsvorteil von Grok 4.7. Die Preisgestaltung seiner API ist identisch mit der von Grok 4.6: 2 US-Dollar pro Million Eingabe-Token und 6 US-Dollar pro Million Ausgabe-Token.
https://docs.x.ai/developers/pricing
SpaceXAI bietet zudem eine Schnellversion mit doppelter Ausgabegeschwindigkeit an, deren Preis entsprechend verdoppelt ist.
Mit den Worten von Elon Musk ist Grok 4.7 ein leistungsstarkes Produkt, das Intelligenz, Geschwindigkeit und niedrige Kosten vereint. Die offizielle Erklärung von SpaceXAI lautet direkt, dass es die doppelte Geschwindigkeit vergleichbarer Modelle bei halbem Preis erreicht.
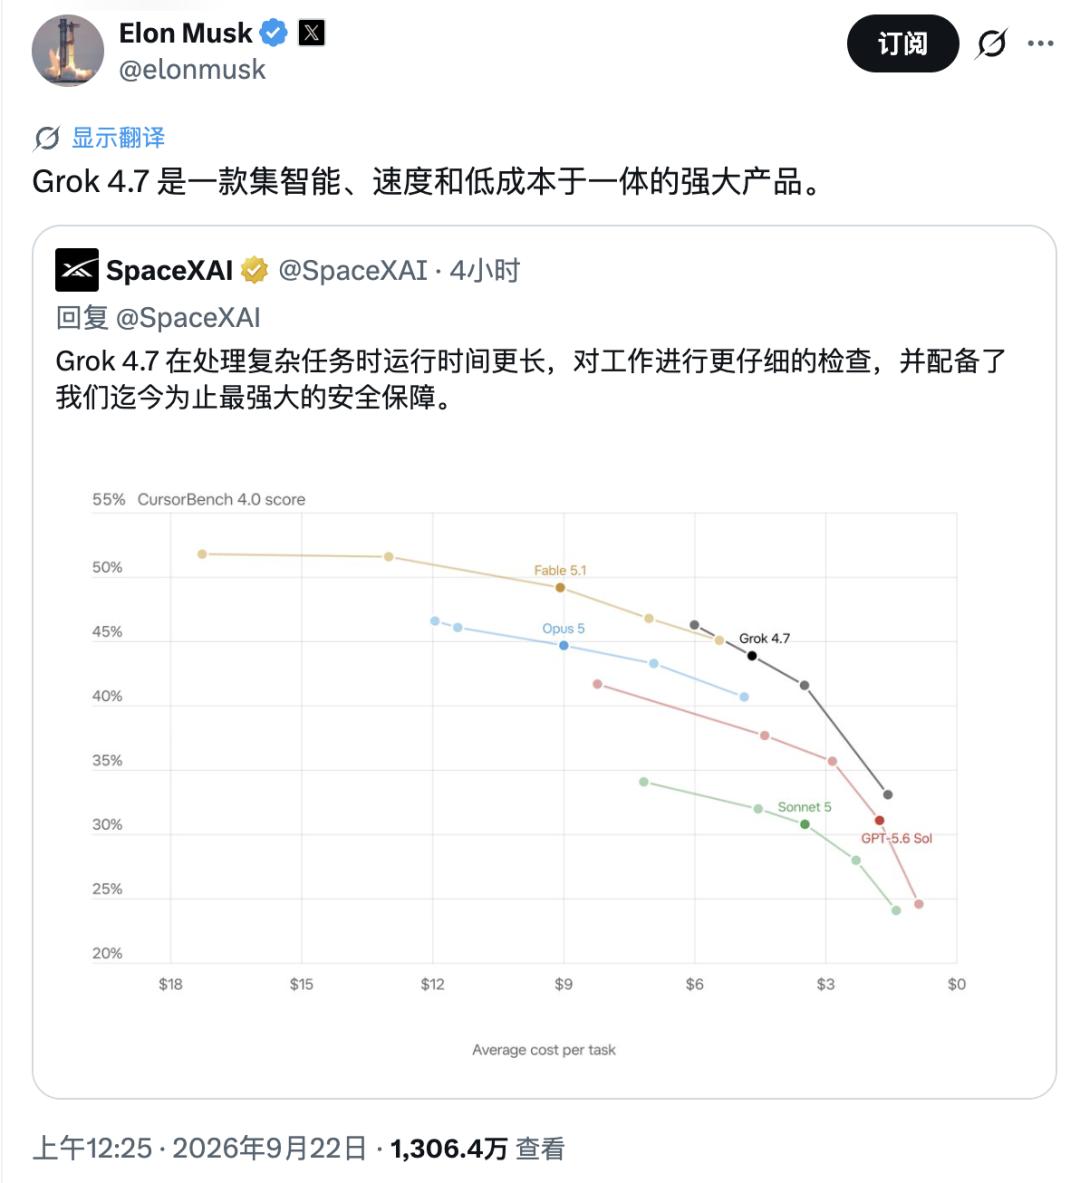
Neben der Programmierung beginnt SpaceXAI, sich den Bereich der fachlichen Berufsarbeit zu erschließen.
Der Hersteller betont ausdrücklich die Fähigkeiten bei Dokumenten und Präsentationen und verweist auf Bewertungen wie GDPval und AA Briefcase, um zu belegen, dass das Modell Teile der Arbeit von Fachkräften wie Anwälten, Pflegekräften und Finanzanalytikern übernehmen kann.
p>Im Hinblick auf die Produktausrichtung zielt Grok 4.7 auf langwierige Aufgaben ab, bei denen große Mengen an Material gelesen, wiederholt Tools aufgerufen und Ergebnisse mehrfach überprüft werden müssen.Ein von Box vorgestelltes Beispiel für eine Versicherungsentschädigung verdeutlicht diese Ausrichtung besonders gut.
In Box Agent prüft Grok 4.7 eine Entschädigungsforderung im Wert von 2 Millionen US-Dollar, die dazugehörige Versicherungspolice und relevante Aufzeichnungen, entdeckt doppelte Rechnungen in Höhe von 82.000 US-Dollar und übersehene Lieferantenrabatte von 64.000 US-Dollar und identifiziert zudem ein Problem mit der Selbstbeteiligung, das die Berechnungsergebnisse um 143.000 US-Dollar abweichen lassen könnte.
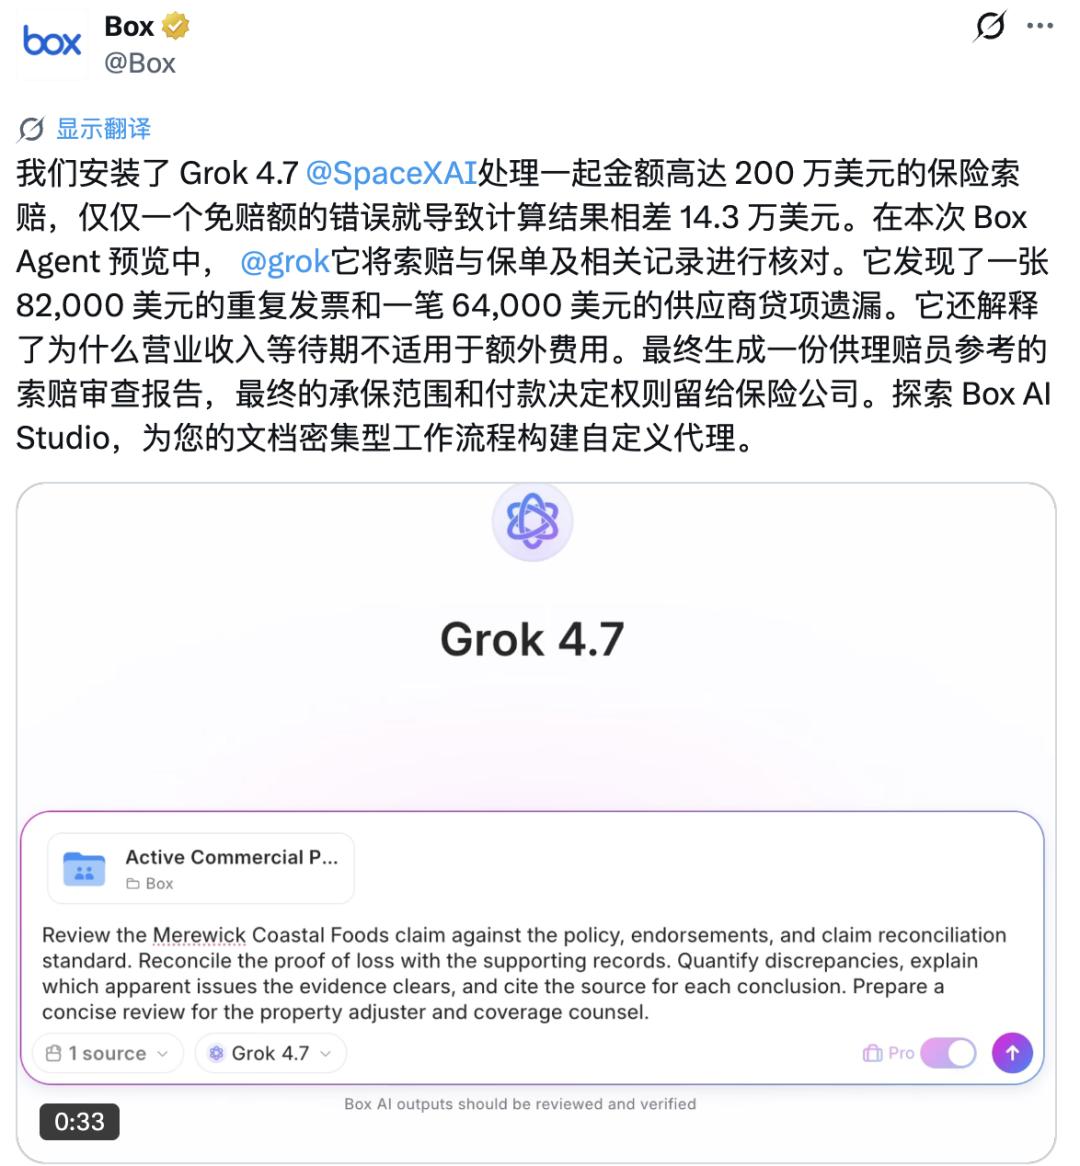
Das System erstellt abschließend einen Prüfbericht mit Quellenangaben, während die Entscheidung über den Versicherungsschutz und die Zahlung weiterhin von den Schadenregulierern getroffen wird.
Die Sicherheitsfähigkeit wurde ebenfalls als wichtiger Bestandteil dieses Upgrades eingestuft.
SpaceXAI gibt an, dass Grok 4.7 ein neues Sicherheitsschutzsystem nutzt und einen Wert von 62,4 % im LatchBio-Biosicherheits-Benchmark erreicht; bei HackerBench v0.3 für risikoreiche Cybersicherheitsaufgaben werden nur 3,3 % der gefährlichen, doppelt nutzbaren Hinweise akzeptiert, während Fehlablehnungen bei normalen Sicherheitsforschungen so weit wie möglich reduziert werden.
Einige Cybersicherheitspartner erhalten zudem zugangsbeschränkte Red-Team-Funktionalitäten für Verteidigungsforschungen.
Nutzer sind begeistert, aber die Bewertungen sind gespalten…
Die ersten Tests nach der Veröffentlichung von Grok 4.7 konzentrierten sich hauptsächlich auf Webseiten, 3D-Szenen und visuelles Programmieren, die Bewertungen sind jedoch extrem polarisiert.
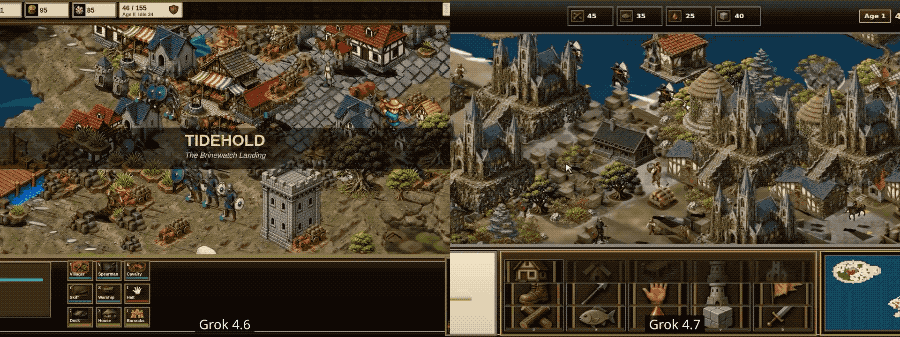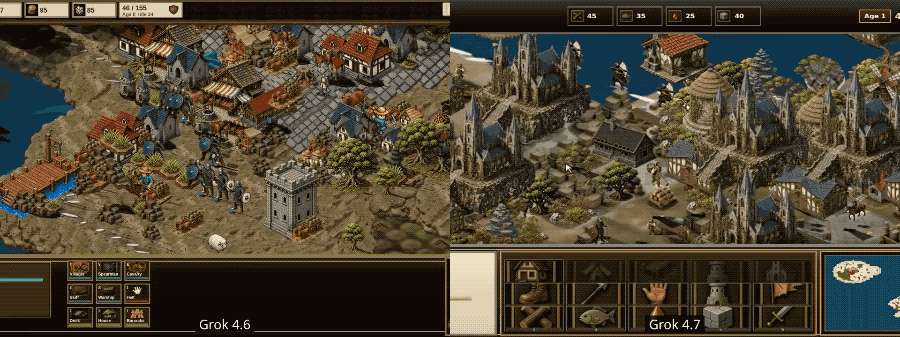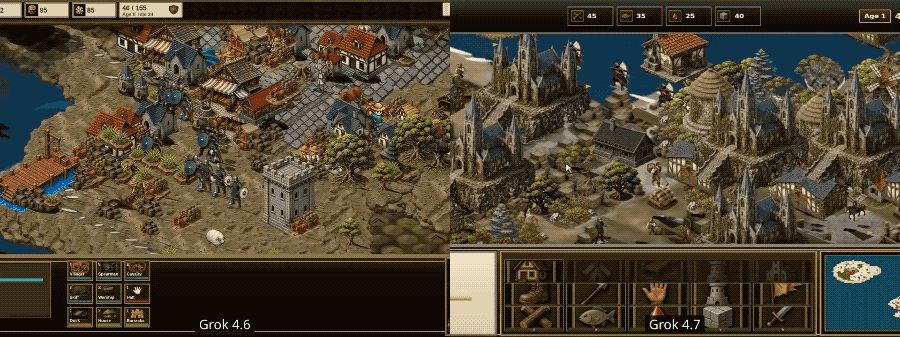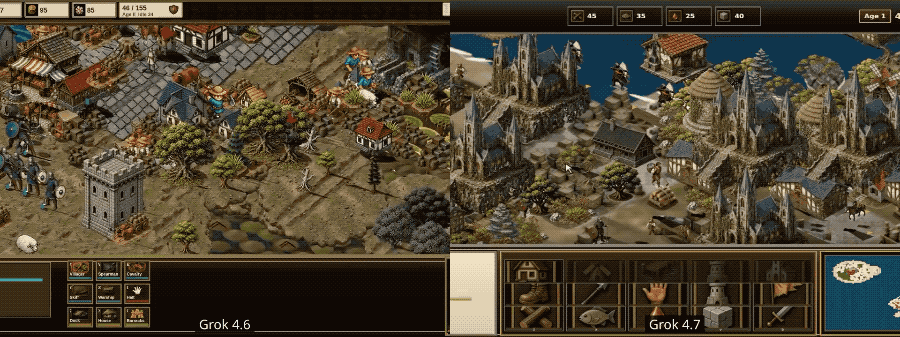
Eric Zakariasson zeigte einen Vergleich zwischen Grok 4.6 und 4.7 bei der Erstellung eines Demonstrationsprojekts für „Age of Empires II“.
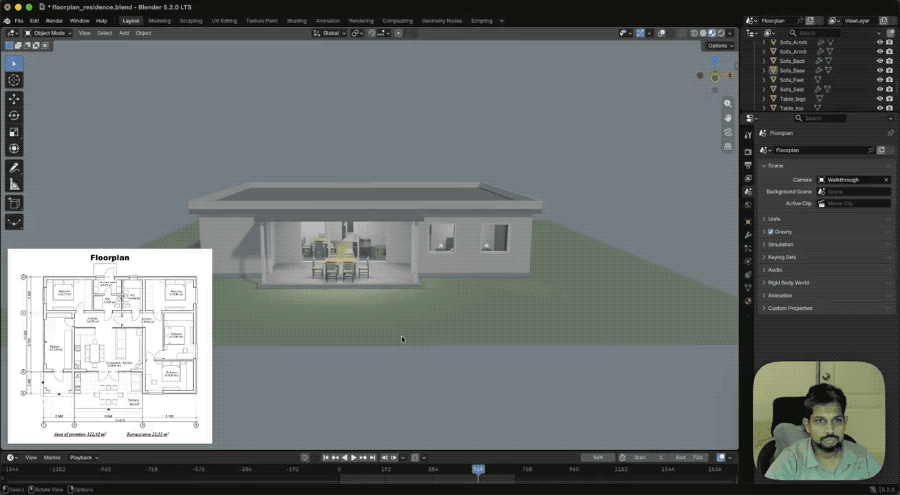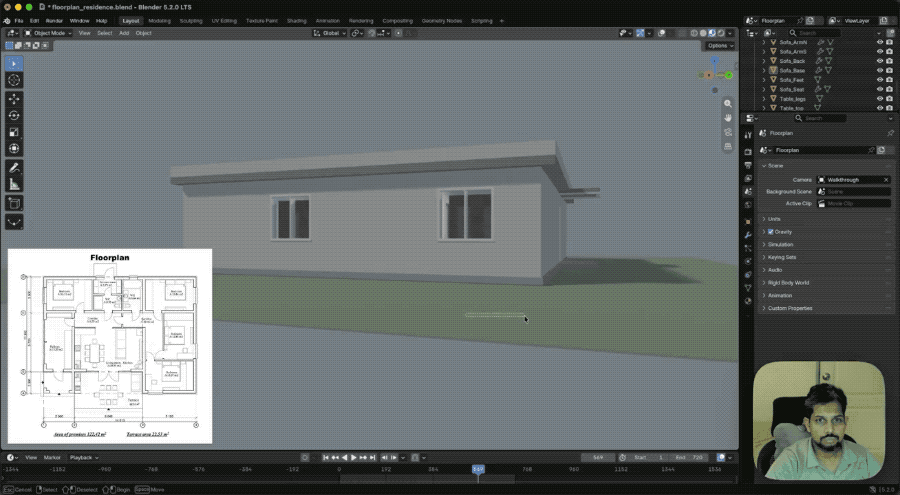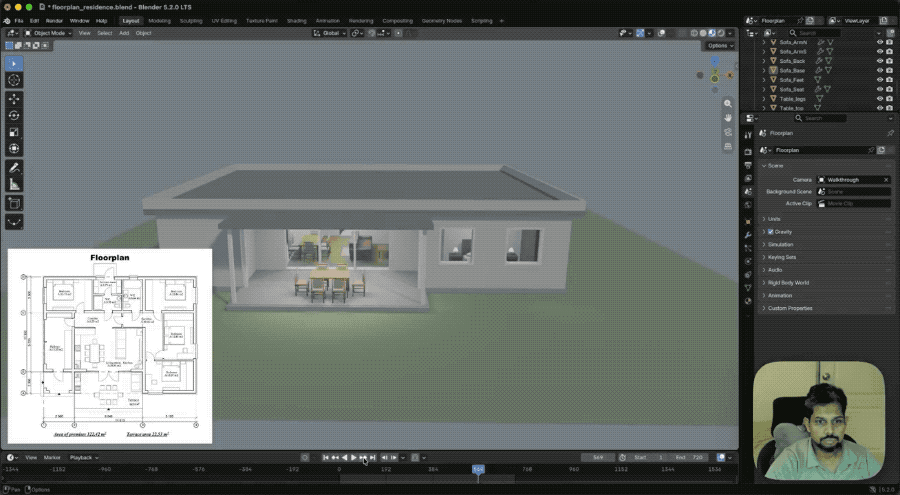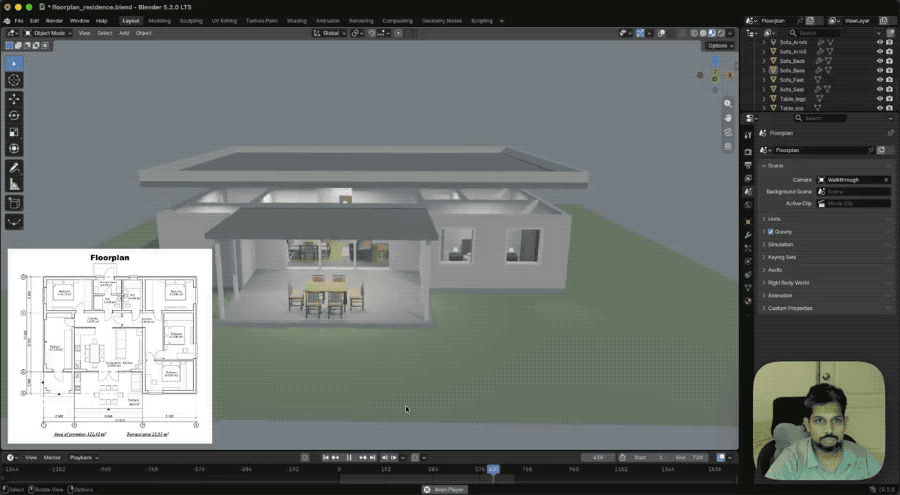
Ashutosh Shrivastava ließ das Modell hingegen eine Blender-Struktur anhand eines Grundrisses erstellen und diese anschließend als interaktive Three.js-Webseite exportieren. Alle genannten Tests zeigen seine Fähigkeit zur Verarbeitung mehrstufiger visueller Aufgaben.
In einem weiteren Test ließ der Entwickler Diego Cabezas Grok 4.7 xHigh den Verkehrsampelverkehr auf einer Einbahnstraße und zufällig einfahrende Fahrzeuge mit Python simulieren und stellte fest, dass die Detailfülle die höchste war, die er bei vergleichbaren Tests je gesehen hatte.
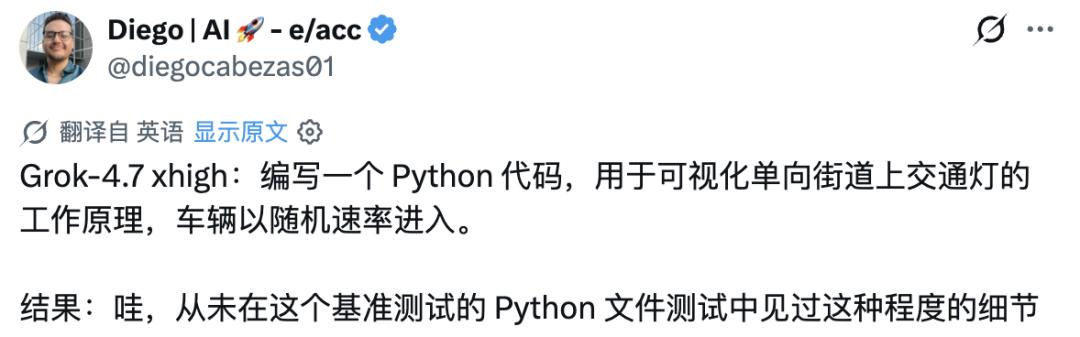
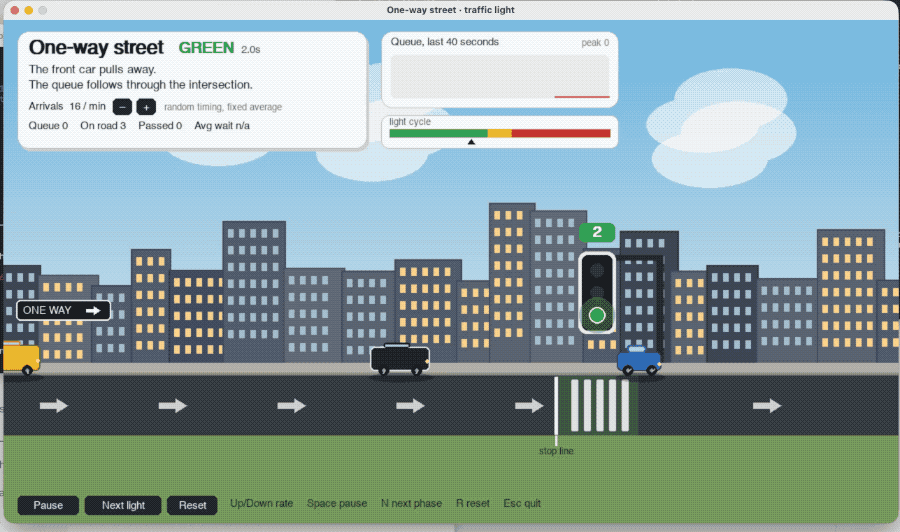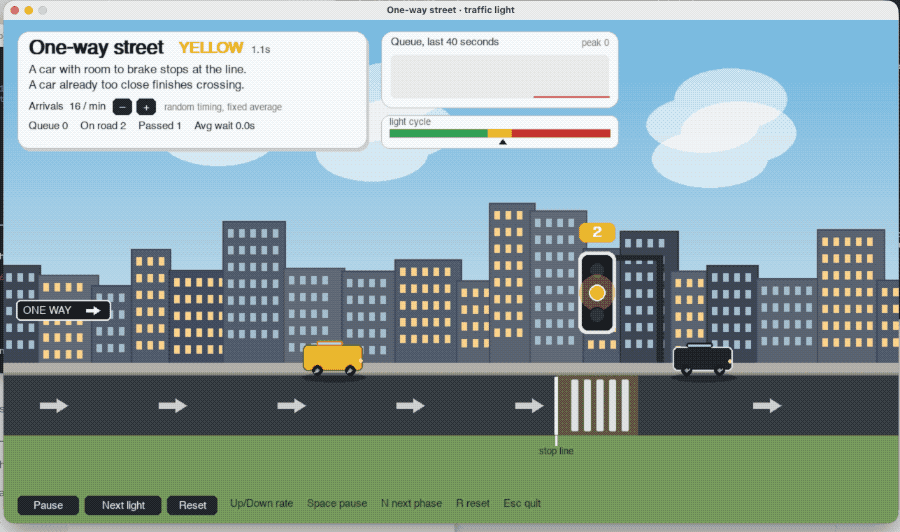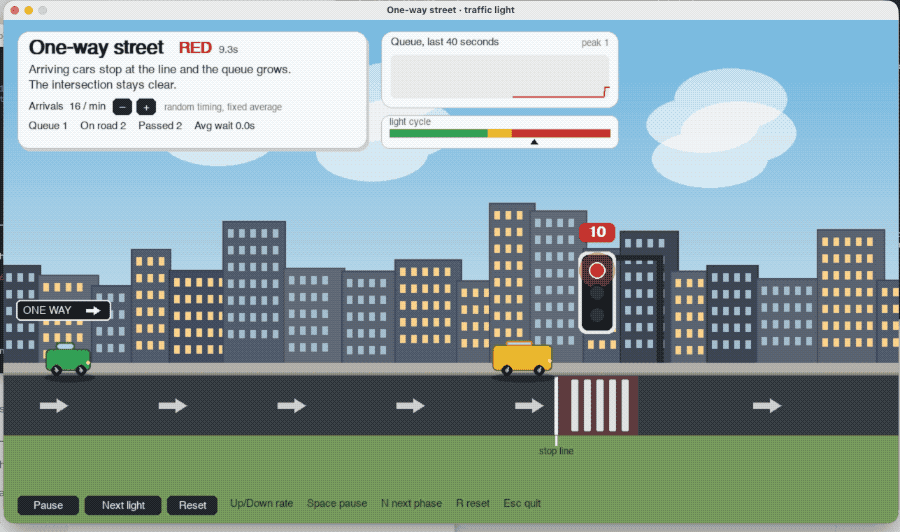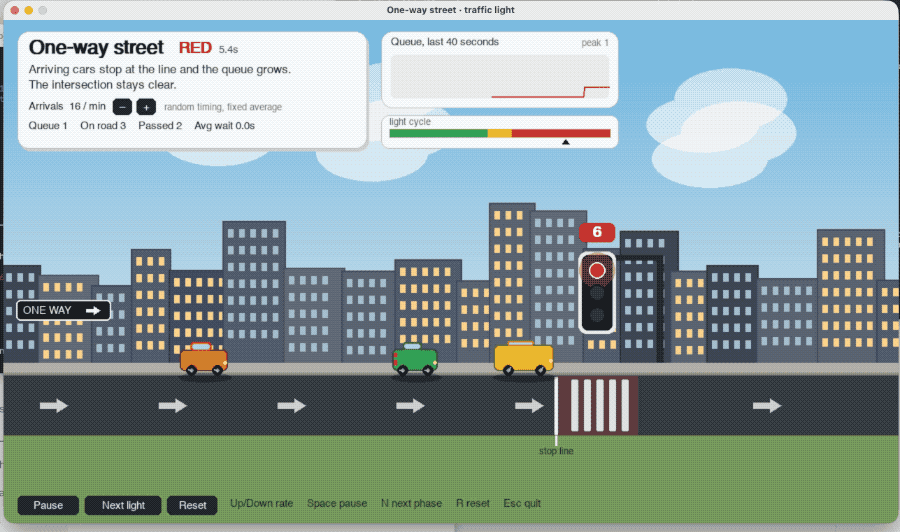
AI/ML API verglich Grok 4.7 und Claude Opus 5 anhand von vier unabhängigen Three.js-Weltraumszenen und stellte fest, dass die Ausführung der Tests bei dem ersteren etwa 0,20 US-Dollar kostete, bei dem letzteren etwa 2,05 US-Dollar, und Grok in drei der vier Szenen eine kürzere Ausführungszeit benötigte.
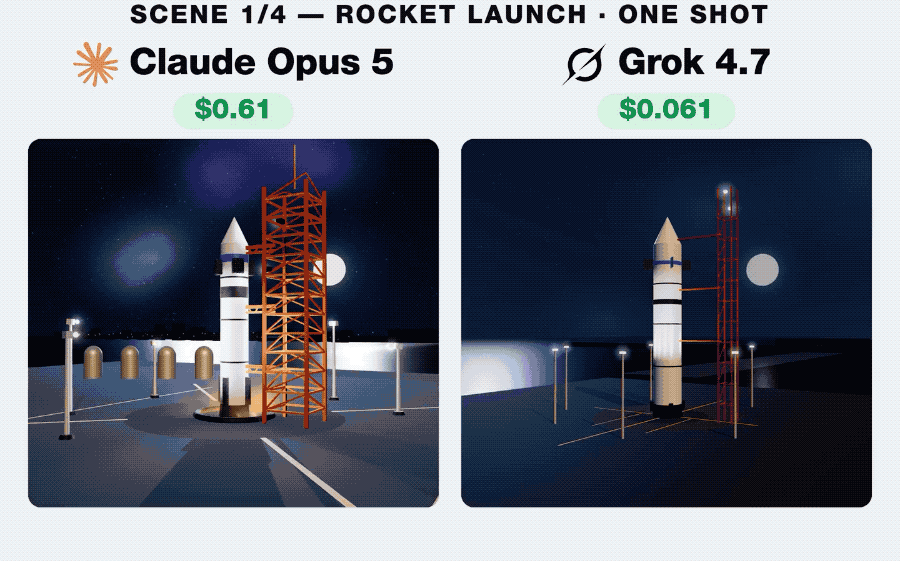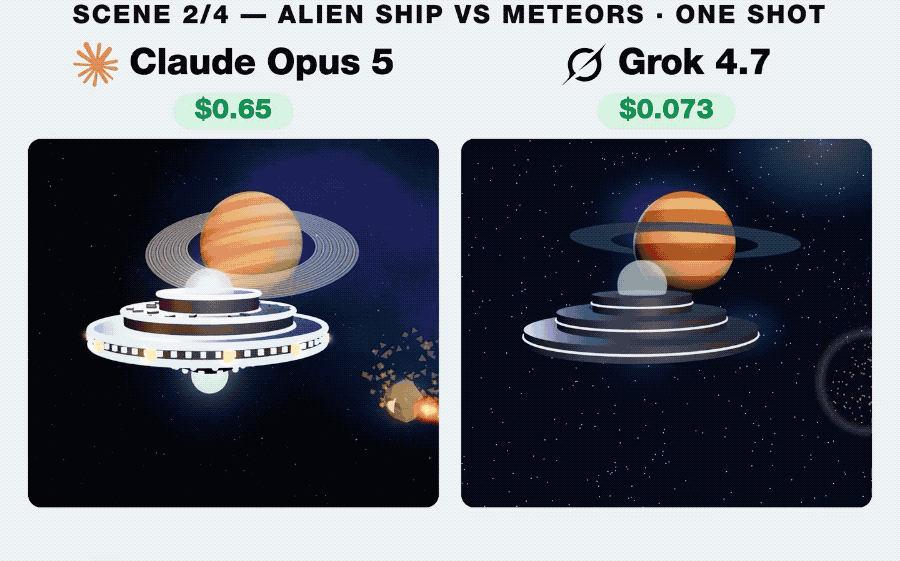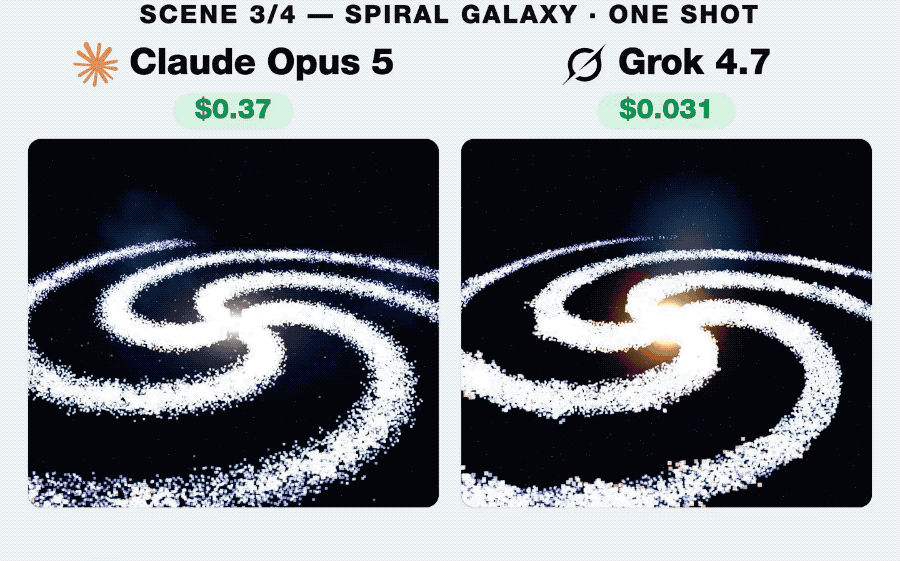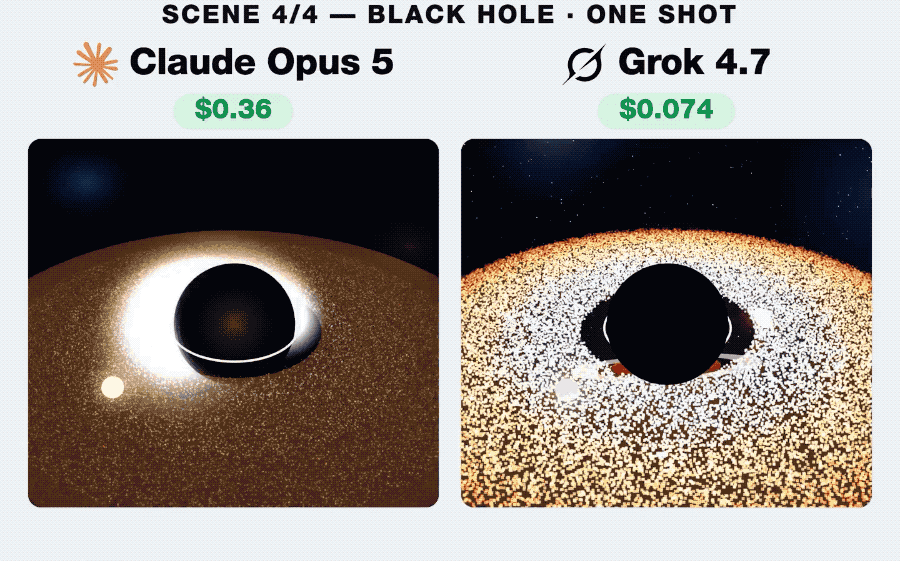
Der Entwickler Bhavy ist hingegen der Meinung, dass