Anthropic und ByteDance steigen in das Geschäftsfeld der KI-gestützten Arzneimittelentwicklung ein: Das »nächste Coding« steckt in datenbezogenen Engpässen fest.
Laut Informationen von Reuters vom 18. September betreibt Anthropic bereits ein nasses Labor in der San Francisco Bay Area. Dieses Labor ist nicht speziell für die Wirkstoffforschung vorgesehen, sondern dient dazu, Claude mit Zellen, Reagenzien und experimentellen Geräten vertraut zu machen und die Fähigkeit des Modells zu testen, Roboter zur Durchführung biologischer Experimente zu steuern. Im Allgemeinen bezieht sich das „trockene Experiment“ auf die Konstruktion und das Screening von Kandidatenmolekülen mithilfe von Modellen, während das „nasse Experiment“ diese Ergebnisse in einem echten Labor synthetisiert, testet und validiert.
Vor zwei Tagen gaben Anthropic und Novo Nordisk ihre Zusammenarbeit bekannt. Laut der Mitteilung beider Seiten wird Claude Science für die Wirkstoffforschung und die Entwicklung von F&E-Software eingesetzt. Zuvor arbeitete Anthropic auch mit Bristol-Myers Squibb zusammen, um Claude in die Bereiche Forschung, klinische Entwicklung, Produktion und Geschäftsabwicklung einzubinden. Im April dieses Jahres erwarb Anthropic das Biotechnologieunternehmen für künstliche Intelligenz Coefficient Bio für rund 400 Millionen US-Dollar.
In derselben Woche schloss Anew Labs, ein aus ByteDance ausgegliedertes neues Unternehmen, eine Erstfinanzierungsrunde in Höhe von 290 Millionen US-Dollar ab, mit einer Bewertung von rund 1,5 Milliarden US-Dollar nach der Investition. ByteDance behält weiterhin 56 % der Anteile, während das Team, die Algorithmusplattform und die in der Entwicklung befindlichen Pipelines in das neue Unternehmen eingebracht wurden.
Diese Maßnahmen setzen den Weg fort, den die KI-gestützte Pharmaindustrie in den letzten Jahren eingeschlagen hat, und bringen neue Akteure mit sich. Früher entwickelten KI-Pharmounternehmen vertikale Modelle und arbeiteten dann mit Pharmaunternehmen oder CRO zusammen, um Experimente durchzuführen. Heute beginnen Unternehmen für große Modelle, eigene Labore aufzubauen und zu versuchen, die Rückkopplung zwischen Modellen und Experimenten direkt zu beherrschen.
Die Effizienzsteigerung bei der Entwicklung neuer Arzneimittel konzentriert sich noch immer auf die frühe Phase
Die traditionelle Arzneimittelentwicklung wird oft als „Zwei-Zehn-Gesetz“ zusammengefasst: Ein neues Arzneimittel braucht von der Entdeckung bis zur Markteinführung in der Regel mehr als zehn Jahre, kostet rund 1 Milliarde US-Dollar (in einigen Statistiken sogar über 2 Milliarden US-Dollar) und hat eine endgültige Erfolgsquote von etwa 10 %.
In seinem Forschungsbericht zur KI-Pharmaindustrie vom September 2026 hat Citi die Phase der frühen Entdeckung weiter aufgeschlüsselt. Um ein präklinisches Kandidatenmittel mit traditionellen Methoden zu finden, müssen in der Regel etwa 5000 Moleküle synthetisiert und getestet werden, was 4 bis 6 Jahre dauert. Der KI-Ansatz kann den Testumfang auf etwa 330 Moleküle reduzieren und die Zeit auf rund 17 Monate senken.
Allerdings decken diese Zahlen nur den Prozess von der Konstruktion bis zum präklinischen Kandidatenmittel ab. Nach Berechnungen von Citi beträgt der vollständige Entwicklungszyklus eines First-in-Class-Arzneimittels etwa 13 Jahre, und KI kann ihn voraussichtlich auf 8 Jahre verkürzen, während die klinischen Phasen I bis III immer noch 5 bis 7 Jahre dauern.
Mit anderen Worten: KI komprimiert zuerst die Such- und Experimentieriterationszeit, und klinische Studien werden nicht im gleichen Maße verkürzt.
Insilico Medicine liefert ebenfalls ein Beispiel. Wie von der Orient Securities unter Berufung auf Unternehmensangaben berichtet, dauerte es für ein Kandidatenmedikament von Insilico Medicine (3696.HK) gegen idiopathische Lungenfibrose 18 Monate von der Zielidentifizierung bis zum Eintritt in die klinische Phase, wobei die Kosten in der Entdeckungsphase etwa 2,6 Millionen US-Dollar betrugen. Zum Vergleich: Der traditionelle Weg dauert im Durchschnitt etwa 4,5 Jahre und kostet in der Regel mehrere zehn Millionen bis zu hundert Millionen US-Dollar.
Bei der Trefferquote muss ebenfalls zwischen verschiedenen Messgrößen unterschieden werden. Ein im August dieses Jahres von Anthropic veröffentlichtes Experiment zur Proteinkonstruktion zeigte, dass Claude 1320 Konstruktionen für 15 Zielstrukturen erzeugte, von denen 354 die Bindungsexperimente bestanden – die Gesamttrefferquote lag bei etwa 26,8 %, und bei 14 Zielstrukturen wurden experimentelle Treffer erzielt. Es ist zu beachten, dass diese Zahl misst, ob die erzeugten Proteine an die Zielstrukturen binden können, nicht die Wahrscheinlichkeit, dass ein Kandidatenarzneimittel in die klinische Phase eintritt oder schließlich auf den Markt kommt.
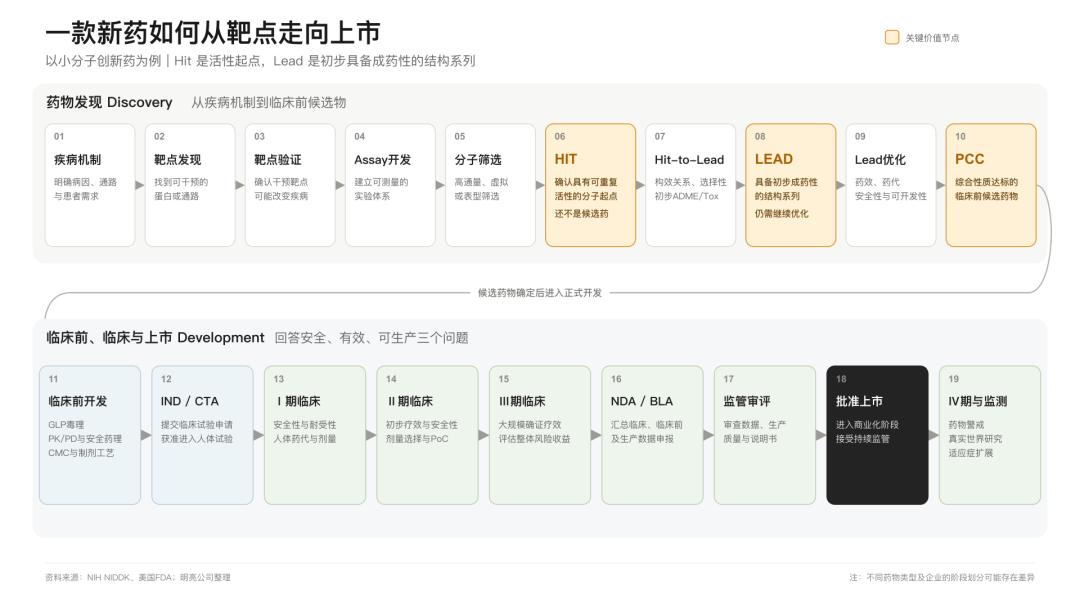
Eine Branchenstatistik, die in einem Protokoll eines Expertenaustauschs (im Folgenden „Experte A“ genannt) zitiert wird, zeigt, dass die Erfolgsquoten in den Phasen von der Zielstruktur zum Treffer (Bindung von Verbindungen), vom Treffer zur Leitverbindung und zur Optimierung der Leitverbindung etwa 80 %, 75 % bzw. 85 % betragen. Nach dem Eintritt in die Phasen I, II und III liegen die Phasenerfolgsquoten bei etwa 54 %, 34 % bzw. 70 %, und die Gesamterfolgsquote des gesamten Prozesses beträgt etwa 11 % bis 14 %. Dabei ist die klinische Phase II nach wie vor der Hauptverlustbereich. Das bedeutet: Eine Erhöhung der Trefferquote in der frühen Phase führt nicht automatisch zu einer gleichzeitigen Erhöhung der klinischen Erfolgsquote.
Daher fasst Citi die aktuelle Beurteilung mit dem Satz „faster is proven, better is not“ zusammen – die betriebliche Effizienz ist bereits nachgewiesen, während die Qualität einzelner Kandidatenarzneimittel und die klinische Erfolgsquote noch unbestimmt sind. Aus dieser Perspektive ist das, was die KI-Pharmaindustrie erreichen kann, die hochfrequente Suche und Rückkopplungsschleife wie im Codierungsprozess, aber das „Testverfahren“ für Arzneimittel sind Zellen, Tiere und der menschliche Körper, sodass sich die Rückkopplungszyklen von Sekunden auf Wochen, Monate und Jahre erstrecken.
Unterschiede im Ansatz zwischen großen Modellen, KI-Pharmounternehmen und großen Pharmakonzernen
Der Ausgangspunkt von KI-Pharmounternehmen ist ein einzelnes Problem im Rahmen der Arzneimittelentwicklung. Zuerst befassen sie sich mit computergestütztem Wirkstoffdesign, Moleküldocking oder Strukturvorhersage und ergänzen dann tiefgreifendes Lernen und Generierungsmodelle. Nach einer Zusammenfassung von UBS und Experte A liegen die Kernkompetenzen dieser Unternehmen in der Regel in Domänenmodellen, pharmazeutischer Chemieerfahrung, geschlossenen Schleifen aus trockenen und nassen Experimenten sowie eigenen Pipelines. Das bedeutet, dass ihre Modelle auf eine bestimmte Zielstruktur oder eine bestimmte Art von Molekülen ausgerichtet sind und die Werkzeugkette ebenfalls um spezifische Aufgaben herum aufgebaut ist.
Unternehmen für große Modelle verfolgen dagegen eher die allgemeine Leistungsfähigkeit des Modells.
In einem weiteren Interviewprotokoll eines Wertpapierhauses fasst „Experte B“ diesen Ansatz als „einzelnes Basismodell plus vertikale Werkzeugkette“ zusammen. Große Modelle trainieren keine separaten kleinen Modelle für jede Phase neu, sondern sind dafür zuständig, Aufgaben zu zerlegen, Werkzeuge auszuwählen und Ergebnisse zu ordnen, bevor sie Werkzeuge für Strukturvorhersage, Moleküldesign und Datenbanken aufrufen. Claude Science integriert mehr als 60 wissenschaftliche Fähigkeiten und Konnektoren – genau diese Produktform eines „wissenschaftlichen Arbeitsplatzes“. Das ähnelt eher der Nutzung der Fähigkeiten von großen Modellen und Agenten, um die „geschlossene Schleife aus trockenen und nassen Experimenten“ zu realisieren.
Die Effizienzziele der beiden Unternehmenstypen unterscheiden sich ebenfalls.
Früher war das Ziel von KI-Pharmounternehmen, den Zyklus eines Projekts von der Genehmigung bis zum Kandidatenmittel von 4,5 Jahren auf 12 bis 18 Monate zu verkürzen. Nach Ansicht des genannten Experten liegt das Ziel von Unternehmen für große Modelle näher an einem einzelnen Zyklus: Die Konstruktion einzelner Zielstrukturen wird von Wochen oder Monaten auf wenige Sekunden oder Minuten verkürzt, und dann wird eine Iteration des nassen Experiments von 6 Monaten auf weniger als 14 Tage komprimiert.
Die Unterschiede zwischen den beiden Ansätzen zeigen sich auch in den Datenquellen. Man kann sogar sagen, dass Daten das Kernvermögen im Bereich der KI-Pharmaindustrie sind.
Um den gesamten Prozess zu durchbrechen, bauen KI-Pharmounternehmen in der Regel teilweise eigene Fähigkeiten für nasse Experimente auf oder kaufen Validierungsdienstleistungen bei Pharmaunternehmen und CRO im Zusammenhang mit spezifischen Pipelines, wobei die Daten im Laufe der Projekte angesammelt werden. Im Vergleich dazu legen Unternehmen für große Modelle mehr Wert auf einen allgemeinen Arbeitsplatz: Sie bauen oft zuerst eine allgemeine Plattform auf und verbinden diese dann mit eigenen Labors sowie externen Dienstleistern wie Twist Bioscience (TWST.US), Adaptyv Bio und GenScript (01548.HK).
Konkret zu den Daten betrachtet: Unternehmen für große Modelle erhalten nicht nur Daten aus einer einzelnen Pipeline, sondern auch Aufzeichnungen über erfolgreiche und fehlgeschlagene Experimente (insbesondere fehlgeschlagene Daten). Aus diesen Aufzeichnungen muss das Modell ableiten, welche Werkzeuge wirksam sind und welche Konstruktionen fehlgeschlagen sind, um dann das nächste Experiment anzupassen.
Im Vergleich dazu liegen die Daten traditioneller KI-Pharmounternehmen näher an spezifischen Arzneimittelvermögen, während Unternehmen für große Modelle eine Dateninfrastruktur anstreben, die zielstrukturübergreifend und aufgabenspezifisch eingesetzt werden kann.
Allerdings können allgemeine Modelle pharmazeutische Erfahrung nicht ersetzen.
Wie in Forschungsberichten der Western Securities und anderer erwähnt, fehlen Unternehmen für große Modelle an exklusiven klinischen Daten, fehlgeschlagenen Daten und interdisziplinären Fachkräften, und der Zusammenhang zwischen den Ausgaben des Modells und den klinischen Endpunkten ist noch immer schwach. Die vorherige Generation von KI-Pharmounternehmen steht näher an den Arzneimittelpipelines, während Unternehmen für große Modelle näher an der F&E-Infrastruktur stehen. Erstere müssen ihre Modelle und Finanzierung ergänzen, Letztere ihre Fähigkeiten in Experimenten, pharmazeutischer Chemie und klinischer Translation ausbauen.
Traditionelle Pharmaunternehmen befinden sich dagegen zwischen den beiden Gruppen. Sie verfügen über präklinische, klinische und Produktionsdaten und wissen, wie man Kandidatenarzneimittel zur IND-Anmeldung und zu klinischen Studien bringt.
Experte A weist jedoch darauf hin, dass große Pharmaunternehmen ihre F&E-Aktivitäten in der Regel nach Pipelines organisieren, sodass verschiedene Teams möglicherweise unterschiedliche Software, experimentelle Abläufe und Aufzeichnungsmethoden verwenden. Historische Daten müssen bereinigt und neu annotiert werden, bevor sie für das Training von Modellen verwendet werden können. Obwohl Pharmaunternehmen über die meisten Daten verfügen, haben sie nicht unbedingt bereits eine einheitliche Dateninfrastruktur aufgebaut.
Finanzierungsausrichtung, Daten und Dateninfrastruktur
Mit dem Einzug von Modellen in Labore beginnen sich die F&E-Budgets neu zu verteilen.
Experte B gibt an, dass Anthropic plant, 3 % bis 4 % seines jährlichen wiederkehrenden Umsatzes in die KI-gestützte Wirkstoffforschung zu investieren, wobei 60 % bis 65 % für das Modelltraining und virtuelle Simulationen und 35 % bis 40 % für Biotechnologiefachkräfte, Vermögen von nassen Labors und die Zusammenarbeit mit CRO verwendet werden. Der Experte fügt hinzu, dass in der traditionellen Pharmaindustrie etwa 60 % bis 70 % des F&E-Budgets in nasse Experimente fließen.
Wenn dies der Fall ist, spiegelt dieses Verhältnis der Mittelverteilung die unterschiedlichen Kostenstrukturen von Unternehmen für große Modelle und Pharmaunternehmen wider. Pharmaunternehmen investieren mehr Mittel in Experimente, Klinik und Produktion, während Unternehmen für große Modelle zuerst in Rechenleistung und Basismodelle investieren und dann mit dem Experimentbudget qualitativ hochwertige Rückkopplungen erwerben.
Wenn sich die Konstruktionsgeschwindigkeit der Modelle erhöht, steigt die Anzahl der Kandidatenlösungen, die in das Labor gelangen. Daher kann der Anteil der nassen Experimente am F&E-Budget sinken, während die absoluten Ausgaben nicht unbedingt zurückgehen. Das erklärt auch, warum Unternehmen für große Modelle einerseits eigene Labore aufbauen und andererseits ihre Zusammenarbeit mit CRO und Dienstleistern für die Biowissenschaften ausweiten.
Die Labore bestimmen auch, welche Daten die Modellunternehmen erhalten können. Wenn das Modell Pharmaunternehmen nur Software bereitstellt, verbleiben die experimentellen Ergebnisse in der Regel beim Kunden. In veröffentlichten Arbeiten werden meist nur erfolgreiche Ergebnisse festgehalten, während fehlgeschlagene Daten selten öffentlich zugänglich sind. Und Moleküle, die nicht synthetisiert werden konnten, Zellexperimente ohne erwarteten Phänotyp sowie Änderungen der Versuchsbedingungen beeinflussen die Beurteilung des Modells in der nächsten Runde.
Vor diesem Hintergrund versucht Anthropic derzeit, Werkzeuge, Geräte und experimentelle Daten miteinander zu verbinden. Laut Unternehmensangaben kann der Model Hardware Standard, der Ende August für die Forschungsvorschau freigegeben wurde, Mikroskope, Flüssigkeitsarbeitsplätze, Roboterarme und Plattenlesegeräte verbinden. Genentech hat damit bereits Proteinkonzentrationsmessungen mit mehreren koordinierten Geräten durchgeführt, und das Team der University of Washington hat ein Dosis-Wirkungs-Experiment um etwa das Dreifache beschleunigt.
Gleichzeitig behält Anthropic nicht alle Experimente im eigenen Haus. Laut seiner Forschung zur Proteinkonstruktion übernehmen Adaptyv Bio und Twist Bioscience die externe Validierung. Groß angelegte Synthesen, Tierversuche und klinische Studien können weiterhin an CRO, CDMO und Pharmaunternehmen übergeben werden.
In China investierte ByteDance bereits 2022 in Image Technology (die Trägergesellschaft ist „Shanghai Huixiang Information Technology Co., Ltd.“). Laut der Website von Image Technology hat das Unternehmen Insilico Medicine erfolgreich dabei unterstützt, das groß angelegte 6. Generation intelligentes Roboterlabor in Suzhou zu errichten.
Der Zweck des Aufbaus eigener Labore besteht darin, Schlüsselsexperimente, Geräteorchestrierung und Datenstandards zu beherrschen, nicht darin, ein vollständiges Pharmaunternehmen zu replizieren. Sogar ein Branchenkenner hat eine provokante These aufgestellt: „Große KI-Unternehmen werden beginnen, große Pharmaunternehmen zu erwerben. Nicht wegen der Arzneimittel, sondern wegen der Daten.“
