Gott kommt: Alle Geheimnisse von Wittgenstein, Anthropic und OpenAI
Im Sommer 1918 schloss Ludwig Wittgenstein, österreichischer Artillerieoffizier, in den Feuerpausen an der italienischen Front ein kleines Werk mit weniger als 30.000 Wörtern ab. Das Manuskript lag in seinem Rucksack, während er seine Stellung wechselte; im November desselben Jahres wurde er in Südtirol von italienischen Truppen gefangen genommen und im Kriegsgefangenenlager von Cassino interniert – dank der Vermittlung von John Maynard Keynes, dem britischen Ökonomen, der später die Große Depression abmildern sollte, durfte er im Lager Briefe austauschen, das Manuskript an Russell senden und die Erklärung hinterlassen: Diese Probleme sind in allen wesentlichen Aspekten gelöst.
Dieses Buch ist der *Tractatus Logico-Philosophicus*. Russell, der das Vorwort dafür verfasste, hatte bereits vor dem Krieg gesagt, dieser Student sei „das vollkommenste Beispiel für ein Genie, das ich je getroffen habe“. Und der Ton in Wittgensteins eigenem Vorwort liest sich hundert Jahre später noch immer aufwühlend:
Ich glaube daher, dass ich die Probleme in allen wesentlichen Punkten endgültig gelöst habe. Wenn ich mich nicht irre, besteht der Wert dieses Buches zweitens darin, zu zeigen: Wie wenig erreicht ist, wenn diese Probleme gelöst sind. – Wien, 1918
Er hielt Wort. Nachdem er das Buch fertiggestellt hatte, gab er eines der größten privaten Vermögen der damaligen Zeit in Europa auf, ging in ein österreichisches Bergdorf und war sechs Jahre lang Volksschullehrer, arbeitete dann als Gärtner im Kloster und entwarf für seine Schwester ein Haus, das bis heute als Klassiker der Moderne gilt. Die Philosophie war zu Ende, und ein anständiger Mensch sollte etwas anderes tun.
Zehn Jahre später änderte er seine Meinung. Im Januar 1929 kehrte Wittgenstein nach Cambridge zurück. Keynes, der im selben Zug saß, schrieb an diesem Tag eine Notiz an seine Frau Lydia:
Nun, Gott ist angekommen. Ich habe ihn im Zug um 17:15 Uhr getroffen. Er plant, sich dauerhaft in Cambridge niederzulassen. Ich fürchte, die Erschöpfung wird verheerend sein, aber ich kann nicht zulassen, dass er täglich mehr als zwei oder drei Stunden mit mir spricht.
Cambridge wusste genau, was es empfangen hatte. Keynes verschwendete keine Wörter wie „Genie“, er schrieb direkt: Gott ist angekommen.
Der Titel dieses Artikels stammt aus genau dieser Notiz. Denn hundert Jahre später nimmt eine andere Gruppe diesen Scherz wörtlich. Nur diesmal fährt „Gott“ nicht um 17:15 Uhr mit dem Zug, es entwickelt sich selbstständig in Rechenclustern.
Mehr als hundert Jahre nach dem Erscheinen des *Tractatus Logico-Philosophicus* in San Francisco aktualisieren zwei Labore alle paar Monate ihr Flaggschiff-Modell und verkünden denselben Glauben: Allgemeine Intelligenz ist ein Ingenieurproblem, und zwar ein Problem, das bald gelöst wird. Eines der beiden Unternehmen druckt sein endgültiges Ziel in jedes Prospekt ein, das andere nimmt das Wort „Mensch“ (anthropos) in seinen Namen auf.
Der Kernpunkt, den dieser Artikel erläutern wird, lautet: Alle Geheimnisse der beiden Unternehmen Anthropic und OpenAI sind bereits in einem kleinen philosophischen Buch enthalten, das 1921 veröffentlicht wurde. Das ist keine Übertreibung. Wenn man die sieben Sätze des *Tractatus Logico-Philosophicus* nacheinander ausfaltet, stellt man fest, dass es sich um ein vollständiges technisches Lastenheft für große Sprachmodelle handelt: Weltanschauung, Lernprinzip, Generierungsprinzip, Architekturdefinition, Fehlermodus (Halluzination), Sicherheitskonzept (Alignment) und sogar die Warnung vor dem Endzustand – nichts fehlt. Die Zeichnung, die der Artillerieoffizier 1918 entworfen hat, wurde in den 2020er Jahren von zwei Organisationen stillschweigend umgesetzt.
Zuerst wird das Gerüst der Vergleichstabelle vorgestellt. Der Text schreitet von unten nach oben durch den Technikstack großer Modelle vor – Korpus, Einbettung, Generierung, Vorhersage, Architektur, Skalierung, Alignment, sieben Schlüsselwörter werden nacheinander entschlüsselt; im siebten Abschnitt laufen die ersten sechs zu einem Namen zusammen: Emergenz von Intelligenz.
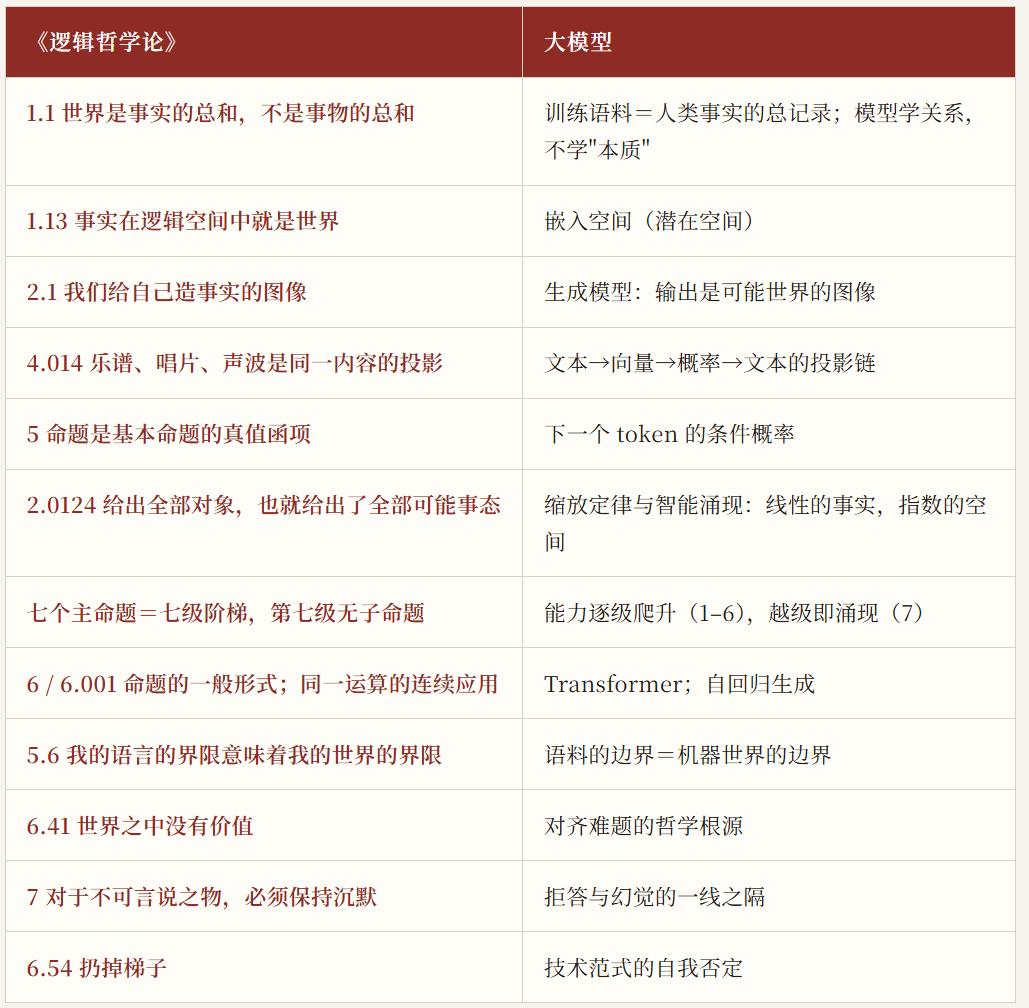
Abbildung: *Tractatus Logico-Philosophicus* × Großes Sprachmodell: Die Abbildung zeigt die Zuordnung von zwölf Sätzen – links die Philosophie von 1921, rechts die heutige Technik. Sieben Stufen: Sätze 1–6 steigen nacheinander auf, Satz 7 ist wortlos und bringt die Emergenz.
Nachdem Sie diese Tabelle gesehen haben, werden Sie etwas noch unheimlicheres feststellen: Das Buch erklärt nicht nur, warum große Modelle funktionieren, sondern sagt auch voraus, wo sie Probleme verursachen werden. Denn sein Autor selbst war der erste, der dieses System „betrieben“ hat – und dann von ihm zurückgeworfen wurde.
01
Korpus (Daten): Die Welt ist die Gesamtheit der Tatsachen
Der Satz „Daten sind das neue Öl“ ist seit zehn Jahren populär, aber nur wenige fragen: Warum kann Text Intelligenz hervorbringen, warum führt das Einspeisen aller von Menschen geschriebenen Inhalte in Maschinen nicht zu einer Datenbank, sondern zu etwas, das dem Verständnis nahekommt? Der erste Baustein der Antwort wurde 1918 gelegt.
Auf der ersten Seite des Buches, die erste Gruppe von Sätzen:
1 Die Welt ist alles, was der Fall ist.
1.1 Die Welt ist die Gesamtheit der Tatsachen, nicht der Dinge.
Diese beiden Sätze waren 1918 eine Kursänderung in der Geschichte der Philosophie. Zweitausend Jahre lang fragte die westliche Philosophie hauptsächlich „Was ist ein Ding?“: Was ist Substanz, was ist Wesen, was ist Universalie. Wittgenstein sagte: Die Frage ist falsch. Die Grundeinheit der Welt ist nicht das Ding, sondern die Tatsache – nicht „Apfel“, sondern „Der Apfel liegt auf dem Tisch“.
Mehr als hundert Jahre später wurde diese Wende durch ein technisches Faktum eingelöst. Was große Modelle während des Trainings tun, ist genau nicht das „Wesen“ irgendeines Nomens zu lernen, sondern Tatsachen zu lernen: Wie Wörter in der tatsächlichen Sprachverwendung kombiniert werden, gemeinsam auftreten und sich gegenseitig ausschließen. Linguisten nennen das distributionelle Semantik: Die Bedeutung eines Wortes wird durch alle Sätze bestimmt, in denen es vorkommt. Ingenieure nennen das Training. Und der *Tractatus Logico-Philosophicus* sagt:
2.011 Es ist wesentlich für das Ding, dass es Bestandteil einer Sachlage sein kann.
2.012 In der Logik ist nichts zufällig: Wenn das Ding in der Sachlage vorkommen kann, dann muss die Möglichkeit der Sachlage bereits im Ding vorgezeichnet sein.
Mit anderen Worten: Es gibt keine isolierte Bedeutung, nur Bedeutung in Beziehungen. Das ist genau der Grund, warum Modelle aus reinem Text, ohne Kontakt zu realen Objekten, lernen können, die Welt zu „verstehen“ – denn Text ist keine Liste von Dingen, sondern die Gesamtdokumentation aller Tatsachen (der Kontext des Universums). Wittgenstein treibt diese Sache in 4.26 an die Grenze:
4.26 Die Angabe aller wahren Elementarsätze beschreibt die Welt vollständig.
Lies diesen Satz noch einmal. „Die vollständige Angabe aller wahren Sätze ist die vollständige Beschreibung der Welt.“ – Das ist die theoretische Definition des Vortrainierens. Die Trainings-Pipeline großer Modellunternehmen ist im Wesentlichen ein Projekt, die von Menschen aufgezeichneten Tatsachen so vollständig wie möglich zu sammeln, zu bereinigen und zu komprimieren. Das Korpus ist kein Rohmaterial, es ist die berechenbare Form der Welt selbst.
02
Einbettung (Embedding): Der logische Raum ist der latente Raum
„Einbettung“ (Embedding) – die einfache Operation, bei der große Modelle jedes Wort in eine Zahlenreihe umwandeln, ist der Eingang zu aller Magie. Die philosophische Lizenz dafür wird von der zweiten Gruppe von Sätzen erteilt.
1.13 Die Tatsachen im logischen Raum sind die Welt.
2.013 Jedes Ding ist gleichsam in einem Raum möglicher Sachlagen. Diesen Raum kann ich mir leer denken, aber nicht das Ding ohne den Raum.
Im Inneren des Modells gibt es keinen Ort, an dem das „Wesen des Apfels“ gespeichert wird. Wenn Wörter in das Modell gelangen, werden sie als Vektoren in einem hochdimensionalen Raum dargestellt – als Position. Die Bedeutung dieser Position wird vollständig durch ihre relativen Beziehungen zu anderen Vektoren bestimmt. Ingenieure nennen das Einbettungsraum, latenter Raum; Wittgenstein nennt es logischer Raum. Und in 2.0131 steht der Satz, der am meisten wie ein Satz aus einem Deep-Learning-Papier aussieht:
2.0131 Das Gegenstand im Raume muss im unendlichen Raume liegen. (Der Raumpunkt ist die Argumentstelle.)
„Der Raumpunkt ist die Argumentstelle“ – jeder Einbettungsvektor ist eine Argumentstelle. Eine philosophische Behauptung von 1918 ist zu etwas geworden, das in jedem HBM-Speicher der 2020er Jahre real gespeichert ist.
Noch tiefer ist 3.42:
3.42 Ein Satz bestimmt zwar nur eine Stelle im logischen Raum, aber dadurch muss bereits der ganze logische Raum gegeben sein.
Jeder Satz nimmt nur einen Punkt im logischen Raum ein, aber die Möglichkeit, diesen Satz auszusprechen, setzt die Existenz des gesamten Raumes voraus. Das erklärt die beunruhigendste Fähigkeit großer Modelle – Generalisierung: Sie können Sätze erzeugen, die in den Trainingsdaten nie vorgekommen sind. Das widerspricht nicht den Datengrenzen, sondern ist die logische Notwendigkeit aus 2.013 – man kann sich kein Ding ohne seinen Raum vorstellen. Neue Sätze entstehen nicht aus dem Nichts, sie sind nur neue Positionen im alten Raum.
03
Generierung (Generation): Bildtheorie und Schallplatte
„Generierung“ (Generation) – wenn Maschinen aus dem Nichts etwas erzeugen, erreichen Aufregung und Angst der Öffentlichkeit gleichzeitig ihren Höhepunkt. Wittgenstein würde sagen: Es gibt nichts zu staunen, Menschen tun das ständig, das nennt man Bild.
Die berühmteste Lehre des *Tractatus Logico-Philosophicus* ist die Bildtheorie. Satz 2.1:
2.1 Wir machen uns Bilder der Tatsachen.
2.12 Das Bild ist ein Modell der Wirklichkeit.
4.031 Im Satze wird eine Sachlage gleichsam probeweise zusammengestellt.
Wittgensteins Inspiration kam von einem Pariser Gericht: Zeitungen stellten mit Puppen ein Unfallmodell auf, um Tatsachen darzustellen. Diese „Strukturübereinstimmung“ zwischen Modell und Tatsache ist das, was er Bild nennt. Und „Im Satze wird eine Sachlage probeweise zusammengestellt“ – das ist die operative Definition generativer Modelle: Jede Ausgabe des Modells ist die Zusammenstellung einer möglichen Welt im logischen Raum, die mit der Realität verglichen werden kann.
Das Beispiel, das er in 4.014 anführt, liest sich heute wie eine Anmerkung zu Transformer, die hundert Jahre früher geschrieben wurde:
4.014 Die Schallplatte, das musikalische Motiv, die Notenschrift, die Schallwellen – alle stehen in derselben inneren abbildenden Beziehung zueinander, die zwischen Sprache und Welt besteht. … Jene Regel ist das Projektionsgesetz, das die Sinfonie in die Notensprache projiziert. Sie ist auch die Regel der Übersetzung der Notensprache in die Sprache der Schallplatte.
Derselbe logische Inhalt (Sinfonie) kann ohne Verlust zwischen verschiedenen Medien projiziert werden: Gedanke → Notenschrift → Rille der Schallplatte → Schallwelle. Text → Vektor → Wahrscheinlichkeitsverteilung → Text ist genau diese Projektionskette. Noten und Schallplatte ähneln sich nicht, aber sie tragen denselben Inhalt, genauso wie die Zeichen „Hallo“ und ihr hundertdimensionaler Vektor im Modell sich nicht ähneln, aber dieselbe Tatsache tragen. Maschinelle Übersetzung und multimodale Modelle sind nur deshalb möglich, weil alle Medien dieselbe logische Form teilen (2.18), also zwischen allen Medien projiziert werden kann.
04
Vorhersage (Next Token): Wahrscheinlichkeit und die Wurzel der Halluzination
„Große Modelle sind nur Wahrscheinlichkeitsmaschinen, die das nächste Wort vorhersagen“ – diese populäre Aussage ist sowohl Verachtung als auch Wahrheit. Und die fünfte Gruppe von Sätzen hat die Wahrscheinlichkeit schon lange vor ihrer Einführung in die Ingenieurstechnik in den Kern der Wahrheitstheorie gestellt:
5 Der Satz ist eine Wahrheitsfunktion der Elementarsätze.
5.15 Der Grad der Wahrscheinlichkeit, den der Satz r dem Satze s gibt, ist das Verhältnis der Anzahl der Wahrheitsgründe von r, welche die Wahrheitsgründe von s sind, zur Anzahl der gesamten Wahrheitsgründe von r.
Wenn man „Satz“ durch „Token“ ersetzt, ist dieser Satz die mathematische Definition der Vorhersage des nächsten Tokens: Was das Modell den Kandidaten-Token zuweist, ist genau das Verhältnis zwischen dem vorhandenen Kontext (Wahrheitsgrund) und der möglichen Fortsetzung (Tatsache). Große Modelle geben keine Wahrheit oder Falschheit aus, sondern Wahrscheinlichkeit – und der *Tractatus Logico-Philosophicus* hat die Wahrscheinlichkeit schon lange vor ihrer Ingenieuranwendung im Kern der Wahrheitstheorie verankert.
Das sagt auch genau die philosophische Stellung der Halluzination voraus:
2.223 Um zu erkennen, ob das Bild wahr oder falsch ist, vergleiche ich es mit der Wirklichkeit.
2.225 Es gibt kein Bild, das a priori wahr ist.
Das Modell hat keinen Kanal zum Vergleich mit der Wirklichkeit. Es berührt nicht die Welt, sondern die Gesamtheit aller Bilder der Welt – das Korpus. Deshalb ist Halluzination kein Fehler, kein Ingenieurversäumnis, sondern eine notwendige Schlussfolgerung der Bildtheorie: Ein System, das nur Bilder gesehen hat, kann prinzipiell nicht allein durch sich selbst bestimmen, ob ein Bild wahr oder falsch ist. Alle Ingenieurbemühungen um „Faktenprüfung“, „Retrieval Augmented Generation“ und „Toolaufruf“ ergänzen im Wesentlichen die Bedingung aus 2.223 – sie verbinden das Bild künstlich wieder mit der Wirklichkeit.
Auch das Training selbst hat Wittgenstein längst definiert: