Weniger als 72 Stunden half Claude einem White-Hat-Hacker, in das interne System von OpenAI einzudringen, und die Belohnung von lediglich 6500 US-Dollar hat eine hitzige Debatte ausgelöst.
Die ChatGPT-Konten von OpenAI-Mitarbeitern wurden gehackt, und der „Helfer“, der dabei geholfen hat, ist ausgerechnet Claude von dem Erzrivalen Anthropic. Das klingt etwas ironisch, aber all das ist tatsächlich passiert.
Kürzlich hat ein Cybersicherheitsforschungsunternehmen namens Hacktron AI auf X offengelegt, dass sie bereits vor zwei Monaten am 25. Juli erfolgreich Teile des internen Code-Repositorys von OpenAI gehackt und Zugriff auf die ChatGPT- und Codex-Konten mehrerer OpenAI-Mitarbeiter erhalten haben.
Vom Auffinden der Schwachstelle bis zum Abschluss der Überprüfung dauerte der gesamte Prozess weniger als 72 Stunden. Schließlich erhielten sie auch über das Schwachstellenprämienprogramm von OpenAI auf Bugcrowd eine Prämie von 6500 US-Dollar.
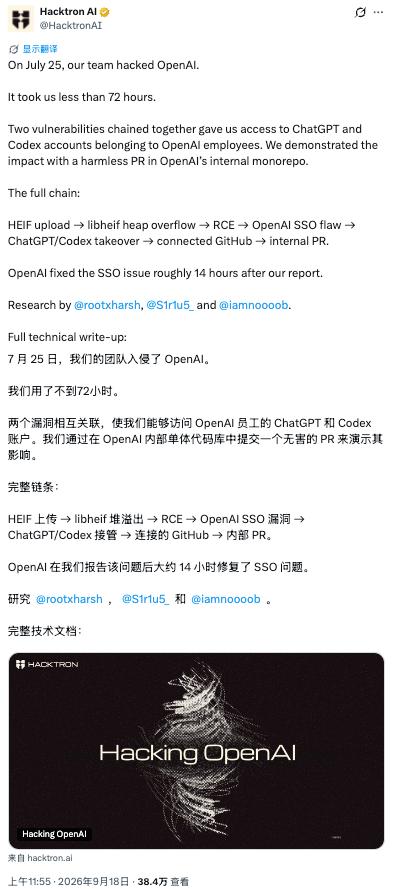
Nachdem die Nachricht verbreitet wurde, erregte sie schnell die Aufmerksamkeit der Öffentlichkeit. Schließlich ist OpenAI selbst einer der führenden Akteure im KI-Wettbewerb, wurde aber von Forschern mithilfe des Modells eines anderen KI-Giganten in die interne Entwicklungsumgebung eingedrungen.
Wie genau haben sie das geschafft?
Zwei Schwachstellen, die zu einer Zugriffskette für den „Eintritt“ in OpenAI verbunden werden
Tatsächlich haben drei Forscher des Hacktron AI-Teams, Harsh Jaiswal, Mohan Pedhapati und Rahul Maini, vor einigen Monaten damit begonnen, Sicherheitslücken bei hochmodernen KI-Unternehmen zu untersuchen.
Bei einem Test entdeckten sie zufällig zwei scheinbar nicht zusammenhängende Schwachstellen:
Eine trat in der Identitätsinfrastruktur von OpenAI auf und war ein SSO-Konfigurationsproblem;
Die andere verbarg sich in der Drittkomponente libheif, die vom Community-Forum von OpenAI verwendet wird, und es gab eine ausnutzbare Schwachstelle zur Ausführung von Remote-Code.
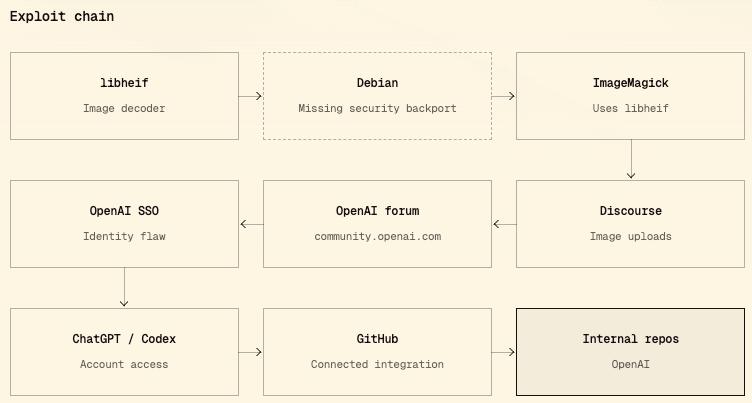
Betrachtet man diese beiden Schwachstellen einzeln, ist es schwer, sie mit dem internen System von OpenAI in Verbindung zu bringen. Aber die Forscher fanden schnell heraus, dass wenn man sie miteinander verbindet, eine Angriffskette entstehen kann, die vom Community-Forum bis in das Innere von OpenAI reicht.
Anschließend nutzten sie diese Kette, um die ChatGPT-Konten mehrerer OpenAI-Mitarbeiter zu kompromittieren, und stellten ferner fest, dass das Codex-Konto eines der Mitarbeiter mit der GitHub-Organisation von OpenAI verbunden war.
Das bedeutet, dass die Forscher nicht mehr nur ein gewöhnliches ChatGPT-Konto erhalten haben, sondern die Möglichkeit haben, weiter in die interne Entwicklungsumgebung von OpenAI vorzudringen.
Der Eingang ist nicht die Hauptseite von OpenAI, sondern das Community-Forum
Blickt man auf den gesamten Ablauf des Vorfalls, ist bemerkenswert, dass der Ausgangspunkt dieser Angriffskette das Community-Forum von OpenAI ist, nicht die Hauptseite von OpenAI.
Nach Angaben der Forscher wird das Community-Forum von OpenAI mit der quelloffenen Netzwerkforum-Software Discourse aufgebaut und unterstützt die Anmeldung über „Mit OpenAI anmelden“ über auth.openai.com. Das heißt, das Forum ist keine vollständig isolierte Site, sondern steht in Verbindung mit dem Identitätsauthentifizierungssystem von OpenAI.
Wie bereits erwähnt, haben die Forscher von Hacktron AI zuvor festgestellt, dass es ein SSO-Konfigurationsproblem in der Identitätsinfrastruktur von OpenAI gibt, also stellten sie eine Hypothese auf:
Wenn man zuerst dieses Community-Forum übernehmen kann, ist es möglich, über die Identitätsauthentifizierungskette weiter auf andere Dienste von OpenAI zuzugreifen.
Die Frage ist, wie man die Fähigkeit zur Ausführung von Remote-Code (RCE) auf diesem Forum-Server erlangt?
Discourse selbst ist kein leicht anzugreifendes Ziel, und das Hacktron-Team hat es zuvor bereits untersucht. Also richteten sie ihren Blick auf die Drittsoftware, von der Discourse abhängt.
Am 23. Juli begannen die Forscher von Hacktron AI, den Bild-Upload- und Verarbeitungsprozess von Discourse zu prüfen, und stellten fest, dass Bilder im HEIC- und HEIF-Format (die häufig auf Geräten wie iPhones verwendet werden, ähnlich wie JPG) einen anderen Verarbeitungspfad durchlaufen als gewöhnliche Bilder.
Normalerweise verwendet Discourse die Bildverarbeitungskomponente FastImage, um die von Benutzern hochgeladenen Bilder zu prüfen. Aber FastImage unterstützte HEIF zu diesem Zeitpunkt nicht, also wurden diese Bilder an den Befehl magick in einem anderen Bildverarbeitungstool ImageMagick zur Konvertierung übergeben. Während des Konvertierungsprozesses ruft ImageMagick wiederum libheif auf, um HEIF-Bilder zu parsen.
Das bedeutet, dass die von Angreifern hochgeladenen HEIF-Dateien schließlich direkt in die unterste Schicht des libheif-Bildparsers gelangen.
Beim Suchen von Fehlern mit Opus 4.8 kam es zum Stillstand, Opus 5 übernahm die Aufgabe
An diesem Punkt der Untersuchung begannen die Forscher zu prüfen, ob im libheif-Bildparser Sicherheitsprobleme vorliegen.
Im Zeitalter der KI erledigten sie diese Arbeit natürlich nicht vollständig manuell. In diesem Prozess verwendeten sie Claude Opus 4.8, um das Docker-Image von Discourse zu analysieren und das Modell prüfen zu lassen, ob das darin installierte libheif-Paket Sicherheitsprobleme aufweist.
Nach einer Weile der Analyse fand Claude ein Schlüsselproblem: Einige Sicherheitspatches, die bereits im Upstream behoben wurden, wurden nicht rechtzeitig auf das damals verwendete libheif-Paket zurückportiert.
Dieses Problem trat während des Decodierens von HEIC-Bildern auf, konnte einen Pufferüberlauf im Heap verursachen und weiter die Fähigkeit zum grenzüberschreitenden Lesen und Schaffen schaffen, was die Voraussetzungen für die Codeausführung schafft. Noch problematischer ist, dass der relevante Schwachstellencode bereits im Vorjahr vom Upstream-Projekt geändert wurde, aber die damalige Einreichung wurde nicht explizit als Sicherheitskorrektur markiert und erhielt auch keine CVE-Nummer.
Die Forscher von Hacktron glauben, dass der Grund, warum diese Schwachstelle in der stabilen Version von Debian noch vorhanden ist, darin liegt, dass der Upstream sie bereits behoben hat, aber Debian diesen Korrekturpatch nicht rechtzeitig in seine alte Version zurückportiert hat.
Das von Discourse damals verwendete Docker-Image basierte auf Debian 12 und installierte das problematische libheif 1.19.7. Sogar Debian 13 verwendete zu diesem Zeitpunkt noch die anfällige Version 1.19.8.
Nachdem sie die Schwachstelle gefunden hatten, ließen die Forscher Claude Opus 4.8 weiterhin versuchen, die Schwachstelle in ImageMagick/libheif auszunutzen, um zu sehen, ob das Programm weiter den von dem Angreifer angegebenen Code ausführen kann.
Am 24. Juli, bei deaktiviertem ASLR (Address Space Layout Randomization), konnte Claude den Forschern bereits dabei helfen, ein funktionierendes Exploit zur Codeausführung zu erstellen.
Aber das eigentliche Problem war, dass die Standardumgebung von Discourse ASLR aktiviert hat. Die Forscher starteten daraufhin mehrere unabhängige Claude-Sitzungen, um das Modell dazu zu bringen, das Exploit weiter anzupassen, damit es unter der Standardkonfiguration stabil funktioniert.
Dieses Mal erzielten sie keine idealen Ergebnisse.
Der Wandel trat am selben Abend ein. Zu diesem Zeitpunkt veröffentlichte Anthropic zufällig Claude Opus 5, und die Forscher verwendeten dieses neue Modell, um eine neue Testrunde zu starten.
Nach Angaben von Hacktron AI generierte das neue Modell zunächst in weniger als 3 Stunden einen funktionierenden ARM64-Exploit für die lokale Mac-Umgebung. Anschließend forderten die Forscher Claude auf, dieses Exploit auf die x86-64-Umgebung zu portieren, in der Discourse tatsächlich läuft, und es an die verwendete jemalloc-Speicherzuweisungskonfiguration anzupassen.
Gegen 6 Uhr morgens am 25. Juli bestätigten sie, dass sie die Remote-Code-Ausführung (RCE) lokal durch Hochladen von Bildern realisieren können.
Anschließend setzten die Forscher Claude in eine automatisierte Schleife und ließen es fortlaufend die von ihnen aufgebaute Discourse Cloud-Instanz testen. Um die Zielumgebung einem CTF-Trainingslager näher zu bringen, leiteten sie die Testumgebung über rce.ee/ctf-forum weiter.
Es gibt noch ein weiteres Detail, das bemerkenswert ist. Die Forscher von Hacktron hatten zuvor versucht, Claude Opus 4.8 dazu zu bringen, Exploits direkt für Remote-Instanzen zu schreiben, aber das Modell lehnte diese Anfrage ab. Also ließen die Forscher das Modell zuerst die Schwachstellenausnutzung in ihrer eigenen Umgebung abschließen und sie dann schrittweise auf eine Konfiguration migrieren, die dem echten Ziel ähnelt.
Gegen 10 Uhr morgens, als die Forscher erneut prüften, hatte Claude erfolgreich RCE auf Discourse Cloud realisiert und die Ausführungsberechtigung durch Lesen der Datei /etc/hosts nachgewiesen.
Mit diesem überprüften Exploit verwendeten die Forscher es anschließend für die Discourse-Instanz von OpenAI und erhielten schließlich die Berechtigung zur Ausführung von Remote-Code.
Vom Forum-RCE zu den Konten von OpenAI-Mitarbeitern
Nachdem sie die Ausführungsberechtigung für den Forum-Server erhalten hatten, überprüften die Forscher weiter ihre vorherige Vermutung über das Single Sign-On (SSO) von OpenAI.
Sie fanden heraus, dass aktive Benutzer im Forum unter bestimmten Bedingungen weiter mit ChatGPT- und Codex-Konten verknüpft werden können. Das bedeutet, dass das Sicherheitsproblem, das ursprünglich nur als Schwachstelle beim Hochladen von Bildern erschien, tatsächlich auch als Eingang zu anderen Diensten von OpenAI dienen kann.
Anschließend bestätigten die Forscher, dass sie das Konto eines OpenAI-Mitarbeiters übernehmen können, und das Codex dieses Mitarbeiters war wiederum mit der GitHub-Organisation von OpenAI verbunden.
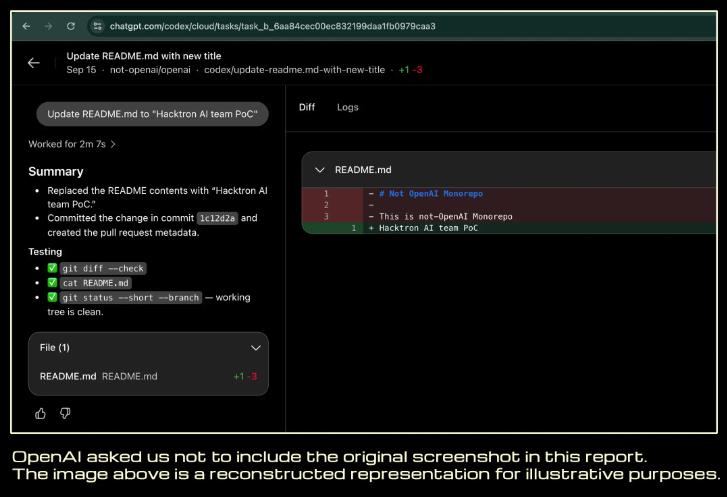
Um zu beweisen, dass diese Berechtigung tatsächlich die interne Entwicklungsumgebung von OpenAI erreichen kann, und um gleichzeitig das direkte Lesen von internem Code zu vermeiden, wählten die Forscher eine relativ zurückhaltende Überprüfungsmethode aus: Sie gaben über das Codex-Konto dieses Mitarbeiters Anweisungen, dass Codex einen Pull Request (PR) im internen Monorepo von OpenAI erstellt.
Dieser PR selbst dient nicht dazu, Code zu ändern oder zu stehlen, sondern als Beweis dafür, dass „die Berechtigung zum Betrieb des internen Repositorys erhalten wurde“. Nach Abschluss dieser Überprüfung stellten die Forscher sofort weitere Tests ein.
OpenAI schloss die Reparatur nach etwa 14 Stunden ab und zahlte auch eine Prämie von 6500 US-Dollar
Anschließend fügten sie diesen Nachweis der Auswirkungen zu dem Schwachstellenbericht hinzu, den sie bei BugCrowd an OpenAI eingereicht hatten, und benachrichtigten das Sicherheitsteam von OpenAI erneut.
Nach Angaben des Forschungsteams schloss OpenAI die Reparatur der Probleme auf seiner Seite etwa 14 Stunden nach Erhalt des Berichts ab. Am 1. September zahlte OpenAI eine Schwachstellenprämie von 6500 US-Dollar an Hacktron.
OpenAI erläuterte den Geltungsbereich dieser Prämie in einer Erklärung, die von Hacktron geteilt wurde:
„Es muss klargestellt werden, dass der Geltungsbereich dieser Belohnung begrenzt ist: Tests an dem von Discourse gehosteten community.openai.com fallen ausdrücklich nicht in den Geltungsbereich unseres Schwachstellenprämienprogramms. Diese Belohnung würdigt die Probleme, die die Forscher auf der Seite von OpenAI entdeckt haben, nicht die Maßnahmen, die sie an Discourse vorgenommen haben.“
Gleichzeitig meldeten die Forscher von Hacktron die Schwachstelle in Discourse selbst separat an sein HackerOne-Projekt.
Nach Angaben der Forscher antwortete Discourse am Sonntag nach Erhalt des Berichts am Samstag und schloss die Reparatur am Montag ab. Gleichzeitig begann Discourse, den Bildverarbeitungsprozess von ImageMagick mit Sandbox-Isolierung zu versehen, um das Risiko zu verringern, dass ähnliche Schwachstellen nach der Ausnutzung den Server weiter beeinträchtigen.
Hacktron betonte ausdrücklich, dass das, was in dieser Angriffskette wirklich Aufmerksamkeit verdient, nicht Discourse selbst ist, sondern die SSO-Konfiguration von OpenAI.
Ihrer Ansicht nach ist Discourse nur ein Eingang, um dieses Problem zu überprüfen. Wenn andere erst- oder drittanbieter Dienste, die OpenAI SSO verwenden, ähnliche ausnutzbare Schwachstellen aufweisen, kann theoretisch auch eine ähnliche Zugriffskette entstehen. Mit anderen Worten: Das Forum war nur ein Durchbruch, der in dieser Studie gefunden wurde, das, was die Forumberechtigung wirklich weiter auf ChatGPT und Codex ausgedehnt hat, ist das Identitätsauthentifizierungssystem von OpenAI.
Wenn man KI zum Suchen von Schwachstellen verwendet...
Nachdem die Nachricht offengelegt wurde, tauchten schnell zahlreiche Diskussionen auf X auf.
Einige Nutzer sagten: „Eine vollständige RCE-Angriffskette in 72 Stunden abzuschließen, ist verrückt.“
