Eine Gruppe von Intel-Veteranen schließt sich zusammen, um NVLink zu kontern.
In einer Zeit, in der der Wettbewerb um die KI-Rechenleistung schnell von der Leistung einzelner Chips auf die Vernetzung von Clustern übergeht, erlebt das Schlachtfeld der Hochgeschwindigkeitsvernetzung seltene heftige Erschütterungen.
Zwei Startup-Kräfte, die aus dem ehemaligen Netzwerkgeschäft von Intel stammen, stürmen gleichzeitig auf das wertvollste Scale-up-Vernetzungssegment im KI-Zeitalter und richten ihre Spitze direkt auf das Kerngebiet von NVIDIA. Auf der anderen Seite beschleunigt die von 115 Branchenriesen gebildete "Anti-NVLink-Allianz" ihre Sammlung, um das Monopol eines einzelnen Unternehmens zu durchbrechen; NVIDIA hingegen nutzt die Gunst der Stunde und spielt die verdeckte Karte "NVLink Fusion", um den legendären Aufstieg von CUDA auf der Hardware-Ebene zu wiederholen.
Eine große Hardware-Schlacht um die Vorherrschaft der nächsten Generation von KI-Rechenzentren ist in vollem Gange.
Zwei ehemalige Intel-Mitarbeiter stürmen auf dasselbe Schlachtfeld
Zuerst werfen wir einen Blick auf das Unternehmen Cornelis, das eine tiefe Verbindung zu Intel hat. Im Jahr 2020 gliederte Intel sein Hochleistungsvernetzungsgeschäft Omni-Path Architecture (OPA) aus, und das Kernteam gründete Cornelis Networks. Die CEO von Cornelis, Lisa Spelman, arbeitete selbst zuvor etwa 20 Jahre bei Intel. Bis heute beschreibt sich Cornelis ausdrücklich als "aus dem Hochleistungsvernetzungsgeschäft von Intel ausgegliedert", und seine technische Linie erbt direkt von Omni-Path. Omni-Path war damals eigentlich die wichtige Waffe von Intel, um Mellanox InfiniBand herauszufordern.
Doch mit der strategischen Anpassung von Intel wurde dieses Geschäft schließlich ausgegliedert. In den folgenden Jahren entwickelte Cornelis seine Hochgeschwindigkeitsvernetzungsprodukte rund um HPC- und KI-Cluster. Das derzeit in Serienproduktion befindliche CN5000 löst hauptsächlich noch Scale-out-Probleme, also die groß angelegte Verbindung zwischen Servern und Rechenknoten. Seine Switches bieten 48 Ports mit 400 Gb/s, und Geräte der Director-Klasse können maximal 576 Ports mit 400 Gb/s bereitstellen.
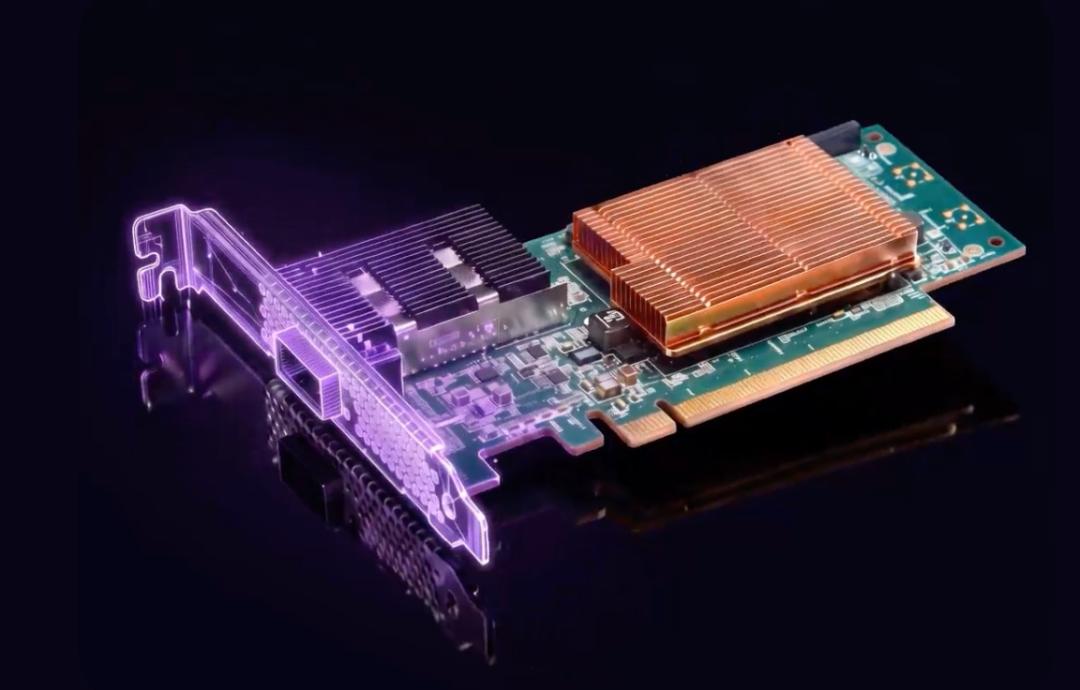
Doch nach dieser Finanzierungsrunde am 14. September hat Cornelis offensichtlich eine Grenze überschritten. Es kündigt erstmals offiziell den Einstieg in das Scale-up-Geschäft an.
Das sogenannte Scale-out bedeutet, mehr Server miteinander zu verbinden; Scale-up ist näher an der GPU selbst und soll Dutzende oder sogar Hunderte von KI-Beschleunigern in einem Rack wie einen einzigen Computer zusammenarbeiten lassen. Und genau das ist der Bereich, in dem NVLink seit langem einen Vorteil hat.
Am 14. September kündigte Cornelis eine Finanzierung in Höhe von 205 Millionen US-Dollar an und stellte das Active Compute Fabric (aktives Berechnungsnetz) vor – eine offene Netzwerkarchitektur mit integrierter programmierbarer Berechnung, die sowohl horizontale als auch vertikale Skalierung unterstützt, was den offiziellen Einstieg in das Segment der vertikal skalierenden Netze markiert. Was Cornelis erreichen will, ist: Das Netzwerk selbst beginnt mit der Berechnung. Diese Architektur kombiniert verlustfreie Übertragung, netzinterne Beschleunigung und programmierbare Berechnung. Sie kann Daten direkt verarbeiten, wenn sie fließen, kollektive Kommunikation entlasten und sich an die Weiterentwicklung von KI-Algorithmen anpassen, wodurch verhindert wird, dass GPUs auf Daten warten und anhalten, und die Auslastung der Beschleuniger erheblich verbessert wird.
Cornelis behauptet, dass in einem Cluster mit 100.000 GPUs herkömmliche Netze aufgrund von Datenwartezeiten zu einer Leerlaufzeit von etwa 50 % der Rechenleistung führen, was jährlich fast 1,68 Milliarden US-Dollar und 500 GWh Strom verschwendet (genug Strom für fast 48.000 amerikanische Haushalte). Das Active Compute Fabric löst dieses Problem durch netzinterne Berechnung und ist kompatibel mit offenen Standards wie UALink, ESUN und Ultra Ethernet sowie gängigen Beschleunigern.
Fast gleichzeitig gab ein anderes Startup mit Hintergrund aus dem Intel-Umfeld, Delos Data, Neuigkeiten über seine Finanzierung bekannt.
Der CEO und Mitbegründer von Delos Data, Ed Doe, stammt ebenfalls aus dem Intel-System. Dieses 2025 gegründete neue Unternehmen wurde von Ed Doe und Dan Daly gegründet. Ed Doe war früher COO von Barefoot Networks. Nachdem Intel Barefoot im Jahr 2019 erworben hatte, leitete er nacheinander Geschäfte wie die Intel Barefoot Division und die Intel Switch & Fabric Group. Dan Daly ist ebenfalls ein erfahrener Intel-Mitarbeiter, der lange Zeit leitende Ingenieurspositionen im Netzwerkbereich von Intel innehatte. Reuters definiert Delos als ein Unternehmen, das von "Intel-Veteranen" gegründet wurde.
Delos kündigte am 15. September eine Finanzierung von mehr als 100 Millionen US-Dollar an, zu den Investoren gehören Matrix, Playground Global, Capricorn, Matter Venture Partners und andere. Erwähnenswert ist, dass Playground Global, bei dem der ehemalige Intel-CEO Pat Gelsinger heute tätig ist, ebenfalls teilnimmt.
Delos hat ein Konzept vorgeschlagen: MoXI (Mixture of X Infrastructure), also eine Infrastruktur, die "alles mischt". Die von ihm entwickelte Nonstop AI Data Interface zielt im Wesentlichen darauf ab, eine einheitliche Datenschnittstelle zwischen diesen heterogenen Geräten und Netzen hinzuzufügen. Beispielsweise kann sein I/O-Chiplet-Plan für GPUs, XPUs und KI-Beschleuniger direkt mit Rechenchips gemeinsam verpackt werden und eine Multiprotokoll-I/O-Bandbreite von über 30 Tb/s bereitstellen; darüber hinaus gibt es eine optische Version mit Nahverpackung von über 10 Tb/s sowie eine Board-Version von über 400 Gb/s für CPUs, Flash-Speicher und Arbeitsspeicher.
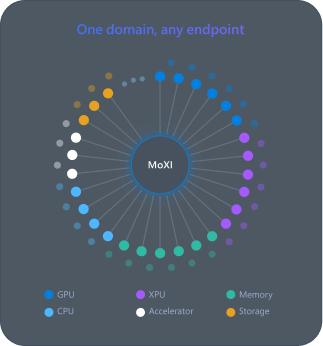
Quelle: Delos
Delos ist kein einfacher Ersatz für NVLink. Sein Ehrgeiz ist sogar größer: Wenn verschiedene GPUs, XPUs, Arbeitsspeicher und Speicher über eine einheitliche Datenschnittstelle frei kombiniert werden können, sollte das zugrundeliegende Protokoll – egal ob NVLink, UALink oder etwas anderes – nicht mehr die gesamte Systemarchitektur bestimmen.
115 Unternehmen,
die eine "Anti-NVLink-Allianz" gebildet haben
Wenn Cornelis und Delos noch Angriffe von Startups sind, dann ist es UALink (Ultra Accelerator Link), das NVLink auf Branchenebene wirklich ausgleichen kann.
UALink wurde ursprünglich gemeinsam von AMD, Intel, Google, Meta, Microsoft und anderen vorangetrieben, mit dem Ziel, einen offenen Standard für die KI-Scale-up-Vernetzung zu schaffen. Bis Ende 2025 überschritt die Zahl der Mitglieder des UALink-Konsortiums bereits 115. Im heutigen UALink-Vorstand sind neben AMD und Intel auch Unternehmen wie Google, Meta, Microsoft, AWS, Apple, Alibaba, Cisco, HPE, Astera Labs und Synopsys vertreten. Man kann sagen, dass die Mitglieder von UALink im Grunde die weltweit wichtigsten Cloud-Unternehmen, KI-Chiphersteller und Infrastrukturanbieter abdecken.
UALink 1.0 unterstützt 200 G/Lane und kann in einem KI-Pod maximal 1024 KI-Beschleuniger verbinden; die im April 2026 veröffentlichte neue Reihe von Spezifikationen fügte Fähigkeiten wie In-Network-Compute, Chiplet und zentralisierte Verwaltung hinzu. Anfang September veröffentlichte UALink weitere Details zu seiner Roadmap für die nächste Phase und kündigte an, die Entwicklung von 400G, optischer Vernetzung, End-to-End-Zuverlässigkeit und umfangreicheren Verwaltungsfunktionen voranzutreiben.
Für diese Anbieter wollen sie nicht, dass alle KI-Rechenchips in Zukunft eine Mautstelle bei NVIDIA passieren müssen. Wenn die Chips selbst entwickelt werden, aber die Kernvernetzung innerhalb des Racks am Ende immer noch von NVLink abhängig ist, ist diese "Entnvidifizierung" offensichtlich unvollständig. Das ist die zentrale Geschäftslogik von UALink.
NVIDIAs brillanter Gegenzug: NVLink Fusion
Auch NVIDIA hat das erkannt. Im Mai 2025 ereignete sich dann eine sehr wichtige Veränderung. NVIDIA stellte NVLink Fusion vor – einen neuartigen Chip, der es verschiedenen Branchen ermöglicht, mit NVIDIAs NVLink halb angepasste KI-Infrastrukturen zu bauen.
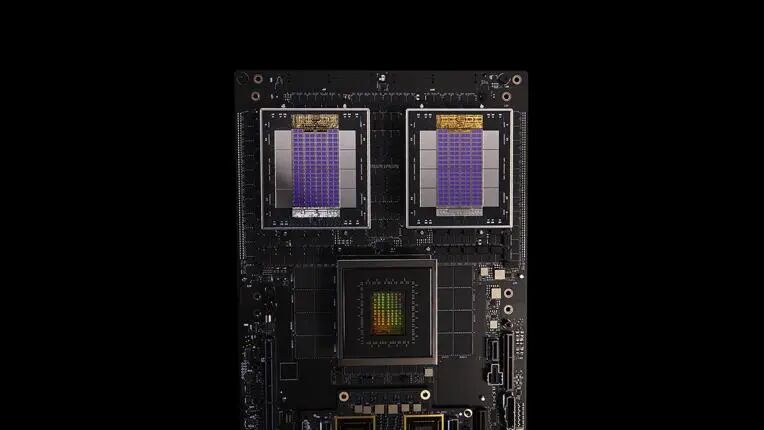
Vor 2025 war NVLink weitgehend eine private Hochgeschwindigkeitsvernetzung zwischen den internen GPUs von NVIDIA. NVLink Fusion öffnet sich aber erstmals systematisch für CPUs und KI-ASICs von Drittanbietern. Zu den ersten angekündigten Partnern gehören MediaTek, Marvell, Alchip, Astera Labs, Synopsys und Cadence; Fujitsu und Qualcomm planen die Entwicklung von CPUs, die über NVLink mit NVIDIAs GPUs Systeme bilden können.
Anschließend erweiterte sich diese Liste schnell weiter. Im November 2025 kündigte Arm an, dass Neoverse NVLink Fusion integriert. Im Dezember 2025 gab AWS bekannt, dass Trainium4 NVLink Fusion integrieren wird. Im Januar 2026 bedeutete der Beitritt von SiFive, dass auch RISC-V-CPUs in NVLink eingebunden werden können. NVLink Fusion hat in kürzester Zeit die drei CPU-Architekturen Arm, x86 und RISC-V erschlossen.
Im März 2026 wurde die Zusammenarbeit als einer der ersten NVLink-Fusion-Partner zwischen NVIDIA und Marvell weiter ausgebaut, NVIDIA investierte zudem 2 Milliarden US-Dollar in Marvell. Marvell wird Custom XPUs, mit NVLink Fusion kompatible Scale-up-Netze und Siliziumphotonik-Technologie bereitstellen, während NVIDIA weiterhin NVLink, Vera, ConnectX, BlueField, Spectrum-X und andere Produkte anbietet.
Noch dramatischer ist, dass sogar NVIDIAs Wettbewerber sich entschieden haben, "zu kapitulieren".
Am 10. September 2026 gab d-Matrix, ein Hersteller von KI-Inferenzchips, der zu den typischen Herausforderern von NVIDIA gehört, den Beitritt zum NVLink-Fusion-Ökosystem von NVIDIA bekannt. Nach den von beiden Seiten veröffentlichten Plänen wird das nächste XPU-Modell Raptor von d-Matrix direkt in die Rack-Ebene-Infrastruktur von NVIDIA eingebunden und bildet zusammen mit Vera-CPU, NVLink-Switch, BlueField-4-DPU, ConnectX-9-SuperNIC und Spectrum-X-Ethernet ein vollständiges System. Die ersten entsprechenden Systeme werden voraussichtlich ab 2027 bereitgestellt. Im Jahr 2025 schloss d-Matrix eine Finanzierungsrunde in Höhe von 450 Millionen US-Dollar ab und erreichte eine Bewertung von 2 Milliarden US-Dollar.
Warum schließt sich ein Chiphersteller, der versucht, NVIDIA Marktanteile im KI-Rechengeschäft abzunehmen, freiwillig NVIDIAs NVLink an?
Weil NVLink Fusion so viele Vorteile bietet: Ein ausgereiftes Scale-up-Netz, das nicht neu entwickelt werden muss; ausgereifte Racks, wobei MGX bereits in großem Umfang bereitgestellt wird; eine ausgereifte Lieferkette, in der Stromversorgung, Flüssigkühlung, Hauptplatinen, Switches und Gehäuse bereits von Dritten hergestellt werden; ein ausgereiftes Rechenzentrums-Bereitstellungssystem, das Kunden bereits gut kennen; und vor allem eine kürzere Markteinführungszeit, was für Startups besonders entscheidend ist.
Daher habe ich zusammengefasst, dass das von NVIDIA derzeit explizit aufgelistete NVLink-Fusion-Ökosystem bereits Folgendes umfasst: (1) CPU-Lager: Arm, Intel, Fujitsu, SiFive; (2) ASIC/Custom-Silicon-Lager: Alchip, Astera Labs, GUC, Marvell, MediaTek, Samsung, AWS, d-Matrix; (3) EDA/IP-Bereich: Cadence, Synopsys; (4) Optische Vernetzung-Lager: Ayar Labs, Lightmatter, Marvell.
Aus der Liste von NVLink Fusion können wir auch ein Phänomen erkennen: Viele dieser Unternehmen sind auch bei UALink. Der tatsächliche Zustand der Branche ist also, dass Chiphersteller "auf zwei Pferde setzen", was der Geschichte von PCIe, CXL und Ethernet ähnelt. Sie nehmen einerseits an UALink teil, um ein offenes Ökosystem als Ersatz für NVLink aufzubauen; andererseits unterstützen sie aktiv NVLink Fusion.
Für diese Unternehmen ist das Gefährlichste nicht, zwei Standards gleichzeitig zu unterstützen. Sondern den falschen Standard zu setzen. Insbesondere für Anbieter von Schnittstellen-IP, Switch-Chips, optischer Vernetzung und EDA ist die sinnvollste Geschäftsentscheidung ohnehin: NVLink UND UALink, statt NVLink ODER UALink.
Zusammengenommen ist der Wettbewerb zwischen UALink und NVLink heute nicht mehr einfach ein Wettbewerb zwischen offen und geschlossen. Derzeit hat NVIDIA dank sechs Generationen der Weiterentwicklung und der tiefen Ausarbeitung von Chips bis zu Software einen enormen Vorsprung; während UALink zwar von Hunderten von Unternehmen unterstützt wird, seine groß angelegte kommerzielle Umsetzung aber noch auf das Zeitfenster von 2026 bis 2027 warten muss.
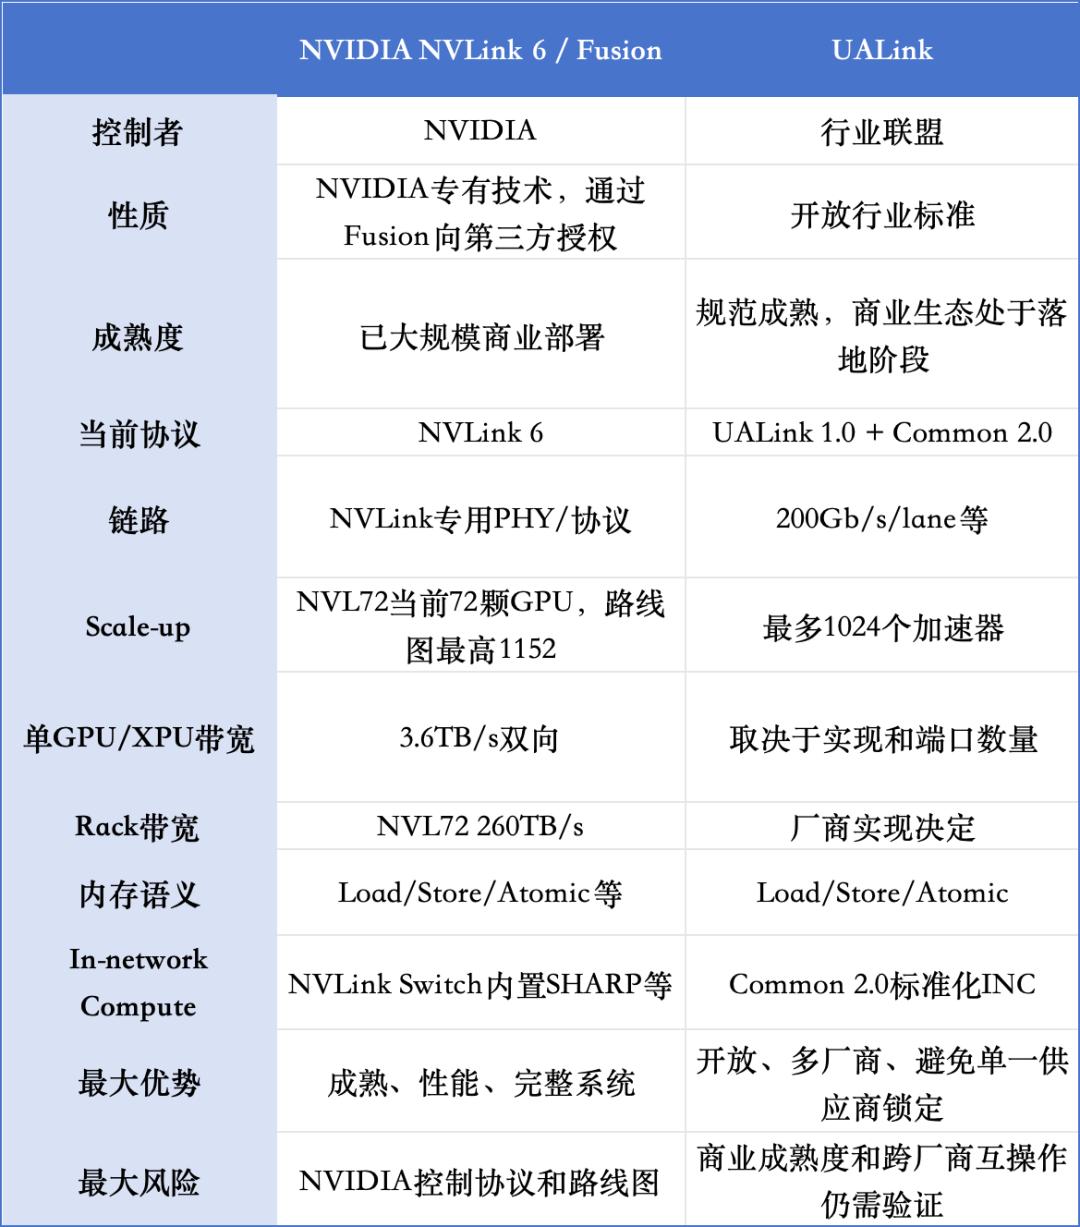
Kurzfristig geht es in diesem Krieg nicht darum, dass eine Seite die andere sofort vernichtet. Worauf es wirklich ankommt, ist: Ob UALink "Offenheit" zu einem tatsächlich einsetzbaren Mehrlieferanten-Ökosystem machen kann; und ob NVLink Fusion dieses Zeitfenster nutzen kann, um