Die KI-Giganten treten gemeinsam auf die Bremse, sind aber noch weit von der echten RSI entfernt.
Ist die KI an dem Punkt angelangt, an dem sie unbedingt langsamer werden muss?
In den letzten Tagen haben Anthropic und OpenAI nacheinander Signale ausgesandt, die das Tempo der Weiterentwicklung fortschrittlicher KI-Fähigkeiten verlangsamen sollen. Dies wird in der Branche als eine aktive Abkühlung der KI-Giganten im Silicon Valley angesichts von Sicherheitsrisiken angesehen. Der Sekundärmarkt reagierte als Erster: Technologieaktien und Halbleiteraktien gerieten gemeinsam unter Druck. Nvidia fiel zeitweise um mehr als 3 %, die Kursrückgänge von AMD, Intel und Micron lagen alle bei etwa 5 %, und der Philadelphia Semiconductor Index sank im Laufe des Tages um fast 6 %.
Was die Märkte besorgt, ist, dass die Schlüsselannahme, die die Erwartungen eines hohen Wachstums der KI-Infrastruktur stützt, neue Variablen erhält: Wenn diejenigen, die bisher ständig auf das Gaspedal der KI getreten haben, beginnen, aktiv über die „Bremse“ zu sprechen, ist die Wachstumslogik, dass „Modelle ständig stärker werden und die Kapitalausgaben für Rechenleistung, Chips und Rechenzentren stetig steigen“, nicht mehr so selbstverständlich.
Und der Ursprung dieser „Bremse-Theorie“ weist auf eine lange Zeit mit science-fiction-haftem Thema hin: Recursive Self-Improvement (im Folgenden RSI). Es stellt sich ein selbstevolutionäres Szenario vor, in dem eine KI beginnt, an der Verbesserung teilzunehmen oder sogar das nächste Generation ihres eigenen Systems zu konstruieren.
Im Jahr 2026 überschreitet RSI weiter den Rahmen der Futurologie und Sicherheitsdiskussion und wird zu einem Schlagwort in der akademischen Agenda, der technischen Praxis und der Finanzierungserzählung für Startups im KI-Bereich. Aber wenn wir uns von Emotionen lösen und zur Technik zurückkehren, was bedeutet die Selbstevolution der KI eigentlich? Auf welchem Stand hat die Selbstverbesserung der heutigen KI bereits erreicht, und wie weit ist sie von der echten RSI entfernt?
Wir haben uns mit Qu Ao, einem MIT-Doktorand und ehemaligem Mitglied des ByteDance Seed-Teams, der seit langem auf diesem Hauptpfad tätig ist, unterhalten. Im Folgenden sind seine Beobachtungen aufgeführt.
RSI ist ein technischer Schnittpunkt, aber derzeit nur ein Werbeslogan
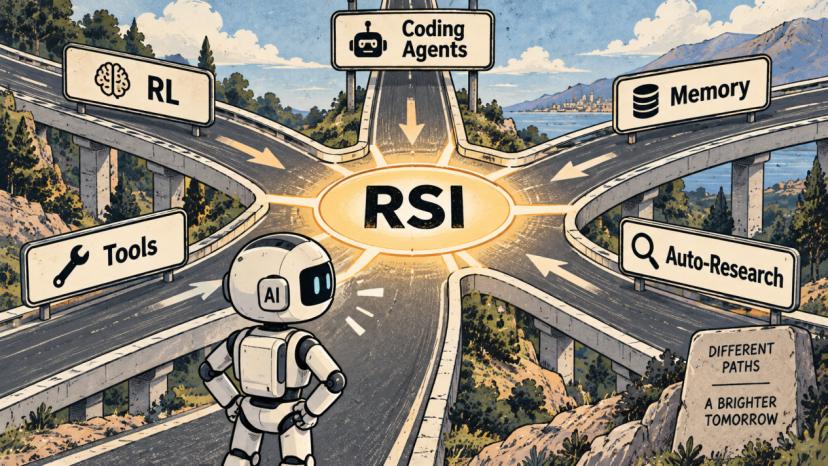
Wenn man nur das letzte halbe Jahr betrachtet, hat man das Gefühl, dass RSI plötzlich populär geworden ist. Aber wenn man den Zeitraum etwas ausdehnt, ist dies kein neues Problem, das 2026 aus dem Nichts entstanden ist. Es ist eher so, dass mehrere grundlegende Entwicklungslinien in den letzten Jahren sich stetig weiterentwickelt haben und heute in dieselbe Richtung zusammenlaufen.
1. Erst wenn kein Mensch mehr Code schreiben muss, hat RSI einen echten Ansatzpunkt
Ich habe 2019 angefangen, mich mit Reinforcement Learning (RL) zu befassen. Damals dachte ich, dass Reinforcement Learning näher an der „Intelligenz“ ist als die reine Verarbeitung natürlicher Sprache (NLP). Denn es geht darum, wie ein System mit der Umgebung interagiert, Feedback erhält und dann sein eigenes Verhalten ändert. Aber damals waren die Aufgaben, die man erledigen konnte, sehr begrenzt, und die Fähigkeiten der Modelle waren bei weitem nicht so gut wie heute.
Das Aufkommen von ChatGPT hat die Vorstellung der Menschen von den Grenzen der Fähigkeiten von Sprachmodellen neu definiert. Sprachmodelle haben einen größeren Aktionsraum (action space) erhalten, und zum ersten Mal spüren gewöhnliche Menschen, dass ein Modell ständig Anweisungen in natürlicher Sprache entgegennehmen und immer komplexere Aufgaben bearbeiten kann.
Danach wurde die reasoning-Fähigkeit (Schlussfolgerung) schrittweise weiterentwickelt. DeepSeek R1, dessen Fortschritt jeder deutlich spürt, ist ein sehr wichtiger Meilenstein. Es hat gezeigt, dass groß angelegtes Reinforcement Learning auf die Schlussfolgerung angewendet werden kann, und hat der Branche den Raum für Reinforcement Learning im Zeitalter großer Modelle erneut vor Augen geführt.
Später wurde diese Veränderung noch konkreter. Anthropics Opus 4.5 ist ein deutlicher Meilenstein. In diesem Stadium kann es bereits sehr lange kontinuierlich arbeiten. Viele Aufgaben, die früher manuell von Menschen zerlegt und wiederholt geändert werden mussten, können durch ständige Eingabe von Prompts und ständige Anpassungen schließlich erledigt werden. Man kann sogar sagen, dass es heute praktisch keinen Code mehr gibt, der nicht mit Prompts „geschrieben“ werden kann.
Diese Veränderung ist für die Selbstverbesserung (self-improvement) von entscheidender Bedeutung. Sobald ein Agent über ausreichend starke Programmierfähigkeiten und immer ausgereiftere Fähigkeiten zur Verwaltung von Kontexten verfügt, kann er lange Zeit an einer Aufgabe arbeiten und selbst den Zyklus aus Lesen von Code, Ändern von Code, Ausführen, Anzeigen der Ergebnisse und Fortsetzen der nächsten Runde abschließen. Viele Schritte, bei denen früher Menschen „eingreifen“ mussten, können nun in demselben Agenten-Loop selbst abgeschlossen werden.
Die Kontextverwaltung wird in diesem Prozess auch von einer „externen Fähigkeit“ allmählich zu einer nativen Fähigkeit des Agenten. Er kann sich merken, wo er aufgehört hat, immer längere Aufgaben verwalten, und in Kombination mit Werkzeugen und Codeausführung werden Langzeitaufgaben erst machbar.
Meiner Meinung nach ist die wichtigste Veränderung im Jahr 2026, dass die KI nun die Voraussetzungen hat, kontinuierlich an einer Sache zu arbeiten – das ist auch die Voraussetzung dafür, dass die Selbstverbesserung wirklich vom Konzept zu einem technischen Problem wird.
2. Was heute funktioniert, ist nur der „lokale Zyklus“ von RSI
Genau in diesem Prozess habe ich begonnen, die scheinbar verstreuten Forschungsrichtungen der letzten Jahre neu zu betrachten.
Eine Linie ist die KI-gesteuerte Entdeckung (AI for discovery), die später zur automatisierten Forschung (auto-research) führte, bei der der Agent selbst Lösungen vorschlägt, Experimente durchführt und dann auf Basis der Ergebnisse weiter forscht.
Die andere Linie dreht sich darum, „wie man den Agenten immer fähiger macht“, also das Gedächtnis zu verbessern, Werkzeuge zu erstellen, Fähigkeiten anzusammeln oder den gesamten Harness zu optimieren – also das Arbeitsframework, auf das der Agent bei der Arbeit angewiesen ist.
Mein eigener Forschungspfad erstreckt sich tatsächlich über diese beiden Linien: von Reinforcement Learning und Agenten-Gedächtnis bis hin zur automatisierten Forschung mit mehreren Agenten (multi-agent auto-research). Als wir CORAL entwickelten, zögerten wir sogar, ob dies zur „automatisierten Forschung“ oder zur „Evolution des Agenten-Arbeitsframeworks“ (harness evolution) gehört.
Deshalb denke ich jetzt über RSI, dass es zwar ein Buzzword ist, aber tatsächlich viele Dinge miteinander verbindet. Was früher wie verschiedene Schulen aussah, bekommt jetzt einen gemeinsamen Koordinatenpunkt, wenn es in das Framework „Wie nimmt KI an der Konstruktion der nächsten KI-Generation teil“ eingeordnet wird.
Aber hier müssen wir zwei Konzepte klar trennen. Das meiste, was wir heute sehen, ist tatsächlich kontinuierliche Selbstverbesserung (continual self-improvement): Die KI sammelt Erfahrungen in der ständigen Interaktion mit der Umgebung, den Benutzern und Aufgaben und nutzt diese Erfahrungen zur Selbstaktualisierung. Was sie aktualisiert, müssen nicht nur die Modellparameter sein, sondern kann auch das Gedächtnis, Prompts, Werkzeuge, Fähigkeiten oder sogar der gesamte Harness umfassen.
Die streng definierte RSI geht noch einen Schritt weiter. Eine ihrer ideellen Quellen geht auf I. J. Goods ultraintelligente Maschine (ultraintelligent machine) zurück, die in den 1960er Jahren vorgeschlagen wurde: Wenn eine Maschine beginnt, an der Konstruktion der nächsten Maschinengeneration teilzunehmen, und die nächste Generation wiederum eine stärkere Generation erzeugen kann, kann der Fähigkeitszuwachs in einen rekursiven Beschleunigungsprozess eintreten.
Mit anderen Worten: Sich durch wiederholte Erfahrungen „stärker zu schmieden“ ist nur der Ausgangspunkt von RSI. Darüber hinaus muss die KI auch an der Konstruktion und dem Training teilnehmen und sogar die nächste Generation ihrer selbst bauen.
Sie kann den Harness ändern, den Trainingsablauf anpassen, Trainingsdaten generieren, oder noch tiefer gehen, GPU-Kernel schreiben und sogar an der Konstruktion der nächsten Hardware-Generation teilnehmen. Je vollständiger wir die „Maschine“ definieren, desto höher ist die Schwelle für RSI.
Meinem Verständnis nach sind viele praktische Umsetzungen heute besser als kontinuierliche Selbstverbesserung zu bezeichnen. Für die streng definierte RSI ist noch ein langer Weg zu gehen.
Bei der Entwicklung von Reef bevorzugen wir auch den Begriff „Verbesserung“ (improve) statt „Evolution“ (evolve). Denn letzterer bedeutet nur, dass „es sich verändert hat“. Aus technischer Sicht interessieren wir uns mehr für eine andere Sache: Woher weiß man, dass es wirklich besser geworden ist?
Die KI kann sich natürlich ständig verändern, aber Veränderung an sich hat keinen Sinn. Sie kann schlechte Erfahrungen lernen oder einen zufälligen Erfolg als Regel auffassen. Genau wie Menschen „dessen Freund rot ist, wird rot; dessen Freund schwarz ist, wird schwarz“ – verhält sich auch das Modell. Man darf es nicht einfach „willkürlich evolvieren“ lassen.
Erst wenn die KI die Arbeit erledigt hat, beginnt sie wirklich, Fähigkeiten zu erwerben
1. Auch wenn sie lange arbeitet: Ohne Lernen ist es nur „spontane Leistung“
Wie bereits erwähnt, hat sich meine Forschung vom Gedächtnis bis hin zur automatisierten Forschung mit mehreren Agenten entwickelt. In diesem Prozess wird ein Problem immer deutlicher: Der Agent kann im Kontext immer fähiger werden, aber diese Verbesserung hat eine Obergrenze.
Später haben wir CORAL entwickelt, damit mehrere Agenten selbst forschen, Informationen austauschen und Lösungen iterieren. In der Anfangsphase konnten die Effekte durch die Evolution von Kontext, Gedächtnis und Harness sehr hoch getrieben werden; aber sobald die Aufgaben länger werden, gerät das System allmählich ins Stocken.
Ein intuitives Problem ist: Der Agent erledigt viele Dinge und sammelt viele Erfahrungen, aber das Modell selbst hat dadurch keine neuen Fähigkeiten erworben.
Es kann sich merken, wo es diesmal Fehler gemacht hat, mehrere Werkzeuge mehr aufrufen und den Arbeitsablauf reibungsloser gestalten. Aber nach Abschluss der Aufgabe verbleiben diese Erfahrungen größtenteils im Kontext und im Gedächtnis und gelangen nicht wirklich in das Modell. Das ist ein bisschen so, als würde eine Person bei einem Projekt durch Notizen immer geübter, aber nach Abschluss des Projekts bleibt nicht viel im Gedächtnis zurück. Beim nächsten ähnlichen Problem muss man viele Schritte wiederholen.
Deshalb haben wir später begonnen, Testzeit-Training (test-time training), Testzeit-Reinforcement-Learning (test-time RL) und Selbst-Distillation zu erforschen. Wir wollten überprüfen: Können die Erfahrungen, die der Agent in echten Aufgaben gesammelt hat, wieder in das Modell eingelernt werden? Nach der Umsetzung haben wir festgestellt, dass dieser Weg tatsächlich einen Teil der Obergrenzen des reinen Inferenzbetriebs (pure inference) durchbrechen kann.
Dann tauchte ein weiteres Problem auf: Wenn der Agent in Zukunft jeden Tag in der realen Welt arbeitet und jeden Tag neue Erfahrungen sammelt, warum können diese Erfahrungen nur einmal verwendet werden?
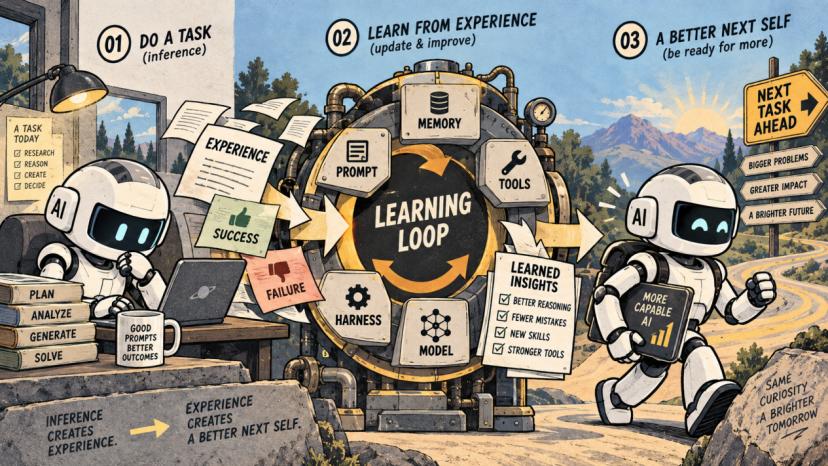
Die traditionelle Entwicklung großer Modelle durchläuft grob die Phasen Training (Train), Bewertung (Evaluate), Bereitstellung (Deploy) und Inferenz (Inference). In der Inferenzphase erledigt das Modell Aufgaben für Benutzer, aber die daraus entstehenden umfangreichen Erfahrungen werden normalerweise nicht automatisch in die nächste Lernrunde zurückgeführt.
Zum Beispiel: Wenn es heute wegen eines missverstandenen Bedarfs drei Mal nacharbeiten muss, wird es morgen bei einer ähnlichen Aufgabe nicht unbedingt schlauer sein, nur weil es heute drei Mal nachgearbeitet hat.
Reef soll das Problem lösen, diesen Weg wieder zu verbinden: Alles, was der Agent in der realen Welt getan hat, wo er Fehler gemacht hat und was von Benutzern korrigiert wurde, kann zu Material für die nächste Lernrunde werden.
Für die kontinuierliche Selbstverbesserung gilt also: Inferenz sollte nicht nur das Ende jeder Aufgabe sein, sondern auch der Ausgangspunkt für neue Erfahrungen. Jedes Mal, wenn die KI eine Sache erledigt, sammelt sie möglicherweise auch Erfahrungen für „die nächste Generation ihrer selbst“.
2. Damit die KI besser lernen kann, muss sie zuerst wissen, was „gut“ bedeutet
Der Schwierigkeitsgrad der Selbstverbesserung variiert stark zwischen verschiedenen Aufgaben.
Die einfachste Kategorie sind Aufgaben, bei denen das Ergebnis kaum umstritten ist, z. B. die Optimierung von GPU-Kerneln. Jedes Mal, wenn der Agent den Code ändert, kann er das Ergebnis direkt ausführen und überprüfen: Ist es schneller oder langsamer geworden? Wenn die Änderung die Leistung tatsächlich verbessert, ist dieser Weg lohnend, belohnt zu werden; wenn sie schlechter wird, bedeutet das, dass dieser Versuch nicht funktioniert hat. Wenn er das oft genug macht, lernt das Modell allmählich, welche Schreibweisen und Änderungen die Leistung eher verbessern.
Diese Art von Aufgabe ist relativ einfach zu bewältigen, weil die Überprüfungsstandards (verification) sehr klar sind. Schneller ist schneller, langsamer ist langsamer.
Etwas komplexer ist es, den Agenten ein „Unternehmen führen“ zu lassen. In der akademischen Welt gibt es einen interessanten Benchmark namens CEO Bench, der das Marktumfeld simuliert und die Fähigkeit des Agenten bewertet, betriebswirtschaftliche Entscheidungen zu treffen. Wenn wir solche Aufgaben ausführen und das Modell nicht aktualisieren, lassen einige Agenten das Unternehmen schließlich in den Konkurs treiben.
Aber im Gegensatz zu Kernel hinterlässt das Führen eines Unternehmens ständig Feedback: Nach dieser Entscheidung sind die Kunden mehr oder weniger geworden, ist der Kassenbestand gestiegen oder gesunken, lebt das Unternehmen weiter oder geht in den Konkurs. Der Agent muss die Ergebnisse nach