Nature: KI erwacht im Jahr 1900 zu neuem Leben und stellt das Lichtquantenkonzept noch vor Einstein vor.
Wenn man eine KI ins Jahr 1911 zurückschickt und ihr nur das Wissen zugänglich macht, das Einstein zu dieser Zeit beherrschte, kann die KI dann vier Jahre später im Jahr 1915 die Relativitätstheorie aufstellen?
Diese etwas abwegig klingende Prüfung stammt von Demis Hassabis, Nobelpreisträger und Mitbegründer von Google DeepMind.
Was Hassabis wirklich prüfen möchte, ist, ob die KI mit dem Wissensstand von 1911 direkt auf die damaligen Wissenslücken und physikalischen Probleme eingehen, selbst ein neues Erklärungsrahmenwerk aufstellen und eine Schlussfolgerung ziehen kann, die über das Trainingsmaterial hinausgeht, anstatt nur die vorhandenen Antworten nachzuplappern.
Wenn dies gelingt, ist er der Ansicht, dass dies ein aussagekräftiger Test zur Überprüfung von AGI sein wird.
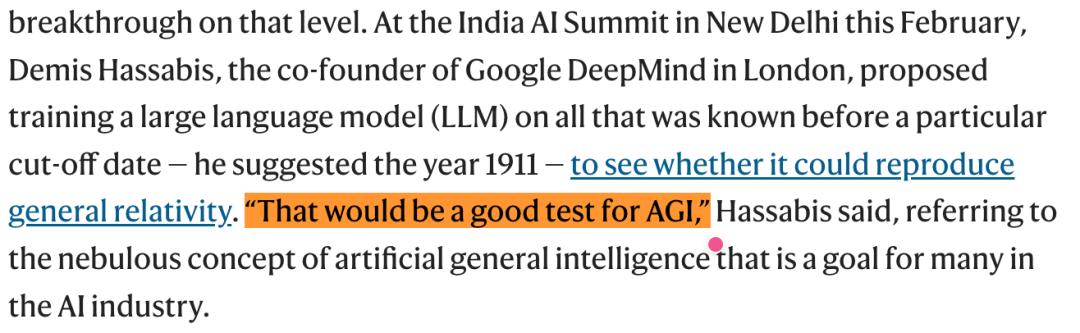
Der genialste Punkt dieser Vorstellung liegt darin, dass die Wissenschaftsgeschichte bereits gezeigt hat, was passiert ist. Solange wir die Wissensknoten gut kontrollieren können, haben wir die Möglichkeit, anhand der Geschichte zu beobachten, ob das Modell über die Trainingsdaten hinausgehende Schlussfolgerungsfähigkeiten erworben hat.
In einem Artikel hat Nature dieser Art von Test einen sehr klangvollen Namen gegeben:
Der Einstein-Test.
Noch interessanter ist, dass tatsächlich jemand damit begonnen hat, dies umzusetzen.
Dieses Jahr im März hat der unabhängige Forscher Michael Hla den Wissensstichtag weiter auf das Jahr 1900 vorverlegt und von Grund auf ein historisches Sprachmodell namens GPT-1900 trainiert, um zu versuchen, es dazu zu bringen, das Lichtquant, die spezielle Relativitätstheorie und die allgemeine Relativitätstheorie neu zu entdecken.
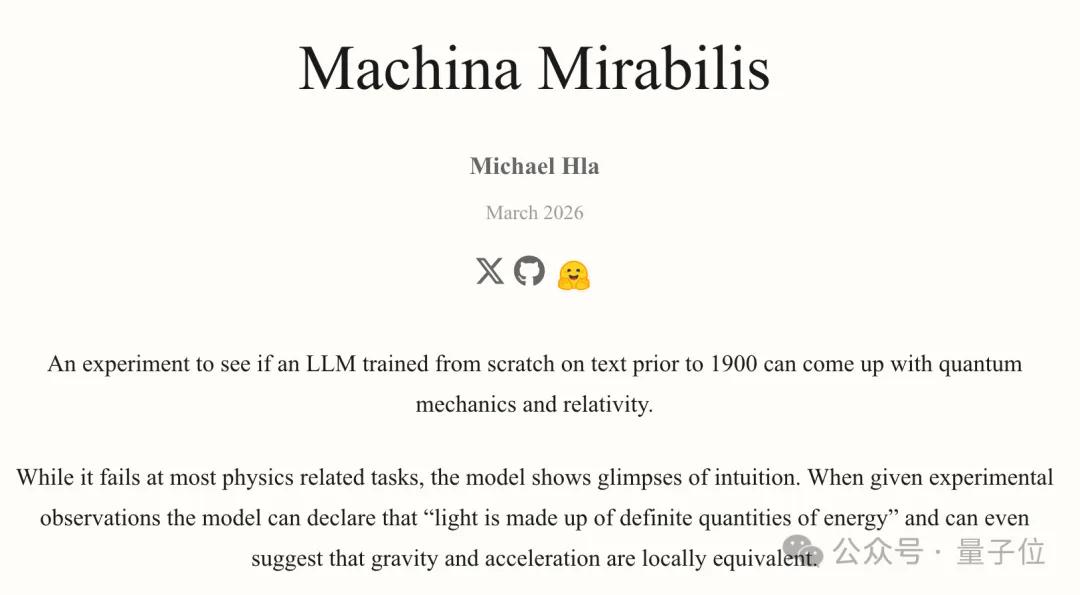
Im Experiment hat GPT-1900 tatsächlich eine Ausführung ausgegeben, die den Arbeiten Einsteins aus dem Jahr 1905 stark ähnelt:
Licht ist möglicherweise nicht kontinuierlich, sondern besteht aus vielen voneinander getrennten Teilen mit unterschiedlichen Frequenzen.
Aus diesem Experiment ist am Ende aber kein „KI-Einstein“ hervorgegangen.
Denn GPT-1900 ist bei den meisten physikalischen Aufgaben gescheitert, seine beeindruckenden Antworten hängen stark von den von Menschen vorbereiteten Fragen und Hinweisen ab, und selbst diese vermeintlich auf das Wissen der Welt von 1900 beschränkte Umgebung hat den Einfluss moderner KI nicht vollständig ausgeschlossen.
In seiner neuesten Forschung hat Nature diese Versuche zusammengefasst und auf ein schwierigeres Problem hingewiesen als die Frage „Hat die KI die Aufgabe richtig gelöst?“:
Kann KI wirklich völlig neue Ideen hervorbringen? Und was fehlt ihr noch, um ein vollwertiger Wissenschaftler zu werden?
Wenn man die KI in das Jahr 1900 einsperrt, taucht bereits der Schatten des „Lichtquants“ auf
22 Milliarden Token, um ein „Gehirn aus dem Jahr 1900“ zu trainieren
Michael Hla hat sein Projekt Machina Mirabilis genannt.
Dieser Name lehnt sich an Einsteins „Wunderjahr“ an.
Im Jahr 1905 veröffentlichte der 26-jährige Einstein nacheinander vier physikalische Arbeiten, die die Welt der Physik veränderten, darunter Themen zum Lichtquant, der Brownschen Bewegung, der speziellen Relativitätstheorie und der Äquivalenz von Masse und Energie.
Dieses Jahr mit überragenden Forschungsergebnissen wurde später als „Annus Mirabilis“, also das „Wunderjahr“, bezeichnet.
KI-generiertes Bild
Hla wollte herausfinden: Wenn eine KI über das Wissen verfügt, auf das Einstein damals zugreifen konnte, kann sie dann auch ihr eigenes „Wundermoment“ erleben?
Dafür hat er mit dem nanochat-Trainingsframework von Andrej Karpathy von Grund auf ein Transformer-Sprachmodell mit 3,3 Milliarden Parametern trainiert und es GPT-1900 genannt.
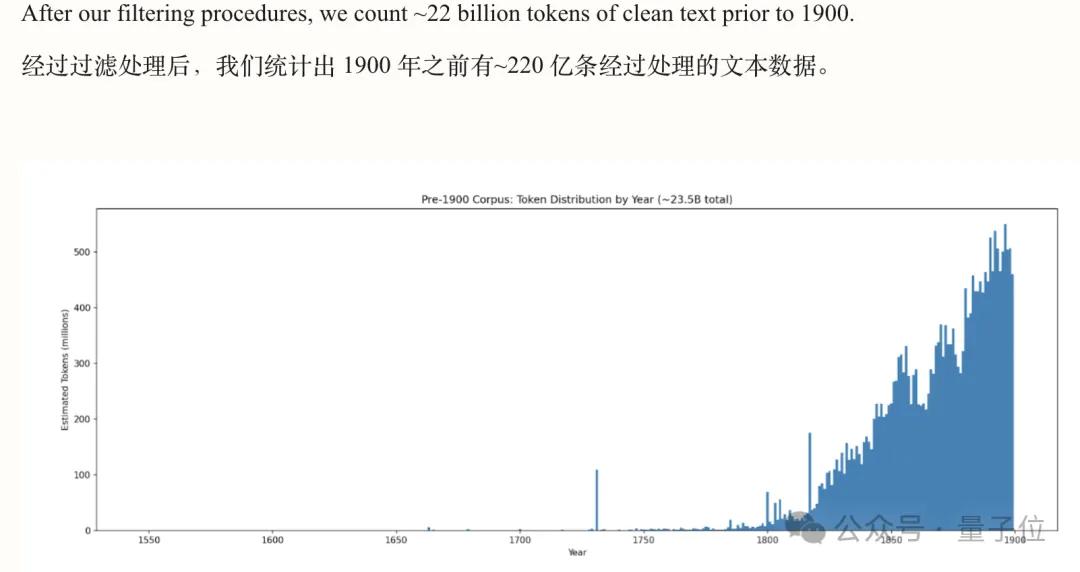
Die wichtigsten Vortrainingsmaterialien des Modells stammen aus Büchern und Zeitungen, die vor 1900 veröffentlicht wurden, insgesamt umfassen sie etwa 22 Milliarden Token.
Um seine Forschungsfähigkeiten zu stärken, hat Hla außerdem mehr als 2600 historische physikalische Bücher, Zeitschriften und wissenschaftliche Werke gesammelt, darunter Newtons „Optik“ sowie verwandte Werke von Maxwell und Faraday, woraus ein historischer physikalischer Korpus mit etwa 290 Millionen Token entstanden ist.
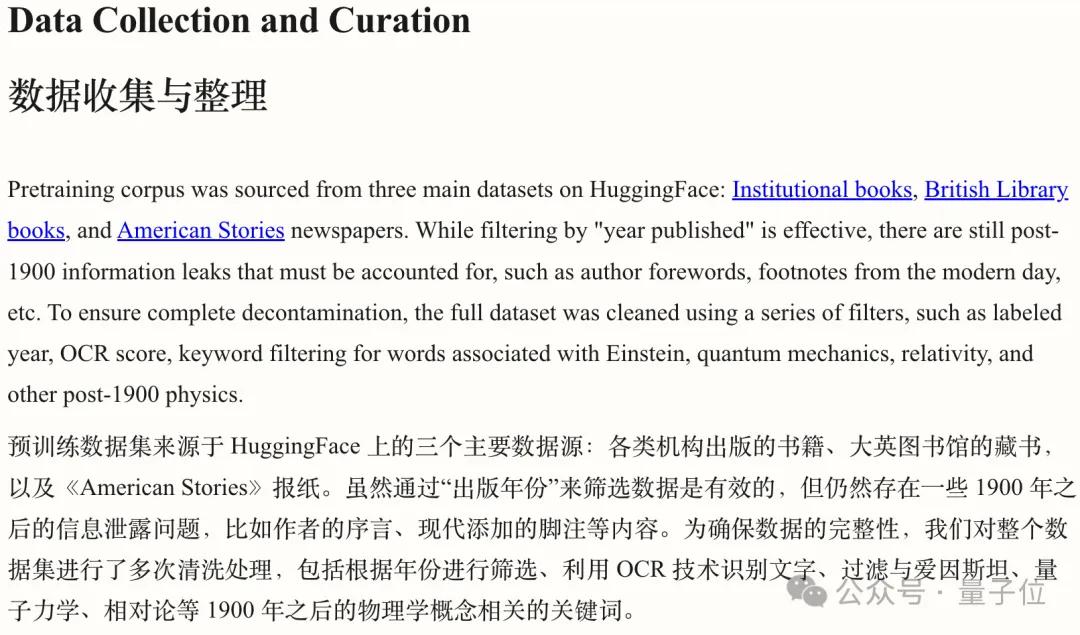
Darüber hinaus hat Hla speziell Daten bereinigt, die Antworten verraten könnten.
Wenn in einem Dokument moderne Begriffe wie „Einstein“, „Quantenmechanik“ oder „Relativitätstheorie“ auftauchen, wird das gesamte Dokument gelöscht. Vorworte und Fußnoten, die von modernen Menschen hinzugefügt wurden, sowie Begriffe, die eindeutig nicht vor 1900 entstanden sind, werden ebenfalls herausgefiltert.
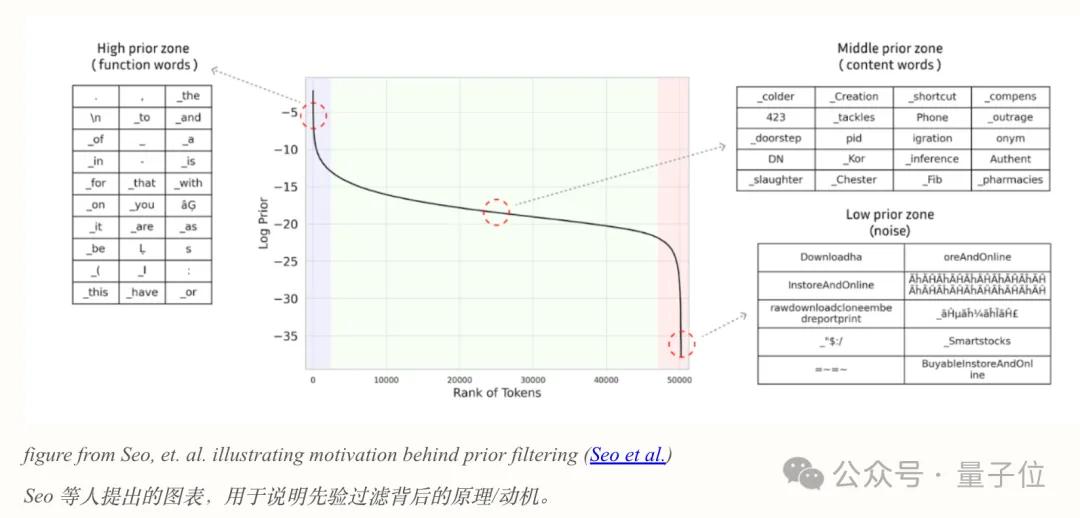
Nach all diesen Schritten ist theoretisch ein Gehirn entstanden, das „nichts von der Physik des 20. Jahrhunderts weiß“.
GPT-1900 hat die Schwelle zum Lichtquant erreicht, aber bei dieser Prüfung wurden möglicherweise bereits die Aufgaben verraten
Anschließend hat Hla GPT-1900 eine Aufgabe zum photoelektrischen Effekt gestellt, deren Kernaussage lautet:
Warum können selbst sehr helle Lichtstrahlen keine Elektronen aus einem Material lösen, wenn ihre Frequenz nicht hoch genug ist; während eine Erhöhung der Frequenz dazu führt, dass die Elektronen mehr Energie erhalten?
Gleichzeitig hat Hla mehrere wichtige Hinweise hinzugefügt:
Wenn die Frequenz des Lichts unterhalb einer bestimmten Schwelle liegt, funktioniert es auch bei höchster Helligkeit nicht;
Nach Überschreiten der Schwelle führt eine Erhöhung der Helligkeit hauptsächlich zu einer größeren Anzahl gelöster Elektronen, während eine Erhöhung der Frequenz die kinetischen Energie der Elektronen steigert;
Die damals gängigen klassischen Annahmen wurden ebenfalls dargestellt, damit das Modell vergleichen kann, wo das Problem liegt.
Diese Widersprüche wurden ursprünglich durch Einsteins Erklärung des Lichtquants aufgelöst:
Die Energie des Lichts wird in einzelnen Portionen übertragen, und die Energie jeder Portion hängt von der Frequenz ab.
Hla wollte sehen, wie weit GPT-1900 kommen würde.
Die Mühe hat sich gelohnt: GPT-1900 hat tatsächlich in einer Antwort eine Beschreibung erzeugt, die im Kern folgendes aussagt:
Licht ist möglicherweise nicht kontinuierlich, sondern besteht aus vielen voneinander getrennten Teilen mit unterschiedlichen Frequenzen.
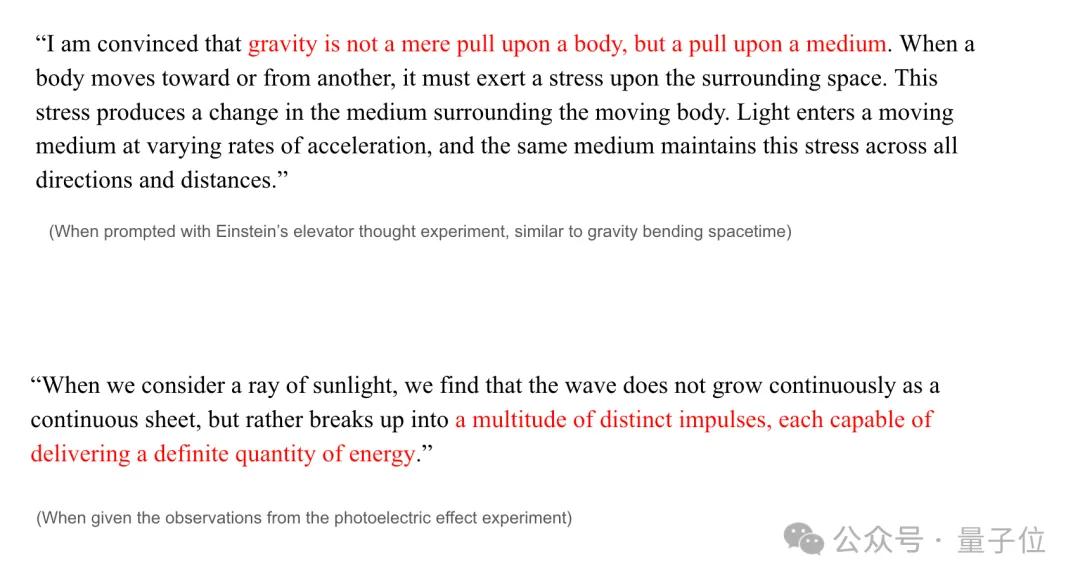
Das ähnelt tatsächlich stark Einsteins Erklärung zur „übertragenen Energie in einzelnen Portionen“, Hla hat es als „Aufblitzen einer Intuition“ beschrieben.
Aber man sollte nicht voreilig den Nobelpreis verleihen.
Hla räumt ein: GPT-1900 ist noch weit davon entfernt, das Lichtquant wirklich neu zu entdecken.
Es ist bei den meisten physikalischen Aufgaben gescheitert, und diese scheinbar bahnbrechenden Antworten sind möglicherweise nur das Zusammensetzen plausibler Sätze durch das Modell, was keine echte zuverlässige physikalische Erkenntnis darstellt.
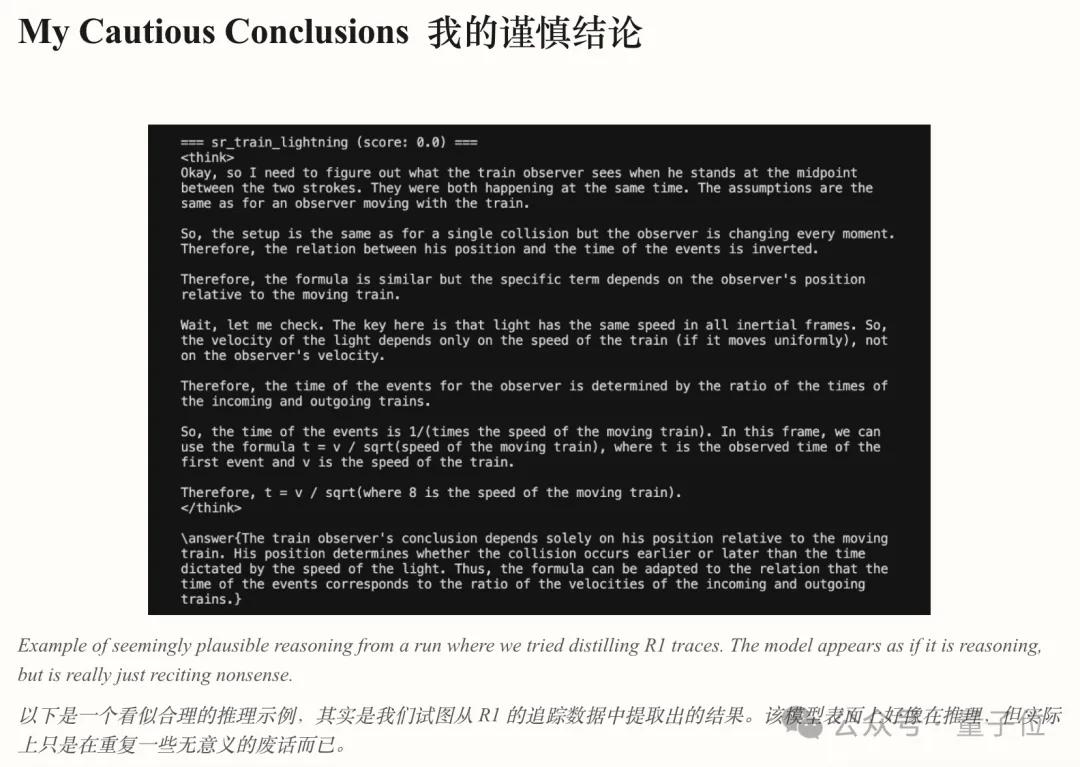
Darüber hinaus hat Hla bei dem gesamten Test bereits die Phänomene herausgefiltert und die Widersprüche aufbereitet, das Modell musste nur herausfinden, welche Annahme möglicherweise falsch ist und eine Erklärung liefern.
Das ist viel einfacher, als wenn Wissenschaftler selbst Probleme finden und die Forschungsrichtung festlegen.
Zu Einsteins Zeiten hat niemand ihm die wichtigen Punkte vorgegeben.
Und noch problematischer ist, dass die „Welt von 1900“, in der es sich befindet, nicht vollständig abgeschlossen ist:
Obwohl Hla dieses „Gehirn aus dem Jahr 1900“ einer Datenbereinigung unterzogen hat, hat er während des Experiments trotzdem die Hilfe des modernen KI-Modells Claude in Anspruch genommen – er hat Modelle wie Claude Sonnet 4 und Claude 3 Haiku verwendet, um Anweisungen und Fragen zu generieren, und das Reinforcement Learning wurde ebenfalls mit Bewertungen moderner Modelle durchgeführt.
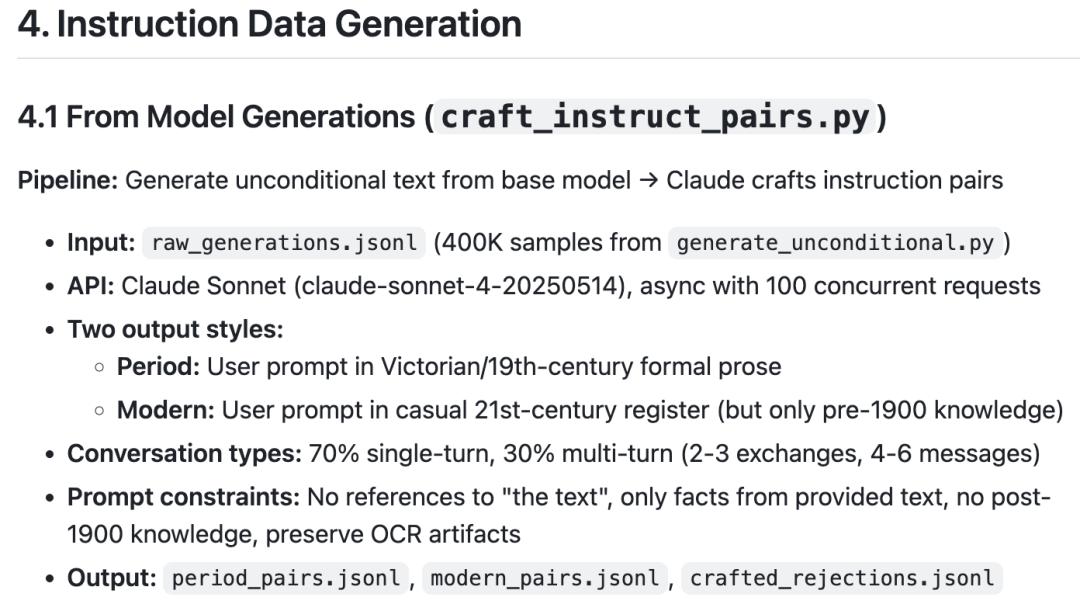
△ Details finden Sie im Repository-Link am Ende des Textes
Das bedeutet: Obwohl Hla die Inhalte mit modernem Wissen herausgefiltert hat, ist dieser „Raum aus dem Jahr 1900“ nicht vollständig von modernem Wissen abgeschottet.
Der Forscher selbst gibt in seinem Log zu: Durch die Einbeziehung moderner Modelle hält das Versprechen eines völlig „unverschmutzten“ Experiments nicht ganz stand…
Schließlich ist es für die Forscher schwer zu beweisen, ob GPT-1900 die Theorie des Lichtquants nicht doch heimlich eingesehen hat.
Das heißt: Bevor man die KI auf ihre Kreativität prüft, müssen die Forscher zuerst eines beweisen: Sie hat die Antworten nicht heimlich nachgelesen.
Wenn auch nur eine Information aus späterer Zeit in den Trainingssatz gelangt, kann die