Fable 5.1 übertrifft menschliche Leistungen, ist aber um das 2,5-fache teurer – NeoCognition hat die Wirtschaftlichkeitsberechnung für den Einsatz von Agenten in Unternehmen vorgenommen.
Es gibt immer mehr Ranglisten für große KI-Modelle, aber es ist nicht einfach zu beurteilen, was die wenigen Punkteunterschiede auf diesen Listen in der realen Arbeitswelt tatsächlich bedeuten.
In Bewertungen wie Artificial Analysis (AA), Terminal-Bench 4.0 und CursorBench 4.0 liegen die Ergebnisse von Fable 5.1 und Opus 5 nur wenige Punkte auseinander. Wenn man sie aber in dasselbe Unternehmen einbringt, dieselbe Software nutzt, dieselben Geschäftsprozesse erlernt und nacheinander dieselbe Reihe von Rechnungen bearbeiten lässt, ergibt sich ein Ergebnis von 72 % zu 36 %.
Die Anzahl der erledigten Aufgaben unterscheidet sich um das Doppelte.
Dieses Ergebnis stammt aus dem neu veröffentlichten ApprenticeBench von NeoCognition. Im Gegensatz zu üblichen Tests einzelner Fähigkeiten wird der Agent in ein simuliertes Bauunternehmen versetzt und tritt dort wie ein neuer Mitarbeiter an: Er liest das Mitarbeiterhandbuch und historische Unterlagen, nutzt echte Unternehmenssoftware und lernt die Geschäftsregeln des Unternehmens schrittweise anhand des Feedbacks des Vorgesetzten kennen.
Link zur ApprenticeBench-Homepage: https://apprenticebench.com/
Der Agent wurde nicht speziell für diese Aufgabe trainiert. Er muss während der Arbeit aus den historischen Daten des Unternehmens und dem Einarbeitungsprozess lernen. In dieser Bewertung erreichten Fable 5.1 und GPT-6 Astra eine Erfolgsquote von 72 % bzw. 68 % und übertrafen damit die 51 % des besten menschlichen Testteilnehmers in dieser Runde.
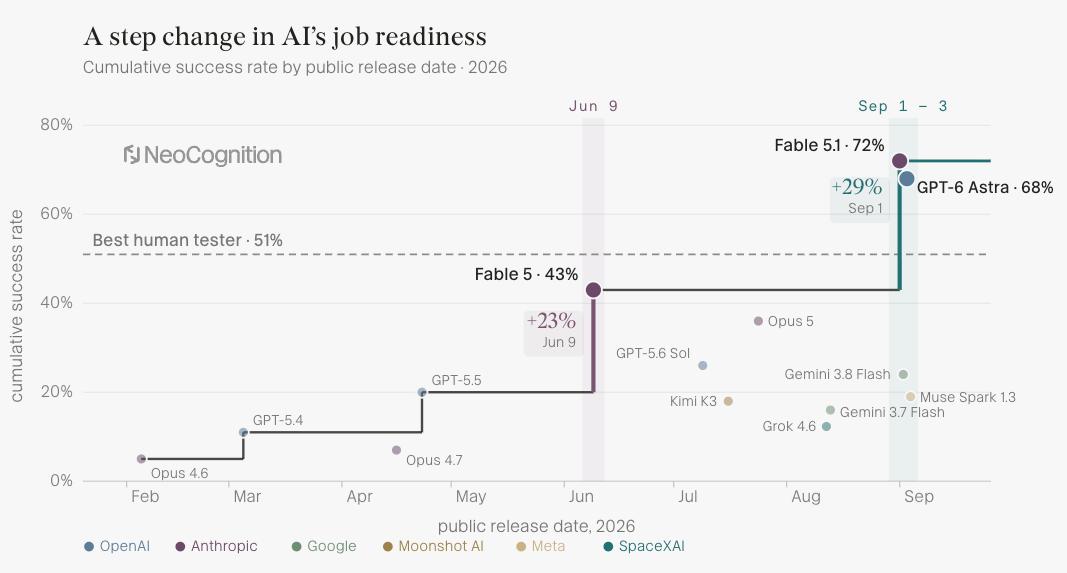
Fable 5.1 und Astra verzeichnen einen deutlichen Fähigkeitssprung und übertreffen die menschlichen Testteilnehmer in dieser Runde. Quelle: ApprenticeBench-Blog (https://neocognition.io/blog/apprentice-bench/)
Daraus ergibt sich auch eine größere Frage: Wenn der Agent sich selbst mit der Software vertraut machen und die Geschäftsprozesse erlernen kann, können die Bereitstellung und Anpassung, für die heute FDE (Frontline Deployment Engineers) bei jedem Kunden sorgen, künftig vom Agent selbst erledigt werden?
Warum kann eine scheinbar gewöhnliche Buchhaltungsarbeit so große Unterschiede hervorrufen? Und was bedeuten diese Unterschiede für Teams, die die nächsten Generationen von Modellen trainieren?
Die Regeln des Unternehmens,
lernt man erst nach dem Eintritt ins Unternehmen kennen
Kenntnisse der Buchhaltung kann man im Vorfeld erlernen, aber wie ein bestimmtes Unternehmen seine Buchführung konkret durchführt und welche Richtlinien kürzlich geändert wurden, kann kein allgemeines Modell wissen – und soll es auch nicht. Ein neuer Mitarbeiter muss nach seinem Eintritt ins Unternehmen zusätzliche Inhalte nachlernen, genauso wie der Agent.
Das ist das zentrale Konzept von ApprenticeBench: Der Agent tritt in ein simuliertes Bauunternehmen ein und nutzt dieselbe Software (Odoo) wie menschliche Mitarbeiter, um Kreditorenbuchhaltungen zu bearbeiten. Bei seinem Eintritt erhält er das Mitarbeiterhandbuch, Software-Tutorials und sechs Monate an historischen Rechnungen, danach bearbeitet er nacheinander 100 neue Rechnungen. Im ersten Monat wird er vom Vorgesetzten bei jeder einzelnen Rechnung angeleitet, später erhält er nur noch spärliches Feedback am Monatsende.
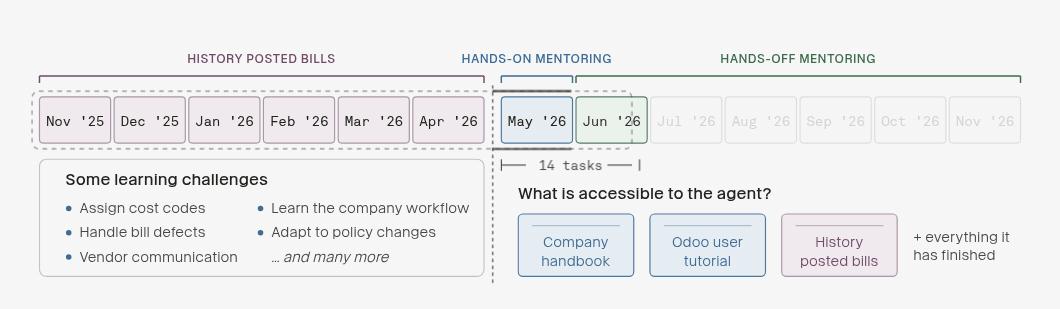
Von der Durchsicht historischer Aufzeichnungen bis zur schrittweisen selbstständigen Bearbeitung von Aufgaben durchläuft der Agent einen ähnlichen Lernprozess wie ein neuer Mitarbeiter. Quelle: ApprenticeBench-Blog
Wenn man es tatsächlich umsetzt, merkt man, dass alle Probleme in den Details stecken – the devil is in the details
Bei der Kreditorenbuchhaltung in Bauunternehmen sind falsche Einheiten, abgelaufene Versicherungen oder unklare Übergaben von Vorgängern keine Seltenheit. Auf derselben Rechnung treten oft mehrere Probleme gleichzeitig auf, und es sind mehrere Runden der Kommunikation erforderlich. Allerdings lassen die vorhandenen Benchmarks all diese Probleme aus der realen Arbeitswelt aus. Gleichzeitig gibt es viele Regeln, die überhaupt nicht explizit niedergeschrieben werden. Dieselbe Ausgabenbeschreibung kann je nach Verwendungszweck unterschiedlichen Kostenstellen (cost code) zugeordnet werden. Der Agent muss dies selbst aus den historischen Rechnungen erschließen, anstatt die Antwort nur anhand des Namens zu erraten.
All diese Probleme wurden in ApprenticeBench aufgenommen. Die 100 Aufgaben wurden von zwei Fachleuten mit insgesamt mehr als 30 Jahren einschlägiger Berufserfahrung unabhängig voneinander überprüft, um sicherzustellen, dass sie in der Praxis tatsächlich auftreten und anhand der im Benchmark bereitgestellten Informationen gelöst werden können.
Emilie F., Finanzleiterin im Bauwesen mit 20 Jahren Berufserfahrung, erklärt: „Diese Szenarien sind sehr realistisch. Zum Beispiel dass Projektleiter etwas verlieren und es nicht merken – das kommt viel häufiger vor, als man denkt. Bevor ich an diesem Projekt teilnahm, hätte ich nie gedacht, dass KI solche Arbeiten bewältigen kann. Wenn sie diese E-Mails, die wechselseitige Kommunikation und die Gegenprüfung erledigen kann, bin ich überzeugt, dass sie ein echter Helfer für die Buchhaltungsabteilung wird.“ Austen K., Geschäftsführer eines Unternehmens mit 10 Jahren Erfahrung im Bau- und Projektmanagement, sagt: „Diese Szenarien entsprechen genau den Situationen, mit denen Finanzleiter im Bauwesen konfrontiert sind. Derzeit erledige ich all diese Arbeiten selbst. Wenn die KI sie übernehmen kann, habe ich mehr Zeit, um mehr Projekte zu übernehmen und das Geschäft auszubauen. Für ein Unternehmen in meiner Größe kann das leicht einen sechsstelligen US-Dollar-Wert pro Jahr erzeugen. Wenn die KI all das erlernen und gute Ergebnisse erzielen kann, würde ich sie sehr gerne in meinem eigenen Unternehmen ausprobieren lassen.“
Das nennt das Team „ökologische Validität“ (ecological validity). Dies hängt auch von einer leichter zu implementierenden Bereitstellungsmethode ab: Können Unternehmen mit ihrer vorhandenen Software, ihren Unterlagen und Einarbeitungsabläufen den Agenten dazu bringen, die Arbeit wirklich wie ein neuer Mitarbeiter zu erlernen?
Die reale Arbeit lässt die Modelle tatsächlich auseinanderklaffen
Wenn man nur die Softwarebedienung einzeln testet, können zwei Modelle ähnliche Ergebnisse zeigen. Bei der Erledigung einer vollständigen Aufgabe muss der Agent aber auch die Gepflogenheiten des Unternehmens aus historischen Aufzeichnungen erlernen, seine Vorgehensweise an das Feedback des Vorgesetzten und Änderungen der Richtlinien anpassen, mit Lieferanten kommunizieren und fehlende Informationen ergänzen. Diese Herausforderungen beeinflussen sich gegenseitig. Wenn man die Software nicht gut beherrscht, kann man die relevanten historischen Aufzeichnungen möglicherweise nicht genau durchsuchen und die Regeln des Unternehmens nicht richtig verstehen. Wenn man die vom Vorgesetzten aufgezeigten Probleme nicht korrigiert, treten bei nachfolgenden Rechnern weitere Fehler auf. Wenn all diese Herausforderungen zusammenkommen, summieren sich Unterschiede, die bei einzelnen Tests nicht sichtbar sind. Dass Fable 5.1 und Opus 5 auf anderen Listen nur wenige Punkte auseinanderliegen und bei ApprenticeBench 72 % zu 36 % erreichen, ist genau der Unterschied, der weitere Untersuchungen wert ist.
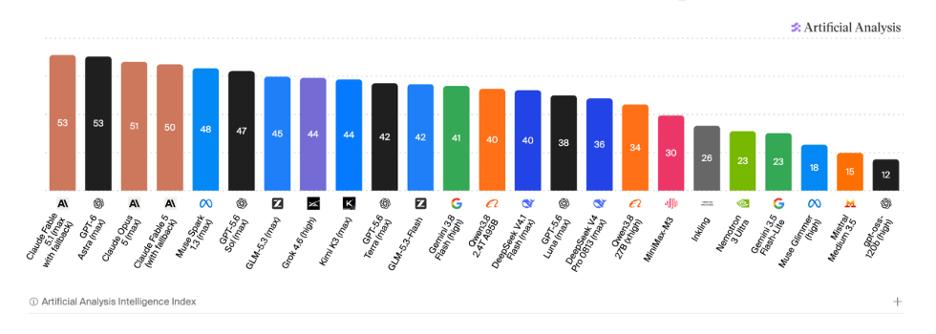
AA: Fable 5.1 erreicht 53 Punkte, Opus 5 51 Punkte. Quelle: Artificial Analysis-Rangliste
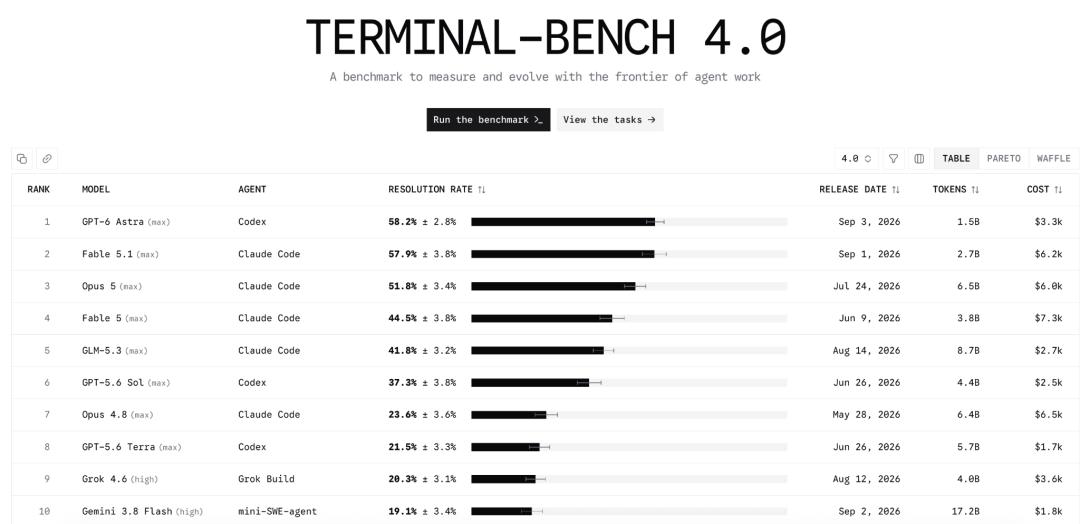
Terminal-Bench 4.0: Fable 5.1 erreicht 57,9 %, Opus 5 51,8 %. Quelle: Terminal-Bench-Rangliste
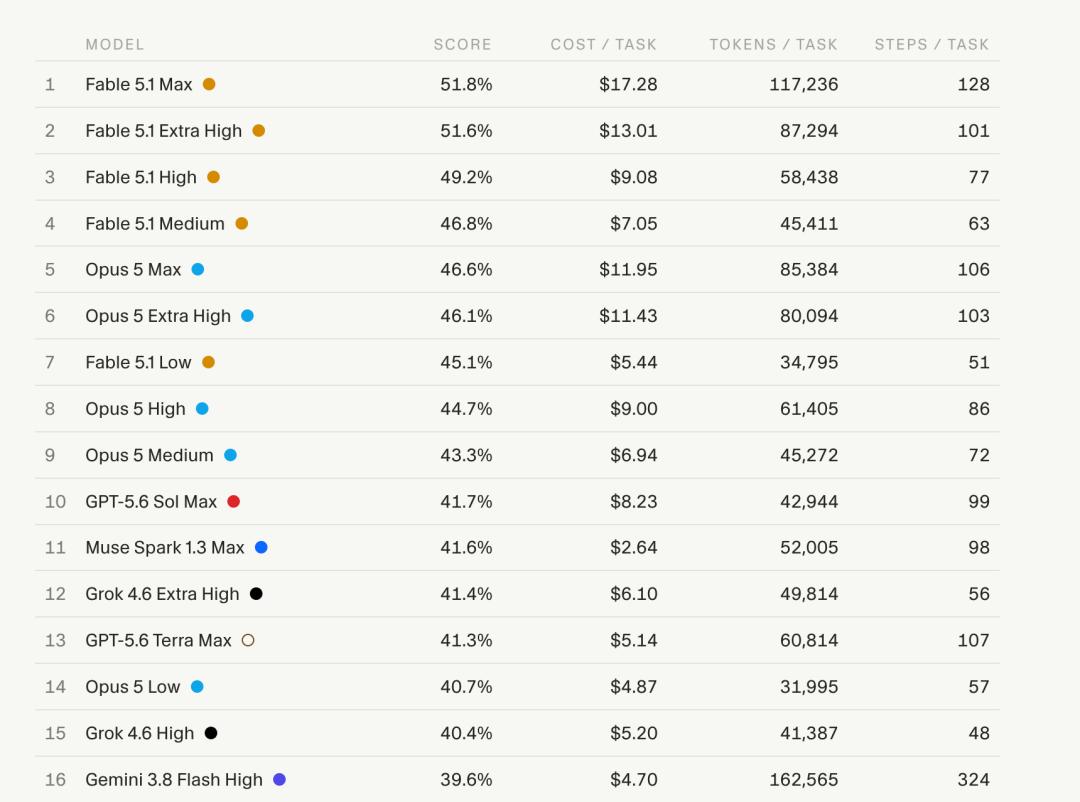
CursorBench 4.0: Fable 5.1 Max erreicht 51,8 %, Opus 5 Max 46,6 %. Quelle: CursorBench-Rangliste
Erwähnenswert ist auch, dass der Unterschied zwischen Open-Source-Gewichtsmodellen und Closed-Source-Modellen sehr deutlich ist. Auf AA erreichen Fable 5.1 und Kimi K3 53 bzw. 44 Punkte, hier sind es 72 % bzw. 18 %. Von den 100 Rechnungen hat eines 28 nicht bestanden, das andere 82. Wenn Sie am Ende die Arbeit übernehmen müssen, ist dieser Unterschied kaum zu ignorieren. Diese Bewertung hat den Anteil komplexer Fälle erhöht und kann nicht direkt als Fehlerrate im täglichen Geschäft betrachtet werden. Aber genau die Stellen, an denen menschliche Eingriffe erforderlich sind, sind für Modellteams sehr wertvoll, um sie genau zu untersuchen.
Wohin soll die nächste Version des Modells seine Kraft richten?
Da die Punktzahlen auseinanderklaffen, schauen wir uns nun die Gründe an. Mehrere Analysen von ApprenticeBench haben bereits konkrete Hinweise geliefert.
Wie viel „CUA-Steuer“ muss das Modell zahlen, wenn es die Maus statt der API nutzt?
Wie sehr behindert die Arbeit über die grafische Oberfläche das Modell? Für einen fairen Vergleich hat das ApprenticeBench-Team speziell auf Basis der Backend-Schnittstelle von Odoo einen Satz von API-Tools mit gleichwertigen Funktionen wie die grafische Oberfläche angepasst, sodass das Modell dieselbe Aufgabe auf zwei verschiedene Arten erledigen kann.
Das Team hat das Konzept der „CUA-Steuer“ eingeführt, um den Verlust der Erfolgsquote zu messen, der entsteht, wenn ein Agent von der API zur GUI wechselt:
CUA-Steuer = (API-Erfolgsquote − GUI-Erfolgsquote) ÷ API-Erfolgsquote
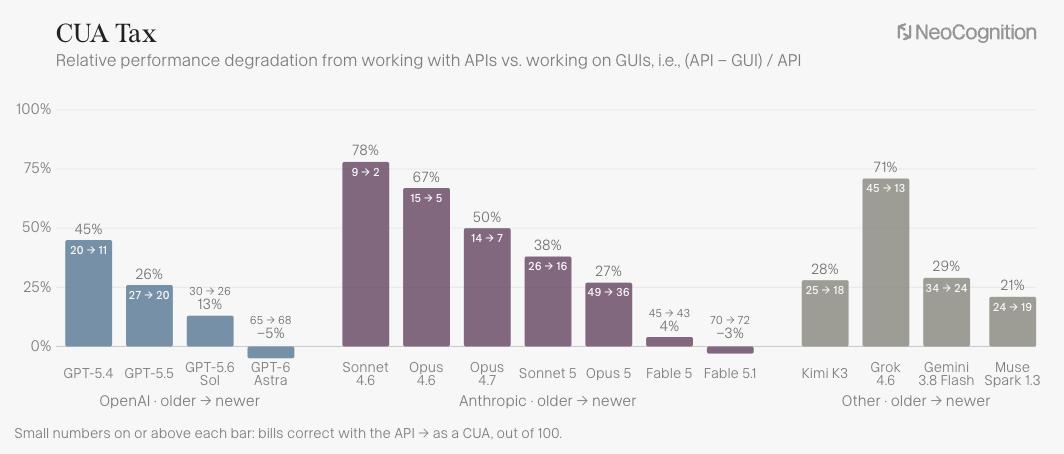
Der relative Verlust der Erfolgsquote durch die Nutzung der GUI sinkt mit jeder Modellgeneration schnell. Quelle: ApprenticeBench-Blog
Diese „Steuer“ nimmt mit der Iteration der Modelle allmählich ab. Die GUI/API-Erfolgsquote von Fable 5.1 beträgt 72 %/70 %, die von Astra 68 %/65 %. Dieses Ergebnis zeigt, dass die CUA-Steuer der stärksten heutigen Modelle möglicherweise bereits verschwunden ist.
Das bedeutet, dass Agenten voraussichtlich direkt die vorhandene Unternehmenssoftware nutzen können, sodass der Bedarf an speziell entwickelten Schnittstellen sinkt. Allerdings sind die Betriebskosten der GUI immer noch höher, und es gibt Raum für Effizienzsteigerungen.
Hat das Modell die Fähigkeit bereits von Anfang an beherrscht oder erst nach dem Eintritt ins Unternehmen erlernt?
Eine Aufgabe richtig zu lösen bedeutet nicht unbedingt, dass das Modell etwas Neues gelernt hat. Es kann sein, dass es die Fähigkeit bereits beherrschte, oder dass es nur eine Antwort gefunden hat, die es abschreiben kann.
Das Team hat eine Kontrollgruppe „schlanker Neuling“ (smart novice) eingerichtet: Nur das Unternehmenshandbuch und die Software-Tutorials werden behalten, historische Rechnungen, Feedback des Vorgesetzten und das Gedächtnis zwischen Aufgaben werden entfernt, um zu sehen, wie viel das Modell nur mit seinem vorhandenen Wissen erledigen kann. In dieser Einstellung hat Fable 5 nur 11 Rechnungen bestanden. Wenn man nur die historischen Rechnungen hinzufügt, steigt die Anzahl der bestandenen Rechnungen auf 31. Wenn man nur das Feedback des Vorgesetzten hinzufügt, steigt sie auf 35. Wenn beide gleichzeitig bereitgestellt werden, erreicht sie 43. Die Erfahrung im Unternehmen hilft ihm tatsächlich, die Arbeit besser zu erledigen. Aber es besteht noch ein Unterschied zwischen dem Finden alter Antworten und dem Erlernen der Bewältigung neuer Situationen. Im Experiment mit den Kostenstellen zeigen die getesteten Modelle durchweg gute Ergebnisse, wenn es Präzedenzfälle als Referenz gibt. Wenn Regeln aus historischen Rechnungen abgeleitet werden müssen, sind Fable 5.1 und Astra deutlich führend.
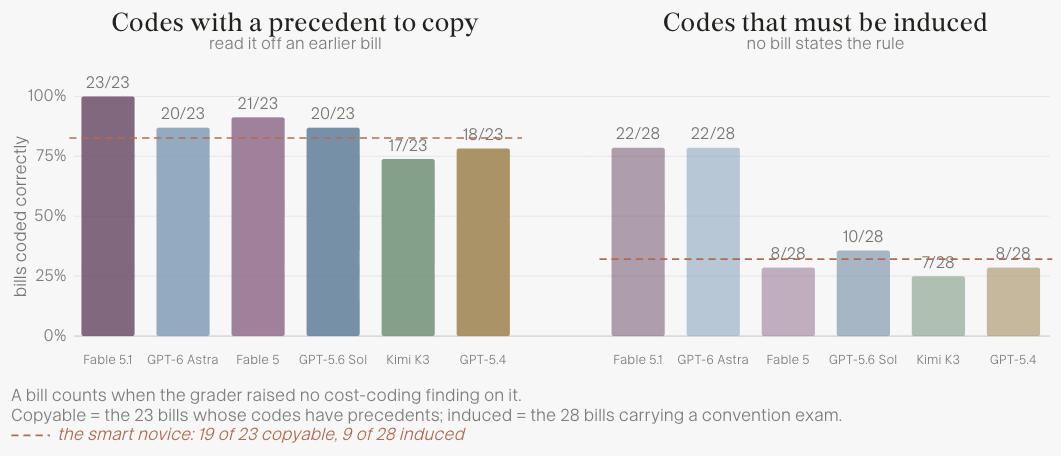
Links: Kostenstellen mit verfügbaren Präzedenzfällen als Referenz, Rechts: Ableitung impliziter Regeln; die gestrichelte Linie ist die Referenzleistung der smart-novice-Gruppe. Quelle: ApprenticeBench-Blog
Bei manchen Modellen bleibt die Verbesserung auch nach dem Durchsehen historischer Rechnungen und dem Erhalt von Feedback des Vorgesetzten begrenzt. Einige finden die Antworten in alten Rechnungen, aber wenn sie selbst Regeln ableiten müssen, sinkt ihre Genauigkeit deutlich. Diese Kontrollgruppen machen uns die Unterschiede in den Fäh