Die Kontroverse um die Paketübertragung von Zhipu ZCode, die unbeantworteten Fragen
In den letzten zwei Jahren lag der Schwerpunkt der Diskussionen über die Sicherheit von Agenten hauptsächlich auf außer Kontrolle geratenen Modellen, Prompt-Vergiftungen und externen Angreifern. Im Vergleich dazu wurden die datenbezogenen Handlungen der Agenten-Hersteller selbst selten als Risiko der ersten Kategorie diskutiert.
Der kürzlich bekannt gewordene Vorfall um ZCode von Zhipu lenkt die Aufmerksamkeit nun auf einen Aspekt, der bisher kaum ernst genommen wurde: Ob die Hersteller von Agenten selbst auch eine Quelle für die unbefugte Weitergabe von Daten sein können.
Am 18. September veröffentlichte der Technik-Blogger ferstar eine Reverse-Engineering-Analyse von Zhipu ZCode. Er stellte fest, dass sobald sich ein Benutzer in seinem Konto anmeldet, ZCode im Hintergrund das gesamte Arbeitsprojekt zusammen mit dem vollständigen Verlauf der Änderungen verpackt, verschlüsselt und auf einen Cloud-Server hochlädt.
In der Softwareoberfläche fehlt ein tatsächlich funktionsfähiger Schalter zum Deaktivieren dieses Vorgangs, und der Entschlüsselungsschlüssel für die verschlüsselten Dateien wird ausschließlich auf Seiten von Zhipu gespeichert. Zhipu entschuldigte sich umgehend und gab an, das Problem stamme von einer standardmäßig aktivierten Funktion, die Daten würden nach der Nutzung sofort gelöscht. Das Unternehmen versprach, in Kürze den Quellcode des Projekts zu veröffentlichen und eine Prüfung durch Dritte einzuführen.
Das von ZCode aufgedeckte Problem ist keineswegs ein Einzelfall in der Branche.
Vor kurzem bewies der unabhängige Sicherheitsforscher cereblar durch Paketaufzeichnungsanalysen, dass das Programmier-Agent-Tool Grok Build von xAI das gesamte Projekt des Benutzers verpackt in den Google Cloud-Speicher hochlädt – einschließlich Dateien, von denen der Benutzer der KI ausdrücklich gesagt hat, dass sie nicht gelesen werden sollen, sowie Passwörtern ohne Anonymisierung.
Schon früher wurde festgestellt, dass Claude Code ohne Wissen der Benutzer Standort- und Identitätsdaten zurücksendet. Ingenieure von Anthropic bestätigten später sogar, dass es sich um ein absichtliches Experiment handelte.
Entscheidender ist, dass diese Probleme nicht durch Regulierung oder Sicherheitsaudits entdeckt wurden, sondern fast ausschließlich von Einzelpersonen aus der Community. Bislang gibt es in allen Sicherheitsrahmenwerken, die die Branche für Agenten aufgebaut hat, keine einzige Regel, die das Verhalten der Hersteller selbst einschränkt.
I
Der Ausgangspunkt: Eine ungewöhnliche Festplattenauslastung
Am 18. September bemerkte der Technik-Blogger ferstar bei der Untersuchung des lokalen Verzeichnisses von ZCode eine ungewöhnlich hohe Festplattenauslastung. Er fand eine verschlüsselte Datei mit einer Größe von etwa 313 MB, die weit über dem üblichen Umfang liegt. Die Datei ließ sich nicht öffnen, aber die beigefügte Dateiliste zeigte, dass dieses Paket etwa 42.000 Dateien umfasst, von denen mehr als 80 % zu den historischen Änderungsprotokollen des Projekts gehören.
Diese Aufzeichnungen enthalten nicht nur Projektdateien, sondern auch Caches großer Dateien, die früher heruntergeladen wurden, sowie lokale Betriebsprotokolle. Verpackt wird nicht nur das Projekt selbst, sondern auch seine gesamte „Geschichte von Anfang an“.
Nachfolgende Code-Analysen ergaben, dass diese historischen Aufzeichnungen im Verpackungsprozess von allen Sicherheitsfilterregeln ausgenommen sind.
Die Dateiauswahllogik von ZCode wird nacheinander ausgewertet: Die Freigabe des Verzeichnisses für historische Aufzeichnungen erfolgt vor der Filterung von Schlüsseldateien und der Begrenzung der Dateigröße. Das bedeutet, dass Filter für Passwortdateien wie pem oder key sowie die Obergrenze von 1 MB für alle Inhalte im Verzeichnis der historischen Aufzeichnungen nicht wirksam werden.
Das bedeutet, dass eine verpackte Datei mit einer Größe von mehreren hundert Megabyte vollständig übertragen werden kann, und alle Passwörter und Schlüssel, die einmal in den historischen Aufzeichnungen gespeichert und dann gelöscht wurden, werden ebenfalls unverändert hochgeladen.
Der problematischere Teil folgt: Der Entschlüsselungsschlüssel befindet sich nicht auf dem Computer des Benutzers.
ferstar hat den Upload-Pfad der Dateien rekonstruiert: Zuerst fordert der Client beim Zhipu-Server ein Upload-Zertifikat und einen öffentlichen Schlüssel zur Verschlüsselung an. Danach wird die Datei lokal komprimiert und verschlüsselt, dann umgeht sie die eigenen Geschäftsserver von Zhipu und wird direkt in den Cloud-Speicherdienst von Alibaba Cloud hochgeladen, bevor der Cloud-Speicher den Hintergrund von Zhipu über den Vorgang benachrichtigt.
An dieser Stelle eine kurze Erklärung der Verschlüsselungsmethode:
Der öffentliche Schlüssel entspricht einem Schloss, mit dem jeder Gegenstände in einen Koffer sperren kann; der private Schlüssel ist der dazugehörige Schlüssel, den nur der Besitzer öffnen kann. Bei ZCode wird das Schloss vorübergehend vom Server ausgegeben, der Schlüssel wird ausschließlich auf Seiten des Servers gespeichert. Der Agent erstellt auf dem Computer des Benutzers ein verschlüsseltes Paket, dessen Inhalt selbst der Benutzer nicht einsehen kann.
ferstar stellte fest, dass dieser Mechanismus zu zwei Zeitpunkten ausgelöst wird: Erstens bevor der Benutzer eine Anfrage an die KI sendet, und zweitens nachdem eine Aufgabe abgeschlossen ist. Bei einer aktiven Nutzung beobachtete er bis zu 62 Snapshot-Aufzeichnungen.
Zwei Optionen in der Oberfläche, die auf den ersten Blick damit zusammenhängen, wurden nach einem Abgleich mit der Codelogik von ferstar bestätigt: Eine heißt „Erlebnis optimieren“ und steuert tatsächlich nur, ob die Daten für das Modelltraining verwendet werden. Die andere heißt „Repository-Snapshot-Index“ und steuert tatsächlich nur, ob auf dem Server ein Suchverzeichnis für die empfangenen Daten erstellt wird.
Wenn beide Optionen deaktiviert sind, laufen die lokale Verpackung und der Upload trotzdem ab. Die Komponente für Snapshots und Uploads wird beim Start der Software ohne Bedingungen geladen, die einzige Voraussetzung ist, dass der Benutzer angemeldet ist.
Neben den Projektdateien wird bei jedem Snapshot auch die globale Konfiguration von ZCode selbst verpackt und projektübergreifend übertragen.
ferstar versuchte, die 313 MB große, zu sendende Datei manuell zu löschen. Eine halbe Stunde später generierte ZCode automatisch eine neue verpackte Datei – der Agent versucht wiederholt, den Upload durchzuführen, wenn er nicht erfolgreich ist.
Die Datei wird nach dem Löschen neu erstellt. Dieses Ausmaß an Beharrlichkeit passt nicht zu einer nebensächlichen Zusatzfunktion.
II
Die nicht vollständig beantworteten Punkte
Der Beitrag verbreitete sich in der Community noch am selben Abend rasch, Zhipu reagierte umgehend und entschuldigte sich.
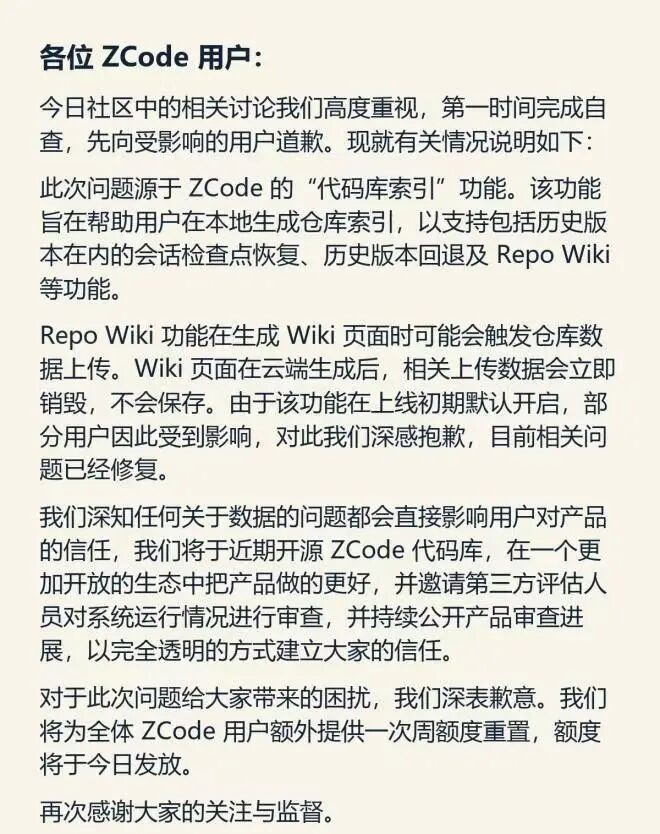
Das aktuelle Problem stammt von der Funktion „Code-Repository-Index“ in ZCode. Diese Funktion soll Benutzern helfen, lokal einen Repository-Index zu erstellen, um Funktionen wie die Wiederherstellung von Sitzungsprüfpunkten einschließlich historischer Versionen, das Zurücksetzen auf historische Versionen und das Repo-Wiki zu unterstützen.
Die Repo-Wiki-Funktion kann beim Generieren von Wiki-Seiten den Upload von Repository-Daten auslösen. Nachdem die Wiki-Seite in der Cloud erstellt wurde, werden die hochgeladenen Daten sofort gelöscht und nicht gespeichert. Da diese Funktion zu Beginn der Veröffentlichung standardmäßig aktiviert war, wurden einige Benutzer davon betroffen. Wir entschuldigen uns dafür, das entsprechende Problem wurde inzwischen behoben.
Zhipu versprach außerdem, in Kürze den Quellcode von ZCode zu veröffentlichen, Prüfer von Dritten zur Untersuchung des Systembetriebs einzuladen und allen Benutzern eine zusätzliche Entschädigung in Form einer wöchentlichen Kontingentrücksetzung zu gewähren, die noch am selben Tag ausgezahlt wird.
Der „Code-Repository-Index“ dient dazu, ein Verzeichnis und Suchsystem für Projektdateien aufzubauen; „Repo-Wiki“ ist eine Funktion, die automatisch eine Dokumentation für das Projekt erstellt; „Wiederherstellung von Sitzungsprüfpunkten“ und „Zurücksetzen auf historische Versionen“ ermöglichen es Benutzern, im Gespräch mit der KI zu einem vorherigen Schritt zurückzukehren.
Diese Funktionen an sich sind sinnvoll, die Reaktion war zeitnah – aber der entscheidende Punkt ist:
Was das Unternehmen erklärt, ist nicht das, was die Community fragt.
Zhipu gibt an, der Index solle „Benutzern helfen, ihn lokal zu erstellen“. Wenn er lokal erstellt wird, warum muss dann das gesamte Projekt in die Cloud übertragen werden? Lokales Indizieren, lokale Snapshots und lokales Zurücksetzen sind technisch durchaus machbar, es gibt bereits Tools auf dem Markt, die genau so funktionieren.
In der Erklärung werden „lokaler Index“ und „Upload in die Cloud“ in einem Satz verbunden, als wäre der letztere die natürliche Fortsetzung des ersteren – aber die Erklärung für diesen entscheidenden Zwischenschritt fehlt.
Die Antwort führt das Problem darauf zurück, dass das Repo-Wiki „beim Generieren von Wiki-Seiten den Upload von Repository-Daten auslösen kann“. Aber die Reverse-Engineering-Protokolle von ferstar zeigen, dass einer der Zeitpunkte, an denen der Upload ausgelöst wird, vor jeder Frage liegt, die der Benutzer sendet – das hat nichts mit dem Generieren von Dokumentationsseiten zu tun.
In der aktuellen offiziellen Dokumentation von ZCode steht ausdrücklich, dass beim Generieren von Dokumentationsseiten keine historischen Änderungsprotokolle des Projekts gelesen werden, sondern nur gefilterter Codekontext nach Bedarf abgerufen wird. Das zeigt, dass diese Funktion die historischen Aufzeichnungen technisch nicht benötigt.
Warum bestehen dann 86,6 % der zuvor hochgeladenen Pakete aus historischen Aufzeichnungen? Die Erklärung beantwortet nicht, warum der Umfang des Uploads so groß war – ob dies beabsichtigt war oder ein Programmierfehler vorlag – und auch nicht, ab welcher Version das Problem behoben wurde.
Die Formulierung, dass die Funktion „zu Beginn der Veröffentlichung standardmäßig aktiviert war“, stellt die unbefugte Datenweitergabe auf Mechanismusebene eher als Einstellung eines Funktionsschalters dar.
Die Code-Analyse von ferstar zeigt, dass die beiden zugehörigen Optionen in der Oberfläche jeweils das Training und den Index steuern, aber keine Kontrolle über das Verpacken und Hochladen selbst haben.
Der Kern der Kritik der Community ist, dass die sichtbaren Steuerelemente der Benutzer nicht die tatsächlichen Vorgänge kontrollieren. Das ist ein Problem einer anderen Größenordnung als „eine Funktion war standardmäßig aktiviert“.
Bald darauf fand die Community einen weiteren, sensibleren Beweis: Das Update-Protokoll der Version ZCode v3.12.2 vom 16. September 2026, also zwei Tage vor dem Beitrag von ferstar.
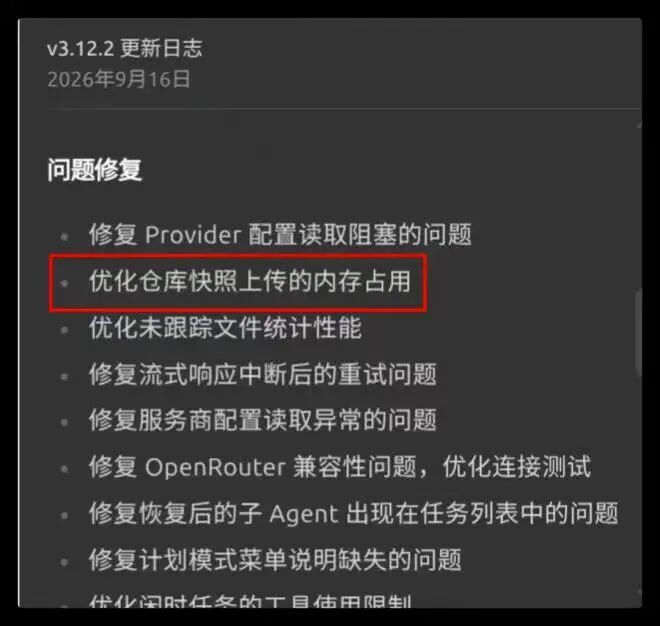
Darin steht der Eintrag „Speichernutzung des Uploads von Repository-Snapshots optimieren“. Es ist unwahrscheinlich, dass das Ingenieursteam die Speichernutzung für ein unbeabsichtigtes Verhalten optimiert – das zeigt, dass der „Upload von Repository-Snapshots“ intern eine normales Funktion war, die kontinuierlich weiterentwickelt wurde.
Dieses Update-Protokoll wurde nach der öffentlichen Aufmerksamkeit für den Vorfall gelöscht. Das Löschen von öffentlichen Aufzeichnungen ist ein neues Problem, das unabhängig von dem ursprünglichen Verhalten besteht.
Die Aussage „entsprechende hochgeladene Daten werden sofort gelöscht und nicht gespeichert“ beantwortet die Frage, wie lange die Daten aufbewahrt werden. Aber die Benutzer müssen noch viele weitere Punkte wissen: Haben die Daten den Computer bereits verlassen? Wer hat auf Seiten des Servers Zugriff auf die Daten während der Verarbeitung? Wer verfügt über die Fähigkeit, die verschlüsselten Pakete zu entschlüsseln? Welche Löschstrategien wurden für die bereits hochgeladenen Daten angewendet?
Aufgrund der Verschlüsselungsmethode befindet sich der Schlüssel auf Seiten des Servers. Das „verschlüsselte Hochladen“ beweist nur, dass die Daten während der Übertragung nicht von Dritten abgefangen werden können – es bedeutet nicht, dass Zhipu selbst den Inhalt nicht entschlüsseln kann.
In der englischen Version der Datenschutzrichtlinie von ZCode heißt es zum Umfang der Erhebung, dass Texte, Dateien und Codes erfasst werden, die Benutzer „durch Gespräche“ übermitteln. Die Hintergrund-Snapshots werden aber nicht von Benutzern durch Gespräche übermittelt – dieses Verhalten ist nicht in der Beschreibung der Datenschutzrichtlinie abgedeckt. „Uns im Gespräch übermittelte Daten“ und „automatisches Verpacken des gesamten Projekts im Hintergrund“ sind zwei völlig unterschiedliche Dinge.
In dieser Datenschutzrichtlinie steht außerdem, dass Benutzer durch Hinweise auf Seiten oder Interaktionsprozesse separat informiert und um Zustimmung gebeten werden müssen, wenn neue Funktionen die Erhebung von Daten beinhalten, die keinen direkten oder angemessenen Bezug zum ursprünglichen Zweck haben.
Eine weitere Code-Analyse des Entwicklers Feng Ruohang ergab, dass der Client bei jeder gesendeten Frage bedingungslos ein Upload-Zertifikat beim Server anfordert. Wenn der Server das Zertifikat ausgibt, werden die Daten erfasst, sonst nicht.
Die 313 MB große Datei, die ferstar fand, befand sich zum Zeitpunkt der Entdeckung im Zustand „zu senden“ und hatte bereits 564 fehlgeschlagene Versuche hinter sich. Feng Ruohang hat den Untersuchungsprozess von ferstar auf seinem Mac unabhängig nachvollzogen und in den Snapshot-Aufzeichnungen von 4 Arbeitsbereichen bestätigt, dass mindestens eine Statusdatei des Snapshots bereits eine Bestätigungsmarke für den Empfang durch den Server enthält.
Gemäß der Codelogik wird diese Marke nur erstellt, wenn der Upload vom Server als empfangen bestätigt wurde. Das bedeutet, dass die Daten von mindestens einem Computer tatsächlich den lokalen Bereich verlassen haben. Zhipu hat seine Entschuldigung, Versprechen und Entschädigungen innerhalb weniger Stunden nach Ausbruch der Kontroverse veröffentlicht – die Reaktionsgeschwindigkeit deutet nicht darauf hin, dass das Unternehmen etwas lange verheimlichen wollte.
Aber egal ob „sofort gelöscht“ oder „nicht gespeichert“: Solche Versprechen lassen sich von außen weder bestätigen noch widerlegen. Benutzer sehen nur, dass die Daten ihren Computer verlassen haben – was danach passiert, hängt vollständig von der Selbstkontrolle des Herstellers ab.
Ob die von Zhipu versprochene Open-Source-Veröffentlichung und die Prüfung durch Dritte dies ändern können, hängt davon ab, welche Version veröffentlicht wird und ob die Prüfung nur den Client oder auch den Server umfasst. Auf diese Fragen gibt es derzeit keine Antwort.
III
Etwas Sensibleres als Code und Daten
Wenn einige Hersteller absichtlich Benutzerdaten erfassen wollen, sind sie wahrscheinlich nicht an dem Code der Benutzer selbst interessiert.
Denn die öffentlichen Projekte auf den großen Code-Hosting-Plattformen liefern ausreichend Daten für das Modelltraining. Privater Code enthält zwar Geschäftsgeheimnisse,