Wie weit ist KI noch davon entfernt, „alles zu verstehen“? Zuerst wird es an Krebszellen und Planetenbahnen auf die Probe gestellt.
In einem technischen Bericht tauchen tatsächlich zwei Forschungsobjekte auf, die auf den ersten Blick überhaupt nichts miteinander zu tun haben – mit KI lernt man wirklich die Welt kennen.
Eines sind patientenabgeleitete Organoide, das andere erstreckt sich bis zum makroskopischen Universum……
Zuerst zum ersten Punkt: Die Forscher nutzten die aus dem Modell erlernten internen Faktoren, schlugen ein Interventionsschema mit Zytokinen in Kombination mit Antikörperblockaden vor und validierten dieses schrittweise an Zelllinien, Organoiden und Mausversuchen.
Was das zweite Objekt betrifft: Die Forscher fütterten das Modell mit simulierten Positionen und Geschwindigkeitsbahnen von Planeten, ohne ihm Keplers Gesetze mitzuteilen.
Nach Abschluss des Lernvorgangs analysierten sie das interne Vorhersagemuster des Modells. Der Anpassungsanstieg der extrahierten Beziehung „Bahnfrequenz – Halbachse“ erreichte einen Wert von -1,4991 (der theoretische Wert nach dem dritten Keplerschen Gesetz beträgt -1,5), und der Wert R²=0,99999999.
Zwei Bereiche, die so gar nichts miteinander zu tun haben wie die Tumorforschung und die Berechnung von Planetenbahnen, lassen sich tatsächlich mit ein und derselben prädiktiven Lernmethode lösen.
Die weite Welt ist äußerst vielfältig: Wetter, Moleküle, Zellen, Patienten, Roboter und sogar Planeten folgen jeweils völlig unterschiedlichen Regeln.
Aber ist es möglich, dass KI beim Verstehen, „wie sich diese Dinge verändern“, auf einen gemeinsamen, tieferliegenden Satz von Methoden zurückgreift?
Kürzlich hat das Team von PhAI Labs gemeinsam mit Forschungsgruppen von Universitäten wie Oxford, Stanford, Princeton und der Chinesischen Universität Hongkong das neueste Werk JEPA-Anything vorgestellt, das versucht, diese Frage zu beantworten.
Laut dem Papier ist JEPA-Anything ein domänenübergreifendes Framework zum Lernen von Vorhersagemodellen für unterschiedliche „Welten“.
Jede Domäne behält ihre eigene Beobachtungsform, die Konstruktion von Kontext und Ziel sowie ihren Encoder bei, teilt aber den nachfolgenden Vorhersagekern und eine einheitliche Schnittstelle für latente Weltzustände.
Dabei kommt ein zentraler Mechanismus namens OPF (Orthogonal Predictive Factorization, orthogonale prädiktive Faktorisierung) zum Einsatz.
Man kann dies zunächst vereinfacht so verstehen:
Man sollte nicht alle Arten von Veränderungen in der Welt zusammen in einen Topf werfen, um sie gemeinsam zu modellieren.
Beim Modellieren der Welt reicht ein einziger Vorhersagepfad oft nicht aus
Zuerst klären wir einen Begriff: Was bedeutet „Weltmodell“ in der Forschung zu JEPA-Anything eigentlich?
Die Definition im JEPA-Anything-Papier kombiniert Breite mit praktischer Anwendbarkeit.
Im Papier heißt es: Solange ein Modell auf Basis vorhandener Informationen (Kontext) einen internen Zustand aufbaut und damit einen anderen Zustand desselben Systems vorhersagen kann, fällt es in die Kategorie der latenten Weltmodelle (Latent World Model) .
Der „andere Zustand“ kann dabei ein zukünftiger Zustand in der Zeit sein, aber auch ein verborgener Bereich im Raum, eine andere Perspektive oder sogar das Ergebnis einer bestimmten Intervention.
Ausgehend von dieser Idee hat die Branche in den letzten Jahren immer ausgereiftere technische Ansätze entwickelt.
Beispielsweise legt DreamerV3 den Fokus darauf, zuerst ein Umgebungsmodell aufzubauen und dann innerhalb des Modells die Folgen von Handlungen zu „vorstellen“; V-JEPA 2 kombiniert Video-Repräsentationslernen mit Robotersteuerung, sodass der Roboterarm vor der Planung von Bewegungen die physischen Rückmeldungen unterschiedlicher Aktionen vorhersagen kann.
Und JEPA – Joint-Embedding Predictive Architecture, gemeinsame Einbettungsprädiktionsarchitektur – ist einer der repräsentativsten Ansätze in diesem Bereich.
Im Vergleich zur direkten Rekonstruktion des Zielzustands im ursprünglichen Raum entscheidet sich JEPA dafür, Vorhersagen im Repräsentationsraum durchzuführen, ohne jedes Pixel oder jedes Detail wiederherstellen zu müssen.
Es kodiert die Beobachtungsinformationen zuerst in interne Repräsentationen im latenten Raum und führt dann die Vorhersage im Repräsentationsraum durch.
Durch dieses Design kann das Modell mehr seiner Repräsentationskapazität für Strukturen mit Vorhersagewert reservieren und Störungen durch Details im ursprünglichen Raum wie Texturen oder Rauschen reduzieren.
Allerdings leitet das Standard-JEPA normalerweise alle Informationen in ein und dasselbe Ziel-Einbettung ein und folgt demselben Vorhersagepfad.
Aber die Veränderungen in der realen Welt verlaufen oft nicht in einem einzigen Strang.
Zum Beispiel geht die gesamte Translation eines Moleküls oft mit mikroskopischen Schwingungen der inneren Atome einher; in der langsamen Entwicklung makroskopischer Wettersysteme mischen sich heftige lokale Störungen; biologische Systeme sind noch komplexer, da Veränderungen auf mehreren Skalen und über mehrere Pfade ständig gleichzeitig stattfinden.
Wenn Signale unterschiedlicher Skalen, Entitäten und Schwierigkeitsgrade zwangsweise zusammengepresst werden, nehmen die Signale, die leichter vorherzusagen sind und deutlichere Veränderungen aufweisen, möglicherweise vorrangig mehr Vorhersagekapazität in Anspruch.
Im Gegensatz dazu werden relativ schwache, aber ebenso wichtige Informationen entweder durch Gradientenkonflikte aufgehoben oder vollständig durch starke Signale überdeckt.
Die Forscher fassen dies als das Problem der „Verteilung der Vorhersagekapazität“ zusammen und schlagen gleichzeitig eine neue Lösung vor.
Wenn Überfüllung zu Verdrängung führt, führt man eine räumliche Entkopplung durch.
So entstand JEPA-Anything.
Sein Kernmechanismus OPF (Orthogonale Prädiktive Faktorisierung) teilt den ursprünglich vollständigen Zielzustand in mehrere komplementäre Teilräume auf, die von unterschiedlichen Vorhersagezweigen unabhängig verarbeitet werden, bevor sie schließlich wieder zu einem vollständigen Weltzustand zusammengesetzt werden.
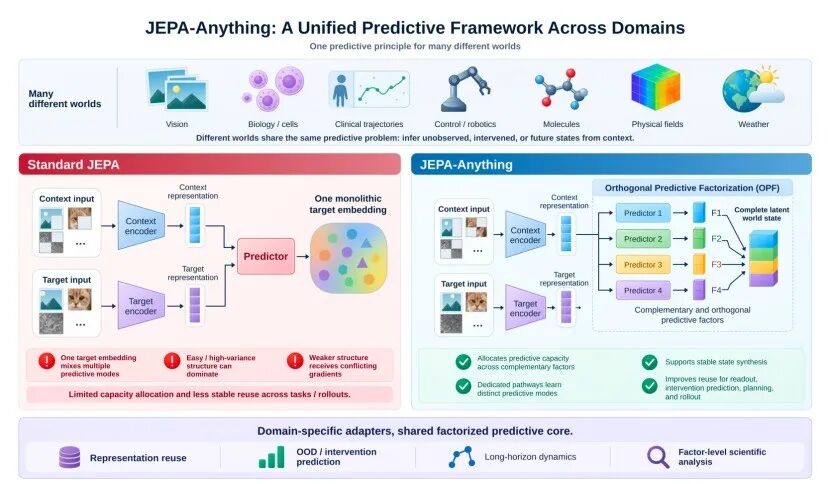
Um zu verhindern, dass sich die mehreren Zweige zu einem redundanten Zustand entwickeln, bei dem „mehrere Teams dasselbe lernen“, führt OPF orthogonale Beschränkungen ein, sodass unterschiedliche Faktoren möglichst überlappungsfreie Vorhersagerichtungen einnehmen und die Wiederholung des Lernens derselben Informationsart durch mehrere Zweige reduziert wird. Gleichzeitig werden durch Beschränkungen der Faktoraktivität und der Varianz des Encoders vermieden, dass einige Faktoren inaktiv werden, und das Risiko eines Repräsentationskollapses wird verringert.
Bemerkenswert ist, dass diese Faktoren nicht im Voraus festgelegt bekommen „du bist für die Geschwindigkeit zuständig“, „du bist für die Temperatur zuständig“ oder „du bist für einen bestimmten biologischen Pfad zuständig“.
Was sie lernen, wird durch die vorhersagbaren Strukturen in den Daten bestimmt.
Nach Abschluss des Trainings hinterlassen diese Faktoren daher eine interne Schnittstelle, die für nachfolgende Analysen genutzt werden kann.
Gemeinsamer Vorhersagekern, validiert an sieben Arten von Systemen
So überzeugend die Methodik auch beschrieben wird, sie muss sich letztendlich der Prüfung der domänenübergreifenden Generalisierung stellen.
Dabei muss man die Besonderheit des experimentellen Designs von JEPA-Anything hervorheben.
Es beschränkt sich nicht auf traditionelle Bereiche wie Video-Repräsentationslernen oder Robotersteuerung, sondern setzt denselben Vorhersagekern (Predictive Core) direkt in sieben völlig unterschiedlichen Systemen ein: Sehen, Biologie, Klinik, Steuerung, Moleküle, physikalische Felder und Wetter, um ihn zu validieren.
Das sogenannte „Anything“ bedeutet nicht, dass Daten aller Domänen zwangsweise aufgelöst und in dasselbe Eingabeformat umgewandelt werden. Bilder, Einzelzellensequenzen, Molekülstrukturen und sogar Wetterdaten behalten weiterhin ihre jeweils am besten passenden Encoder und Datenformen bei.
Was vereinheitlicht wird, ist folgender Satz von Grundregeln:
Nachdem die Daten in Repräsentationen im latenten Raum umgewandelt wurden, wie der Vorhersageteil das Modell aufbauen und das Lernen durchführen soll.
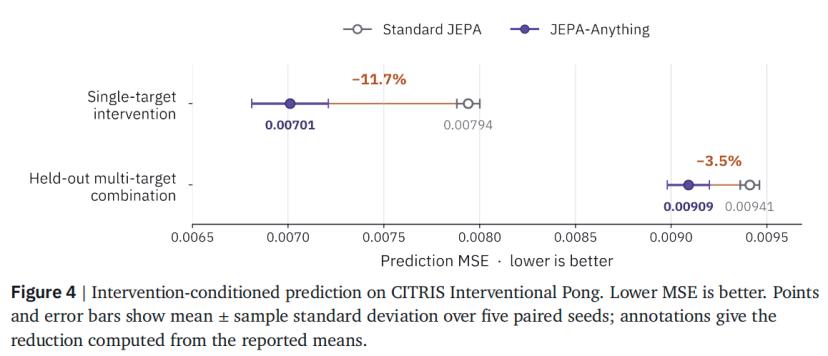
Das Papier führt zuerst Experimente in einer kontrollierten dynamischen Umgebung namens CITRIS Interventional Pong durch, die auf einem vereinfachten Pong-Spiel aufbaut, um zu überprüfen, ob das Modell zusammengesetzte Veränderungen „zerlegen, lernen und dann wieder kombinieren“ kann.
In der Trainingsphase erhält das Modell nur Daten zu Veränderungen einzelner Faktoren; in der Testphase muss es mit Kombinationsinterventionen mehrerer Faktoren umgehen, die noch nie zuvor aufgetreten sind.
Wenn das Modell nur stur die vollständigen Muster im Trainingssatz aufgezeichnet hat, wird es bei völlig neuen Kombinationen zwangsläufig versagen. Wenn das Modell aber die wiederverwendbaren Regeln von Zustandsänderungen zwischen verschiedenen Veränderungen gelernt hat, hat es eine höhere Chance, diese in noch nicht gesehenen Kombinationen neu zusammenzusetzen.
Die experimentellen Ergebnisse zeigen, dass JEPA-Anything bei einzelnen Interventionen innerhalb der Verteilung den Vorhersagefehler um etwa 11,7 % senkt im Vergleich zum Standard-JEPA; bei noch nicht gesehenen Kombinationsinterventionen mehrerer Faktoren sinkt der mittlere quadratische Fehler (MSE) ebenfalls um etwa 3,5 %, und dies verbessert sich in allen fünf gepaarten Trainings-Seeds.
Anschließend geht die Validierung zu komplexeren realen Systemen über.
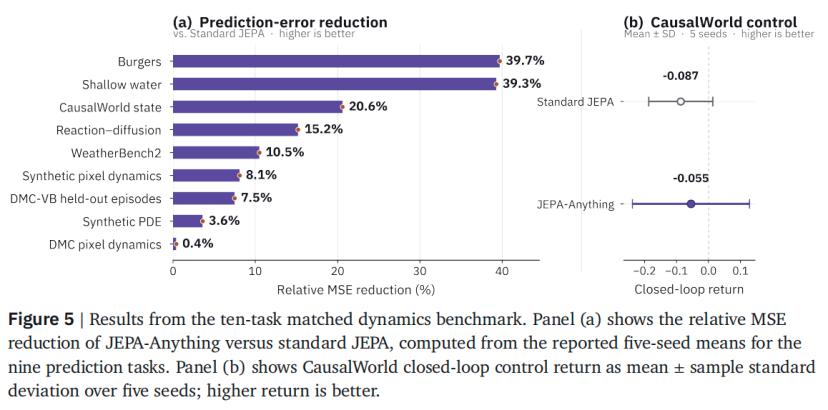
Das Papier erstellt einen streng ausgerichteten Dynamik-Benchmark (Matched Dynamics Benchmark), bei dem in zehn Aufgaben sichergestellt wird, dass Standard-JEPA und JEPA-Anything exakt dieselben Trainingsdaten, Encoder, Backbone-Netze für Zustandsübergänge, Rechenressourcen und Auswertungsaufteilungen verwenden.
In neun von zehn Vorhersageaufgaben verbessern sich die Leistungsindikatoren von JEPA-Anything.
Beispielsweise sinkt der MSE bei der Burgers-Gleichung im PDEBench um 39,7 %, bei der Flachwassergleichung um 39,3 % und bei WeatherBench 2 um 10,5 %.
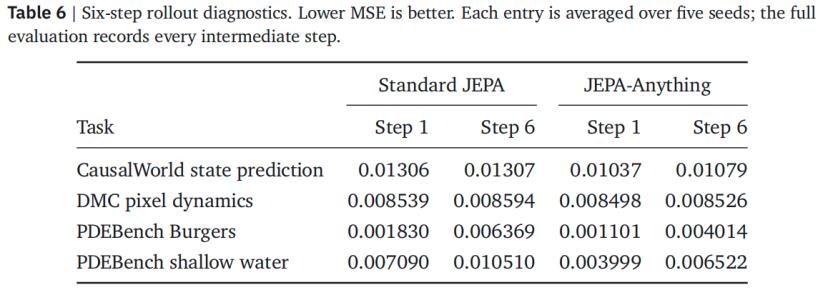
Das Papier führt außerdem speziell einen mehrstufigen Rollout durch, bei dem jede Vorhersage als Eingabe für die nächste Vorhersage dient, um zu beobachten, was passiert, wenn sich Fehler ständig fortpflanzen.
Bei Molekülsystemen wird der Zeithorizont noch weiter gestreckt.
In vier Systemen: flüssiges Wasser, α-Quarz, Paracetamol und Benzol muss das Modell kontinuierlich die zukünftigen Positionen und Geschwindigkeiten der Atome vorhersagen und seine eigenen Ausgaben immer wieder zurückfüttern.
Schließlich erzielt JEPA-Anything sowohl beim MAE der Ein-Schritt-Vorhersage als auch beim RMSD der Endposition nach 100 Schritten freiem Rollout den niedrigsten Fehler in allen vier Molekülsystemen.
Allerdings ist zu beachten, dass die experimentellen Daten keine idealisierte Kurve zeigen, bei der „ein einziger Mechanismus alles andere vollständig übertrifft“.
Bei kontinuierlichen Steuerungstests ist JEPA-Anything nicht bei jeder Aufgabe besser: Bei Walker2d und HalfCheetah liegt sein durchschnittlicher Wert über dem des Standard-JEPA; bei Hopper hingegen zeigt das Standard-JEPA bessere Leistungen.
Je weiter die Distanz der kontinuierlichen Vorhersage ist, desto mehr sammeln sich die Fehler an.
In einem zusätzlichen Burgers-Test schrumpft der Vorsprung von JEPA-Anything deutlich, wenn die Vorhersagelänge von 20 auf 50 Schritte ansteigt, auch wenn es immer noch vorne liegt.
