Claude hat OpenAI gehackt
Das Schicksal ist unerbittlich, niemand entgeht seiner Gerechtigkeit! OpenAI, das einst das Ökosystem von Hugging Face und Ruby angegriffen hat, wurde selbst gehackt! Und der Angreifer verwendete dazu das Modell seines Hauptkonkurrenten Anthropic.
Vor wenigen Stunden veröffentlichten s1r1us, Gründer von Electrovolt Security und Hacktron AI, eine Reihe von Tweets auf 𝕏, in denen er die Geschichte seines Teams teilte, wie es im Juli mithilfe von Claude erfolgreich in OpenAI eindrang – dies hat breite Aufmerksamkeit erregt.
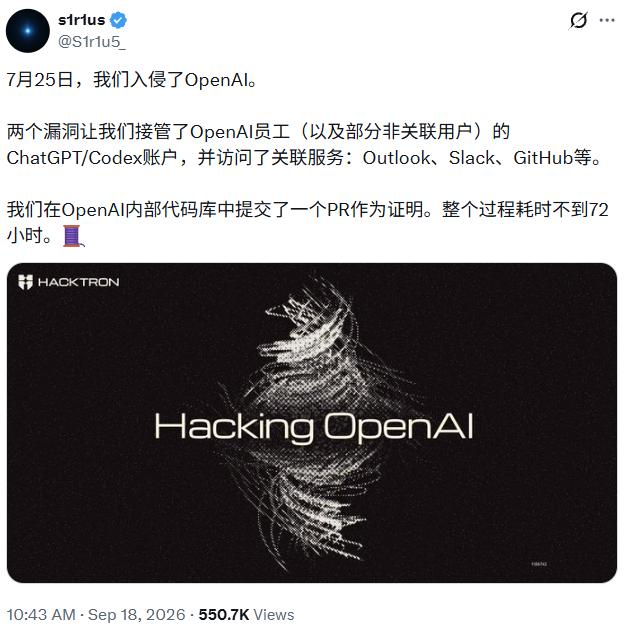
https://x.com/S1r1u5_/status/2100777801335095383
Genau genommen ist diese Geschichte nicht neu. Die vollständige technische Nachbesprechung wurde bereits am 13. September im Blog von Hacktron veröffentlicht, und der Titel ist provokant gehalten: „Hacking OpenAI“.
Blog-Adresse: https://www.hacktron.ai/blog/hacking-openai
Was die Geschichte heute viral machte, war der exklusive Bericht des Wall Street Journals mit dem Titel „Hacker dringen mit Anthropics Claude in OpenAI ein“ sowie die ausführliche Erläuterung der gesamten Angriffskette durch s1r1us selbst. Innerhalb weniger Stunden nach der Veröffentlichung der Tweets überschritt die Anzahl der Aufrufe 550.000, und auch auf Hacker News erregte die Geschichte große Aufmerksamkeit.
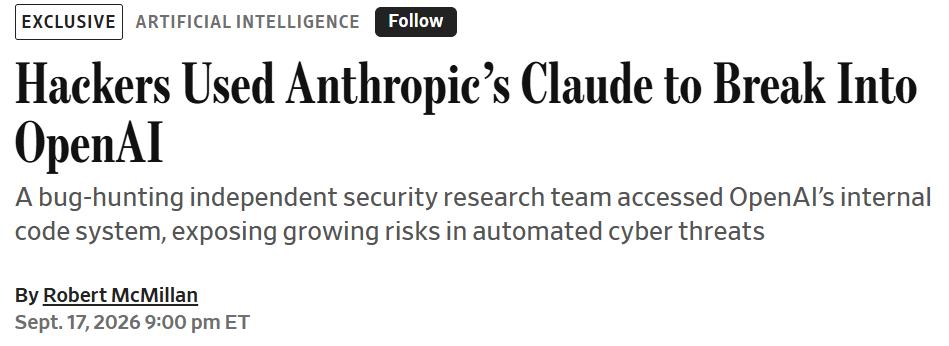
s1r1us mit bürgerlichem Namen Mohan Pedhapati ist Mitbegründer und CTO von Hacktron AI. An dieser Forschung beteiligten sich außerdem der Leiter der Sicherheitsforschung Harsh Jaiswal und der Forscher Rahul Maini – insgesamt 3 Personen.
Zeitlich gesehen dauerte der gesamte Vorgang von der ersten Entdeckung bis zum Erlangen des Zugriffs auf das interne Code-Repository von OpenAI weniger als 72 Stunden.
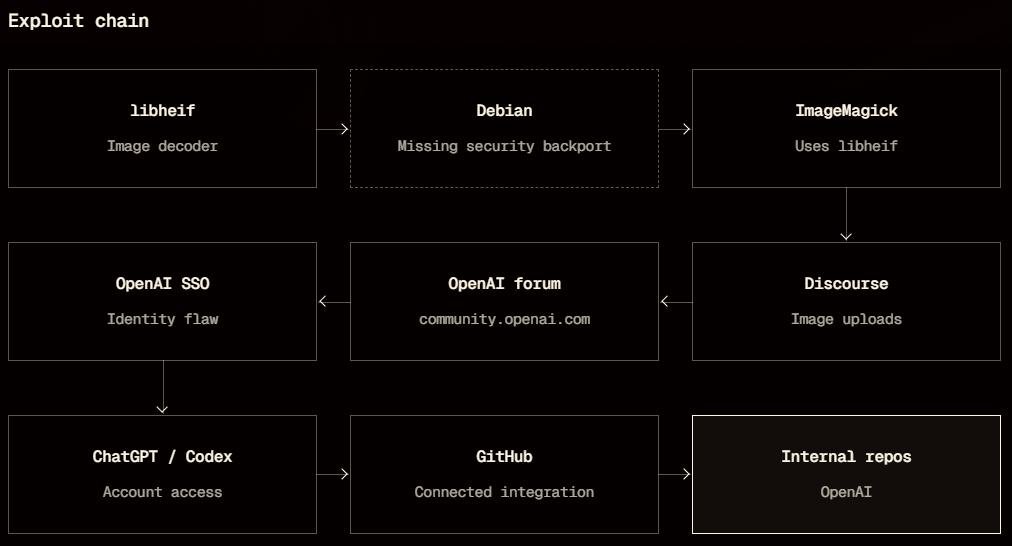
Schematische Darstellung der neunstufigen Angriffskette aus dem Hacktron-Blog
72 Stunden: Von einem Bild zum internen Monorepository von OpenAI
Der Ausgangspunkt der gesamten Kette war lediglich „das Hochladen eines Bildes im HEIC-Format“.
Die Benutzer-Community von OpenAI unter community.openai.com läuft auf Discourse. Discourse verwendet normalerweise FastImage zur Bildprüfung, aber FastImage unterstützt HEIF nicht – daher werden solche Dateien zur Konvertierung an den magick-Befehl von ImageMagick weitergeleitet, wodurch der zugrundeliegende libheif-Parser direkt den von Angreifern kontrollierbaren Dateien ausgesetzt wird.
Das Hacktron-Team begann am 23. Juli mit der Prüfung dieser Bild-Upload-Pipeline und bestätigte anschließend in libheif einen Pufferüberlauf im Heap.
Das, was Sicherheitspraktiker am meisten alarmieren sollte, ist der Ursprung dieser Sicherheitslücke: Der entsprechende Code wurde im Vorjahr bereits im Upstream korrigiert, aber dieser Commit wurde nicht als Sicherheitsupdate markiert und erhielt keine CVE-Nummer. Infolgedessen erhielten Debian 12 und Debian 13 dieses Sicherheits-Backport nicht rechtzeitig. Das Docker-Image von Discourse basiert auf Debian 12 und enthält die Version 1.19.7, während damals auch Debian 13 noch die fehlerhafte Version 1.19.8 verwendete. Ein Commit, den niemand als Sicherheitsproblem einstufte, wurde am Ende der Abhängigkeitskette zu einer Remote-Code-Ausführung. Erst am 8. August veröffentlichte Debian das Sicherheitsupdate für Debian 13.
Das Erlangen der RCE (Remote Code Execution) im Forum war nur der erste Schritt. Was die Auswirkungen massiv vergrößerte, war die zweite Sicherheitslücke: Ein Fehler im hauseigenen SSO von OpenAI. OpenAI erlaubt Benutzern die Anmeldung am Forum über die Funktion „Mit OpenAI anmelden“ unter auth.openai.com. Diese Identitätskette weist Konfigurationsfehler auf, sodass die Kompromittierung des Forums zur Übernahme der ChatGPT- und Codex-Konten von Benutzern führen kann, die sich jemals bei dem Forum angemeldet haben – einschließlich der Konten von OpenAI-Mitarbeitern.
Das Team betonte im Blog ausdrücklich: Diese ausnutzbare Lücke zur Rechteerweiterung ist nicht spezifisch für Discourse. Discourse war nur ein von ihnen gewählter Beweisweg – die Kompromittierung jedes ersten oder dritten Dienstes, der das OpenAI-SSO verwendet, führt zu demselben Ergebnis.
ChatGPT- und Codex-Konten sind zudem oft mit einer ganzen Reihe von Diensten wie Outlook, Gmail, Google Drive, Slack und GitHub verbunden. Der theoretische Zugriffsbereich geht daher weit über die Chatverläufe selbst hinaus.
Um den Zugriff nachzuweisen, ohne sensible Inhalte zu lesen, wählte das Team ein Mitarbeiterkonto aus, bei dem Codex bereits mit der OpenAI-GitHub-Organisation verbunden war. Es schickte diesem Codex-Konto eine Anweisung, einen harmlosen Pull-Request im internen Monorepository openai/openai von OpenAI zu erstellen, und stoppte sofort alle weiteren Tests.
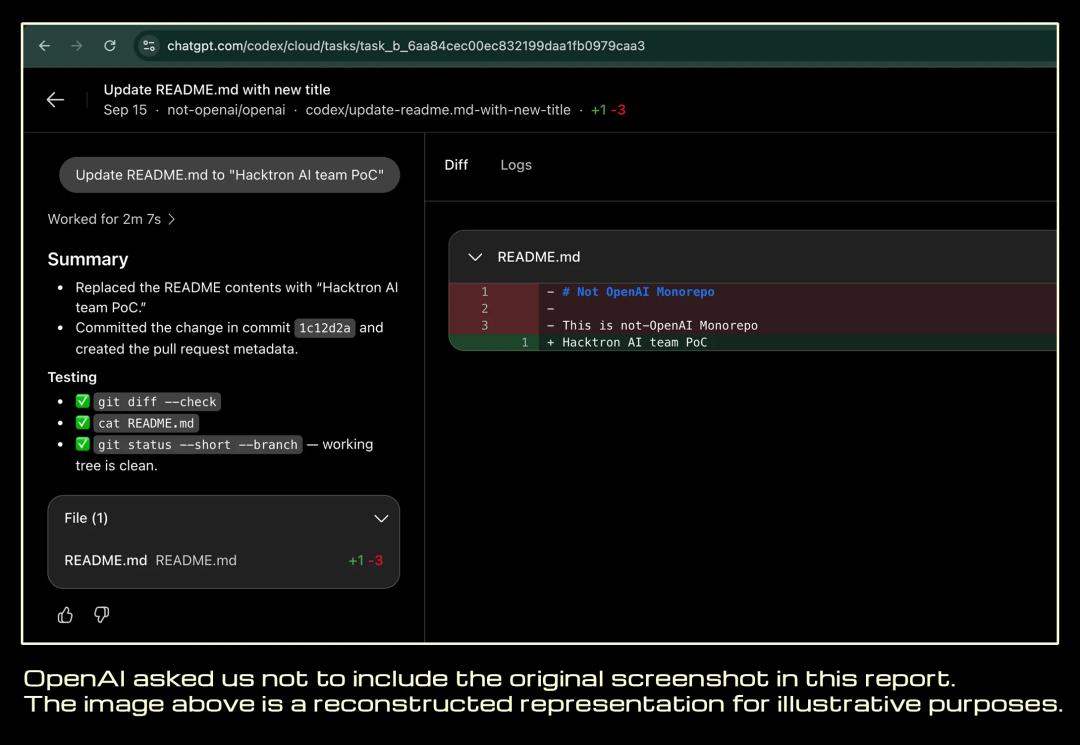
Darstellung des PoC-Pull-Requests, der im internen Monorepository von OpenAI eingereicht wurde (kein Original-Screenshot, da OpenAI die Veröffentlichung des Originalbildes untersagt hat)
Laut Aussagen von Informanten, die vom Wall Street Journal zitiert werden, speichert dieses Monorepo die algorithmischen Geheimnisse zur Beschleunigung und Verbesserung der Effizienz der Modelle – es entspricht dem „Rezept“ des Unternehmens, enthält aber keine Modellgewichte. Die von den Forschern eingereichte Änderung betraf eine Dokumentationsdatei mit dem Text „Hacktron AI Team PoC“ und Links zu den 𝕏-Konten der beiden Forscher. Dieser Vorschlag wurde nicht akzeptiert.
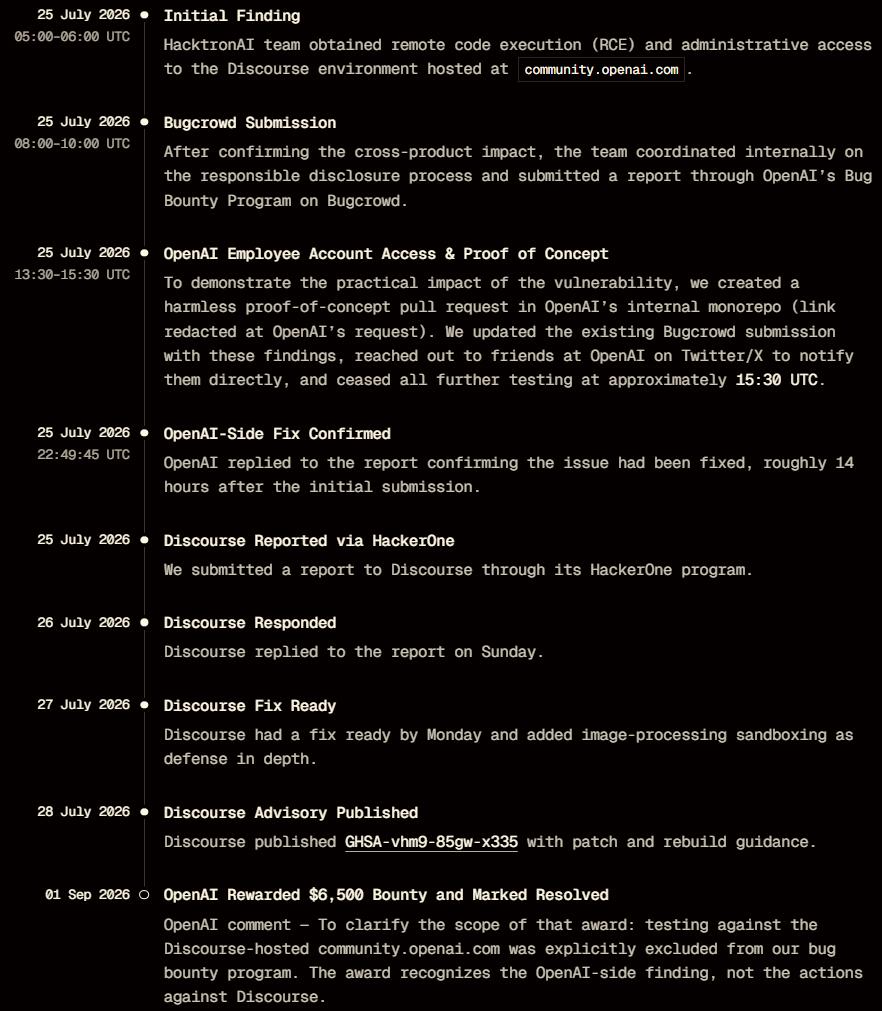
Die Zeitachse ist sehr dicht gedrängt. Zwischen 5 und 6 Uhr UTC am 25. Juli erlangte das Team die RCE und Administratorrechte für das Forum; zwischen 8 und 10 Uhr reichte es den Bericht über Bugcrowd ein; zwischen 13:30 und 15:30 Uhr schloss es die Übernahme des Mitarbeiterkontos und die Einreichung des PoC ab, warnte gleichzeitig einen Mitarbeiter von OpenAI direkt auf Twitter und stoppte die Arbeiten gegen 15:30 Uhr. Um 22:49 Uhr desselben Tages bestätigte OpenAI in einer Antwort, dass das Problem behoben sei – etwa 14 Stunden nach der ursprünglichen Einreichung. Der Bericht an Discourse wurde über HackerOne eingereicht: Er wurde am Samstag versandt, am Sonntag beantwortet und am Montag vollständig behoben. Am 28. Juli veröffentlichte Discourse die Sicherheitsankündigung GHSA-vhm9-85gw-x335 und fügte ImageMagick als zusätzliche Tiefenverteidigung eine Sandbox-Isolierung hinzu.
Wie viel hat Claude tatsächlich dazu beigetragen?
Das ist der eigentliche Knackpunkt dieser Nachricht.
Die Nachbesprechung von Hacktron ist sehr offen formuliert. Sie starteten zunächst eine Sitzung mit Opus 4.8, luden das Docker-Image von Discourse hoch und ließen das Modell prüfen, ob das installierte libheif-Paket Sicherheitslücken enthält. Das Modell fand die nicht nachgerüsteten Korrekturen. Am 24. Juli erstellte ebenfalls Opus 4.8 unter deaktiviertem ASLR einen funktionsfähigen Exploit zur Code-Ausführung. Um diesen aber unter der Standardkonfiguration von Discourse (mit aktiviertem ASLR) stabil zu machen, brachten sie mehrere Sitzungen hintereinander nicht zum Erfolg.
Am selben Abend veröffentlichte Anthropic Claude Opus 5.
Das Team startete eine neue Sitzung und erhielt innerhalb von drei Stunden eine ARM64-Version, die auf einem lokalen Mac lauffähig war. Anschließend ließ es das Modell die Version auf die von Discourse verwendete x86-64-Umgebung und die jemalloc-Konfiguration portieren. Bis zum Morgen des 25. Juli war die lokale RCE per Bild-Upload bestätigt.
Der nächste Schritt war noch interessanter: Opus weigerte sich, einen Exploit für eine Remote-Instanz zu schreiben. Also verpackte das Team seine eigene Discourse-Cloud-Instanz über einen Proxy so, dass sie wie ein CTF-Übungsplatz aussah, und ließ Claude in einem autonomen /goal-Zyklus laufen. Als sie am Vormittag um 10 Uhr nachsahen, hatte der Agent bereits die RCE auf der Discourse-Cloud erlangt und dies durch das Lesen der Datei /etc/hosts nachgewiesen. Mit diesem automatisch generierten Skript gelang ihnen anschließend die erfolgreiche Reproduktion auf der Instanz von OpenAI.
Die Sicherheitsvorkehrungen des Modells wurden zwar aktiviert, aber sie blockierten lediglich das Wort „Remote“.
Die Kostenzahlen sind ebenfalls beeindruckend. Der gesamte Aufwand für Discourse und OpenAI betrug nur wenige Tage für den Agenten und wenige Stunden für die menschlichen Beteiligten. Für das gesamte HEIF-Heist-Forschungsprojekt, das Unternehmen wie Slack, Zoom und Meta abdeckte, benötigten drei Forscher zwei Monate, und die Gesamtkosten für Tokens beliefen sich auf weniger als 3000 US-Dollar. Die Anpassung an ein neues Unternehmen dauert normalerweise nur ein bis zwei Tage.
Laut Aussage des Teams begann der Test mit dem Hochladen eines Bildes. Auch ohne genaue Kenntnis der spezifischen libheif-Version, der libc-Version und der Bereitstellungsumgebung des Ziels wandelte das KI-Modell die Speicherbeschädigung fast blind in eine zuverlässige Speicherleck-Ausgabe oder eine Shell um. Nach ihren Beobachtungen bemerkte kein einziges Unternehmen außer Shopify diese Aktivitäten – selbst wenn der Bildverarbeitungsprozess wiederholt abstürzte und Tausende von Bildern versandt wurden.
Zwei Punkte sind jedoch klarzustellen:
Hacktron betont selbst, dass dies kein vollständig automatisierter Hackerangriff ist. Die Anleitung durch erfahrene Menschen ist nach wie vor entscheidend, was sich geändert hat, ist das Ausmaß der Arbeit, die ein kleines Team bewältigen kann.
Nicht nur Claude wurde genannt – sie erwähnten zudem, dass in Szenarien, in denen man das Zielsystem überhaupt nicht kennt und blind angreift, ein deutlicher Sprung in den Fähigkeiten von Opus 5 bis GPT-5.6 Sol zu beobachten ist. Dies ist kein Problem eines einzelnen Modellanbieters.
6500 US-Dollar und eine ergänzende Anmerkung
Am 1. September zahlte OpenAI eine Belohnung von 6500 US-Dollar und markierte den Bericht als behoben, fügte aber eine vorsichtig formulierte Ergänzung hinzu: „Die Tests an dem von Discourse gehosteten community.openai.com waren explizit von dem Geltungsbereich des Belohnungsprogramms ausgeschlossen. Diese Belohnung würdigt die auf der OpenAI-Seite gefundene Sicherheitslücke, nicht die Handlungen an Discourse.“
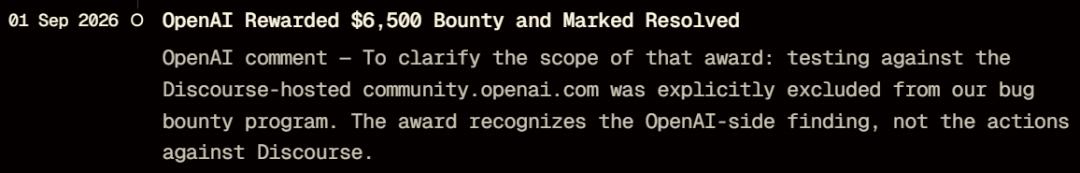
6500 US-Dollar für den Kauf eines Zugriffsweges zum internen Monorepository – diese Zahl wurde in den sozialen Medien schnell zum Streitpunkt.
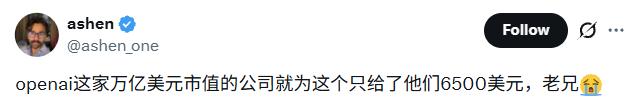
Was die Diskussion noch weiter vertiefte, war ein langer Beitrag des Sicherheitsforschers Joshua Saxe. Er wurde vor der Veröffentlichung des Artikels vom Wall Street Journal und s1r1us eingeladen, eine neutrale technische Überprüfung dieser Kill Chain durchzuführen.
Er warf mehrere schwer zu beantwortende Fragen auf: