Knickpunkt der physikalischen KI: Warum ist ausgerechnet Zidong Taichu, die inländische raumbezogene Basisinfrastruktur für verkörperte Intelligenz, weithin wahrgenommen worden?
In der heutigen Zeit ziehen multimodale Großmodelle in Fabriken und Labore ein, und eine Einschränkung tritt schnell zutage: Sie können Bilder verstehen, aber es fällt ihnen schwer, die Orientierung, Verdeckungen und Perspektivänderungen in realen Szenen zu beurteilen, geschweige denn darauf basierende Handlungen zu planen. Dies ist zugleich eine Hürde, die die physikalische KI unbedingt überwinden muss, um wirklich in die Industrialisierung einzutreten.
Auslands verstärken Google, NVIDIA und World Labs, das von Li Fei-Fei gegründet wurde, kontinuierlich die Investitionen in physikalische KI und Weltmodelle. Im Inland haben sich allmählich zwei technische Pfade herausgebildet: Der eine konzentriert sich auf vertikale verkörperte Großmodelle und fokussiert auf das räumliche verkörperte Verständnis und die Steuerung von Robotern. Der andere geht von allgemeinen multimodalen Großmodellen aus und erweitert kontinuierlich die umfassenden kognitiven Fähigkeiten in Bezug auf Text, Bilder, Ton und Video. Der erstere ist näher an echten physikalischen Aufgaben, der letztere verfügt über eine stärkere allgemeine kognitive Grundlage. Doch wie man beide Fähigkeiten in einem einzigen Modell wirklich vereinheitlichen kann, ist nach wie vor ein ungelöstes Problem der Branche.
Am 15. September hat Zhongke Zidong Taichu, ein staatliches Unternehmen, das vom Institut für Automatisierung der Chinesischen Akademie der Wissenschaften ausgegründet wurde, das allgemeine multimodale Großmodell ZDTaichu5.0-9B für die physische Welt quelloffen veröffentlicht. Gemäß den vom Team offengelegten horizontalen Bewertungen behält dieses Modell das Niveau der ersten Reihe bei den allgemeinen Fähigkeiten bei und ist zugleich das allgemeine multimodale Großmodell mit führenden räumlichen verkörperten Fähigkeiten im Parameterbereich von unter 10 Milliarden, das in acht von neun internationalen Benchmarks für räumliches verkörpertes Verständnis den ersten Platz in seiner Gruppe belegt.
Leistungstests können nur einen Teil der Fähigkeiten widerspiegeln. Diese Open-Source-Veröffentlichung umfasst zudem eine Produktionspipeline für räumliche multimodale Daten, und das Modell wurde in wissenschaftlichen Experimenten und Aufgaben der intelligenten Fertigung praktisch getestet. Dieses Modell setzt die seit Jahren bestehende native multimodale Linie von Zidong Taichu fort und erweitert die Grenzen der KI-Fähigkeiten weiter in die physische Welt.
Dieser Durchbruch wirft auch zwei tiefer zu untersuchende Fragen auf: Wenn die KI von der Interpretation der digitalen Welt dazu fortschreitet, die reale physische Szene zu verstehen, zu planen und in sie einzugreifen, welche unabhängig kontrollierbare KI-Grundplattform muss China aufbauen? Und womit kann Zidong Taichu zu einem besonders beachteten Akteur in diesem Wettbewerbsfeld werden?
Der Wendepunkt der physikalischen KI
Die Grundplattform für räumliche verkörperte Intelligenz wird zum umkämpften Kernbereich
Frühere Großmodelle verarbeiteten hauptsächlich relativ stabile digitale Inhalte. Nach dem Eintritt in die physische Szene steht das Modell vor einer sich ständig verändernden Umgebung, die nicht vollständig vordefiniert werden kann. Roboter müssen nicht nur die Objekte vor sich erkennen, sondern auch beurteilen, wo sie sich befinden, welche Beziehung sie zu anderen Objekten haben und was als Nächstes zu tun ist.
Räumliches verkörpertes Verständnis ist bereits heute eine grundlegende Fähigkeit, die die KI erwerben muss, um von der digitalen Welt in die physische Welt zu gelangen.
Am Beispiel der Fertigungsindustrie: Laut Statistik der Internationalen Föderation der Roboter (IFR) wurden 2024 in China etwa 295.000 neue Industrieroboter installiert, was 54 % des weltweiten Bestands ausmacht, und die Gesamtzahl der im Einsatz befindlichen Roboter übersteigt 2 Millionen.
Auf Produktionslinien, die hauptsächlich auf vordefinierten Programmen basieren, sind Roboter zwar gut darin, wiederholende Aufgaben auszuführen. Sobald jedoch Werkstücke ausgetauscht oder Verfahren angepasst werden, müssen Ingenieure sie häufig neu einlernen, kalibrieren und debuggen – dies ist ein seit langem ungelöstes Problem der flexiblen Fertigung und zugleich der direkteste industrielle Wert der räumlichen verkörperten Intelligenz.
Doch zwischen den Fähigkeiten des Modells und der realen industriellen Szene besteht noch eine deutliche Lücke.
Open-Source-Gewichte sind nur der Ausgangspunkt. Unternehmen müssen zudem industrielle und wissenschaftliche Daten in trainierbare Stichproben umwandeln und mit diesen Daten das Modell iterieren. Viele Projekte fehlen zudem die Validierung durch physische Aufgaben, und die Leistung des Modells außerhalb von Simulationen muss noch überprüft werden. Daher benötigt die Industrie ein System für räumliche verkörperte Intelligenz, das Szenen kontinuierlich verstehen, räumliche Beziehungen verarbeiten und Aufgabenpläne erstellen kann.
Benchmarks können nur lokale Fähigkeiten validieren. Der Wettbewerb um räumliche verkörperte Intelligenz hängt davon ab, ob das Modell von dem „Verstehen“ zum „Verstehen – Planen – Ausführen“ gelangen kann. Wer diese Kette wirklich durchgängig betreiben kann, hat die Chance, die allgemeine intelligente Grundplattform hinter Robotik, flexibler Fertigung und wissenschaftlicher Automatisierung zu werden.
Und ZDTaichu5.0-9B ist genau die praktische Lösung, die Zidong Taichu für dieses industrielle Problem anbietet.
Zidong Taichu: Ein Anbieter für räumliche verkörperte Intelligenz, der aus nativen multimodalen Modellen hervorgegangen ist
Um dieses Modell zu verstehen, muss zuerst ein weit verbreitetes Missverständnis ausgeräumt werden: ZDTaichu5.0-9B ist kein neues Projekt, das separat für aktuelle Trends entwickelt wurde, sondern ein Meilenstein in der Evolution der langfristigen technischen Linie von Zidong Taichu.
Dieses 2024 gegründete Unternehmen wurde vom Institut für Automatisierung der Chinesischen Akademie der Wissenschaften ausgegründet. Als staatliches Unternehmen verfolgt es das Ziel, eine unabhängig kontrollierbare allgemeine künstliche Intelligenz-Grundplattform für China zu schaffen.
Seine technische Linie lässt sich bis ins Jahr 2021 zurückverfolgen – damals veröffentlichte das Institut für Automatisierung der Chinesischen Akademie der Wissenschaften das multimodale Großmodell „Zidong Taichu“ mit einem Parameterumfang von 100 Milliarden, das Bild, Text und Sprache in einem einzigen Modell einheitlich darstellt. Diese Anordnung erfolgte vor dem Boom der multimodalen Technologie in der Branche.
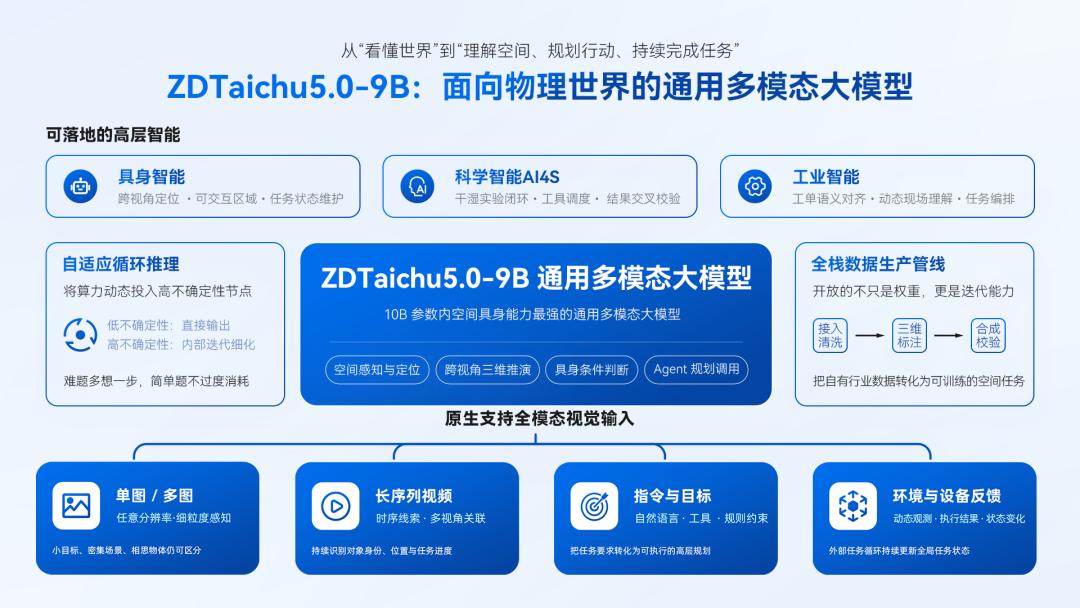
Die nachfolgende Version 2.0 integrierte Video, Sensorsignale und 3D-Punktwolken; die Version 4.0 entwickelte sich von dem multimodalen Verständnis zu tiefgreifendem multimodalem Schließen; bei ZDTaichu5.0-9B liegt der Fokus der Fähigkeiten weiter auf räumlicher Wahrnehmung, perspektivenübergreifendem Schließen, Aufrechterhaltung des Aufgabenstatus und Beurteilung von verkörperten Bedingungen.
Mit anderen Worten: Die räumlichen verkörperten Fähigkeiten sind eine natürliche Erweiterung der nativen multimodalen Linie von Zidong Taichu.
Diese integrierte technische Linie führt zu einem entscheidenden Unterschied: Während sich die Fähigkeiten des räumlichen verkörperten Schließens verbessern, behalten die allgemeinen Fähigkeiten wie Text-Bild-Verständnis, OCR, visuelles Rechnen, Code und Agent das Niveau der ersten Reihe bei. Dies ist für die Industrie von entscheidender Bedeutung – in echten industriellen Szenen müssen sowohl die Position und räumliche Beziehung von Objekten erkannt als auch Arbeitsaufträge gelesen, Messgeräte identifiziert und experimentelle Dokumente verstanden werden. Allgemeine Fähigkeiten und räumliche Fähigkeiten müssen gleichzeitig verfügbar sein.
Gemäß den vom Team offengelegten horizontalen Bewertungen belegt ZDTaichu5.0-9B unter den allgemeinen multimodalen Großmodellen im Parameterbereich von 10 Milliarden in acht von neun internationalen maßgeblichen Benchmarks für räumliches verkörpertes Verständnis den ersten Platz in der allgemeinen Gruppe und ist das allgemeine multimodale Modell mit den stärksten räumlichen verkörperten Fähigkeiten in diesem Parameterbereich. Bei dem komplexen räumlichen Schließen mit dem größten Abstand erzielte es bei ViewSpatial zur Beurteilung der perspektivenübergreifenden Lokalisierung 62,5 Punkte, während das vergleichbare Modell der gleichen Kategorie 48,2 Punkte erreichte; bei MindCube-tiny zur Beurteilung der dreidimensionalen räumlichen Schlussfolgerung lag es um 20,67 Punkte höher.
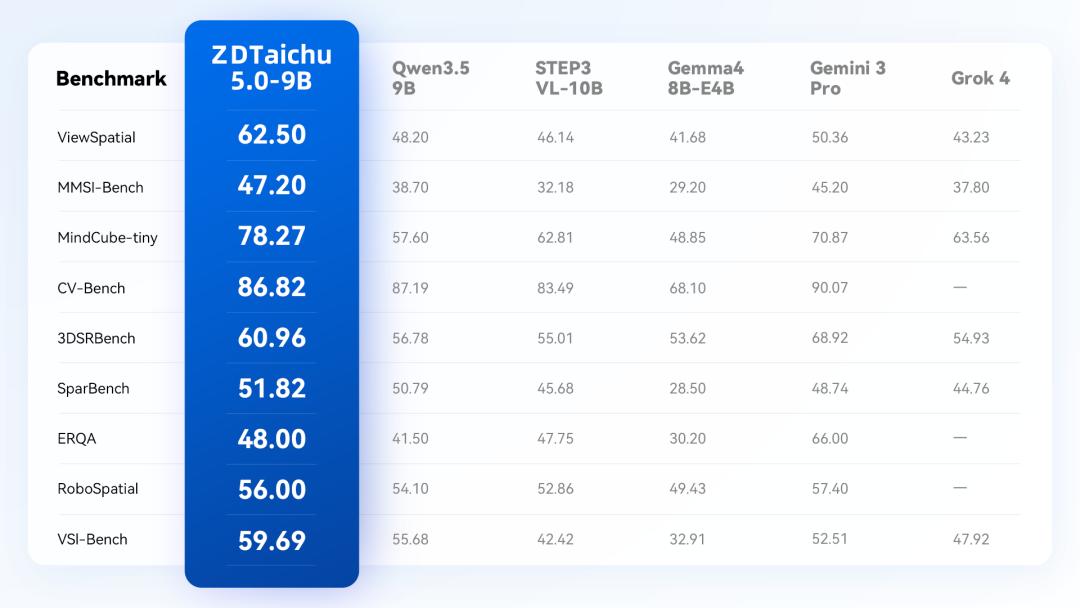
Diese Ergebnisse zeigen, dass es keine räumlichen Leistungswerte auf Kosten der allgemeinen Fähigkeiten erkauft hat. Sein selbst entwickeltes adaptives zyklisches Schließen lässt das Modell zuerst die Sicherheit jeder Ausgabe bewerten und führt mehrere interne Berechnungen für unsichere Glieder wie räumliche Transformationen, Objektbeziehungen und Betriebsbedingungen durch, bevor es antwortet. Die Rechenkapazität wird auf schwierige Aufgaben konzentriert, die durchschnittlichen Schließkosten sind kontrollierbar und es eignet sich besser für den Einsatz in der Industrie.
Zwei seltene Wettbewerbsvorteile
Abstand zu gewöhnlichen Open-Source-Modellen aufbauen
Die Ranglisten spiegeln nur die Leistung des Modells bei vorgegebenen Aufgaben wider. Unternehmen müssen zudem zwei praktische Probleme lösen: Wie man mit eigenen Daten weiter trainiert und ob das Modell nach dem Einsatz in Geräten kontinuierlich arbeiten kann. Die diesjährige Open-Source-Veröffentlichung von ZDTaichu5.0-9B deckt sowohl die Datenpipeline als auch die Validierung physischer Aufgaben ab.
Wettbewerbsvorteil 1: Nicht nur Open-Source-Gewichte, sondern auch die vollständige Produktionspipeline für Daten wird gleichzeitig freigegeben
Die überwiegende Mehrheit der Open-Source-Modelle auf dem Markt gibt nur Gewichte heraus. Der häufigste Fehler, den Unternehmen nach dem Erwerb machen, ist: Sie verfügen zwar über eine große Menge an Videos von Fabrikszenen, Simulationsdaten und experimentellen Aufzeichnungen, wissen aber nicht, wie diese Rohmaterialien gereinigt, markiert und zu hochwertigen räumlichen Aufgabenstichproben aufbereitet werden können, sodass am Ende die Feinabstimmung und Iteration mit eigenen Daten nicht abgeschlossen werden kann.
Der Unterschied von Zidong Taichu besteht darin, dass es gleichzeitig mit der Freigabe der Modellgewichte auch ein überprüftes Lösungskonzept für die Produktionspipeline von räumlichen multimodalen Daten quelloffen veröffentlicht – von der Datenanbindung und -reinigung über die Markierung räumlicher verkörperter Fähigkeiten bis zur Konstruktion von Aufgabenabläufen und Stichprobenprüfung, sodass die Daten für Feinabstimmung und verstärkendes Lernen bereitstehen.
Wenn die Gewichte wie ein ab Werk eingestelltes Gerät sind, dann ist diese Pipeline wie die vollständigen Verfahrensunterlagen, die dem Gerät beigefügt sind: Wenn Unternehmen die Werkstücke austauschen, können sie gemäß dem Verfahren neue Materialien vorbereiten, Muster erstellen und Prüfungen durchführen.
Ihre Bedeutung beschränkt sich nicht auf die Bereitstellung eines grundlegenden Modells, sondern beantwortet das weit verbreitete Problem der Industrie, dass man das Modell erhält, es aber nicht mit eigenen Daten iterieren kann. Sie senkt die Hürde für die gesamte Branche, in die räumliche verkörperte Intelligenz einzutreten. Zidong Taichu wandelt seine jahrelang angesammelte Erfahrung im Datenengineering in eine wiederverwendbare Entwicklungsmethode für die Industrie um, was eine Fähigkeit ist, die gewöhnliche Open-Source-Modelle in der Vergangenheit kaum bieten konnten.
Wettbewerbsvorteil 2: Keine „Leistungstests als Endziel“ – Durchführung der geschlossenen Validierung in physischen Szenen
Die Industrie ist oft misstrauisch gegenüber „Modellunternehmen, die nur Benchmarks durchführen“. Die Lösung von Zidong Taichu besteht darin, nicht bei Simulationstests zu verweilen, sondern die Fähigkeiten in zwei hochwertige Bereiche, nämlich wissenschaftliche Intelligenz und intelligente Fertigung, voranzutreiben und die Validierung echter physischer Aufgaben abzuschließen.
In wissenschaftlichen Szenen wurde ZDTaichu5.0-9B bereits in die wissenschaftliche Agentenplattform ScienceClaw von Zidong Taichu zur Durchführung von Tests eingebunden. Diese Plattform deckt 8 Fachbereiche ab und hat Aufgaben von trockenen und nassen Experimenten validiert.
In trockenen Experimenten stellen Forscher mit natürlicher Sprache ein Problem zu einem gedämpften Oszillator auf. ZDTaichu5.0-9B ruft in ScienceClaw mathematische und Programmierwerkzeuge zur Lösung auf, vergleicht die analytische Lösung und die numerische Lösung gegeneinander und gibt dann einen Analysebericht aus. Bei nassen Experimenten wird das Modell zum Experimentiertisch gebracht: Bei Aufgaben wie dem Einordnen von Reagenzgläsern in Regale in der richtigen Reihenfolge und dem Übertragen von Flüssigkeit mit Tropfpipetten muss das Modell kontinuierlich die Position der Objekte verfolgen und den Aufgabenfortschritt beurteilen – dies ist eine unverzichtbare Fähigkeit für die Planung übergeordneter Aufgaben in automatisierten Experimentierplattformen.
In Fertigungsszenen validierte das Modell die Verbindung zwischen Arbeitsaufträgen und Gerätefähigkeiten: Ausgehend von Arbeitsauftragsanweisungen wie „Legen Sie den Korb aus dem roten Regal auf das Förderband“ werden Objekterkennung, Verständnis räumlicher Beziehungen und Planung übergeordneter Aufgaben abgeschlossen, bis die Erledigung der Aufgabe an