Nach der Open-Source-Veröffentlichung von DeepSeek Harness: Die Öffnung von Ausführungsframeworks und die technischen Grenzen industrieller Agenten
Am 13. August veröffentlichte DeepSeek offiziell seinen Agent-Ausführungsframework DeepSeek Harness. Dieses Mikrokern-Framework, das auf dem Konzept „Modell + Harness = Agent“ basiert und dem Designprinzip „Alles ist ein Plugin“ folgt, gewann innerhalb von zwei Tagen nach der öffentlichen Open-Source-Testphase fast 100.000 GitHub-Stars und wurde zu einem der am schnellsten wachsenden Open-Source-Projekte in diesem Bereich.
Als die Nachricht bekannt wurde, war die erste Reaktion vieler Marktteilnehmer Nervosität: Wenn die Modellanbieter selbst an Ausführungsframeworks arbeiten, werden sie die Unternehmen, die die Agent-Implementierung umsetzen, durch übermäßigen Wettbewerb verdrängen? Unser Urteil ist genau das Gegenteil – dies ist nicht der Beginn einer Bedrohung, sondern der Beginn der Bestätigung und vor allem der Beginn der Erweiterung des Marktes.
Mitte dieses Jahres haben wir in dem Artikel *Das Harness-Zeitalter: Wie Haizhi Tech die „Steuerungstechnik“ der KI definiert* systematisch dargelegt: Der entscheidende Vorteil der industriellen KI liegt nicht in der „Leistung“ des Modells, sondern in dem „Geschirr“, das das Modell steuert. Das Modell ist ein wildes Pferd, Harness ist die Zügel. Das Modell bestimmt die Obergrenze der Intelligenz, Harness bestimmt die Untergrenze für den stabilen Betrieb des Systems. Anschließend haben wir in dem Artikel *Graph Engineering* weiter die Frage beantwortet, „worauf das Modell vertrauen soll“ – man baut eine vertrauenswürdige, schlussfolgernde und entwickelbare Wissensbasis durch Graphtechnik auf.
Heute sind die führenden Spieler, die Modelle am besten verstehen, selbst an die Herstellung von „Geschirren“ gegangen und haben sich dafür entschieden, es als Open Source zu veröffentlichen. Das bedeutet, dass die zentralste Partei der Industrie diese Behauptung mit der Produkt- und Ökosystemvalidierung aus der Modellebene bestätigt hat. Für Haizhi ist dies eine Bestätigung der Richtung und auch eine Beschleunigung: Es bestätigt den Weg, den wir vor zwei Jahren gewählt haben. Haizhi beginnt nicht erst heute, die Frage nach „der Schicht außerhalb des Modells“ zu beantworten, sondern hat schon lange kontinuierlich in Harness-Engineering, Ontologien, die Fusion von Graph und Modell sowie FDE investiert. Dass das Chassis Open Source wird, wird diese Anhäufungen nicht schwächen, sondern ihren Wert leichter sichtbar machen.
Dieser Artikel wird in den folgenden drei Aspekten erläutert: Was diese Open-Source-Veröffentlichung bestätigt, was sie nicht leisten kann und wie Haizhi auf dem standardisierten Chassis eine unersetzbare Engineering-Schicht aufbaut.
01 Paradigma festgelegt: Wenn „die Schicht außerhalb des Modells“ von führenden Spielern unterstützt wird
Die Bestimmung von Modellanbietern ist es, Modelle leistungsfähiger zu machen. Warum sollten sie wertvolle Ressourcen in das Ausführungsframework außerhalb des Modells investieren?
Es gibt nur eine vernünftige Erklärung: Im Agent-Zeitalter gibt es keine „sofort einsatzbereite“ Lösung. Um die Fähigkeiten des Modells in ausführbare Aktionen vor Ort beim Kunden umzuwandeln – Aufgabenplanung, Tool-Aufruf, Zugriffskontrolle, Ergebnisprüfung, sicherer Betrieb – muss eine Engineering-Schicht diese Funktionen übernehmen. Diese Schicht ist so wichtig, dass Modellanbieter sie nicht an Dritte überlassen können, und es lohnt sich, mit Open Source um den Ökosystemstandard zu kämpfen.
Diese Open-Source-Veröffentlichung bringt zwei Bestätigungen:
Erstens: Harness wird als unabhängige Wertschicht bestätigt. „Agent = Modell + Harness“ ist von einem Konsens im Ingenieurkreis zu einem Produktpfad führender Modellanbieter geworden. Im Jahr 2026 vollzieht der Bereich der KI-Engineering einen Paradigmenwechsel von Modellwettbewerb zu Systemwettbewerb – Harness läuft als Betriebssystem von Agenten, übernimmt Kernaufgaben wie Zustandsverwaltung, Tool-Ausführung, Feedback-Prüfung und Sicherheitsbeschränkungen und wandelt die probabilistische Schlussfolgerung des Modells in deterministische Aktionssequenzen um.
Branchendaten bestätigen dieses Urteil ebenfalls: Die Ausfallrate von Agenten in Produktionsumgebungen liegt im Bereich von 70 % bis 95 %, aber 60 % der Ausfälle sind auf Datenqualität, Lücken im Kontext und fehlende Steuerung zurückzuführen, nicht auf das Modell selbst. Mit anderen Worten: Ob ein Agent erfolgreich implementiert werden kann, hängt nicht davon ab, wie intelligent das Modell ist, sondern davon, wie solide die Engineering-Schicht um das Modell herum ist.
Zweitens: Harness wird als öffentliche Einrichtung bestätigt. Es ist nicht die Veröffentlichung selbst, sondern die Aktion „Open Source“, die besondere Aufmerksamkeit verdient: DeepSeek Harness baut auf dem Cordis-Metaframework auf, verwendet eine Mikrokernarchitektur, und Laufzeitkomponenten laufen in Form von voneinander isolierten und austauschbaren Plugins. Funktionseinheiten wie Modelladapter, Tool-Register, Sandbox-Umgebungen, Sitzungszustandsprozessoren, Ereignisverteiler und Benutzeroberflächen werden alle als unabhängige Erweiterungen geladen. Die Ausführungsworkflows können ersetzt werden, indem nur die deklarative Konfigurationsdatei aktualisiert wird. Das Design mit Mikrokern und vollständigen Plugins zeigt, dass DeepSeek nicht beabsichtigt, Harness zu einem geschlossenen Stack zu machen, sondern es zu einem „Chassis-Standard“ im Agent-Zeitalter zu machen.
Betrachtet man die Geschichte der Informationsindustrie: Die Open-Source-Veröffentlichung von Linux hat die Unternehmen, die Betriebssysteme entwickeln, nicht vernichtet, sondern das Betriebssystem von einem Wettbewerbshemmnis zu einer öffentlichen Einrichtung gemacht und den Wettbewerb zu den Anwendungen und branchenspezifischen Tiefen der oberen Schicht verlagert. In der Agent-Technologie-Stack findet eine ähnliche „Aufteilung“ statt: Die Ausführungsinfrastruktur wandelt sich von einem monolithischen Framework zu einer modularen, entkoppelten Architektur. Nach der Standardisierung des Chassis verschwindet der Wert nicht, sondern verlagert sich auf die Schicht über dem Chassis – Branchenwissen, vertrauenswürdige Daten, Verantwortung für Ergebnisse werden zu neuen Preismaßstäben.
02 Grenzanalyse: Was Harness nicht lösen kann
Die verantwortungsvollste Bewertung einer neuen Technologie besteht darin, ihre Grenzen klar zu erläutern.
DeepSeek Harness bietet ein hochwertiges allgemeines Ausführungsframework. Aus der Sicht der Branchenpraxis des Agent-Engineerings im Jahr 2026 steht aber mehr als die Hälfte der Punkte auf der Implementierungsliste der industriellen KI in keinem Zusammenhang damit – und diese Punkte sind genau die zentralen Engpässe, die Agenten von Demo zu Produktionssystem führen.
Erstens: Branchenwissen kommt nicht mit dem Framework. Harness kann sicherstellen, dass der Agent „korrekt ausführt“, aber nicht sicherstellen, dass „das Richtige ausgeführt wird“. Die Temperaturdifferenzschwellwerte für Vor- und Rücklaufwasser bei Heizungsunternehmen, die Zusammenhänge von Geschäftsangelegenheiten in Verwaltungsszenarien, die Qualitätszuordnungsketten in Fertigungsunternehmen – dieses Wissen, das in den Köpfen von Branchenexperten verankert und in den Kundenbüchern und Systemen gespeichert ist, kann von keinem allgemeinen Framework voreingestellt werden. Es muss Punkt für Punkt durch Interviews erfasst, zu Ontologien modelliert und zu maschinenlesbaren Regeln abgelagert werden. Das Urteil von Professor Wang Haofen von der Tongji-Universität ist erwähnenswert: Je leistungsfähiger das große Sprachmodell ist, desto wichtiger werden Ontologien und Wissensgraphen – sie sind genau die „Zügel“, die der KI-Agent braucht. Große Modelle führen Korrelationsschlüsse durch, aber für ernsthafte Entscheidungen braucht man Kausalketten – welcher Schritt zu welchem Ergebnis führt, muss klar erklärbar und nachprüfbar sein.
Zweitens: Die Unternehmensumgebung wird durch das Framework nicht vereinfacht. Die Compliance-Anforderungen, dass Daten den Unternehmensbereich nicht verlassen, der IT-Status mit zahlreichen heterogenen Systemen, die organisatorischen Prozesse mit mehrstufigen Genehmigungen, die Verantwortungsketten, die prüfbar sein müssen – unter diesen Einschränkungen ist die Implementierung von Agenten nicht „einen Demo zum Laufen bringen“, sondern ein Systemprojekt, das Daten-Engineering, Ontologie-Modellierung, Zugriffssteuerung und Vor-Ort-Betrieb umfasst. In unserer Praxis machte der Entwicklungsaufwand für die systemübergreifende Datenanbindung eines Fertigungskunden mehr als 60 % des gesamten Projektaufwands aus. Dieser Teil der Arbeit hat nichts mit Modellen und Frameworks zu tun, sondern hängt vom Verständnis der Mitarbeiter für die Unternehmenssysteme ab.
Drittens: Neutralität ist ein struktureller blinder Fleck von Modellanbietern. Das Harness von Modellanbietern ist natürlich auf das eigene Modell ausgerichtet entworfen und optimiert. Aber auf der tatsächlichen Einkaufsliste von Unternehmen gibt es nie nur ein Modell: In Szenarien für vertrauenswürdige inländische Technologien wird die Anpassung an inländische Produkte gefordert, in kostensensitiven Szenarien muss der Preis für Inferenz abgewogen werden, in fähigkeitssensitiven Szenarien müssen die Stärken verschiedener Modelle kombiniert werden. Im Jahr 2026 ist das Multi-Modell-Routing von einem High-End-Feature zu einem Standard der Unternehmens-Agent-Plattform geworden. Je mehr Harness, die auf einem einzigen Modell zentriert sind, es gibt, desto stärker wird die Nachfrage nach neutraler Planung mehrerer Modelle.
Viertens: Das Gedächtnisproblem bei lang andauernden Aufgaben wurde noch von keinem allgemeinen Framework gelöst. Eine gemeinsame Untersuchung von CMU, Yale und Amazon weist darauf hin: „The harness is becoming the binding constraint“ – das Ausführungsframework wird zu dem Engpass, der die Fähigkeiten von Agenten einschränkt, nicht das zugrundeliegende Modell. In der siebenstufigen ETCLOVG-Klassifikation, die in dieser Untersuchung aufgelistet ist, gibt es bereits 20 Hauptprojekte in der Ausführungsumgebung und Sandbox-Schicht, der reifste Teil der Infrastrukturebene. Die Schicht für Kontext und Gedächtnisverwaltung ist fast die dünnste der sieben Schichten, und es gibt nur wenige unabhängig veröffentlichte Komponenten. Agenten entwickeln sich von kurzen Aufgaben, die wenige Minuten laufen, zu lang andauernden Aufgaben, die mehrere Stunden laufen. Aber nach Ende jeder Aufgabe wird die Umgebung zerstört, und der nächste Start beginnt von Null – der Agent kann nie Erfahrungen sammeln. Dieses Problem kann das allgemeine Harness selbst nicht lösen.
Wenn die Grenzen klar definiert sind, ist die industrielle Arbeitsteilung so klar wie nie zuvor:
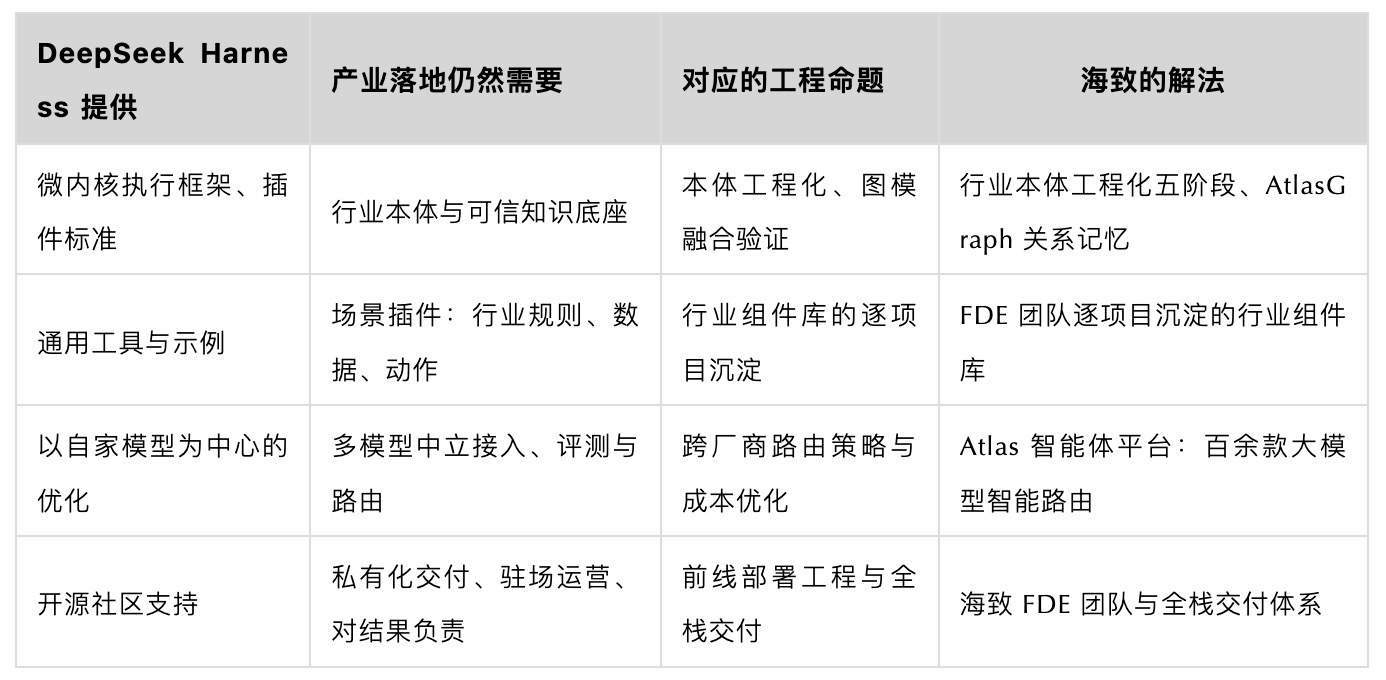
Zusammengefasst: DeepSeek hat das beste Chassis als Open Source veröffentlicht, aber die Arbeit, das Fahrzeug zum Ziel des Kunden zu fahren und alle Straßenverhältnisse unterwegs zu bewältigen, bleibt das Geschäft professioneller Transportunternehmen.
03 Wohin geht die Branche: Drei technische Trends
Wenn man die Grenzen des allgemeinen Harness versteht, kann man die technische Entwicklungsrichtung der industriellen Agenten klar erkennen.
Erster Trend: Übergang von der einzelnen Agent-Schleife zur graphenbasierten Orchestrierung mehrerer intelligenter Agenten. Ein einzelner Agent übernimmt Planung, Ausführung und Prüfung gleichzeitig, der Kontext wird schnell überlastet, und bei langen Aufgaben tritt ab 10 bis 15 Schritten eine „Zielabweichung“ auf. Die Antwort der Branche ist es, mehrere spezialisierte Agenten zu einem gerichteten Zustandsgraphen zu organisieren: Einer ist für die Aufgabenzergliederung zuständig, einer für die Recherche, einer schreibt Code, einer führt Code aus, einer führt die Prüfung durch, und dann sammelt der Orchestrator die Ergebnisse, um den nächsten Schritt zu bestimmen.
Ein kontrolliertes Experiment aus dem Jahr 2025 zeigt: Der Anteil der ausführbaren Vorschläge, die ein einzelner Agent in Ereignisreaktionsaufgaben erzeugt, beträgt 1,7 %, bei der Orchestrierung mehrerer intelligenter Agenten liegt er bei 100 %. Im Jahr 2026 hat sich die Architektur klar zur graphenbasierten Orchestrierung entwickelt, LangGraph 1.0 wurde offiziell als allgemeine Verfügbarkeit veröffentlicht, und OpenTelemetry ist zum Standardformat für die Verfolgung von Abläufen geworden. Die Kernprimitive der graphenbasierten Orchestrierung sind klar: Knoten (jeder Knoten ist ein Agent mit eigener Schleife), Kanten (definieren Datenfluss und Abhängigkeiten), typisierte Zustände, Prüfpunkte, Unterbrechung und Wiederherstellung.
Zweiter Trend: Konvergenz auf der Protokollebene, Wettbewerb verlagert sich auf die Anwendungsebene. Das MCP-Protokoll hat im Juli 2026 die größte Überarbeitung seiner Geschichte abgeschlossen – es wechselte von einem zustandsbehafteten bidirektionalen Protokoll zu einem Anfrage/Antwort-Modell und führte einen zustandslosen Kern und ein standardisiertes Erweiterungsframework ein. Anschließend veröffentlichte Anthropic ein fortschrittliches Tool-Aufruf-Suite, die die Lücken von MCP bei der Tool-Erkennung, -Auswahl und -Zusammenstellung schließt.
Der Wettbewerb um Protokolle ist im Wesentlichen beendet, das Muster „MCP verwaltet Tools, A2A verwaltet Agenten“ hat sich gebildet, und der Wettbewerb verlagert sich auf die Anwendungsebene und die branchenspezifischen Tiefen. Das bedeutet: Je höher der Standardisierungsgrad des allgemeinen Tool-Aufrufs ist, desto auffälliger wird der differenzierte Wert von Branchenregeln, Datenbeschränkungen und Geschäftssemantik.
Dritter Trend: Ontologien wandeln sich von „statischen Karten“ zu „dynamischen Navigationen“. Frühe Ontologien waren statische Karten, die darstellten, welche Personen und Angelegenheiten es in einer Organisation gibt. Aber im Agent-Zeitalter reicht eine Karte nicht mehr – man muss sich darin bewegen können. Ontologien müssen mit Schnittstellen und verschiedenen Funktionen verbunden werden, um die dahinterliegenden Dienste und Prozesse zu verbinden, damit die KI entsprechend handeln kann.
Snowflake hat bereits das ontologie-basierte Schlussfolgerungskonzept in Cortex Agents umgesetzt, indem es branchenübliche Standardontologien mit Wissensgraphen und GraphRAG kombiniert, um die Modellierungslücke zwischen relationalen Daten und domänenspezifischer Semantik zu schließen. In ernsten Szenarien, in denen deterministische Kausalketten benötigt werden – Geldwäschebekämpfung, Qualitätszuordnung, Fehlerursachenanalyse – kann ein modellorientierter Ansatz nur Korrelationen liefern, nur ein ontologieorientierter Ansatz kann Kausalitäten verfolgen.
04 Die technische Antwort von Haizhi
Unter den oben genannten drei Trends ist der technische Weg von Haizhi klar.
Erster Aspekt: Hebel für die Lieferung – die Kostenkurve von FDE senkt sich insgesamt
Im Jahr 2026 stieg die Nachfrage nach Stellen für FDE (Forward Deployed Engineer, Ingenieur für Vor-Ort-Einsatz) im Jahresvergleich um 729 %. AWS investierte 1 Milliarde US-Dollar, um ein FDE-Team aufzubauen. Dieses Modell wird weltweit als der Schlüsselpfad für die Implementierung von Agenten bestätigt. Haizhi ist eines der ersten Teams in China, das das FDE-Modell systematisch