Claude „dominiert“ 26 % der KI-Forschungs- und Entwicklungsarbeit bei Anthropic, 30.000 Agenten laufen gleichzeitig: Wenn KI anfängt, KI zu „erschaffen“, differenziert sich der RSI-Entwicklungsweg der führenden Unternehmen.
Künstliche Intelligenz beteiligt sich zunehmend tiefer an der Forschung und Entwicklung der nächsten Generation von KI, und das Tempo ist möglicherweise schneller als von außen erwartet.
Am 17. September Ortszeit veröffentlichte Anthropic eine seltene Reihe interner Daten, um zu quantifizieren, in welchem Ausmaß KI bereits an ihrer eigenen Entwicklung beteiligt ist.
Die Ergebnisse zeigen, dass Claude bis August 2026 bereits etwa 26 % der KI-Forschungs- und Entwicklungsarbeiten von Anthropic „führen“ konnte; mehr als 90 % der KI-Forschungs- und Entwicklungsarbeiten haben mindestens das Niveau der „KI-Kooperation“ erreicht. Auf der am weitesten verbreiteten internen Agent-Plattform von Anthropic arbeiten etwa 30.000 Agenten gleichzeitig an Forschungs- und Ingenieuraufgaben.
Noch bemerkenswerter ist die Geschwindigkeit der Veränderung. Die von Anthropic veröffentlichte Grafik zeigt, dass im Februar dieses Jahres der Anteil der Modellentwicklungsaufgaben, die Claude auf dem Niveau „führen“ bewältigen konnte, weniger als 1 % betrug, und sechs Monate später auf 26 % gestiegen ist. Anthropic verbindet dieses Messsystem direkt mit RSI, also der Fähigkeit eines KI-Systems, letztendlich seinen eigenen Nachfolger autonom zu erstellen.
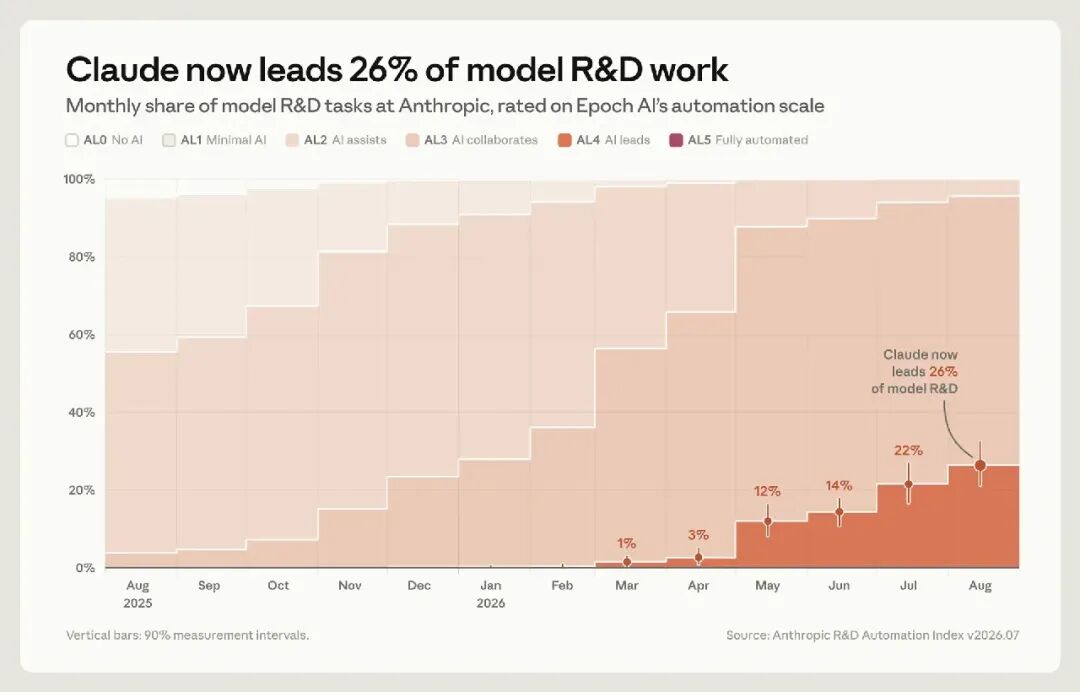
Das hier genannte „Führen“ bedarf einer besonderen Erklärung. Anthropic hat ein internes „R&D Automation Index (Forschungs- und Entwicklungsautomatisierungsindex)“ aufgebaut. Es verwendet den sechsstufigen Automatisierungsstandard, der von Epoch AI vorgeschlagen wurde: Von AL0 bis AL5 wird der Grad der Beteiligung von KI an einer Arbeit gemessen. Dabei steht AL3 für „Kooperation“: KI kann große Arbeitsblöcke unter enger Anleitung des Menschen übernehmen; AL4 steht für „Führen“: Ingenieure müssen nur ein übergeordnetes Ziel vorgeben, und die KI kann den größten Teil der End-to-End-Arbeit einer Aufgabe erledigen, wobei der Mensch hauptsächlich für die Überwachung und die endgültigen Entscheidungen verantwortlich ist; das höchste Niveau AL5 bedeutet einen vollständig autonomen Betrieb ohne menschliche Beteiligung.
Daher bedeutet „26 %“ nicht, dass 26 % der Forschung und Entwicklung von Anthropic bereits vollständig menschenfrei sind, und auch nicht, dass 26 % der Forscher durch Claude ersetzt wurden. Genauer gesagt bedeutet es, dass etwa ein Viertel der KI-Forschungs- und Entwicklungsarbeiten von Anthropic bereits in die Phase eingetreten ist, in der Menschen Ziele festlegen und überwachen, während Claude den größten Teil der Ausführung übernimmt.
Um diese Zahl zu ermitteln, zog Anthropic zunächst Mitarbeiter aus allen Abteilungen heran, die an dem Modellentwicklungszyklus beteiligt sind. In jeder Woche im Juli 2026 zog das Unternehmen zufällig 20 % der Mitarbeiter dieser Abteilungen aus, ließ Claude Research Agent deren Slack- und interne Dokumente lesen und erstellte schließlich etwa 15.000 feingranulare Modellentwicklungsaufgaben. Anschließend organisierte Claude diese Arbeiten zu einem Aufgabenbaum mit 542 Knoten, darunter 378 endgültige Blattknoten, die Arbeiten wie Vortraining, Verstärkungslernen, Fehlerdiagnose auf Bewertungsplattformen, Netzwerkrichtlinien im RL-Sandkasten und Nachbesprechungen von Vorfällen bei Inferenzdiensten abdecken. Anthropic gewichtete dann nach dem menschlichen Zeitaufwand, den verschiedene Aufgaben verbrauchen.
Diese Methode selbst weist auch Grenzen auf. Zum Beispiel ist der „Schiedsrichter“, der zur Bewertung des Automatisierungsgrads von Claude verwendet wird, ebenfalls Claude. Anthropic führte zudem eine Kreuzvalidierung durch interne Mitarbeiter durch, die für die entsprechenden Arbeitsbereiche verantwortlich sind: Die vollständige Übereinstimmungsrate zwischen den Bewertungen des Modells und der Menschen beträgt 59 %, während die vollständige Übereinstimmungsrate zwischen verschiedenen menschlichen Bewertern nur 35 % liegt; wenn der Unterschied zwischen Modell- und Menschenbewertung nicht mehr als eine Stufe beträgt, erreicht die Übereinstimmungsrate 97 %. Anthropic gibt jedoch immer noch zu, dass es einen gewissen Spielraum für subjektive Beurteilungen zwischen „KI-Kooperation“ und „KI-Führung“ gibt.
Um diese 30.000 gleichzeitig arbeitenden „KI-Mitarbeiter“ zu verwalten, hat Anthropic zwei Designs für interne Agenten eingeführt.
Zuerst die unabhängige Identität: Jeder Agent besitzt eine eigene Identität, und alle Daten und Verhaltensaufzeichnungen sind an diese Identität gebunden. Selbst wenn das zugrundeliegende Modell aktualisiert wird, kann die Identität weiterhin bestehen bleiben. Zweitens die offene Kommunikation: Agenten kommunizieren über ein gemeinsames Nachrichtensystem, anstatt Informationen privat zu übermitteln. Jede Nachricht ist an die Identität des Absenders gebunden und verlinkt auf das Ausgangsmaterial, sodass andere Agenten sie einsehen, Fehler korrigieren und zusammenarbeiten können. Gleichzeitig verknüpft Anthropic diese Nachrichten kreuzweise mit den vollständigen Betriebsspuren der Agenten, damit das Überwachungssystem das kooperative Verhalten zwischen verschiedenen Agenten verfolgen kann.
Der Grund für die Erhebung dieser Daten liegt darin, dass Anthropic mit der zunehmenden Nutzung von KI zum Aufbau zukünftiger KI-Modelle durch Spitzen-KI-Labore anhand dieser Indikatoren beurteilen möchte, wie weit die Welt von RSI noch entfernt ist.
Anthropic möchte das gesamte KI-Labor automatisieren
Im Juni dieses Jahres stellte Anthropic bereits den Entwicklungsweg vor: Von 2021 bis 2023 schrieben hauptsächlich Menschen den Code; von 2023 bis 2025 begann man, Chatbots zur Unterstützung zu nutzen; von 2025 bis 2026 trat die Phase des Coding Agent ein; heute gibt es bereits autonome Agenten, die Code ausführen und Arbeiten von mehreren Stunden an andere Agenten weiterleiten können. In späteren Phasen könnten die Agenten stark genug sein, um selbst Modelle zu erstellen und zu trainieren, sodass zukünftige Versionen von Claude kontinuierlich von Claude verbessert werden.
Damals erklärte Anthropic bereits „Wir haben das noch nicht erreicht“ und betonte, dass RSI nicht zwangsläufig eintritt. Was tatsächlich bereits passiert, ist, dass mehrere Zwischenschritte auf dem Weg zu diesem geschlossenen Kreislauf zunehmend ingenieurstechnisch umgesetzt werden.
Im Mai dieses Jahres gab Anthropic an, dass mehr als 80 % des Codes, der in die offizielle Codebibliothek zusammengeführt wurde und Claude zugeordnet werden kann, bereits von Claude erstellt wurde; im zweiten Quartal betrug die Anzahl der Codezeilen, die ein typischer Ingenieur täglich zusammenführte, etwa das 8-fache des Wertes von 2024. Anthropic wies jedoch sofort darauf hin, dass Codezeilen nur die Menge, nicht die Qualität messen, sodass der Faktor „8“ die tatsächliche Produktivitätssteigerung mit ziemlicher Sicherheit überbewertet.
In einem kleinen Experiment zur Optimierung des Modelltrainings, bei dem Ziele und Erfolgsstandards im Voraus festgelegt waren, konnte Opus 4 im vergangenen Mai den Ausgangscode im Durchschnitt nur um etwa das 3-fache beschleunigen, während das Mythos Preview im April dieses Jahres bereits etwa das 52-fache erreichte; Anthropic nutzt dieses Beispiel, um zu zeigen, dass sich die Fähigkeiten des Modells in Forschungsabschnitten mit „klaren Zielen und fortlaufenden Experimenten“ sehr schnell verbessern.
Anthropic ist der Ansicht, dass der Bereich, in dem Menschen derzeit noch deutliche komparative Vorteile haben, der Forschungsgeschmack und das Urteilsvermögen sind: also die Entscheidung, welche Probleme es wert sind, erforscht zu werden, welche Ergebnisse vertrauenswürdig sind und wann ein Weg in eine Sackgasse geraten ist.
Daher können die von Anthropic jetzt veröffentlichten Daten als Versuch angesehen werden, zu messen, wie viel von der Arbeit in einem KI-Labor, die unbedingt von Menschen erledigt werden muss, noch übrig ist.
Betrachtet man die gesamte Branche, ist Anthropic nicht das einzige Unternehmen, das ernsthaft beginnt, diese Frage zu beantworten.
OpenAI hat ein spezialisiertes RSI-Team gegründet; Google DeepMind hat RSI offiziell als einen der potenziellen Wege von AGI zu ASI eingestuft; Recursive, das erst in diesem Jahr öffentlich vorgestellt wurde und von Tian Yuandong und anderen mitbegründet wurde, schreibt direkt „Rekursiv selbstverbessernde Superintelligenz: Automatisierung der Wissensentdeckung“ auf die Startseite seiner offiziellen Website.
Obwohl die Ziele übereinstimmen, gehen die Unternehmen tatsächlich nicht genau denselben Weg.
OpenAI skaliert den „KI-Forscher“
Die Wege von OpenAI und Anthropic sind sehr ähnlich, aber ihre Schwerpunkte sind nicht völlig identisch. Das Ziel von OpenAI ist derzeit sehr klar: Einen automatisierten KI-Forscher aufzubauen.
Im September dieses Jahres erklärte OpenAI, dass das Unternehmen das zuvor festgelegte Ziel der Automatisierung des „KI-Forschungspraktikanten“ erreicht hat. Der sogenannte KI-Forschungspraktikant bezieht sich auf ein System, das klar definierte Forschungsaufgaben unter menschlicher Anleitung erledigen kann, einschließlich Arbeiten, die früher von erfahrenen Forschern mehrere Tage dauerten. Das nächste Ziel von OpenAI ist es, bis März 2028 weiter in Richtung eines automatisierten KI-Forschers voranzuschreiten.
Diese Veränderung spiegelt sich bereits in der internen Arbeitsbelastung wider. Vor Juni dieses Jahres lag die gesamte Laufzeit der Agenten in der Forschungsorganisation von OpenAI noch unter der menschlichen Arbeitsbelastung; bis Mitte August, umgerechnet auf einen 8-stündigen Arbeitstag, liefen die KI-Agenten parallel etwa 24,8 Stunden, während Menschen 1 Tag arbeiteten. Immer mehr Forscher starten zudem mehrere Agenten gleichzeitig. Die eigenen Daten von OpenAI zeigen jedoch auch, dass die übergeordnete Planung derzeit nur einen sehr kleinen Teil der von Agenten ausgegebenen Token ausmacht.
OpenAI betont gleichzeitig, dass immer noch Menschen die Forschungsprioritäten festlegen, beurteilen, welche Ideen und Ergebnisse weiterverfolgt werden sollen, und entscheiden, ob ein System skaliert, angehalten oder bereitgestellt werden soll. Das ähnelt der Situation bei Anthropic.
Derzeit treibt OpenAI die Entwicklung weiter voran. Das offizielle RSI-Team von OpenAI erstreckt sich über Forschung, Ingenieurwesen, Produkt und Infrastruktur. Die offizielle Beschreibung lautet, KI-Systeme aufzubauen, die „hochwertige OpenAI-Forschung beschleunigen und letztendlich durchführen“ können, wobei die Bewertungsfähigkeiten Forschungsurteil, Hypothesengenerierung und -validierung sowie die Durchführung langfristiger Experimente umfassen.
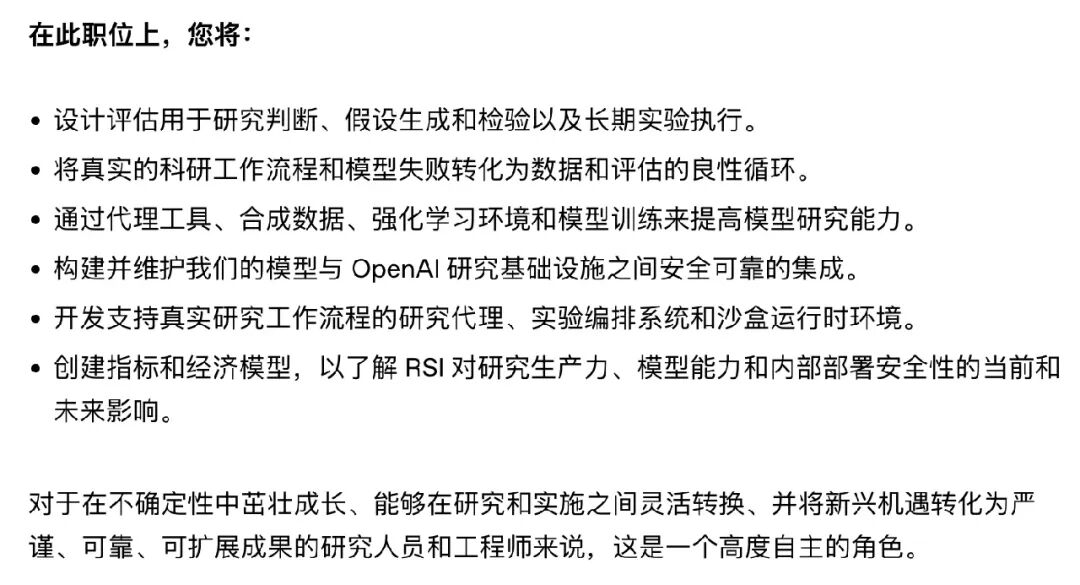
Informationen zu offenen Stellen bei OpenAI
Das zeigt, dass OpenAI nicht verlangt, dass der erste Schritt darin besteht, „dass GPT direkt seine eigenen Gewichte öffnet und sich selbst modifiziert“. Solange die KI immer mehr tatsächliche Modellentwicklungsaufgaben übernimmt, kann die KI-Forschungsfähigkeit zu einer Produktionsressource werden, die durch Inferenz-Rechenleistung erweitert werden kann.
Jakub Pachocki, Chefwissenschaftler von OpenAI, erklärte in seinem kürzlichen Artikel „An Alien Mind“, dass wenn die KI sich weiterentwickelt, die zunehmend tiefe Beteiligung maschineller Intelligenz an ihrer eigenen Entwicklung das natürliche Ergebnis des langfristigen technischen Fortschritts ist. Er bezeichnet die automatisierte KI-Forschung als eine radikalere Form der „Erweiterung der Intelligenz durch Rechenleistung“. OpenAI hat auch klar angegeben, dass es die Forschung weiter in Richtung RSI lenkt.
Pachocki betonte jedoch, dass die oben genannte Beurteilung nicht bedeutet, dass die gesamte Forschungsgemeinschaft jetzt die Forschung im Bereich Deep Learning stark beschleunigen sollte. Im Gegenteil, es sei notwendig, „bewusst zu wählen, wie man voranschreitet“. Er fügte hinzu, dass bisher noch kein Labor die Ausrichtung und Überwachung so weit umgesetzt hat, dass eine langfristige maximale Skalierungsgeschwindigkeit gewährleistet werden kann.
OpenAI erklärte auch, dass es derzeit nicht bekannt ist, wie man sicher zu einer „ausgerichteten vollständigen rekursiven Selbstverbesserung“ gelangen kann. Wenn Risiken nicht ausreichend kontrolliert werden können, wird in Betracht gezogen, die Entwicklung oder Bereitstellung entsprechender Systeme zu verlangsamen oder einzustellen.
Daher besteht OpenAI derzeit darin, den KI-Forscher zu skalieren und gleichzeitig zu untersuchen, wie schnell RSI weiterentwickelt werden soll.
Im Vergleich zum skalierten KI-Forscher von OpenAI tendiert Anthropic eher dazu, ein zunehmend agentenbasiertes virtuelles Labor zu skalieren: Wie viel Codierung noch von Menschen erledigt werden muss, wie viele Experimente noch menschliche Beteiligung erfordern, wie viel Forschungszusammenarbeit noch menschlich gesteuert werden muss, und ob schließlich auch die Beurteilung, „was erforscht werden soll“, allmählich von Claude übernommen wird.
Google optimiert „wie man Antworten findet“
Im Vergleich dazu zeigt Google in letzter Zeit auf RSI einen weiteren Weg, der sich stärker auf den „Such- und Entdeckungsmechanismus“ konzentriert: Es lässt die KI nicht nur bessere Antworten finden, sondern beginnt auch, sie dazu zu bringen, die „Methode zum Finden von Antworten“ zu verbessern.
Am 2. September veröffentlichte Google die Gemini 3.8-Modellreihe und enthüllte dabei ein zuvor selten öffentlich gemachtes Detail der Modellentwicklung. Google gab an, dass die Modelle nicht nur denselben Satz grundlegender Intelligenz gemeinsam nutzen, sondern auch lang laufende Agent-Kreisläufe nutzen, um die Entwicklung weiter zu beschleunigen. Diese Kreisläufe sind dafür ausgelegt, „das zugrundeliegende Modell rekursiv zu bewerten und zu verbessern“.
Das bedeutet nicht, dass Gemini 3.8 bereits in der Lage ist, die nächste Generation von Gemini autonom zu trainieren. Google hat derzeit auch nicht offengelegt, an welchen spezifischen Abschnitten des Modelltrainings, der Daten, der Bewertung oder des Post-Training-Prozesses diese Agent-Kreisläufe beteiligt sind und wie viel der Entwicklungsarbeit bereits automatisiert ist. Dies zeigt jedoch zumindest, dass Agenten nicht mehr nur zum Schreiben von Code oder zur Optimierung der peripheren Infrastruktur verwendet werden, sondern in den Iterationsprozess der zugrundeliegenden Modelle eintreten.
Weniger als zwei Wochen später wurde dieser Weg noch weiter vorangetrieben.
Am 14. September veröffentlichte ein Forschungsteam von Google, Google DeepMind, der University of Maryland und der University of Virginia das Papier „Dream-RSI: Recursive Self-Improvement through Evolving Worlds“, um ein weiteres Problem in der automatisierten KI-Forschung zu lösen: Wenn die KI bereits kontinuierlich Kandidatenvorschläge machen kann, kann sie dann weiter lernen, „wie die Erkundung effektiver gestaltet werden kann“?
In der Vergangenheit konnten zahlreiche automatische Entdeckungssysteme, einschließlich AlphaEvolve, Modelle dazu bringen, Kandidatenalgorithmen zu generieren, die dann von einem Evaluator ausgeführt, bewertet und gefiltert werden, sodass bessere Kandidatenvorschläge in die nächste Suchrunde