Zhipu realisiert den minimalen geschlossenen RSI-Zyklus, Unternehmen A: Ich übernehme die Aufsicht.
„Zhipu hat die kleinste geschlossene Schleife realisiert: Das Modell optimiert das System, das System dient dem Modell.“
Kürzlich hat TANG Jie, Chefwissenschaftler von Zhipu, in den sozialen Medien mit diesem Satz den Schritt zusammengefasst, den Zhipu in Richtung rekursiver Selbstverbesserung (RSI) unternommen hat.
In der von Zhipu veröffentlichten Arbeit *Auf dem Weg zur rekursiven Selbstverbesserung* hat ein von GLM-5.3 angetriebener Infra-Agent am Aufbau und der Optimierung des Inferenzdienstes von GLM-5.3-Flash mitgewirkt. Dieser Dienst läuft auf mehr als 100.000 inländischen KI-Chips, und es wurden nur zwei Wochen benötigt, um vom ersten erfolgreichen Lauf zur Übernahme des gesamten Online-Verkehrs zu gelangen.
Das Modell arbeitet nun für sich selbst. Es hilft, das System zu optimieren, auf dem es läuft, sodass die Inferenz schneller und kostengünstiger wird. Die während des Optimierungsprozesses angesammelten Aufgaben, Validierungsergebnisse und Korrekturerfahrungen können wiederum Ressourcen für die nachfolgende Forschung und Entwicklung werden. Die von Tang Jie genannte „kleinste geschlossene Schleife“ beginnt sich von hier aus zu drehen.
Es besteht noch eine Lücke bis zu der vollständig autonomen Entwicklung der nächsten KI-Generation durch KI. Aber sie wirft eine immer konkretere Frage auf: Wenn Modelle nach und nach die Entwicklungsarbeiten übernehmen, die ursprünglich von Menschen erledigt wurden, wie können wir wissen, in welchem Schritt sich die Selbstverbesserung tatsächlich befindet?
Eine Beschleunigung der Inferenz kann mit Durchsatz und Latenz validiert werden – aber was misst man, um zu bestimmen, wie viel von seiner eigenen Entwicklungsarbeit ein bestimmtes Modell tatsächlich übernimmt? Wenn immer mehr Agenten daran beteiligt sind, können Menschen dann noch klar sehen, was sie tun, und rechtzeitig eingreifen?
Die kürzlich von Anthropic veröffentlichte Arbeit *Die Messung der Entwicklungsgeschwindigkeit von KI in Spitzenlabors* hat die Diskussion genau an diesen Punkt gebracht. Sie schlägt drei Messdimensionen vor: Wie viel KI-Entwicklungsarbeit die KI übernimmt, wie die Handlungen der Agenten überwacht werden und wie die Rechenleistung zwischen Modellentwicklung und Sicherheitsarbeit verteilt wird. Das entspricht der Installation von drei Armaturenbrettern für den laufenden Entwicklungsprozess, sodass Personen außerhalb des Labors die Veränderungen darin sehen können.
Nach den von Anthropic offengelegten Daten hat Claude bis August dieses Jahres unter menschlicher Aufsicht 26 % der Modellentwicklungsarbeiten „geleitet“, im Februar lag dieser Anteil noch unter 1 %. Allerdings hat keine der von ihr gemessenen Entwicklungsarbeiten einen vollständig autonomen Grad erreicht.
Die von Zhipu gezeigte technische Praxis liefert ein konkretes Beispiel für „KI, die an der Verbesserung ihrer selbst mitwirkt“; die von Anthropic vorgeschlagene Messmethode versucht, diese Veränderung dauerhaft beobachtbar und prüfbar zu machen. Wie die Schleife in Gang kommt und wie sie nach dem Anlaufen gemessen und überwacht werden kann – die beiden Arbeiten schließen sich damit zu derselben Fragestellung zusammen.
Was ist die kleinste geschlossene Schleife der RSI?
Bevor man die kleinste geschlossene Schleife der RSI versteht, muss man zuerst die neue Sichtweise von Tang Jie begreifen. Früher dachten die Menschen bei RSI zuerst: „Das Modell wird klug genug, um sich selbst weiterzuentwickeln.“
Tang Jies Verständnis ist genau umgekehrt: Was die Schleife in Gang bringt, ist nicht Intelligenz, sondern die geschlossene Schleife selbst.
Selbst ein nicht besonders intelligentes System kann einen Kreislauf aufrechterhalten, solange es kontinuierlich etwas verbessern kann und jemand kontinuierlich beurteilt, ob die Verbesserung korrekt ist. Umgekehrt kann selbst das klügste Modell, wenn niemand ihm sagt, ob sein letzter Schritt richtig war, auch nach Monaten oder Jahren nur auf der Stelle treten.
Daher ist Tang Jie der Meinung, dass man drei Puzzleteile benötigt, um die geschlossene Schleife zu vervollständigen.
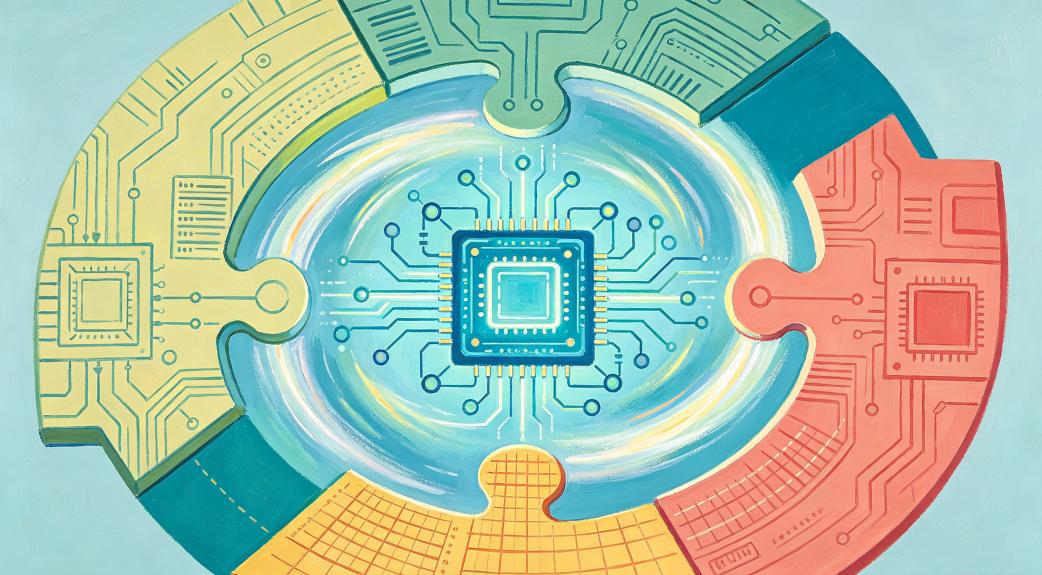
Erstens: Ein verbesserbares Objekt wird benötigt.
Das Modell kann nicht auf seine eigenen Gewichte zugreifen, aber es kann das dazugehörige Inferenzsystem optimieren, das den Modelldienst unterstützt, z. B. Kernel, Parallelisierungsstrategien, Kommunikation, Speicherverwaltung und Planung.
Das ist so, als ob Sie im Büro Kaffee trinken müssen, um wach zu bleiben, aber Kaffeemaschine und Wasserspender zu weit entfernt sind – Sie müssen jedes Mal einen weiten Weg gehen, um Kaffee zu holen. Also stellen Sie die Kaffeemaschine in die Nähe Ihres Arbeitsplatzes.
Auf diese Weise können Sie die Arbeitseffizienz steigern, selbst wenn sich Ihre täglichen Aufgaben nicht ändern.
Tang Jie ist der Meinung, dass dieses Inferenzsystem der Schlüssel zur Realisierung der geschlossenen Schleife ist.
Zweitens: Ein überprüfbarer Schiedsrichter wird benötigt.
Nach jeder Änderung muss jemand sofort dem Modell bestätigen, ob die Änderung richtig oder falsch ist – und dieser Schiedsrichter darf keine hohen Kosten verursachen. Dieser Vorgang wird als dichtes Feedback bezeichnet.
Für die Korrektheit gibt es eine Referenzimplementierung, für Durchsatz und Latenz gibt es vergleichbare Kennzahlen, Richtigkeit und Falschheit können objektiv beurteilt werden – das heißt, es braucht einen günstigen und zuverlässigen Maßstab.
Drittens: Ein sich selbst versorgender Kreislauf wird benötigt.
Die in dieser Runde abgeschlossenen Aufgaben selbst werden zur Trainingsgrundlage für die nächste Runde. Dadurch braucht der Kreislauf keine ständigen externen Eingaben, sondern er erzeugt die nächste Runde von selbst.
Erst wenn die drei Puzzleteile zusammenkommen, kann der Kreislauf selbstständig laufen. Was Zhipu dieses Mal wirklich geschlossen hat, ist das erste Puzzleteil: Das Modell optimiert das Inferenzsystem.
Obwohl diese kleinste geschlossene Schleife die Intelligenz des Modells nicht im eigentlichen Sinne steigern kann, senkt sie die Kosten für das Modell, sich selbst zu erzeugen. Nur wenn Sie Ihren eigenen Arbeitsplatz ordentlich eingerichtet haben, können Sie von einer Effizienzsteigerung sprechen.
Günstigere Inferenz bedeutet, dass mit demselben Budget mehr Rechenleistung für das Training übrig bleibt. Ein effizienteres Dienstsystem bedeutet, dass das nächste Modell auf einer stabileren Grundlage aufbauen kann.
Auf Basis dieser geschlossenen Schleife läuft der produktive Inferenzdienst von GLM-5.3-Flash auf mehr als 100.000 inländischen KI-Chips. Es wurden nur zwei Wochen benötigt, um vom ersten erfolgreichen Lauf zur Übernahme des gesamten Online-Verkehrs zu gelangen, und der End-to-End-Durchsatz wurde um etwa das Dreifache gesteigert.
Noch wichtiger ist, was im Kreislauf fließt. Das Modell extrahiert ein „Optimierungsgerüst“ aus fertigen Kerneln wie SGLang, Flash Linear Attention und DeepGEMM, speichert die Anwendungsbedingungen und Validierungsbeweise zusammen, und die validierten Vorgehensweisen fließen zurück in eine Bibliothek – die nächste Runde wird dadurch einfacher.
Jede Aufgabe, die der Agent erledigt, kann daraus erben. Das Training ist nicht mehr einmalig, sondern wird zu einem Zinseszinseffekt.
Das ist so, als ob ich vor dem Schreiben eines Artikels nach Referenzmaterialien suche, sonst könnte ich die Schlüsselinformationen, die in diesem Artikel von Zhipu erwähnt werden, überhaupt nicht verstehen. Dann wandle ich diese Informationen in einfache Worte um, die jeder verstehen kann. Gleichzeitig kann ich während der Informationssuche mein Verständnis von RSI vertiefen, um den nächsten Artikel besser schreiben zu können.
Wie groß kann dieser Kreislauf dann weiter ausgebaut werden?
Tang Jie ist der Meinung, dass das Wesen der Erweiterung darin besteht, die „überprüfbare Umgebung“ aus dem technischen Bereich in mehr Bereiche zu kopieren. Wie groß er letztendlich werden kann, hängt von dem zweiten Puzzleteil ab.
Wie bereits erwähnt, muss dieser Schiedsrichter günstig, schnell und sein Ergebnis objektiv überprüfbar sein.
Alle Bereiche, die diese drei Bedingungen erfüllen, können in die RSI einbezogen werden, z. B. Code, Datenverarbeitung, formale Verifikation und jedes messbare System.
Umgekehrt funktioniert die Erweiterung nicht dort, wo es keinen objektiven Schiedsrichter gibt – wie bei Strategie, Ästhetik oder Narrativen, wo es keinen günstigen und zuverlässigen Maßstab gibt. Wer entscheidet, ob eine Geschichte gut erzählt ist, wenn das Modell sagt, sie sei gut, und Sie sagen, sie sei schlecht?
Was den Agenten bestimmt, ist Feedback
Wo hängt dieser Kreislauf eigentlich fest?
Tang Jie schreibt in seinem langen Text: Wenn der Infra-Agent steckenbleibt, liegt es selten daran, dass er keinen Code schreiben kann, sondern daran, dass er nicht weiß, warum die Situation schlechter geworden ist.
Zum Beispiel gibt der Schiedsrichter der KI das Feedback, dass „der Durchsatz um 20 % gesunken ist“. Das sagt nur, dass etwas kaputt ist – aber es sagt nicht, welche Ebene kaputt ist, wo die aktuelle Annahme falsch ist und was als Nächstes getestet werden soll.
Tang Jie sagt, das ist ein altes Problem, das aus dem Reinforcement Learning stammt: Spärliche Belohnung und Kreditzuweisung.
Oft erhalten Sie erst nach Abschluss einer gesamten Aktion und dem vollständigen End-to-End-Lauf ein Signal von „gut“ oder „schlecht“, und dieses Signal kann nicht auf einen bestimmten Schritt zurückgeführt werden – die Erkundung wird natürlich langsamer.
Das ist wie bei einer Prüfung: Nach der Prüfung sagt Ihnen der Lehrer, dass Sie 60 Punkte erreicht haben, aber er sagt Ihnen nicht, welche Fragen Sie genau falsch beantwortet haben. Also müssen Sie die gesamte Prüfungsarbeit noch einmal machen und raten, was Sie ändern müssen.
Möglicherweise ändern Sie etwas, das gar nicht falsch war, während der eigentliche Fehler noch vorhanden ist.
Darüber hinaus dauern End-to-End-Benchmarks oft mehrere Stunden. Wenn das Modell eine Hypothese aufstellt und eine Codezeile ändert, muss es lange warten, um zu wissen, ob es richtig war – die Erkundung wird dadurch so langsam, dass es schmerzt.
Allerdings gibt es hier ein erstaunliches Phänomen: Ein erfahrener Ingenieur, der seit 10 Jahren im Infrastrukturbereich arbeitet, der dasselbe Problem sieht, braucht möglicherweise weniger als eine Stunde, um es zu optimieren. Denn er hat eine Art unaussprechliche Intuition. Nachdem er einen Codeabschnitt geändert hat, weiß er manchmal selbst nicht, wie er zu seinem Urteil gekommen ist.
Die Gedanken dieser erfahrenen Ingenieure lauten etwa: „Hmm, das fühlt sich falsch an, ich schaue mir die Zeitachse an“ oder „Hmm, hier sollte ich vielleicht ein kleines Microbenchmark durchführen, um zu vergleichen“.
Diese Dinge sind in seinem Kopf verankert. Er kann die Schritte nicht aussprechen und auch nicht in ein Dokument schreiben, aber sie funktionieren.
Was Tang Jie erreichen möchte, ist, diese unaussprechliche, aber funktionierende Intuition in den Köpfen erfahrener Ingenieure in eine hierarchische Verifikationsschnittstelle zu verwandeln, die das Modell direkt aufrufen kann. Genau wie ein erfahrener Handwerker, der seinen Lehrling anleitet, erklärt er es der KI.
Korrektivfeedback beantwortet die Frage „Wurde korrekt gerechnet?“, indem Referenzimplementierung und Fehlertoleranz prüfen, ob die Berechnung korrekt ist. Systemverhaltensfeedback beantwortet die Frage „Wofür wurde die Zeit verwendet?“, indem Ausführungszeitachse und Laufzeitereignisse die zeitlichen Beziehungen zwischen Berechnung, Wartezeit und Kommunikation aufzeigen. Leistungsfeedback beantwortet die Frage „Welcher Ansatz ist unter welchen Bedingungen besser?“, indem kontrollierte Experimente und vergleichbare Kennzahlen prüfen, welcher Weg tatsächlich vorteilhafter ist.
Der Originaltext nennt drei Fälle zur Erklärung.
Der erste Fall ist KV-Transfer. Der Ingenieur legt dem Agenten zuerst eine Akzeptanzbedingung fest: Bei gleicher Last darf der Unterschied zwischen Prefill plus Übertragung und reinem Prefill nicht mehr als 5 % betragen.
Der Agent stellt fest, dass dieser Unterschied in einigen Szenarien über 20 % liegt. Dieses Feedback gibt keine direkte Antwort, aber es grenzt den Untersuchungsbereich auf den zusätzlichen Overhead und die gleichzeitigen Interaktionen ein, die durch den KV-Transfer verursacht werden.
Der Meister kocht in der Küche, und wenn das Gericht fertig ist, muss es ins Restaurant getragen werden. Eigentlich sollte der Meister das nächste Gericht kochen, während der Kellner das vorherige Gericht gleichzeitig hinausträgt – beide Arbeiten stören sich nicht.
Aber die Tür zum Servierraum hat nur einen Schlüssel, den der Meister während des Kochens in seiner Tasche steckt. Der Kellner, der das Gericht hinaustragen möchte, muss warten, bis der Meister den Schlüssel herausnimmt und die Tür öffnet. Wenn der Meister ganz in das Kochen vertieft ist und den Schlüssel vergisst, steht der Kellner nutzlos an der Tür und wartet.
Der Agent verfolgt die Spur entlang der Zeitachse sogar bis zu Python und C++: Der Pfad innerhalb des Knotens von DeepEP gibt die GIL nicht explizit frei, sodass der für die Übertragung zuständige Python-Thread im selben Prozess keine Sperre erhalten kann. Der KV-Transfer, der eigentlich mit der Berechnung überlappen sollte, wird durch die Planung blockiert.
Der Eintritt in C++ gibt die GIL nicht automatisch frei – genau dieses Detail erklärt, warum die untere Ebene asynchrone Vorgänge unterstützt, aber die obere Ebene dies nicht umsetzt. Nach der Behebung wurde der Unterschied zwischen Prefill plus Übertragung und reinem Prefill von über 20 % auf unter 1 % gedrückt.
Der zweite Fall ist die Genauigkeitsabweichung bei KDA. Während der Kernel-Validierung traten Unterschiede zwischen den Ergebnissen des CP-Pfads und des Nicht-CP-Pfads auf, sodass die Untersuchung sich der Zustandsausbreitung und der zusammengefassten Berechnung zuwandte, die durch die parallele Ausführung verursacht werden.
Der Agent stellt fest, dass die Ursache tf32 ist. In der ursprünglichen Implementierung verwendet tl.dot standardmäßig tf32 für die Berechnung, um die Leistung zu steigern. Selbst bei fp32-Eingaben sammeln sich durch diese geringere Genauigkeit ständig Fehler in der kettengliedartigen Zusammenführung der Zustandsmatrix an – je länger die Sequenz, desto deutlicher wird dies.
Ein Lehrer sagt etwas